HiDream-O1-Video 的三场世界回应测试。
在《塞尔达传说:旷野之息》中,玩家点燃一片草地,火焰会沿着草叶蔓延,热空气随之升起。此时展开滑翔帆,林克便能借助上升气流离开地面。雷雨中,金属武器可能招来闪电,降雨又会让攀爬变得困难。海拉鲁并没有追求照片级的视觉拟真,却通过一组稳定、可组合的规则,让玩家感受到一个世界正在持续运行。
这种体验的关键在于:无论世界里有多少种物体,系统都会回应玩家的行动,并且符合物理规律。规则稳定,玩家才有可能根据经验作出预测;多条规则相互作用,又会产生未被逐一写死的解法。一个可信的虚拟世界,因而同时包含状态、变化、交互与反馈。
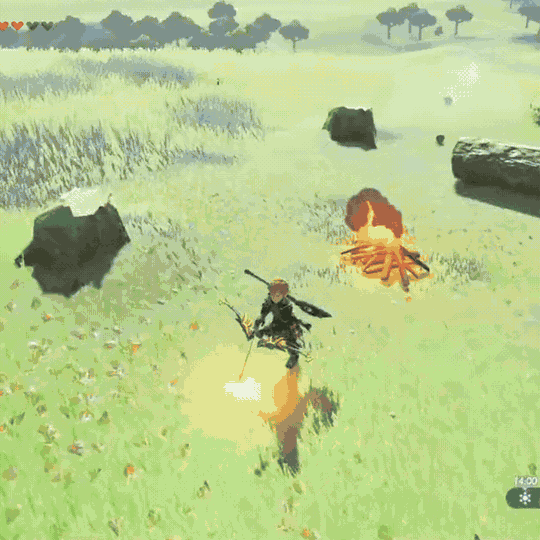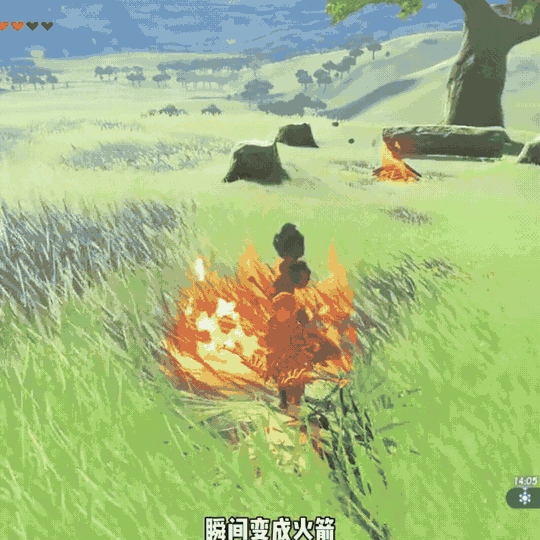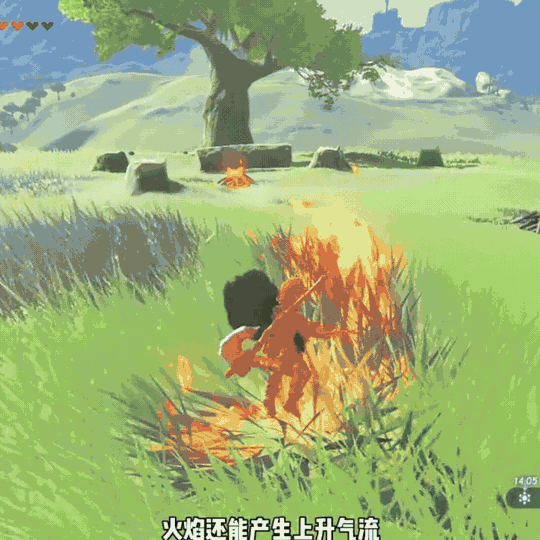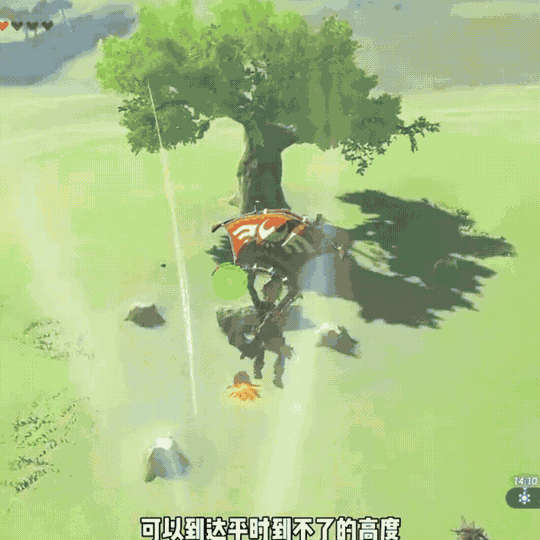
素材出自抖音博主「丑丑鱼-主机游戏」。
《塞尔达》当然不是机器学习语境中的世界模型。前者的规则主要由设计师与工程师显式构建,后者则试图从数据和交互中学习状态、行动与后果之间的关系。两者机制不同,但指向了同一种直观体验:一个世界之所以成立,并不是因为它看起来真实,关键是它能够对行动作出符合物理世界的回应。
这也是理解世界模型的一个有效入口。世界模型不是更大规模的视频生成器,也不是把图像、视频、三维空间和机器人排列在同一张矩阵图里。它需要形成对世界状态及其变化规律的表征,并进一步支持预测、规划或行动。
智象( HiDream.ai )将新发布的 HiDream-O1-Video-1.0(下文简称为 HiDream V1)定义为“更懂真实世界的视频生成模型”,并把它放在“一个 UiT( Unified Transformer )、四大模型同源演进”的世界模型路线中。按照官方介绍,模型具备前置多模态意图理解、5—20 秒动态时长、1080P 输出、物理变化生成和原生音画等能力。Video 在这套叙事中的作用,是让静态空间进入时间:模型不仅要呈现世界是什么样,还要表达一个动作发生后,世界将如何变化。
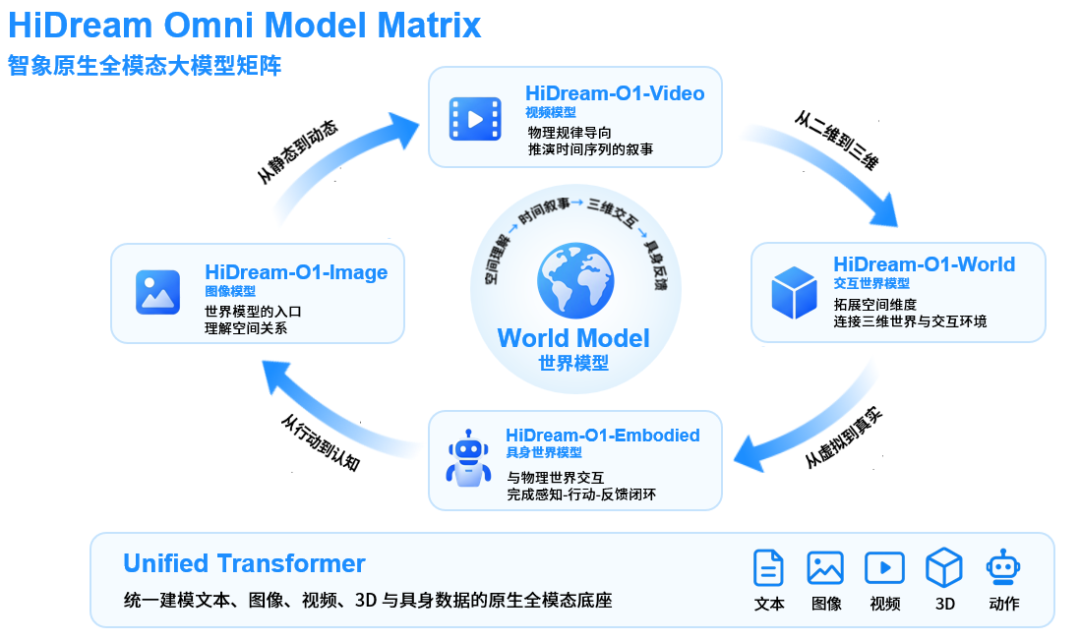
不过,视频模型本身并不是完整的世界模型,一段符合常识的成片也不能证明模型已经形成了可泛化的物理认知。要判断“更懂真实世界”是否超越传播口号,仍然需要回到可观察的输出。
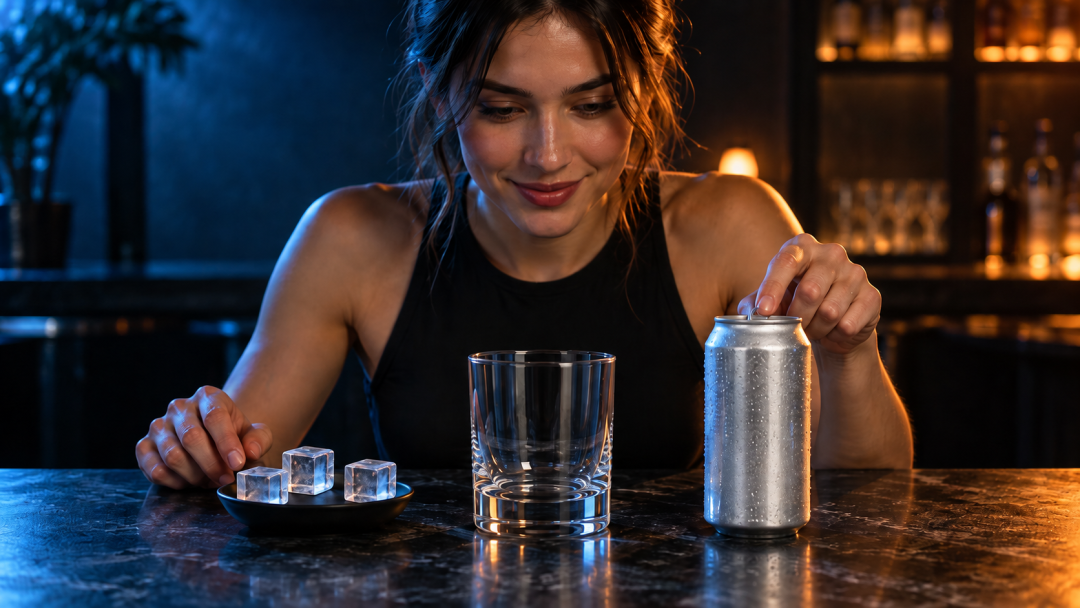
比如在下面这个场景中,拉环尚未弹开,气泡声是否已经提前响起;可乐在手中晃动是否符合液态规律。
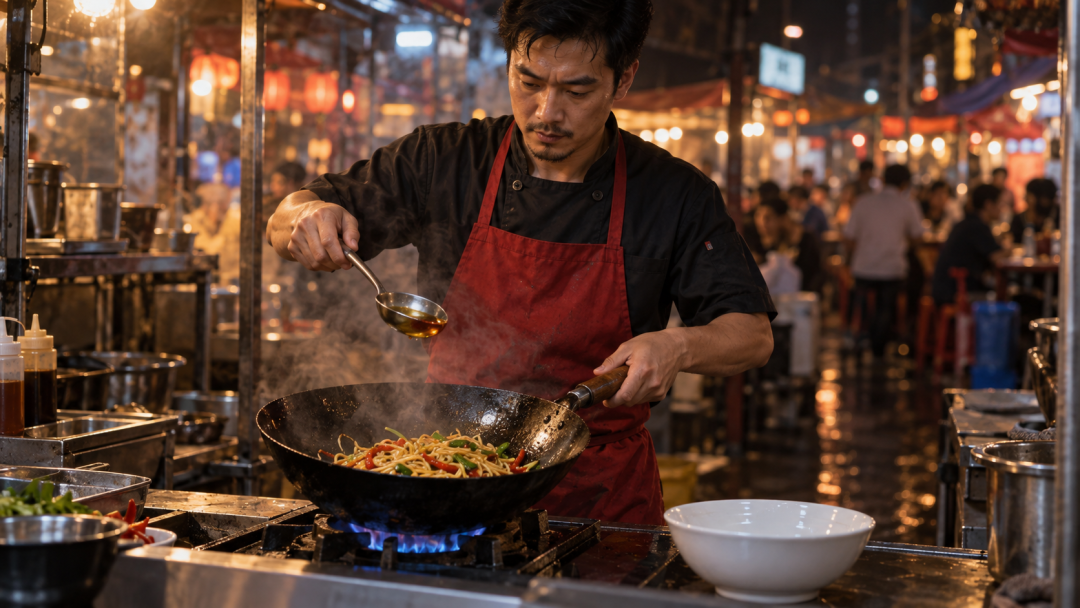
比如在炒菜的场景里,料酒还未落入热锅,火焰是否凭空升起:
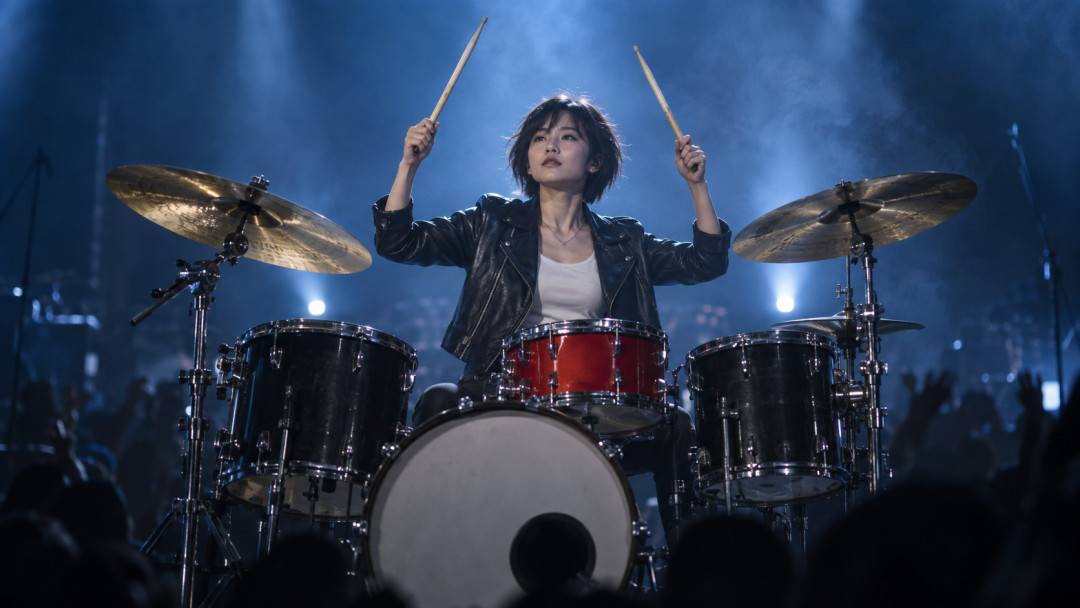
比如鼓槌没有接触鼓面,鼓声是否已经出现。
宏大的世界模型命题,最终需要从这些最小的状态变化开始接受检验。
01 我们怎么测试“世界有没有正确回应”?
今天的视频模型已经能够稳定生成大量运动效果:镜头推进、人物转身、头发飘动、烟雾扩散与火焰变化都不再罕见。但画面存在运动,并不等于模型完成了一个事件。完整事件至少包含三个层次:首先是对象发生运动,其次是动作按顺序产生结果,最后是视觉、声音与状态变化都能找到对应原因。
大量生成结果仍会停留在第一层。它们通过运动模糊、镜头晃动、火焰和烟雾制造强烈动感,却可能漏掉关键动作、改变对象身份,或让结果早于原因发生。对用户而言,这类视频的单帧质量可能很高,但只要连续观看,世界的规则就会迅速失效。
为验证 HiDream V1 的能力,本文设计了三组原创图生视频任务,并与 Seedance 2.5、MiniMax H3 进行对比。三家使用相同参考图和原始中文提示词,目标时长统一设为 10 秒(三家实际交付时长并不相同,见下方规格说明),开启原生音频,并保留各平台正常面向用户的默认理解与提示词处理流程。测试关注的不是单一画质分数,而是意图规划、时间因果和音画对应三个维度。
这并非纯底模的实验室测试,而是同图、同原始需求、同目标时长的端到端产品对比。三家的前置理解、提示词增强和服务系统存在差异,这些差异本身也是产品能力的一部分。
实测环境:三家实际平台与完整模型版本
- HiDream-O1-Video-1.0——HiHarness
- Seedance 2.5——即梦
- MiniMax H3——MiniMax Design
实际交付规格:
- HiDream:1920×1080 / 30fps 恒定帧率;爆炒与可乐 10.07 秒,鼓手 7.93 秒
- Seedance:1280×720 / 实际 24fps(封装声明 60fps,PTS 为 3:2 间隔,非真 60 帧);三题均 8.00 秒
- MiniMax:2560×1440 / 24fps;三题均 7.96 秒
以下分析中涉及三家在分辨率、帧率与实际时长时运用了专业软件和模型辅助进行量化分析。
02 第一场:料酒落锅之后,火应该什么时候起来
第一组任务发生在夜市铁锅前。厨师先把一勺料酒泼入滚烫的锅中,油爆声出现后,橙蓝色火焰随之升起;随后连续颠锅三次,让面条、红椒和葱段腾空再落回;最后火焰收起,食材被装入原本空着的白瓷碗,铁勺敲击锅沿完成收尾。
火焰是这一场景中最醒目的视觉元素,也最容易掩盖问题。真正需要维持的是从料酒接触热锅、油汽被点燃,到颠锅、食材回落和最终装盘的连续关系。如果火焰早于触发动作出现,或者食材在高速运动中消失、变种,再强烈的视觉效果也无法证明事件已经完成。
这一任务还要求模型同时处理快速运动与对象一致性。三次颠锅需要形成可辨认的“腾空—落回”,锅中三类食材在运动前后应保持一致,最终白碗也应从空碗连续变为装有成品的状态。油爆、爆燃、金属撞击与敲锅声,则用于检验声音是否准确对应各自的动作节点。
Seedance 2.5
Seedance 的画面表现确实非常出片,整体运镜和色彩有讲究,天然会有“场景—主体—动作”的交代关系。从物理关系上看也有可圈可点的地方:料酒的加入过程很狂野,虽说有一半撒到了炒锅之外,但鉴于中餐大排档的制作过程非常依赖厨师风格,这种操作也不能算错,甚至有些节目效果,视效拉满。但面条在锅里的状态让人提不起食欲,整体不是根根分明的状态,而是一整个面团在锅里搅拌,也算不上对错,从最后出锅的效果看倒是前后一致的。
HiDream-O1-Video-1.0
HiDream V1 的出片非常优秀。料酒刚开始撒入后没有立即变化,炒勺移开之后再进画面,依旧是同一个东西;然后厨师开始颠勺,火苗才窜起来。整个面条在锅里被颠起来的上松下紧效果,已经极其接近物理世界的状态。包括最后面条入碗的流动状态,是主体面条“滚进”碗里,最后锅里残留几根,并不是一股脑滑进去的。并且锅具放回灶上的时候依旧有合理的碰撞声。
MiniMax H3
MiniMax 的起火位置有些偏,但锅具和灶台的撞击点音画配合挺好,每一次都精准卡进去了,非常符合大众的认知。只是最后装盘时,模型没理解面条这种材质应该怎么表现,视频上像是直接快速位移搬运过去的,并不是面食这种黏度较大的组合物品自然流到碗里。如果细看还会发现面条在锅里颠勺的过程也像是一个整体的面饼在移动,不是有层次的。
把三家放到同一条时间轴上,就可以把起火这个节点量化核对。HiDream 是炒勺 2.4 秒重新进入锅内、油爆声 2.5 秒达到峰值、火焰面积 2.6 秒进入最快增长,动作、声音、结果依次相隔约 100 毫秒。
Seedance 是 0.25 秒泼酒、0.54 秒起爆声、0.58 秒起火,顺序同样成立,只是整体节奏被压缩到前半秒。
MiniMax 则是 1.5 秒起火、2.26 秒才出现对应的高频爆声,火焰比声音早了约 0.5 秒;而且火苗位置明显偏离锅心,与锅内食材不在同一处。起火点和燃料不在一起,这比时序偏差更根本。
火焰规模的差别也很大:Seedance 峰值占到画面 54.7% 并持续四秒多,几乎把颠锅和食材全遮住;HiDream 峰值 36.2%;MiniMax 只有 30.6%,而且只烧了 0.6 秒就熄灭,不太像料酒爆燃应有的衰减过程。火焰越大越容易掩盖事件本身,这一题里 Seedance 恰好演示了这一点——最壮观的四秒,也是最看不清发生了什么事的四秒。
出锅场景里,HiDream 的转移持续约 0.9 秒(7.5—8.4 秒),面条呈连续流态滚入碗中,到 9.3 秒时锅壁上仍挂着几根葱段没有倒净。不完全转移反而是真实厨房里的常态。Seedance 的转移约 0.5 秒,面条在碗中逐步堆积,过程连续,但整体是一团黏聚的面块。MiniMax 的转移只用了约 0.42 秒,且面团在下落过程中几乎不发生形变,是整块平移下去的,确实更接近搬运而不是倒出。
03 第二场:鼓槌落下之后,声音能否准时出现
第二组任务是一段舞台鼓手的演奏收尾。鼓手先在中央红色军鼓上连续击打两次,再依次敲击左右两只黑色通鼓,踩下一次底鼓,最后双臂交叉击中两面金色镲片。最终一击落下时,冷蓝色舞台灯切换为红色,观众欢呼,人物以举起两根鼓槌的姿势结束。
这组任务把音画同步拆成了可以逐项核对的动作。军鼓、通鼓、底鼓和镲片具有不同音色,每个声音都应当在对应鼓面或脚踏被击中的时刻出现。镲片长鸣可以延续,但必须由先前的击打触发;灯光切换与观众欢呼,也应在最后一击后进入高潮,而不是提前出现。
快速演奏同时提高了人物和器材一致性的难度。两根鼓槌需要在双手交叉、人物甩头和镜头推进中保持数量与归属,鼓手面部、服装和鼓组位置也不能因遮挡发生漂移。这类任务可以检验模型是只生成一层泛化鼓点,还是能让声音、动作与舞台反馈进入同一条时间序列。
Seedance 2.5
Seedance 在“起手才有声”这件事上做得最好:音轨前 450 毫秒只有环境底噪,第一次能量跃升出现在 0.47 秒,画面里双槌首次落到鼓面是 0.5 秒,两者基本重合。真正的问题出在最后一击。4.66 秒落下的时候,双槌收在军鼓与通鼓一侧,并没有打到左右两面金色镲片;这一击的频谱里 43% 的能量压在 120Hz 以下,6kHz 以上几乎为零,听感是一记低频闷响,不是镲片的宽频炸裂。
紧接着 50 毫秒后,画面里双臂完全放下,4.71 秒左右的下一帧,灯光已从冷蓝整片切成红色、双臂变成完全举起、景别同时前推。帧间变化量达到全片中位数的 11.3 倍。手臂在 50 毫秒内从最低点回到最高点,在物理上不成立。所以这不是“灯光跳变”,而是一次硬切。提示词要求的“双臂交叉击中两面金色镲片”这个动作,被这次剪切跳过去了。
切点之后还叠了一段持续低频轰鸣,总能量是最后一击本身的 2.6 到 5.9 倍,频谱重心压在 sub 频段(0.79—0.86),更像影视预告片里的低频冲击音效,而不是提示词要的观众欢呼——人声频段要到 6.5 秒之后才出现。整条音轨的带宽也是三家最窄的,7.9kHz 之上基本截断,高频能量比另两家低一个数量级,鼓组整体音色因此偏钝。
收尾姿势与人物一致性没有问题:两根鼓槌数量全程正确,最终停在举槌姿态,面部与发型和参考图一致。
HiDream-O1-Video-1.0
HiDream 是三家里唯一全片没有出现硬切或突变帧的一条:帧间变化量最大值也没超过中位数的 5 倍,整段是一次连续推镜。军鼓—通鼓—底鼓—双镲的顺序成立,击打位置、时间与音色能对应上,鼓槌、双手、人物脸与鼓组的一致性也没问题。但视频开头鼓手还没动手,就出现了镲击声。
最后一击的处理,是它和另两家分开的地方。4 秒左右双臂向左右完全展开、落点在两侧镲片高度,这一击的频谱是真正的宽频(sub 0.26 / low 0.36 / mid 0.24 / hi 0.10 / vhi 0.03),能分析出镲片而不只是鼓皮。灯光从 4.5 秒开始升温,4.7 秒越过冷暖分界,整个过渡约 270 毫秒完成,变化速率 +2.11/秒。也就是说击打先发生,灯光在大约 200 毫秒后跟上,是渐变而不是跳切。人物还保留了独立于红色背景的打光。
尾段 5.5—7.9 秒的音轨里,96% 以上的能量集中在 400—2000Hz 的人声频段并持续了三秒半,画面下方同时出现观众举起的手——欢呼场景是真的被生成出来了。结束姿势是举起两根鼓槌,与提示词一致。整条音轨里中频占 47.8%、低频只占 9.3%,是三家中最接近真实鼓组音色的一条,棒击的 attack 和镲片泛音都在。
MiniMax H3
MiniMax 这一条的单帧规格最高(1440P),但事件层的问题也最多。
首先是结构。全片在 2 秒、4 秒、6 秒各有一次硬切,帧间变化量分别是中位数的 6.4、9.7、8.7 倍,间隔几乎正好两秒。这更像是按两秒片段拼接后接起来的,而不是一次连续演奏。
其次是音色。开场 0.1 秒左右就有一记极大的低频撞击,通过定量分析发现能量是前 50 毫秒底噪的三十八万倍,但 93% 的能量落在 120Hz 以下,是近乎纯低频的闷响;而提示词此处要求的是先击中央红色军鼓两次,军鼓应当有脆亮的中高频。放到全片看,78.5% 的能量都在 400Hz 以下,能检出的高频事件只在 6.32—6.56 秒出现过一次。也就是说前六秒多的演奏里,几乎没有棒击的 attack,也没有镲片。
灯光的表现有一点复杂。末击在 6 秒左右出现,冷暖越界要到第 7 秒,滞后几乎有一秒,这已经进入人能明确感知不同步的区间;而且红光最终只走到 +0.16,另两家是 +0.39 和 +0.42,所以红色既晚又没到位,转换速率也是三家最慢的 +1.29/秒。
04 第三场终极大考:老板来杯可乐加冰
第三组任务是一段冰可乐 ASMR。人物需要拉开覆满水珠的银色易拉罐,在“咔嗒”之后听到绵长的气体释放声;随后把三块冰倒入空杯,注入深褐色可乐,让气泡和泡沫沿杯壁上涌;最后端起杯子晃动两次,喝下一大口并呼气收尾。
提示词:一镜到底的冰可乐 ASMR,节奏利落。年轻人先“啪”地拉开冰凉的易拉罐,清脆的“咔嗒”后立刻冒出一声绵长的“嘶——”,细密泡沫冲到罐口。紧接着,他把碟里的三块冰快速倒进空杯,响起连续的“叮、当、咚”;马上把深褐色可乐冲进杯里,气泡沿玻璃杯壁疯狂上涌,泡沫贴近杯口但没有溢出。随后他端起杯子猛晃两下,让冰块密集撞击杯壁,再仰头咕噜喝下一大口,放下杯子痛快地“哈——”一声。镜头顺着手部动作小幅跟移,只保留拉环、气泡、冰块、吞咽和呼气这些现场声,不要背景音乐。
这段 Prompt 刻意没有写入:人物不能变脸、冰块不能增减、杯子不能变形、所有动作必须完成。因为这些不是用户故事,把这些变量交给模型去处理,更能看出模型对真实世界的理解。
这个场景包含连续的状态转换:易拉罐从密闭变为打开,空杯先装入冰块,再被可乐填满,最终又被人物端起并饮用。声音同样具有明确顺序,从拉环、气泡、冰块碰杯、液体注入,一直延伸到吞咽和呼气。这个测试任务最难的是冰块的转换要从碟子里往杯子中过渡,并且人物手拿杯子的时候还要摇晃一下,相当考验模型对真实世界的理解能力。
测试的重点主要是对象状态是否真正随动作变化。比如可乐应当从罐口连续流入杯中,不能在遮挡后凭空出现;冰块、泡沫与液面应当受到注入和晃动影响;人物饮用前后的杯中液体也应保持连续。
Seedance 2.5
Seedance 2.5 的风格挺明显,是有成熟视听语法的高情绪短片。易拉罐被拉开的声音处理得很细腻,分了好几段来表现扣开、拉扯、掀开喷气的几个过程。但是冰块入杯的声音很奇怪,不符合冰块逐点下落的事实,是黏在一起的一连串声音,有点强行找素材配上去的感觉。冰块进杯子之后也从三块变成了四块,逐帧看得很清楚:2.83 到 2.96 秒稳定是 3 颗,到 3.10 秒变成 4 颗,而此时碟子已经移出画面,没有任何第四颗入杯的过程——是凭空多出来的。并且在摇动杯子时,液体的晃动程度不符合物理规律,明显感受到液体的黏稠度,晃动幅度较小。片尾也没有遵循提示词中“放下杯子”的硬约束:到 7.97 秒最后一帧,杯子仍然端在手里。
HiDream-O1-Video-1.0
HiDream-O1-Video-1.0 的液体晃动情况就好很多,符合可乐这种低粘度液体的摩擦力应有的反应,也遵循了提示词中的所有约束,包括 Seedance 丢掉的那一条:9.3 秒把杯子放回台面、手离开杯身,随后张口呼气,音轨的最大能量峰值就落在 9.5 秒,能和这个动作对齐。但在冰块数量上依旧翻车了——碟子上清晰看到三块冰,落进杯子之后变成了五块。
MiniMax H3
有意思的是,MiniMax 对自己的生成结果进行校验时,发现结果出现多次明显剪切,开罐、倒冰、注液、摇杯和饮用分别使用了不同景别与机位,于是重新申请生成一次。也就是说重做的目的瞄准的是一镜到底,不是符合物理规律。
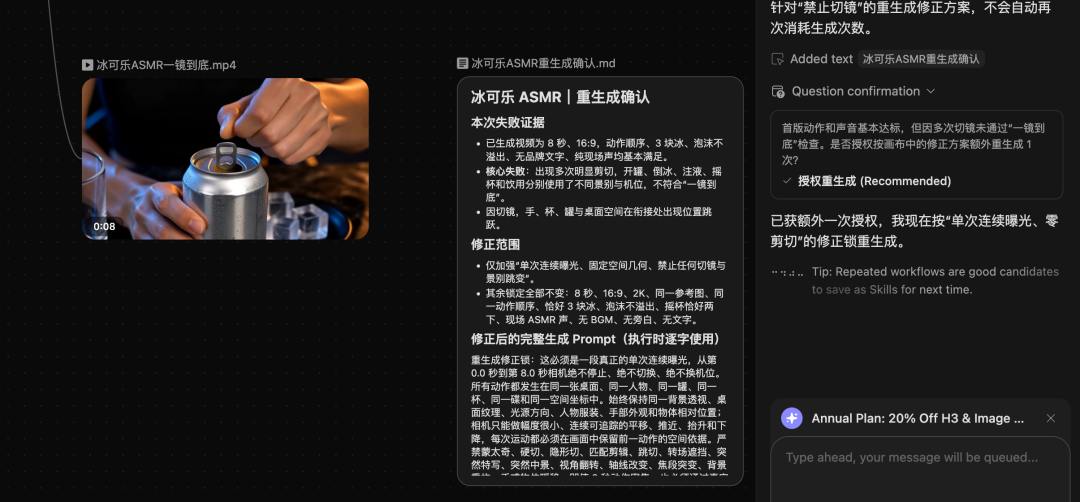
这是重制版:
MiniMax H3 重新生成的视频虽然是一镜到底了,但仍在 4 秒左右处留有一次明显的动作断裂(帧间变化量为中位数的 6.7 倍)。这是修正版里唯一的突变点,比初版的十余处已经收敛很多。
修正版的端点数量其实是对的:碟中 3 颗,落定后 3 颗。问题不在数量而在材质稳定性。冰块在飞行途中会糊成没有棱角的白色团块,可见颗数一度掉到 2 颗,落到杯底才重新收敛成三颗有棱有面的方冰。初版的碟子上一开始就摆了 4 颗以上,并且开罐、倒冰之间还夹着多次景别切换。(但说实话,初版的冰块摇动声音是最好听的。)
Seedance 给液体设置了过高的等效阻尼,或者根本没有成功把液体作为独立于杯子的动态对象来处理。它明显压缩了摇杯动作,液体、泡沫与冰块近似随杯体整体移动,呈现出过度阻尼的糖浆感。
HiDream 更好地表现了低黏度液体受杯体加速后的惯性滞后、液面形变与余振。
05 “先理解,再生成”正在成为完整系统能力
按照智象的介绍,HiDream V1 在生成前设置了多模态意图理解模块,将用户口语化、碎片化的输入整理为镜头时长、场景、人物、动作、声音和转场等结构化规划,再交由视频生成核心执行。这套机制的价值,在于能大幅减少动作遗漏、顺序错误和对象关系错配。
因此,判断前置理解是否有效,需要同时观察规划和结果。若结构化规划已经正确识别动作顺序,而最终视频没有执行,问题主要发生在生成阶段;如果规划本身就遗漏关键动作或改变因果顺序,则说明意图理解仍未稳定。把规划与执行分开分析,比笼统讨论“指令遵循”更有助于定位模型能力。
音画生成也需要遵守同样的证据边界。智象称 O1-Video 采用文本、视频与音频联合建模,使声音和画面在同一次生成中相互约束。
输出表现则已经拥有外部坐标。Artificial Analysis 的 Image-to-Video with Audio 榜单是面向带音频图生视频的独立 Elo 池,HiDream 在其中进入第一梯队,说明其完整音画成片获得了较高的人类偏好评价。
06 HiDream 距离“世界模型”还有多远
▪ 第一梯队的竞争,正在从能力清单走向路线分化
截至 2026 年 9 月 15 日,HiDream-O1-Video-1.0 在 Artificial Analysis 带音频图生视频榜上名义排名第 4,Elo 为 1186;考虑置信区间后,更稳妥的表述是处于第 3—6 名区间。
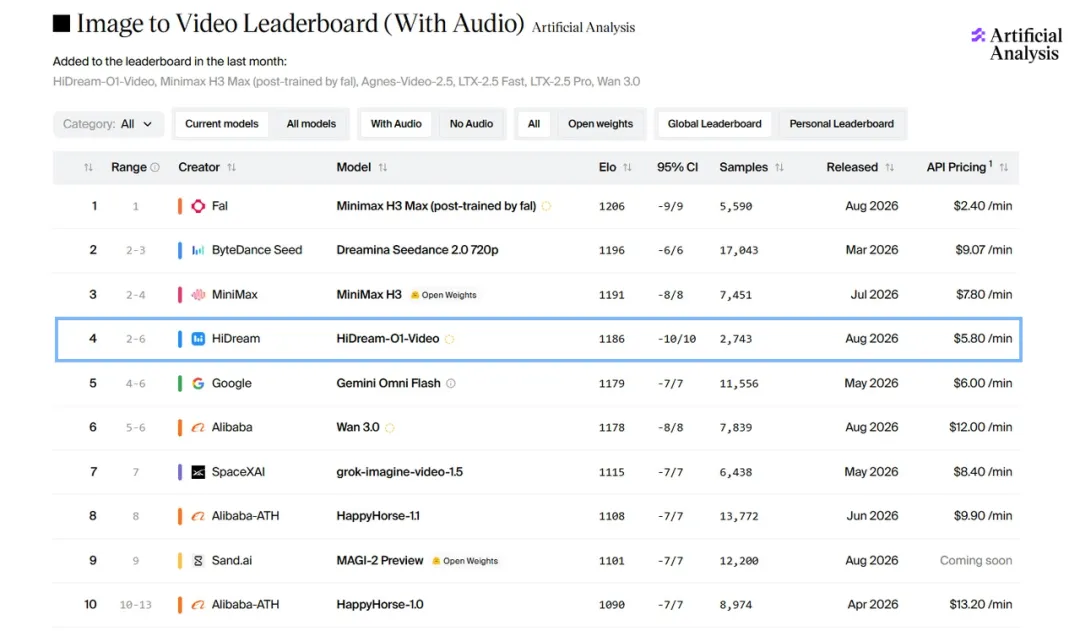
在 Arena Image-to-Video 榜上,它暂列第 8,置信排名约为第 6—10 名。
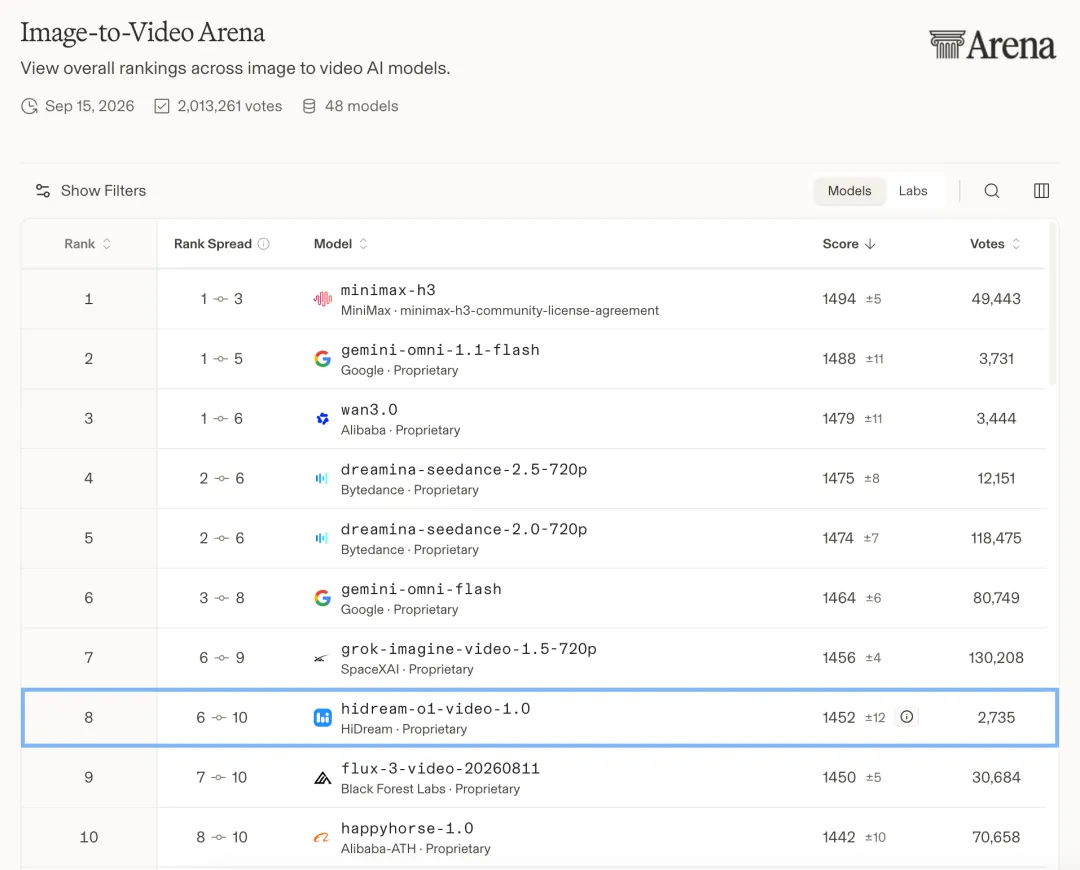
两项成绩足以说明智象 HiDream 已进入全球视频生成模型第一梯队。放到国内看,它与 Seedance 2.5、MiniMax H3 和阿里 Wan 3.0 一同构成了这一轮原生音画视频生成的头部阵容。
更值得关注的是,三家已经在不同方向上建立产品路线。Seedance 2.5 将原生单段时长扩展至 30 秒,支持大量多模态参考,并把生成、编辑和延长纳入同一生产流程,其重点是服务复杂内容创作。MiniMax H3 则开放了 33B Base 权重,同时以 Context-IR 负责多模态意图解析,并通过 Regenerate-2K 处理高分辨率输出;fal 基于开放权重进一步后训练出 H3 Max,也表明基础模型、第三方后训练与推理服务正在成为不同的竞争层次。
HiDream 的选择是前置意图理解、内容驱动时长,以及把 Video 纳入图像、交互世界和具身模型组成的更大体系。 由此可以看到,原生音画已经逐渐成为第一梯队的共同能力,“先理解、再生成”也不是单一厂商独有的方向。差异最终仍需体现在输出中:声音是否服从动作,时长是否服从内容,结果是否服从原因。
▪ 三篇研究构成技术储备,但不是产品配方
智象在 HiDream V1 的技术叙事中重点介绍了 DMSampler、DiffusionCompass 和 EvoID 三项 2026 年顶会研究。三者可以组成一条视频 Diffusion RL 后训练路线,分别回应训练成本、质量稳定和身份保持三个问题。
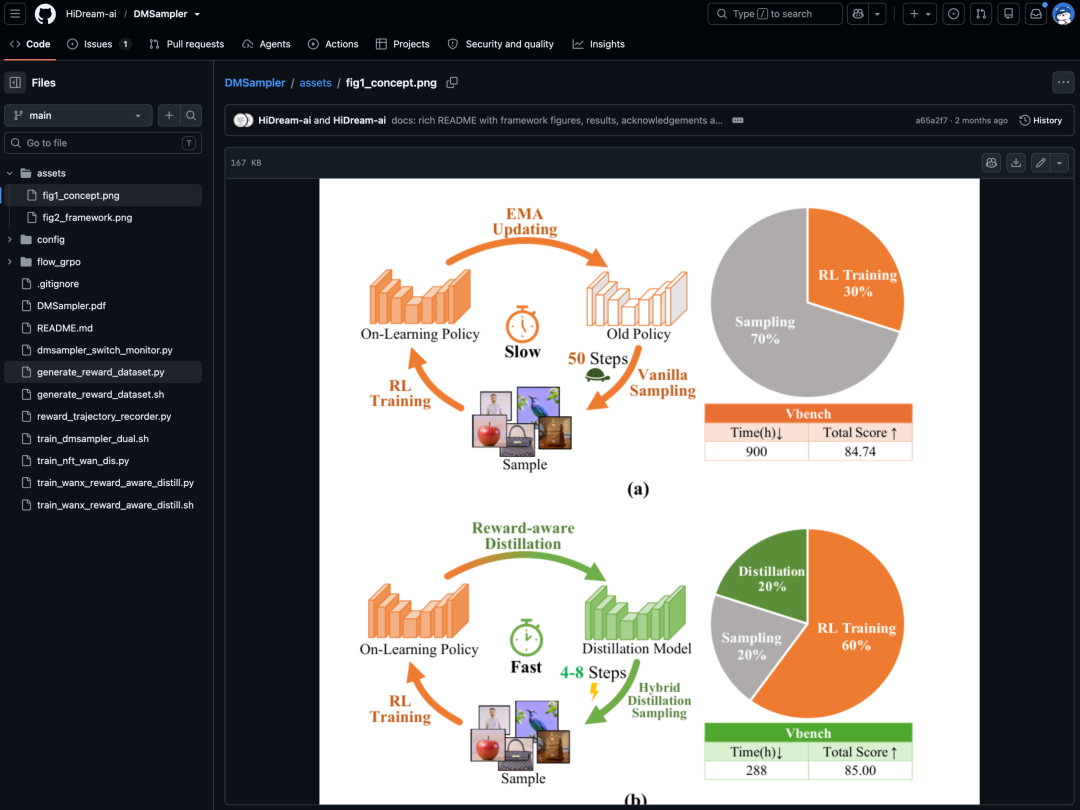
该图展示的是 DMSampler 如何压缩扩散强化学习的采样成本。传统流程中,采样约占训练时间的 70%;DMSampler 以持续重蒸馏的少步采样器替代高成本 rollout,将约 50 步压缩至 4–8 步。
来源:HiDream × 中国科学技术大学,ICML 2026。
视频强化学习首先面临高昂的采样成本。一次 rollout 需要完成整段视频的扩散去噪过程,远高于单张图像的生成开销。DMSampler 尝试将奖励评估采样从大约 50 步压缩至 4—8 步,使 rollout 成本下降一个数量级,为视频 Diffusion RL 的规模化训练提供基础。
在此之后,DiffusionCompass 使用 off-policy 高质量样本锚定 on-policy 探索,降低模型追逐奖励时出现质量漂移的风险;EvoID 则将身份保持、运动自然度与时间一致性纳入强化学习优化。从研究逻辑看,它们形成了“降低试错成本—稳定探索质量—优化时间一致性”的连续路径。
▪ Video 补上的是时间维度
按照智象的世界模型路线,HiDream-O1-Image 用于表达静态空间,HiDream-O1-Video 加入时间、动作与音画变化,HiDream-O1-World 进入可探索的三维环境,HiDream-O1-Embodied 则让模型在现实中行动并接收反馈。四个位置分别对应世界“是什么样”“如何变化”“能否进入”和“能否被行动改变”。
Video 的意义并不只是增加一种内容格式。图像可以呈现玻璃杯、铁锅和架子鼓,却不需要回答可乐倒入后液面如何升高、料酒接触热锅后火焰何时出现、鼓槌击中不同鼓面时应当发出什么声音。视频把静态空间放进时间,迫使模型处理状态转换、事件顺序、对象一致性和同步反馈。
这也解释了为什么视频是世界模型路线中不可缺少的一环:它承载的是世界如何随时间变化。但需要强调的是,生成正确的时间顺序不等于模型已经形成可泛化的因果认知,符合物理直觉的样片也不能证明模型能够进行反事实推理或真实世界预测。视频输出可以作为行为层证据,世界模型则是更大的架构。
“一个 UiT 底座、四模型同源演进”构成了这条路线的骨架。后续值得观察的是:四个模型能否使用可迁移的共同表征,能否在彼此之间传递状态与约束,以及虚拟环境中获得的经验能否进入真实行动。只有这些关系逐步建立,四个模型才有可能从并列产品走向真正协同的世界模型体系。
07 世界模型,最终要接受最小事实的检验
回到三组任务。HiDream 真正做到的是“行动在前、回应在后”这条关系,比如料酒入锅 2.4 秒、油爆声 2.5 秒、火焰 2.6 秒;或者末次击鼓 4.365 秒、灯光转红 4.567 秒;以及三块冰逐颗落杯、数量前后一致。
《塞尔达传说》里面之所以像一个世界,不仅因为它拥有更多山川或更接近现实的材质,而是因为点燃草地之后,火焰、热气与滑翔会沿着稳定规则依次发生。玩家可以基于这些规则进行预测和试探,并获得连贯反馈。
但是世界模型的目标远比一套游戏规则复杂,HiDream-O1-Video 仅仅是智象世界模型路线中的一个组成部分。不过理解世界无论被扩展到多大,最终都会回到我们上面演示的这些具体变化:拉环弹开后,气泡是否响起;料酒落锅后,火焰是否升起;鼓槌落下后,鼓声是否到来。
世界模型的宏大,不在于它能生成多大的世界,而在于它能否回答好每一次最小的变化。只有经得起这些具体事实的检验,模型生成的才不只是一段视频,而是一个真正成立的世界。
 发表于 昨天 23:45
|
查看: 1|
回复: 0


