凌晨三点,一个女同事和男同事还在烧烤店里。
问题是,她有男朋友,却一直告诉男同事自己单身。男同事以为双方都是自由状态,关系越走越近。最后男朋友直接找到了烧烤店,三个人当场碰面。
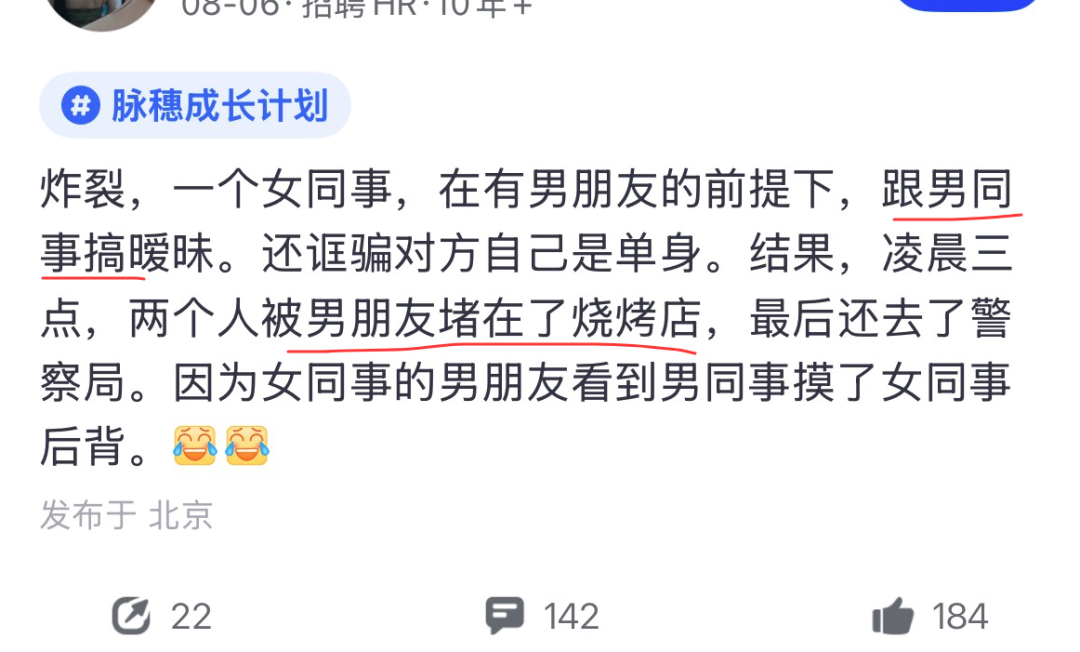
这件事里最麻烦的不是“暧昧”两个字,而是有人拿着错误信息做了后续决策。
做系统时,我最怕的就是这种问题。
一个状态如果从源头就是假的,后面的缓存、消息、数据库哪怕全部正常工作,也只是在非常稳定地传播错误。
技术上最典型的一类事故,就是:缓存和数据库状态不一致。
一个订单,怎么同时出现两个状态
假设订单服务有个查询接口:
public OrderView query(long orderId){
    String key = "order:" + orderId;

    OrderView cached = redis.get(key, OrderView.class);
    if (cached != null) {
        return cached;
    }

    Order order = orderRepository.findById(orderId);
    OrderView view = OrderView.from(order);

    redis.set(key, view, Duration.ofMinutes(10));
    return view;
}
很普通。
Redis 有数据读 Redis,没有就查 MySQL,再回填缓存。
现在订单支付成功:
@Transactional
public void pay(long orderId){
    orderRepository.markPaid(orderId);
    redis.delete("order:" + orderId);
}
看着也没什么问题。
但线上并发一上来,时间线可能变成这样:
T1  查询请求:Redis miss
T2  查询请求:读取 MySQL,status = UNPAID

T3  支付请求:UPDATE status = PAID
T4  支付请求:DELETE Redis

T5  查询请求:把刚才读到的 UNPAID 写入 Redis
最终状态:
MySQL : PAID
Redis : UNPAID
数据库已经支付,缓存却告诉后面的请求:
{
"orderId": 92831,
"status": "UNPAID"
}
如果前端相信它,可能继续展示“立即支付”。
如果下游业务相信它,甚至可能再次发起支付流程。
这类问题烦就烦在:每一行代码单独看都没错,组合起来才出事。
看到这里先别急着把缓存时间从10分钟改成1分钟。
TTL只能缩短错误存活时间,不能解决并发窗口。
我更愿意把“删缓存”放到事务提交之后
先改支付代码。
不要数据库事务还没提交,就急着操作 Redis:
@Transactional
public void pay(long orderId){
    int affected = orderRepository.markPaid(
        orderId,
        OrderStatus.UNPAID,
        OrderStatus.PAID
    );
    if (affected != 1) {
        throw new IllegalStateException(
            "order status changed, id=" + orderId
        );
    }
    TransactionSynchronizationManager
        .registerSynchronization(new TransactionSynchronization() {
            @Override
            public void afterCommit(){
                redis.delete("order:" + orderId);
            }
        });
}
SQL也别写成无脑 UPDATE:
UPDATE t_order
SET status = 'PAID',
    paid_at = NOW(),
    version = version + 1
WHERE id = ?
AND status = 'UNPAID';
这里至少解决两个问题。
第一,事务最终回滚时,不会提前把缓存删掉。
第二,状态迁移带条件:
UNPAID -> PAID
两个支付请求同时进来,也只有一个能成功修改。
但问题还没有完全结束。
前面那个并发查询仍然可能拿着旧数据,在支付事务提交以后回填缓存。
所以我一般还会给缓存里的业务数据带版本。
public record OrderCache(
    long id,
    String status,
    long version
){}
数据库:
id      status    version
92831   PAID      18
某个慢查询准备回填的旧对象:
id      status    version
92831   UNPAID    17
回填之前不能直接 SET。
可以用 Lua 做一次版本判断:
local current = redis.call('GET', KEYS[1])
if not current then
    redis.call('SET', KEYS[1], ARGV[1], 'EX', ARGV[2])
    return 1
end
local oldObj = cjson.decode(current)
local newObj = cjson.decode(ARGV[1])
if tonumber(newObj.version) >= tonumber(oldObj.version) then
    redis.call('SET', KEYS[1], ARGV[1], 'EX', ARGV[2])
    return 1
end
return 0
这样 version=17 的旧数据,不能覆盖 version=18。
当然,这个方案会增加复杂度。
如果业务只是普通商品详情缓存,我不会这么折腾。短 TTL + Cache Aside 基本够用。
但如果缓存的是:
支付状态
退款状态
库存占用状态
优惠券核销状态
账户冻结状态
我会更谨慎。
因为这时候 Redis 里的一个错误状态,不只是“页面显示旧了”。
它可能改变下一步业务行为。
真出问题,我不会先盯着 Redis 命中率
假设线上出现投诉:
用户已经支付成功,
页面仍然显示“待支付”。
先查数据库:
SELECT id, status, version, paid_at, updated_at
FROM t_order
WHERE id = 92831;
结果:
92831 | PAID | 18 | 03:01:42 | 03:01:42
再看缓存。下面是假设性的排查样例:
redis-cli GET order:92831
{
"id": 92831,
"status": "UNPAID",
"version": 17
}
问题已经缩小很多了:
DB version    = 18
Cache version = 17
接下来不是一句“缓存不一致”就结束,而是继续找谁最后写了这个 key。
应用日志最好一开始就留这些字段:
03:01:41.812 order_query
orderId=92831 dbStatus=UNPAID dbVersion=17
03:01:42.037 order_paid
orderId=92831 from=UNPAID to=PAID version=18
03:01:42.061 cache_delete
key=order:92831
03:01:42.093 cache_fill
orderId=92831 status=UNPAID version=17 cost=287ms
看到最后一行,基本就露头了。
不是 Redis 自己把数据“变旧”。
是一个执行了 287ms 的旧查询,在状态修改完成之后才回来,然后重新污染了缓存。
调用链大概是:
Request A
  -> Redis GET miss
  -> MySQL SELECT -------- 287ms --------+
                                          |
Request B                                  |
  -> MySQL UPDATE PAID                     |
  -> COMMIT                                |
  -> Redis DEL                             |
                                          |
Request A <--------------------------------+
  -> Redis SET UNPAID
所以排这种问题,时间线比一堆平均指标有用。
我还会补几个指标:
order_cache_fill_total
order_cache_delete_total
order_cache_version_reject_total

order_query_db_ms_p99
order_cache_fill_delay_ms_p99
如果:
order_cache_version_reject_total
突然从每分钟个位数涨到几百,先别急着庆幸“版本控制生效了”。
它意味着系统里正在大量出现旧请求覆盖新状态的竞争,只不过被你挡住了。
下一刀应该去查:
MySQL 慢查询
连接池 pending
数据库锁等待
线程池 queue wait
网络抖动
尤其别把:
接口耗时 = 400ms
直接理解成:
SQL执行了400ms
真实链路可能是:
线程池排队       110ms
等待数据库连接   160ms
SQL执行          35ms
对象转换          4ms
Redis写入        3ms
其他             88ms
如果 HikariCP 已经出现:
active=50
idle=0
pending=37
这时候继续优化那条 35ms 的 SQL,收益可能非常有限。
先找为什么连接被占满。
缓存一致性事故经常就是这样,一层套一层。表面看是 Redis 里出现旧状态,真正把并发窗口拉大的,却可能是连接池等待或者线程排队。
凌晨三点烧烤店那件事,最后怎么处理是当事人的事。
但系统里我不愿意留这种空间:状态可以延迟,但不能让旧状态在新状态之后重新取得话语权。
这才是缓存一致性真正需要防的东西。
 发表于 半小时前
|
查看: 2|
回复: 0


