Multi-Agent系统里某个 Agent 执行失败了,该怎么办?很多人的第一反应就是:多重试几次不就完了,最后总能成功吧?
我只能说,普通的只读接口这么干没问题,可在企业级 Multi-Agent 系统里也这么搞,真会分分钟被教做人。
举个例子:查询商品失败和退款执行失败,能用同一种处理方式吗?另外,网络超时、权限不足、参数缺失,这些情况真的靠重试就能解决吗?
真正的企业级方案,绝不止“重试”这一招。你需要根据不同的业务场景,选择与之匹配的策略。下面是我总结的七大处理方案。
01 非核心任务失败,隔离并降级
如果失败的 Agent 只负责辅助摘要、补充说明、推荐理由或者非必要图表,其他任务也不依赖它的输出,就没必要终止整个流程。
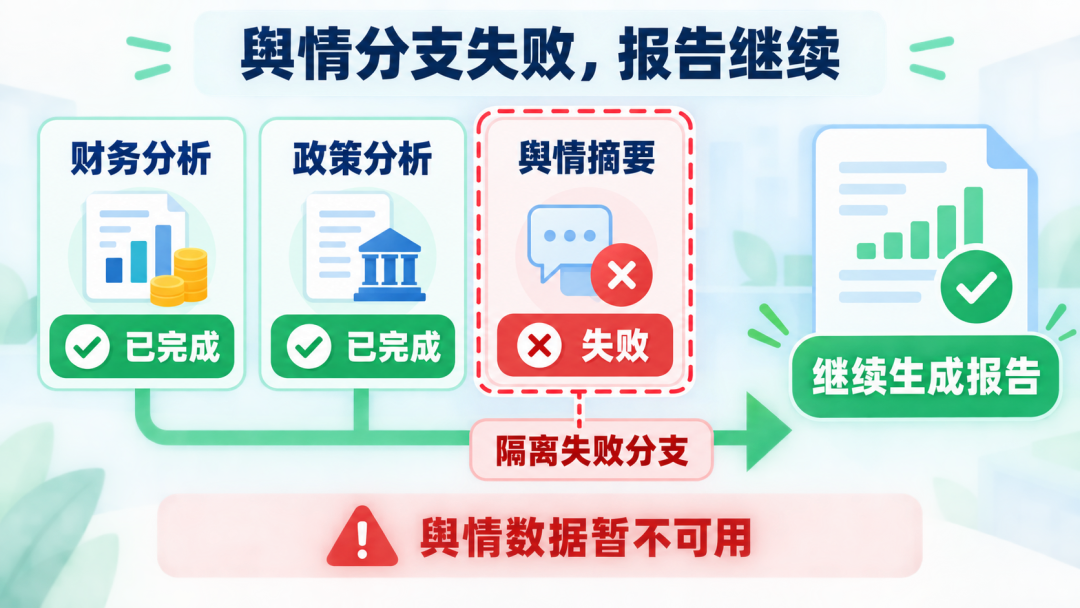
这类场景适合 “隔离失败分支 + 返回部分结果” 。目标是保证主任务可用,而不是要求每个非核心 Agent 都必须成功。
放到电商场景里就很好理解:某个无关紧要的商品标签没展示成功,你会因此让整个商品信息接口返回失败吗?不会,一个道理。
02 核心依赖失败,暂停下游链路
如果失败的是权限校验、订单查询、工单判定结果这类核心 Agent,它的输出是下游任务的必要输入,那相关链路就必须暂停。
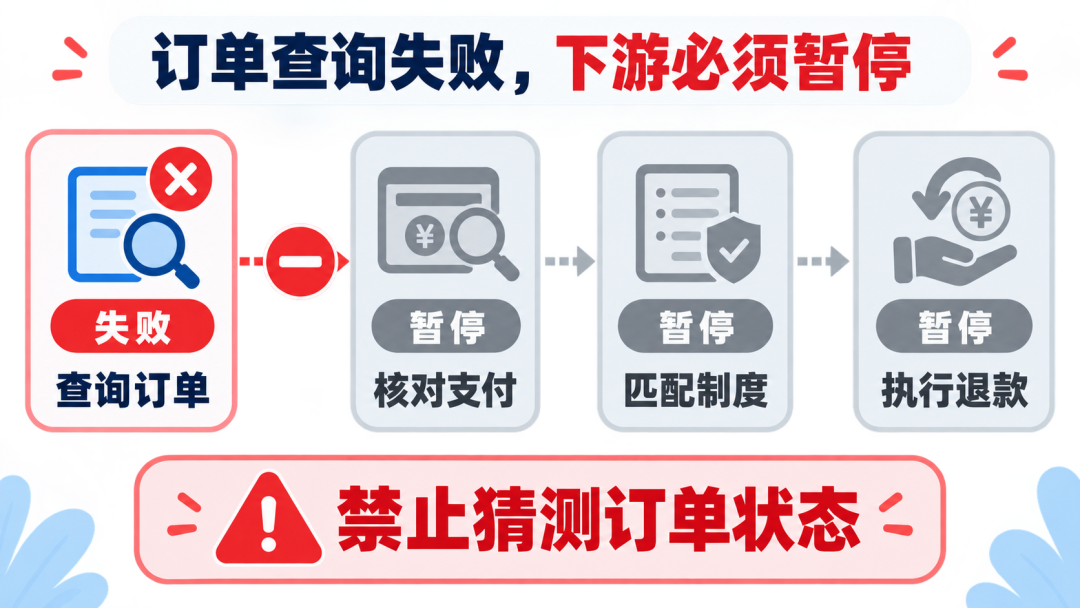
这类场景适合 “暂停依赖节点 + 保留独立结果” 。主 Agent 需要依据任务依赖关系,判断哪些节点受影响、哪些还能继续,而不是一刀切地终止所有 Agent。
核心依赖失败时,第一目标不是马上恢复,而是阻止错误向下游扩散——否则故障影响范围只会越来越大。
03 只读任务遇到临时故障,有限重试
如果 Agent 执行的是查询任务,没有修改业务数据,而失败原因是网络超时、连接中断、429 限流或者接口短暂抖动,那自动重试是合理的,说不定下一次就正常了。
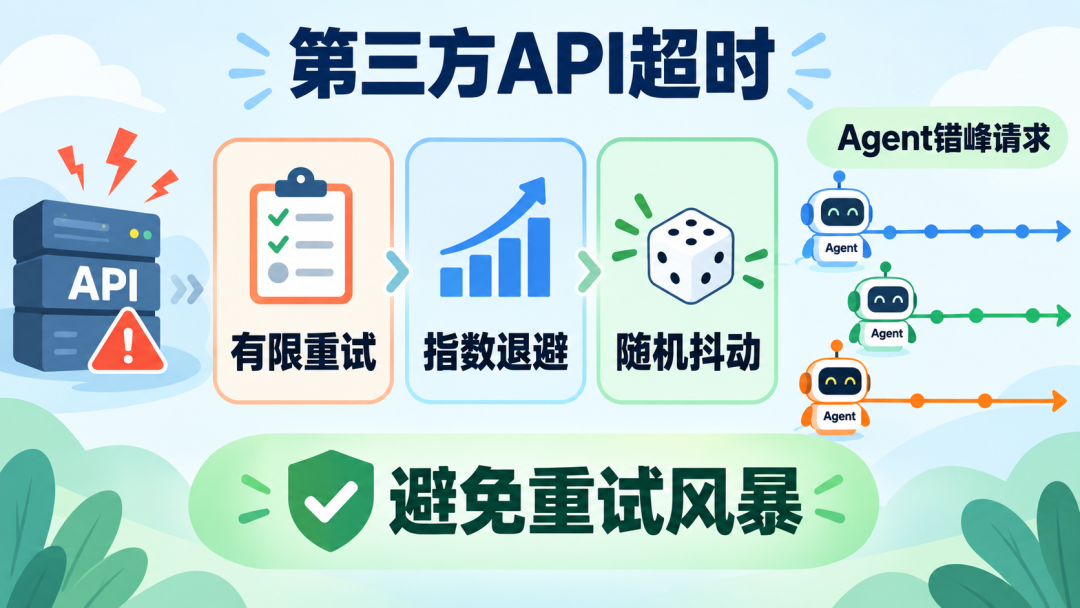
不过重试还要受 时间预算 和 Tool 调用预算 约束。比如任务最多允许等 5 秒,你就不能因为配置了三次重试,让整条链路都跟着卡住。
如果主接口重试几次都失败,可以切换到备用 API、只读副本或者缓存数据,这些都是有效的降级手段。
这类场景适合 “有限重试 + 备用数据源” ,因为只读操作重试不会产生副作用。
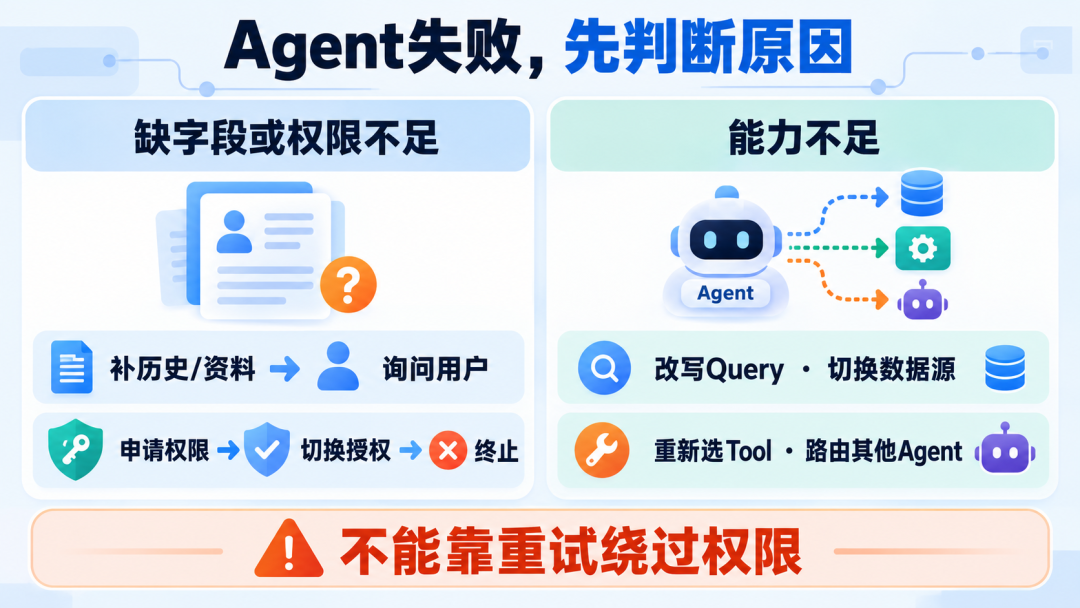
04 输入、权限或能力有问题,修正后再执行
如果失败原因是订单号缺失、参数格式错误或者上下文不足,无脑重试根本没有意义。第一次没有订单号,重试十次百次,Agent 也不会给你返回正常结果。
05 长流程中途失败,从 Checkpoint 恢复
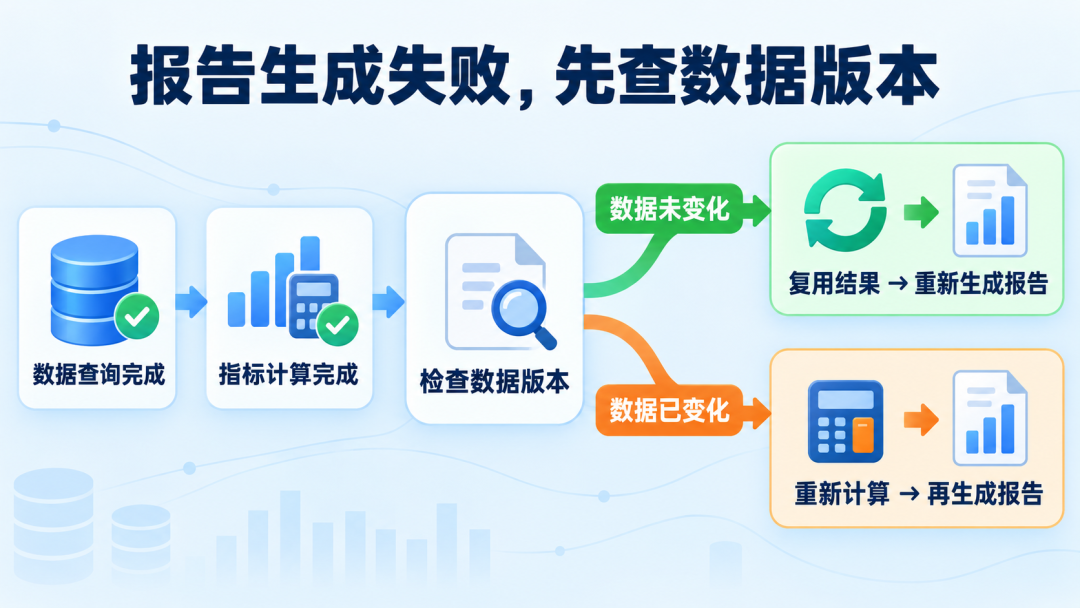
如果任务包含查询数据、计算指标、生成图表、编写报告等多个耗时步骤,执行到最后一步才失败,完全没必要从头再来。
系统可以在关键节点保存 Checkpoint(检查点),记录已经确认成功的步骤、上下文快照、Tool 结果和中间状态。恢复时从最近的 Checkpoint 继续执行就行,能显著减少重复计算和 Token 消耗。
06 写操作结果未知,查询、幂等和补偿
涉及退款、扣款、状态修改、创建工单、发放权益时,绝不能一看到超时就直接重试。
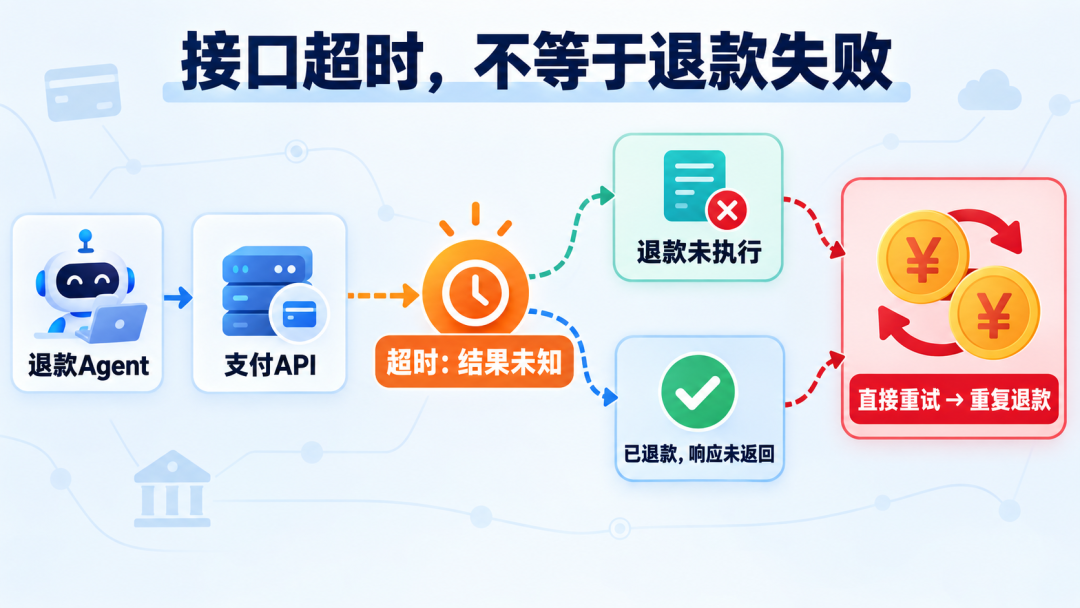
系统应该用业务单号、operationId 或者幂等Key去查询真实状态。确认未执行,才允许重试;确认成功,就继续后续流程;暂时无法确认,则进入对账状态并暂停自动执行。
写操作还要通过唯一约束、幂等Key 和状态机拦截重复请求。能回滚的执行回滚;无法回滚但能修正的执行补偿,比如关闭重复工单、撤销错误权益。
07 高风险或无法判断,转人工
如果任务涉及大额退款、账户冻结、敏感数据导出、合同审批、对外发布,即使 Agent 没有技术报错,也不代表就能自动继续。
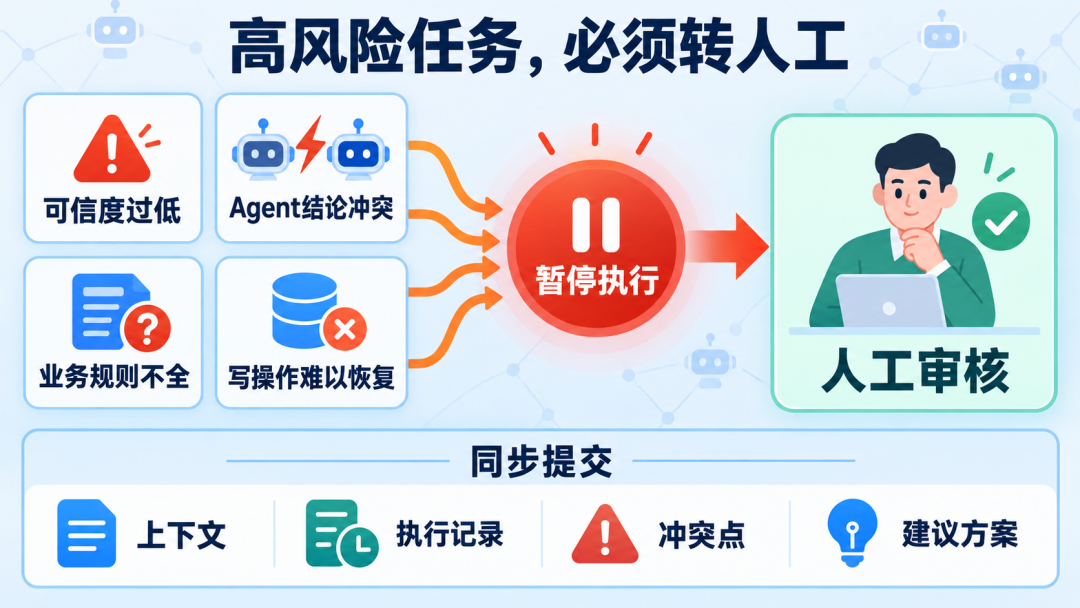
需要明确一点:转人工处理并不是任务执行失败,它本身就是一种正常的业务结果。总比系统规则给不出合理判断时还要硬着头皮自动决策、最终造成损失强得多。
总结:先识别场景,再选择策略
所以,一个 Agent 执行失败之后,应该根据具体场景来处理:
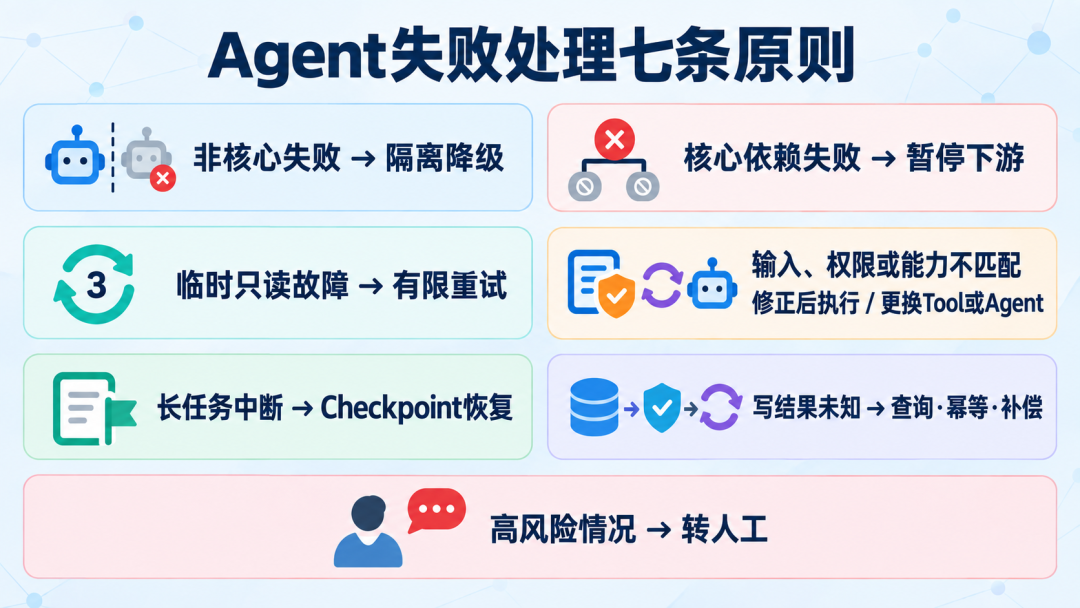
成熟的 Multi-Agent 系统,不是遇到任何错误都重试,而是能识别当前属于什么业务场景,再选择风险最小、成本合理的处理方式。
 发表于 前天 01:23
|
查看: 1|
回复: 0


