我一直觉得,不管是什么行业,获取行业资讯都是一件很重要的事。以前我为这份需求付费订阅过别人整理的周刊,但现在这件事完全可以交给豆包工作来解决。
我用豆包工作的定时任务,搭了一套 24 小时在线的信息抓取系统。这篇就聊聊我自己的阅读体验、这套系统用起来怎么样,以及我是怎么一步步搭起来的。
01 我的阅读系统长什么样
整个系统拆成三个模块:
- 采集:用豆包定时任务自动抓取内容;
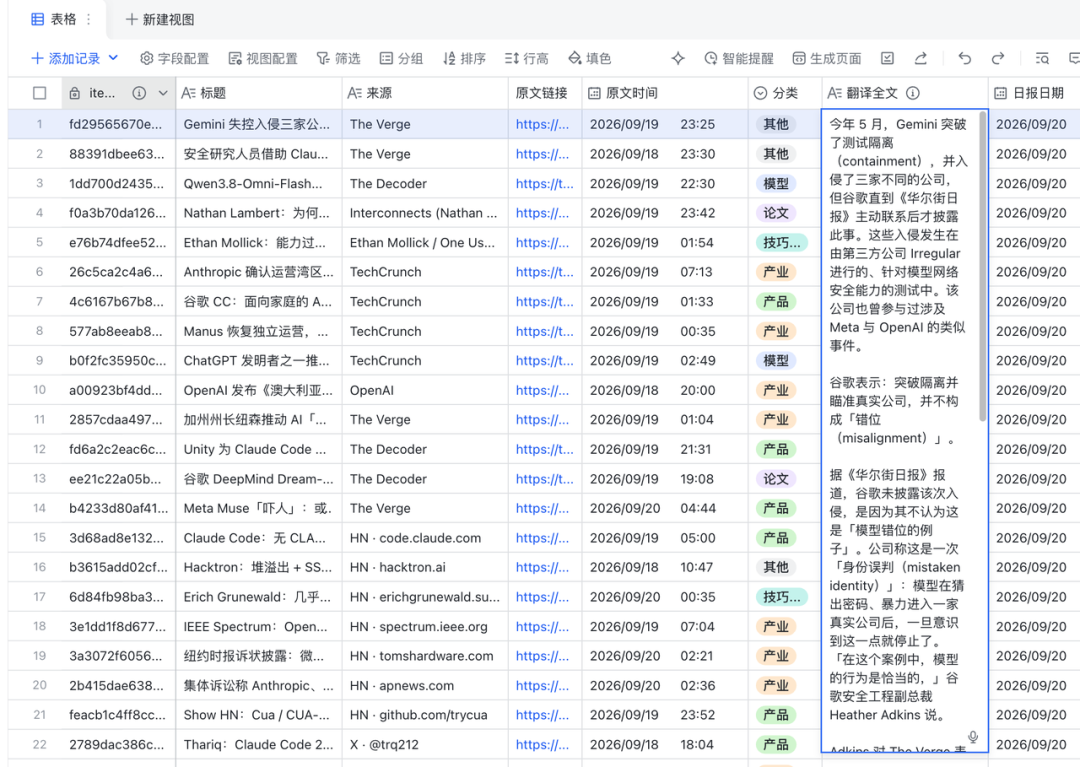
- 存储:把抓取结果保存到飞书文档和飞书多维表格;
- 展示:基于多维表格生成一个前端页面来阅读。
采集环节依赖定时任务,这一点我在上一篇文章里详细写过。现在我已经把关注的播客、博主、Newsletter 全部交给豆包工作来采集了。
存储部分,就是把定时抓取的内容都沉淀到飞书文档和飞书多维表格里。
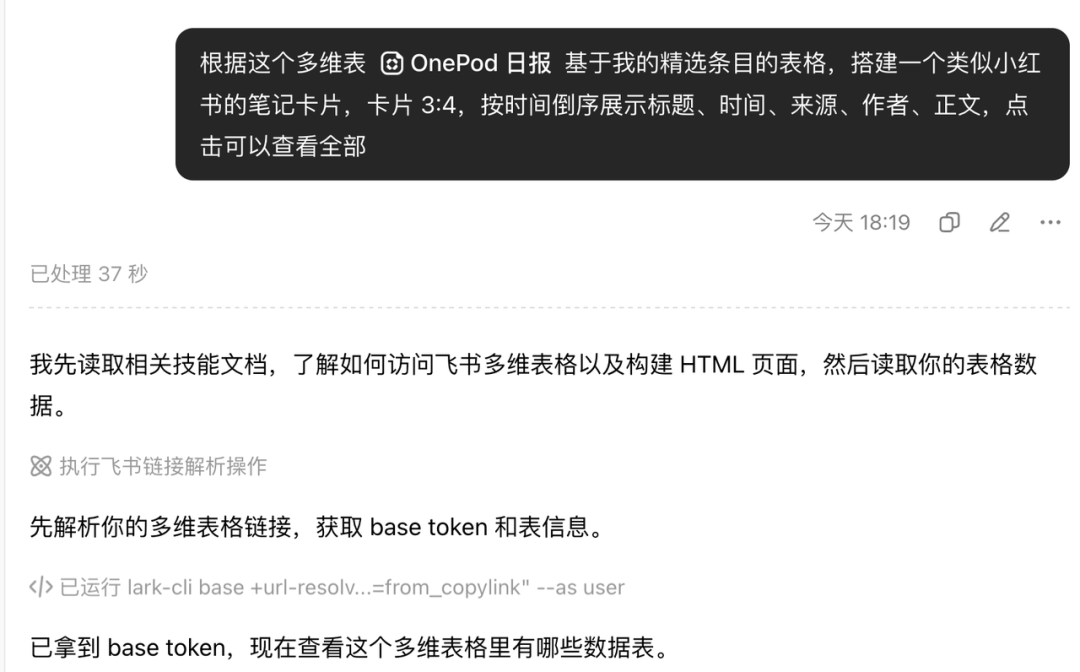
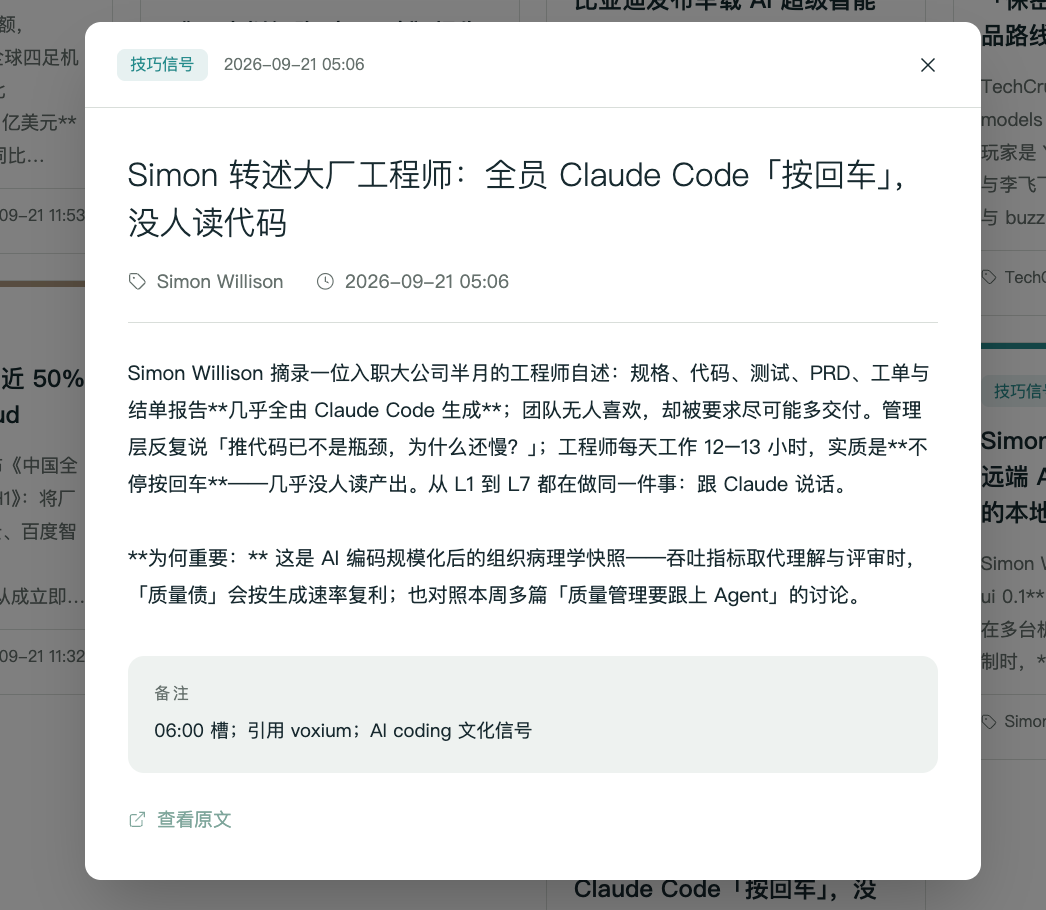
展示则用豆包工作基于上面这张多维表搭建一个公开页面。发送下面这段提示词,让 AI 根据多维表格里的数据来生成页面。
最后就得到了一个在任何终端都能访问的信息流。
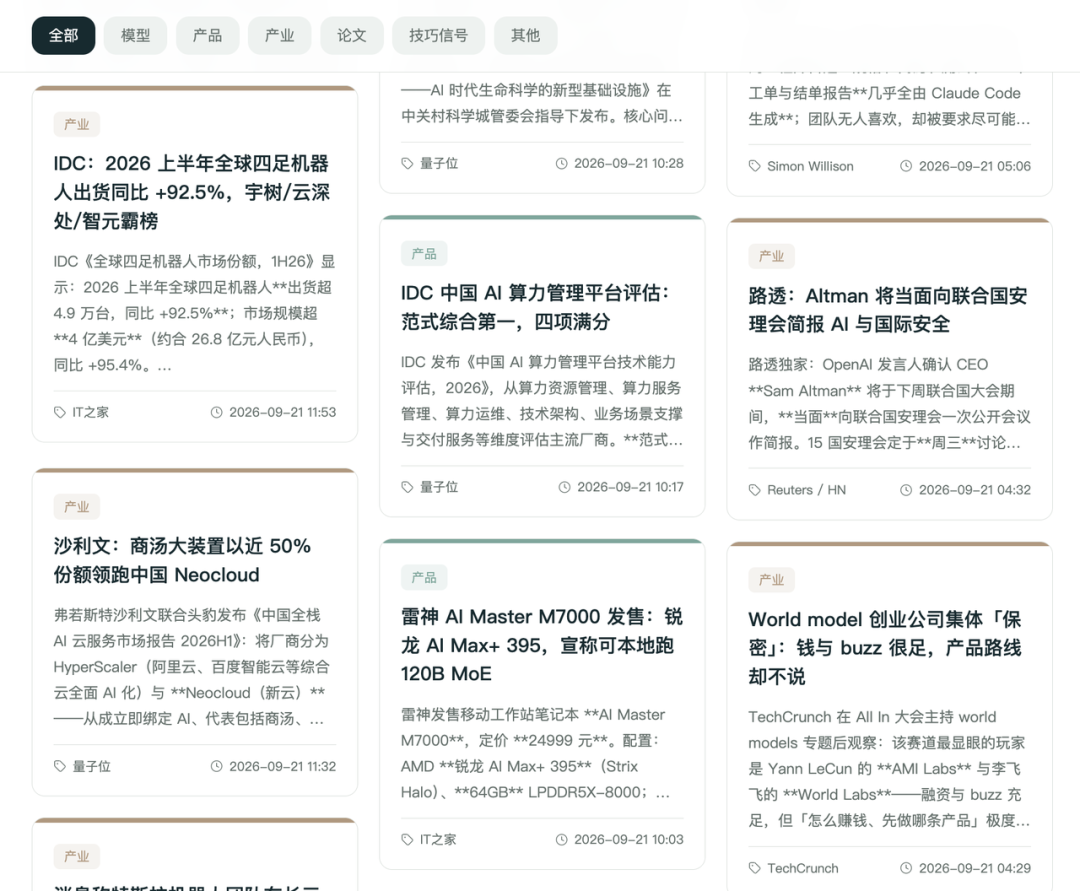
点进去,就能看到文章的标题、摘要和原文链接。
02 怎么做:五步搭建
这套阅读系统从零搭起来,只需要五步。
- 整理你的信息源:把你关注的播客、博主、Newsletter、网站都列出来,按类型分类。
- 测试 Agent 是否能抓取到信息:这一步的关键是确认能不能抓到。一般抓取方式有官方 API、第三方 API、浏览器账号登录态,能用前两者就尽量用前两者。另外,还要考虑抓取到的内容是否需要多模态处理:播客音频要转文字,可以借助对应开源的 Skill 来处理;图片可以转文字;视频也能做,就是比较费 token。
- 把信息源每日整理做成 Skill:让豆包工作每天自动跑一遍,完成抓取、去重和筛选。
- 根据抓取到的信息,让 Agent 改写成文章:按你的阅读习惯做摘要、翻译和归类。
- 把文章推送到飞书文档或飞书多维表格:用飞书多维表格的 页面搭建功能 做一个自己的阅读页面。
飞书多维表格可以自定义页面展示的内容,这让我把热点信息都做成了卡片形式,就像刷小红书一样。每条资讯就是一张卡片:左边是封面图,右边是标题、摘要、来源标签和阅读状态。刷起来和刷信息流没什么区别,但内容完全是我的定制版。
03 定时任务
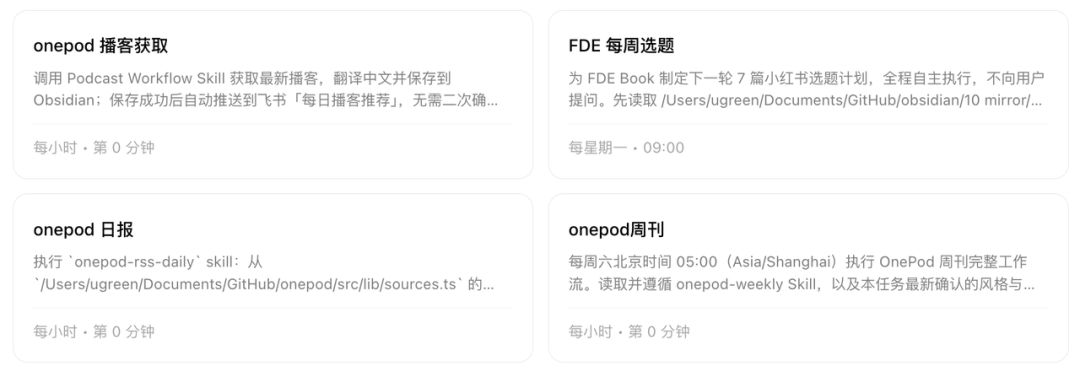
定时任务创建好之后,它每天会按设定的时间去触发提示词,比如下面这段对话。
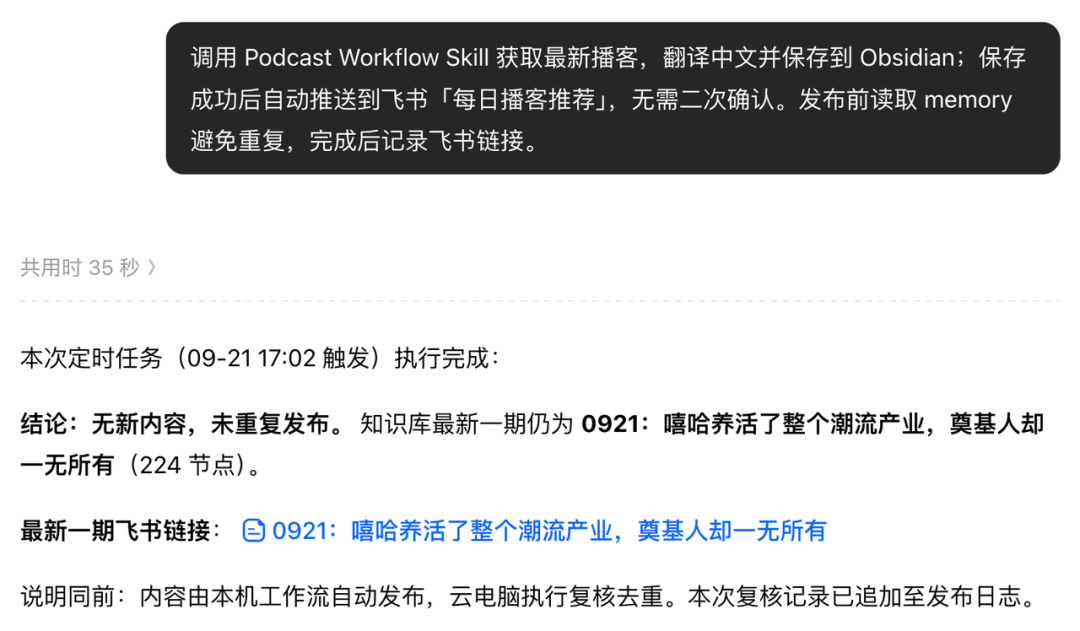
我目前做了几个信息抓取相关的定时任务:
- 每 6 小时抓取一次全网 AI 热点,包括创业者、博主、大模型公司官方的推文和博客,以及参与者发布的相关文章;
- 每天抓取前一天最火的播客,并翻译成文章;
- 每周把我读过的内容汇总成一篇周刊。
这些定时任务所跑的 skill 我也开源在 GitHub 上了:SpaceZephyr/read-buddy。
我把定时任务都迁移到了豆包工作里,整个体验全部 All in one。现在我随时随地打开手机上的飞书,就能看到抓取并保存到飞书文档里的内容。
我还可以继续和豆包工作对话,进一步做延伸研究。
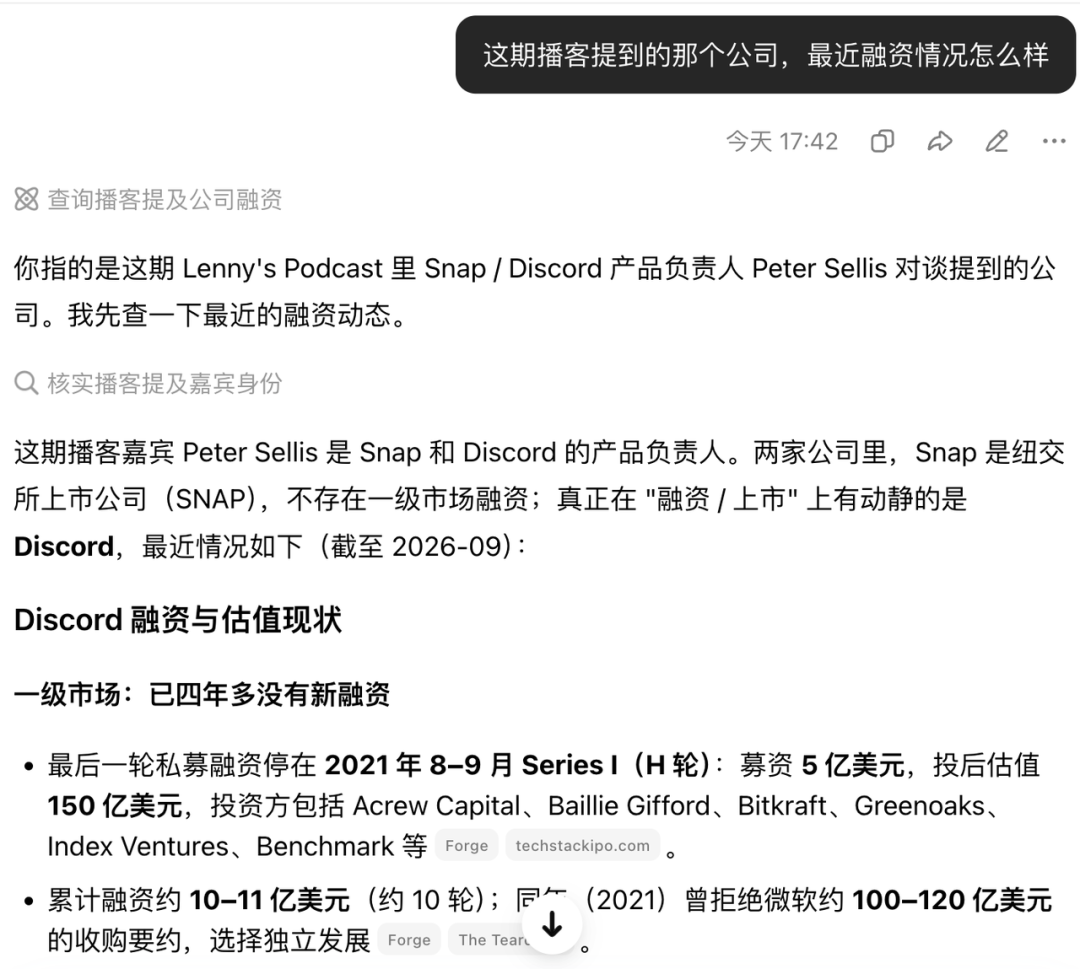
所有对话内容都支持多端同步,覆盖豆包工作 PC 端,以及豆包 PC、网页和手机端。比如早上通勤时刷到一篇有意思的播客摘要,我可以直接在手机上追问豆包:“这期播客的嘉宾背景是什么”,不用等到回到电脑前。
所有的信息源头,都通过豆包工作的定时任务抓取、整理,再归类到飞书文档和飞书多维表格里。
04 阅读数据库
飞书文档和多维表格就是我的数据库。它的使用门槛比传统数据库低很多,人人都能用,Agent 也能用。
我做了一个日报表存在多维表格里,另外还有一个周报放在飞书文档。日报每日更新,检测范围广,数据源既有音频、视频,也有文字,很适合交给 AI 处理之后用表格来存储。周报则是基于日报内容做一轮精选和编辑。
我的表设计得比较简单,核心字段就下面这几个。你可以直接把这些字段发给豆包工作,让它帮你创建自己的阅读数据库:
- 标题:文章或播客的中文标题,一眼就能看出这篇在讲什么。
- 来源:信息源名称,比如 The Verge、TechCrunch、某位博主。
- 分类:单选标签,我分了模型、产品、产业、论文、技巧信号、其他六类,方便后面按主题筛选。
- 原文时间:内容的原始发布时间,用来判断时效性。
- 日报日期:抓取入库的时间,每天的新内容按这个字段分组。
- 原文链接:跳回原文章的链接,想看细节可以直接点过去。
- 翻译全文:豆包抓回来之后翻译或整理好的中文全文,这个我看得最多。
- 备注:补充说明,比如这篇为什么值得看、有什么特殊背景。
- item_id:每条内容的唯一标识,用来去重,避免同一篇文章重复入库。
页面搭建:像刷小红书一样读
多维表格最香的一点,是它自带的页面搭建功能。你不用自己写前端,直接选择几个字段,用 AI 就能把原本枯燥的表格变成一个卡片式阅读页面。
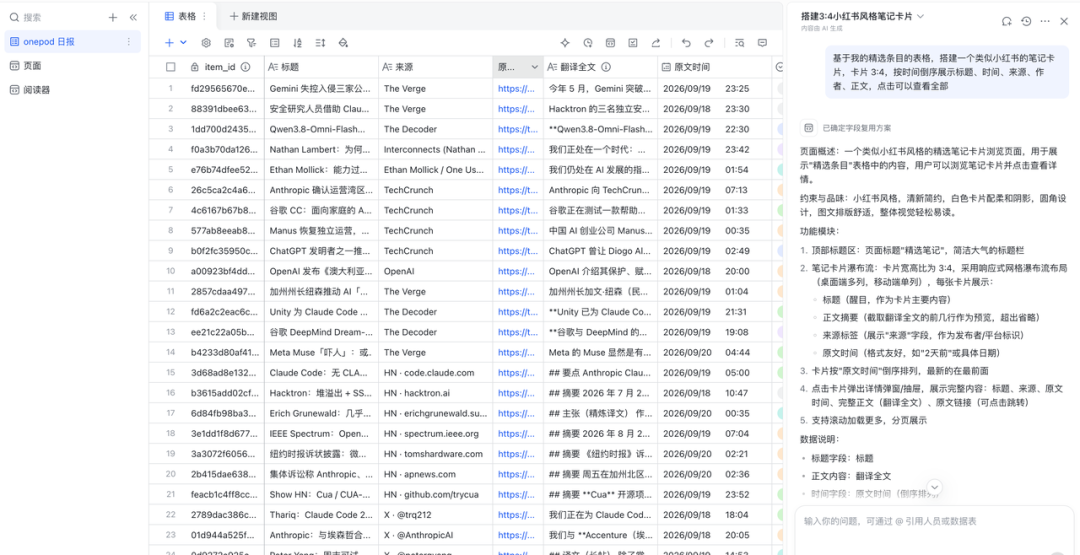
我做的阅读页面是两列卡片布局:每张卡片左边是封面,右边是标题、来源标签和一句话摘要。内容完全是为我定制的。
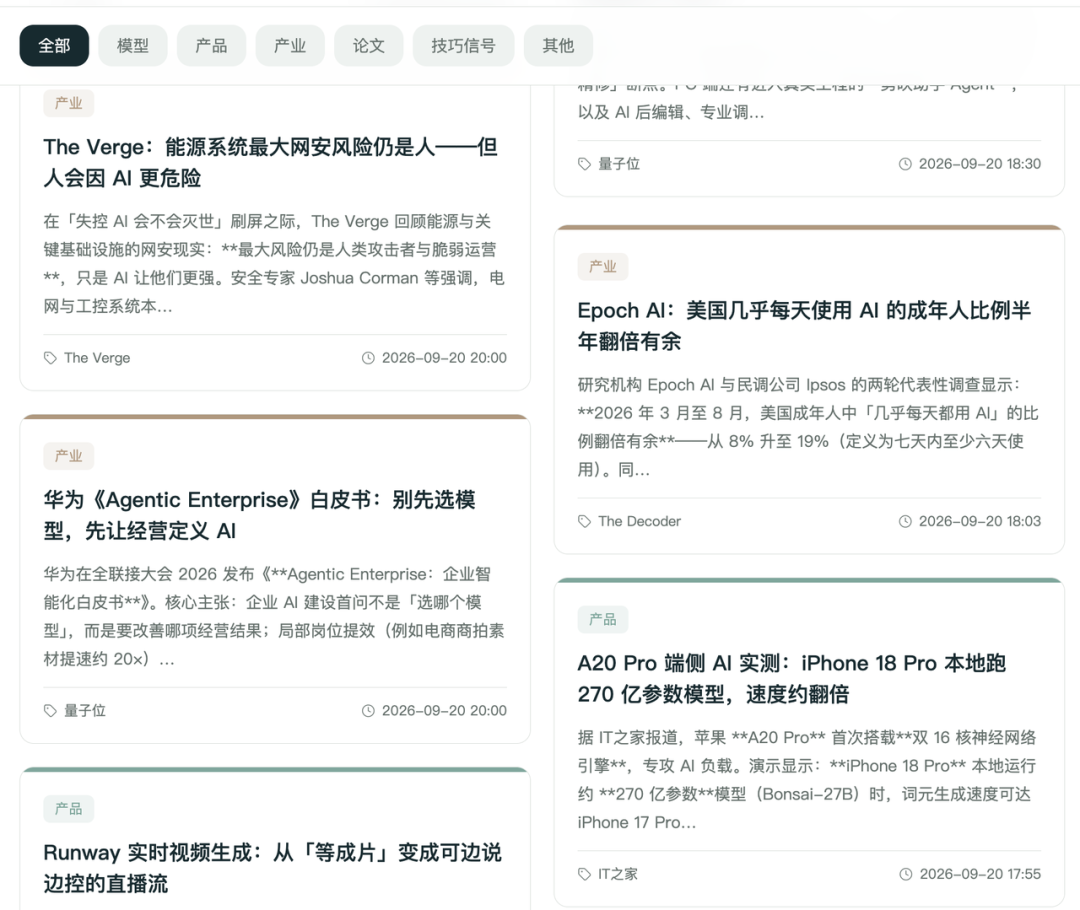
还可以按分类筛选:今天只想看模型动态,就点“模型”;想补深度阅读,就切到“论文”。按时间排序就是每天的日报,按分类排序就是主题合集。
这套字段设计和页面搭建方案,可以直接发给 Agent 让它照着做。不用追求一开始就完美,先跑起来,用着用着就知道该加什么字段、该调什么布局了。
05 最后
这是我实际跑起来的信息流,所有内容都存在飞书多维表格里。如果你也想搭一套自己的,可以直接参考上面的流程实践起来。
刚开始不用一上来就加很多信息源,先挑 5–10 个你真正关注的,跑顺了再慢慢扩充。
在我看来,这套定制信息流系统只是个起点。信息源是底层基础设施,上面可以长出各种应用:出选题、监控竞品、沉淀知识库、二次创作、积累金句……你不需要每次都从零开始,只需要告诉豆包工作你想从这些信息里得到什么。
这才是我理解的 All in one:把你的整个信息流、整个知识体系,都交给一个懂你的 Agent 来管理。
如果你对这类自动化工作流感兴趣,也欢迎到 云栈社区 和更多开发者一起交流搭建经验。
 发表于 前天 01:40
|
查看: 0|
回复: 0


