前段时间我在 GitHub 上翻到一个开源项目 OlliteRT,作者的思路基本就是“安卓上的 Ollama”。装上之后,手机不只是能跑大模型,还会在局域网内暴露一个兼容 OpenAI 的接口,其他设备上的软件填个地址就能直接调用。
这类场景我正好有几个:每天汇总 RSS、给相册照片打标签,偶尔还要处理智能家居发过来的指令。活儿都不大,单次几秒就能跑完,但就是需要一个一直在线的东西兜着。专门拿电脑跑不划算,OlliteRT 正好适合。
简介
OlliteRT 底层基于谷歌的 LiteRT-LM 运行时,推理时可以选择手机 GPU 或 CPU,服务通过局域网 HTTP 暴露。项目完全开源,使用 Apache-2.0 协议。
模型下载完成后可以完全离线运行,手机上处理的内容不会外传。官方在隐私说明里也写得很明确:没有数据收集,也没有任何统计代码。
模型这块能干什么
模型来源给了几条路。最省事的是应用里内置的模型列表,看中哪个点一下就能下载,文件托管在 HuggingFace 的 LiteRT 社区。也可以直接导入手机里已有的 .litertlm 文件。另外还支持自定义模型源,填一个 JSON 文件或 URL 就行;添加后应用大约每 24 小时会自动刷新一次,检查有没有新模型。
内置列表里目前这些模型值得说说:
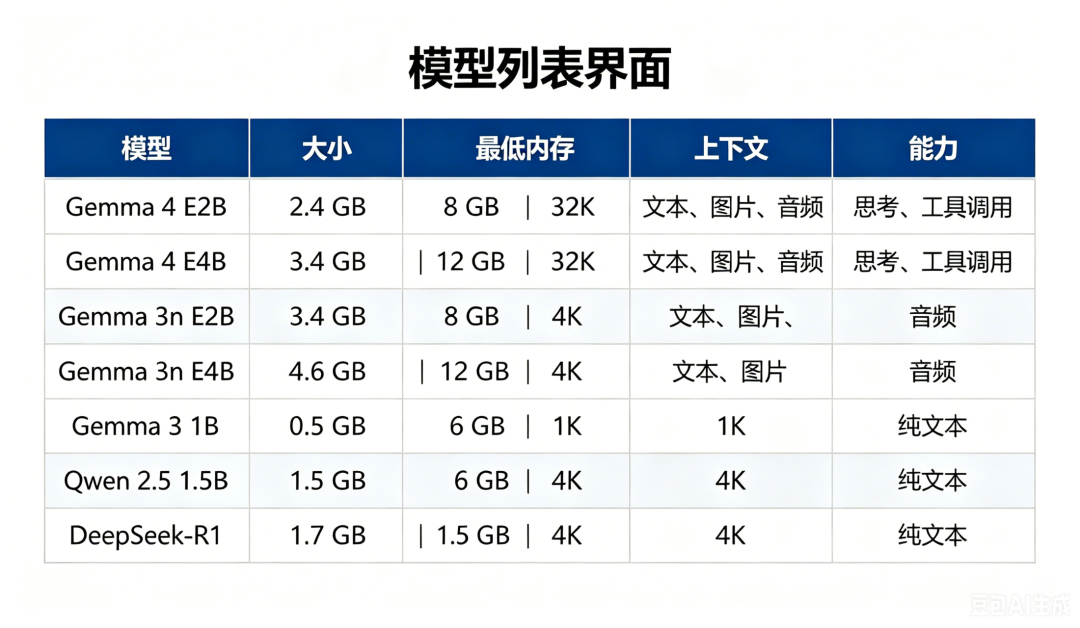
官方推荐多数用户选择 Gemma 4 E2B,配置高一点的手机可以上 E4B。两者都是多模态模型,支持图像和音频输入,也支持思考模式,回答前会先给出一段推理过程。Gemma 4 还带一个叫 MTP 的能力,大致相当于一次预测多个词,能明显提升出字速度,不过需要在模型设置里手动开启。
我手机内存不算大,日常挂载 E2B 也够用了。
接口兼容到什么程度
接口兼容性算是这个项目做得比较突出的部分。OpenAI 的 chat/completions 和 completions 都支持,Responses 接口、音频转写接口也有,连 Anthropic 的 Messages 接口也可以兼容,流式和非流式都能用。
所以手头现成的工具几乎不用改。Open WebUI 填个地址就能连;Python 里用 OpenAI 官方 SDK,把 base_url 指到手机即可;curl 直接调用也没问题。Home Assistant 还有专门的接入文档。我自己只是把 NAS 上几个定时任务的接口地址改成手机地址,任务就照常跑起来了,其他配置一点没动。
需要注意的是,工具调用目前仍是实验性质,在 Gemma 4 上表现最好,小模型不一定能稳定按格式返回。官方提供了两种模式:默认走 schema 注入;如果效果不好,可以在设置里关掉,退回用提示词解析的老方案。
监控和日志做得挺细
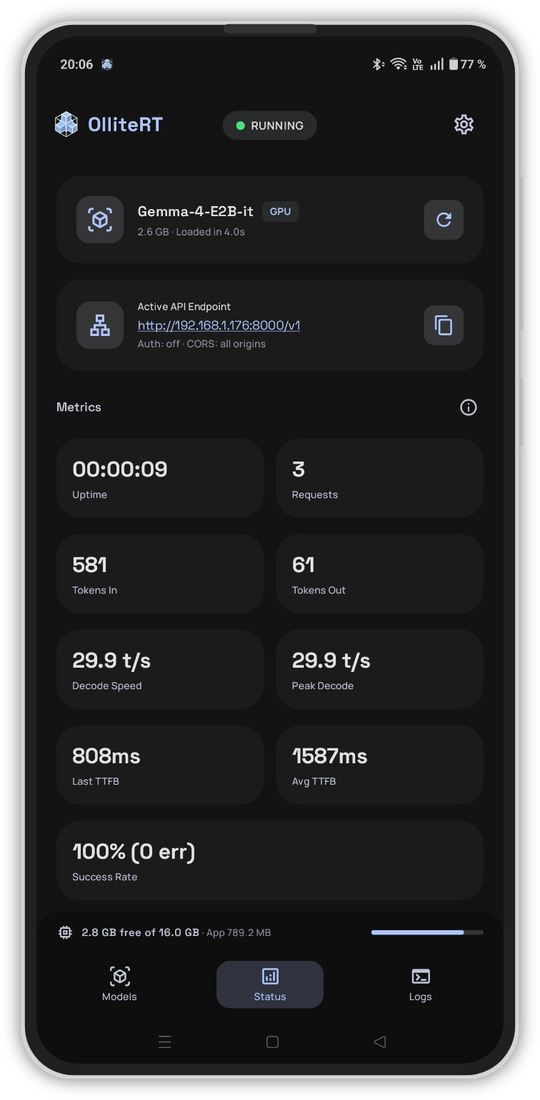
服务跑起来以后,状态页会展示实时数据:运行时长、已处理请求数、输入输出 token 量、出字速度、首字延迟、成功率,全都摆在那儿。另外还有一个可拖动的悬浮窗。手机放在一边当服务器用时,瞟一眼就能确认它还在不在运行。
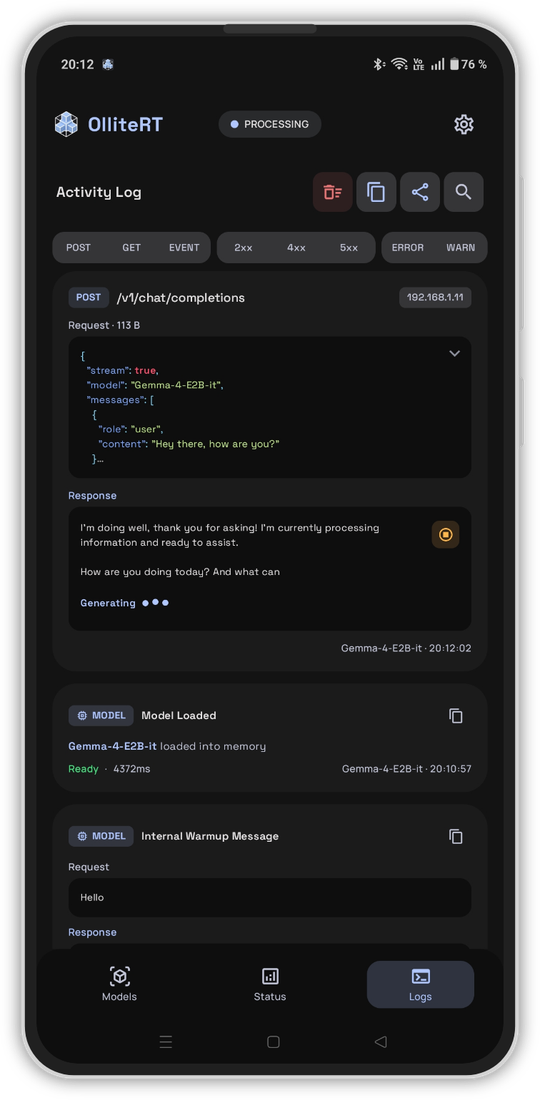
日志页同样做得很细。每次请求和响应都会记录下来,可以按请求方法或状态码过滤,也可以搜索关键词,JSON 还带语法高亮。每条日志下面有一排小标记,能看出请求耗时多少毫秒、是否流式、是否开启思考模式,以及估算的输入 token 占了多少上下文。当上下文快要占满时,这个数字会变黄再变红,非常直观。
除了应用内看到的这些,它还有 /metrics 端点,能暴露 29 个 Prometheus 格式指标。如果家里跑着 Grafana,可以直接接进去画图。Home Assistant 除了调用模型,还能通过内置 REST 接口远程查看状态、切换模型和修改设置。
另外还内置了 Benchmark 功能。同一台手机上把几个模型挨个跑一遍,长输入处理速度、出字速度、加载速度,一比就清楚。新手机上手时,我建议先跑一次这个,比光看参数表直观。
配置项给得挺足
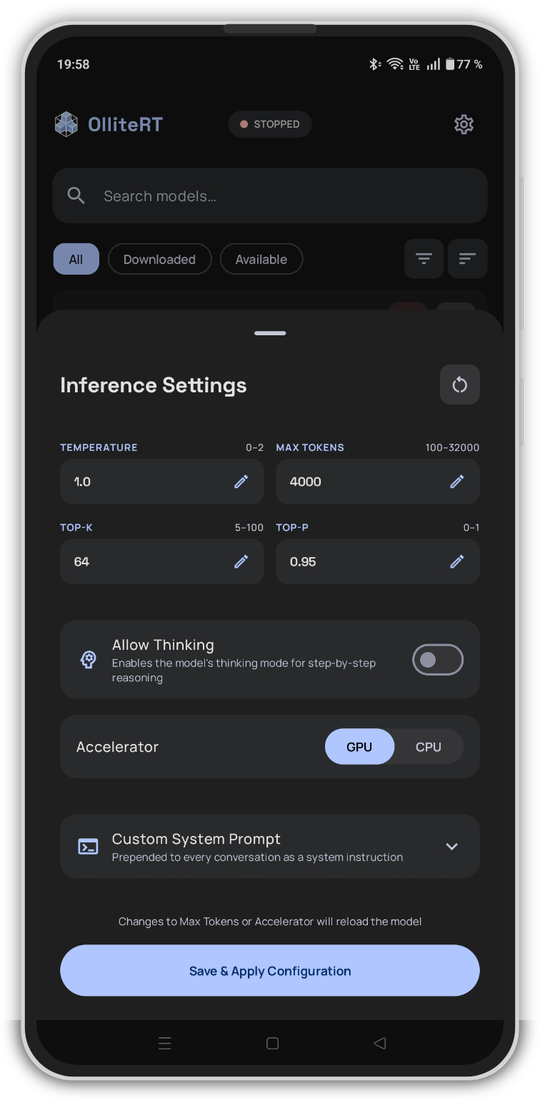
每个模型都可以单独保存一套推理参数,温度、top-k、top-p、最大输出长度都按模型存储,重启后不会丢。加速器可以在 GPU 与 CPU 之间切换,默认用 GPU,遇到问题再换 CPU 试试。
有几个开关我自己实际用上了。
一个是闲置自动卸载。 设置一个时间,比如 5 分钟没有收到请求,模型就会从内存中卸载,把内存还给系统。等下一个请求进来时再自动重新加载,代价是这一次会慢几秒。如果手机平时还要干别的,这个开关非常有用。
开机自启我也开了。 选好默认模型,打开 Start on Boot,手机重启后服务会自己拉起来。记得把应用电池优化关掉,否则安卓后台可能把它杀掉。这样配置完,这台手机基本就是个不用管的常驻设备。
还有个常驻通知。 它通过前台通知来保住后台服务,通知上直接放了“停止服务”和“复制地址”两个按钮,这个细节很贴心。
接口安全这块
接口可以开启 bearer token 验证。开启后,没有携带 token 的请求会直接返回 401。还可以设置客户端 IP 访问规则,只放行家里那几个设备,监听范围也能调整。
官方文档里有一句话,我觉得值得单独拿出来说:
不要通过端口映射把它暴露到公网,它没有 HTTPS,token 验证也只是基础手段。它合适的使用场景就是局域网,别往公网放。
上手很简单
整个上手过程几乎没门槛。去 GitHub Releases 页下载 APK 并安装,打开后在模型列表里挑一个下载;下好后点击模型卡片上的 Start Server,状态页就会显示服务地址,一般是 http://手机IP:8000/v1。把这个地址填到客户端里就行。
硬件要求:安卓 12 以上、arm64 架构、内存最低 6 GB;想跑多模态模型最好 8 GB 以上。2017 年之后的安卓手机基本都已是 arm64,这一点问题不大。
有些限制得提前说下
一次只能加载一个模型,请求也是排队逐个处理,想拿它当多人共用的服务不现实。
只支持 .litertlm 格式,不认 GGUF。网上给 llama.cpp 和 Ollama 准备的模型文件在这里是用不了的,下载前别搞混。
接口返回的 token 计数是估算值,按字符数除以四计算。英文场景下还行,代码或多语言内容会偏。想用这个数字算费用不可取,看个大概还凑合。
从本地导入模型时,文件会被复制一份到应用自己的目录,相当于占用双倍空间。导入完成后记得删除原文件。
因为运行在移动端推理框架上,logprobs、LoRA 这类进阶玩法都没有。
长时间挂机要注意的事
如果打算让它 7×24 小时常驻运行,官方建议插着电使用,摘掉手机壳帮助散热,把手机放在阴凉、硬实的平面上,并且每隔一段时间检查是否发烫、电池是否鼓包。
功耗方面,模型生成时大约 5 到 10 瓦,空闲时接近零。和动辄三百瓦以上的显卡服务器相比,确实省电。
用下来的整体感受
指望它替代一台正经推理机器是不现实的,一次只能跑一个模型、请求排队处理,这个限制绕不开。但在某些场景里刚刚好:活儿碎、量小,不想专门开电脑,也不想让数据外流。监控、日志、权限、自启这些它都有,当一个常驻服务用没有问题。
用到现在,NAS 上那几个定时任务没再让我操过心。家里要是有闲置安卓机,确实可以装一个试试。
开源地址:
https://github.com/NightMean/OlliteRT
 发表于 昨天 23:49
|
查看: 3|
回复: 0


