只要你在实际业务里做过时间序列预测——不管是下个月的门店销量、机房服务器负载,还是电池衰减曲线——大概率都被“调参”折磨过。
传统统计模型每换一个数据集,往往就要重新识别周期;而前两年的时序基础模型虽然打着“零样本预测”的旗号,一落进真实业务就容易现原形:现实中的销售预测永远依赖促销打折、节假日和气温,但早期模型大多只能吃一条孤零零的单变量数值曲线。
Google Research 在 8 月正式推出的 TimesFM 3.0,试图跨过这条横亘在时序基础模型和真实业务之间的鸿沟。
项目卡片
- 项目:TimesFM[1]
- 状态:v3.0.0 / 30.5k Stars / Google Research 2026年8月重磅升级
- 一句话判断:零样本搞定多变量与动态协变量的时序基座模型,扫平了传统微调门槛,但上线商用前必须看清它的新协议。
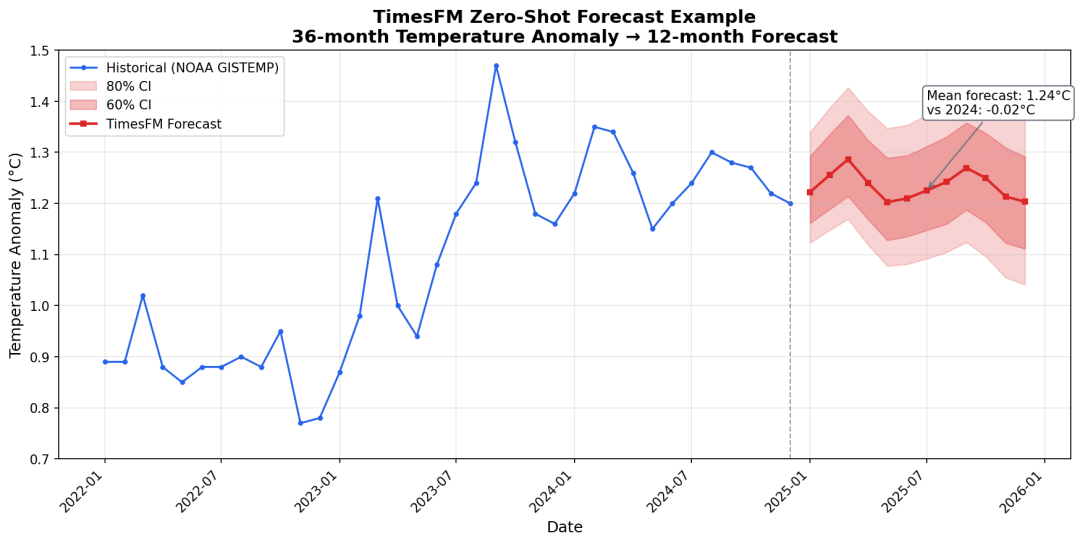
为什么说单变量时序模型一直隔靴搔痒?
在真实世界的预测场景里,几乎不存在纯粹的“孤岛时间序列”。
比如预测一款饮料的周末销量,除了过去半年的销量流水,你还必须输入降雨量(过去已知、未来预测)、打折力度(人为设定的未来变量)以及同类竞品的促销状态。过去无论是学术界的基准模型,还是 TimesFM 的早期版本,核心架构都围绕单通道设计。遇到外部变量,开发者只能在模型外围挂一层线性回归(如 XReg)打补丁,信息传递在特征层就已经发生断裂。
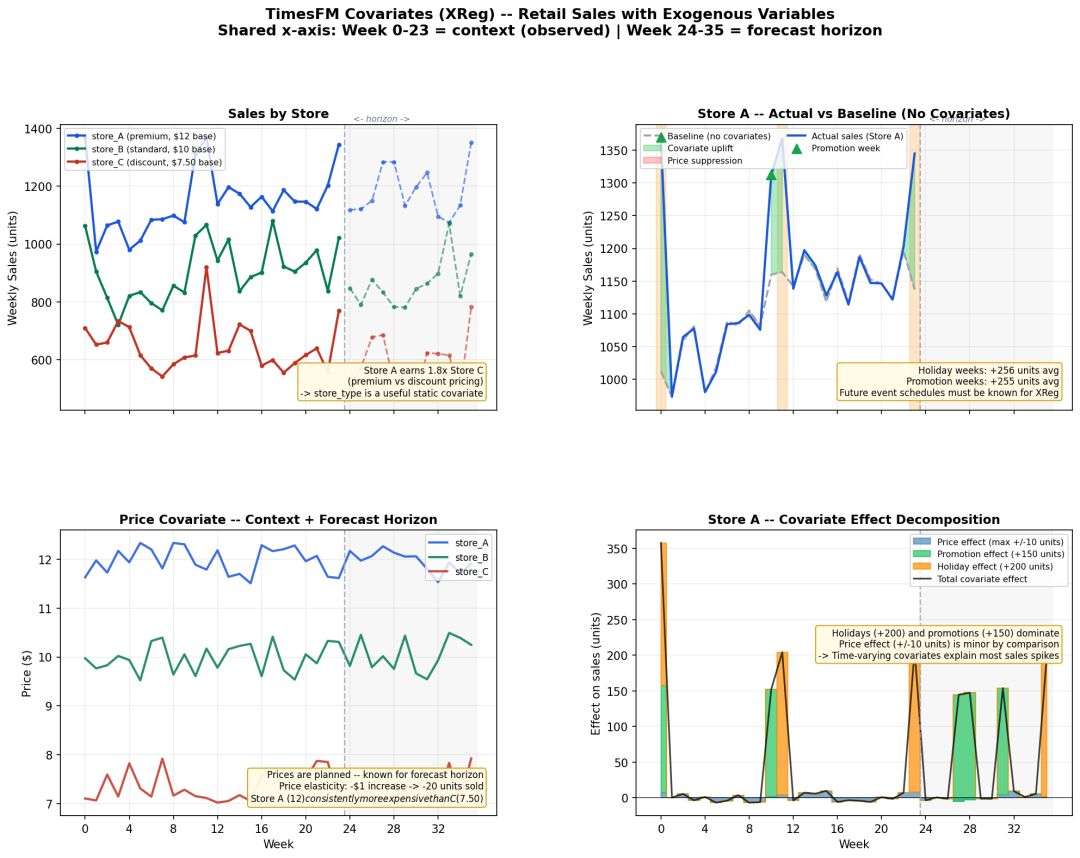
TimesFM 3.0 最大的架构跨越,是把多变量(Multivariate)与动态协变量(Covariates)做进了模型原生注意力机制。
它把协变量严格划分为两类处理:
- 仅过去可见变量:如过去几个月测得的实际气温、历史缺货记录,只输入历史 Context 窗口;
- 跨越过去与未来的动态变量:如排期的促销档期、法定节假日日历,完整贯穿历史与待预测的未来 Horizon。
这一改动带来的直观收益是性能质变。在时序领域三个权威评测集里,TimesFM 3.0 拿下了统一的头名:AutoGluon 涵盖 100 项真实任务的 fev-bench 综合第一、ICML TIME 跨 50 个领域的 98 项任务第一,以及 Salesforce GIFT-Eval 基础模型第一。这意味着它不是在某几个学术玩具集上过拟合,而是在上百种工业时序形态下展现出了泛化能力。
普通开发者怎么把它用起来?
对于习惯了 PyTorch 和数据科学栈的工程师,TimesFM 3.0 的上手门槛被压得很低。你不需要准备标注数据做微调,甚至不用配置繁琐的周期频率标识(frequency indicator)。
整个预测逻辑可以直接用一段干净的 Python 脚本 驱动:
import numpy as np
from timesfm3 import TimesFM3Evaluator, ModelConfig

# 初始化模型(默认加载 HuggingFace 权重)
config = ModelConfig(
    checkpoint_path="google/timesfm-3.0-pytorch",
    per_core_batch_size=16,
    device="cuda"# 亦可指定为 cpu
)
forecaster = TimesFM3Evaluator(config)

# 目标序列:shape 为 (通道数, 历史长度)
target = np.random.randn(3, 128).astype(np.float32)

# 动态协变量:包含未来已知信息的促销与假期标记 (2, 128 + 24)
future_cov = np.random.randn(2, 128 + 24).astype(np.float32)

# 批量零样本预测
outputs = list(
    forecaster.predict_batch(
        contexts=[target],
        horizon=24,
        past_future_covariates=[future_cov],
        return_quantiles=True,
    )
)

print("预测均值形状:", outputs[0].forecast.shape)    # (3, 24)
print("分位数区间形状:", outputs[0].quantiles.shape) # (3, 24, 9)
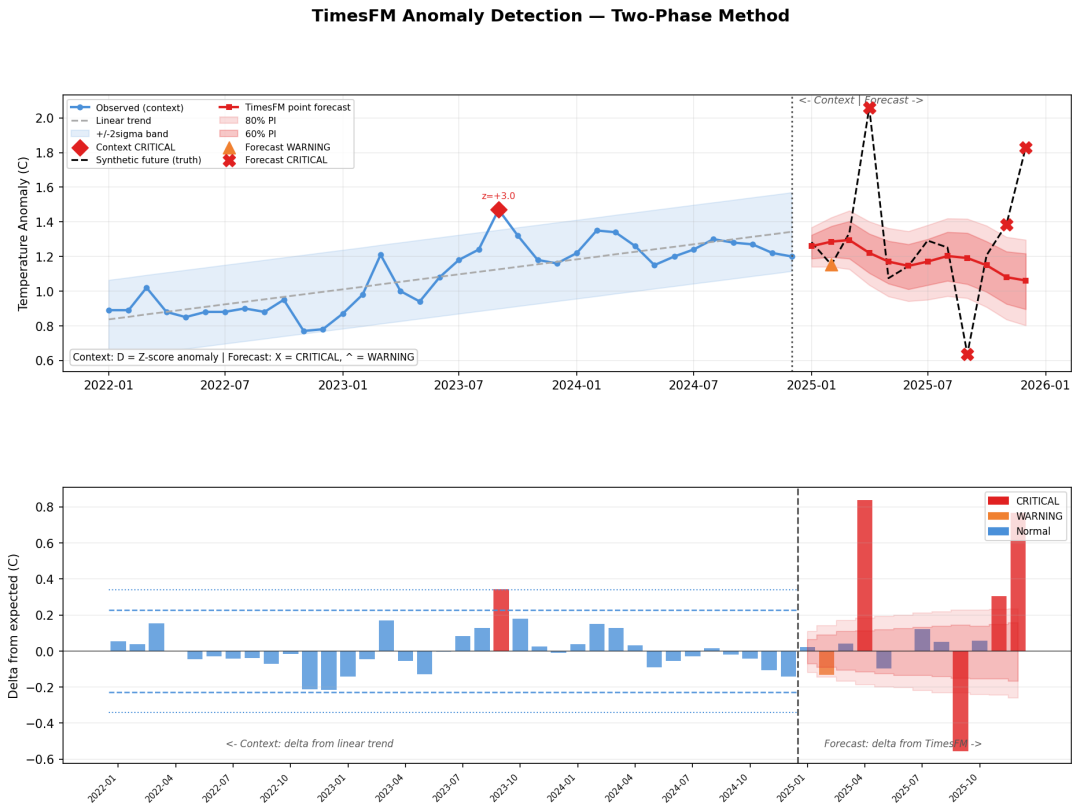
这段调用里最值得注意的是 outputs[0].quantiles。TimesFM 不是只输出一个生硬的点预测值,而是同步给出 0.1 到 0.9 的 9 个分位数。
在库存备货或电力调度中,单点数值往往毫无意义,运营方真正需要的是极端水位估计(例如 P90 保障率)。更有价值的副产物是异常检测:将历史真实数据与模型给出的分位数置信区间比对,落在 10%~90% 置信区间之外的点,天然就是统计学意义上的异常值,不需要单独部署一套孤立森林算法。
从脚本到工程:它适合嵌入什么场景?
除了在本地或服务器用 Python 脚本跑批量推理,Google 已经在其产品矩阵里给出了 TimesFM 的三种落地样板:
首先是 BigQuery ML。数据分析师不需要把几百万行数据导出到本地 GPU 集群,直接在云数仓里写一句标准的 SQL 语句调用 ML.FORECAST,底层就能直接跑 TimesFM 基础模型。
其次是 Google Sheets。在连接了 BigQuery 的日常电子表格里,非技术人员可以直接选中历史销售列,点击菜单触发时序预测,预测结果连同置信区间直接回填为表格图表。
第三是 Vertex AI Model Garden。它提供现成的 Dockerized API 端点,适合配合自主智能体(Agentic Workflow)做动态环境感知与趋势预警。
这意味着,普通团队如果不想在本地维护复杂的深度学习环境,完全可以把 TimesFM 作为云上开箱即用的预测微服务来消费。
决定选型前,必须看清的三道边界
尽管 TimesFM 3.0 的评测表现亮眼,但在实际引入架构前,必须明确它的适用边界与硬性约束。
最核心的一点是 开源协议 的变化。TimesFM 仓库的 Python 代码本身保持 Apache-2.0 许可证,且 2.5 及更早版本的模型权重依然是 Apache-2.0。但是,TimesFM 3.0 的官方预训练权重采用了单独的非商业协议(timesfm-non-commercial-license-v1.0)。这意味着 3.0 权重目前仅限研究与非生产环境使用;如果你需要在商业生产系统里免费商用,现阶段必须回退使用 2.5 版本(200M 参数、Apache-2.0 权重),或者采购 Google Cloud 的商业 API。
其次是硬件资源占用。TimesFM 2.5 曾做过轻量化精简(200M 参数,显存需求约 1~2 GB)。而 3.0 为了容纳多通道注意力和长上下文,参数量扩展到 20 层 Transformer(隐藏层 1280 维,参数量约 5 亿)。虽然 CPU 仍能勉强加载并完成单步推理,但在处理成百上千条长序列时,没有独立 GPU 会遇到显著的延迟瓶颈。
最后是模型能力的职责划分。TimesFM 专精于时序数值的回归预测与不确定性量化。官方文档里明确提醒:如果你需要进行时间序列分类或聚类,应该选择专用库如 aeon;如果你需要白盒可解释的参数经济学归因或因果检验,经典的 statsmodels 仍然是更严谨的工具。
把 TimesFM 当作一把锋利的“零样本数值趋势与风险区间切刀”,在它擅长的多变量预测场景下榨取效率,才是最稳妥的打开方式。
引用链接
[1] TimesFM: https://github.com/google-research/timesfm
 发表于 3 天前
|
查看: 1|
回复: 0


