机器人做长一点的任务,最怕的环节往往发生在回头那一刻:摄像头还在,桌面也还在,可关键证据已经从画面里消失了。
桌上有个方块,机器人先把它移走,按下按钮,再放回原位。问题来了:方块一旦离开,当前画面里可能只剩一个空桌面和几个相似垫子。该放回哪里?答案藏在开局那一眼里。
电池试错也一样。刚刚试过哪一块、哪个槽已经失败、下一步换哪个,当前画面未必直接写着。交换方块更麻烦——做了两步还是三步、是否该按 done,都得靠记住过去。
MemBodied 这篇论文抓的就是这个点。来自 Nanyang Technological University、Griffin Labs 和 École Centrale de Lyon 的团队,没有选择把历史视频一股脑塞进上下文,而是给 VLA policy 加了一个固定大小的 episode memory。数字很醒目:在 RMBench 五个记忆任务上,它做到 stateless pi0 的 7.81 倍、vanilla recurrent memory 的 2.98 倍;对比最强的 memory baseline,还少用了约 10 倍新增参数。LIBERO-Long 上也到了 90.6%。
这个工作值得看,并不靠“机器人有记忆”这个说法撑场面。它把记忆做成了一个工程部件:能补历史证据,同时不让 context 越跑越胖。
当前画面有时已经没有答案了
很多 VLA demo 给人的错觉是:只要视觉模型够强,机器人就能一路往下做。摄像头看到桌面,语言指令给出目标,policy 输出动作,链路看起来很完整。
可在长程操作里,当前画面经常只是半张考卷。Put Back Block 这类任务,机器人要记住物体最开始的位置;Swap Blocks 里,它要知道交换进度,别两步没做完就提前收工;Battery Try 里,它要记住尝试历史,不要在几个相似选项里原地打转。
RMBench 专门把这类问题拎出来考。论文评了五个 memory-dependent 任务,每个任务 50 次 rollout。难点不在识别一个方块,也不在听懂一句指令;难点是当前 observation 可能对应好几种历史状态。画面看起来差不多,正确动作却完全不同。
这类任务不缺视觉,缺的是过去。
这个判断放到真实桌面也成立。咖啡杯被推到垫子边缘后,下一帧看到的只是杯子和垫子;要不要扶正、该从哪侧靠近,要结合刚才那次推动。少了这段历史,机器人很容易把事故现场当成普通起点。
如果机器人只把每次 policy call 当成一次新开始,它就像只看最后一页的侦探:局部细节都在,案件顺序没了。MemBodied 要补的,就是这条顺序线。
记忆不能靠把历史视频越塞越长
最直接的补法,是把过去几帧、几十帧都带上。对很多多模态模型来说,这条路很自然:信息不够,就把上下文加长。
机器人上这件事很快会变贵。episode 越长,历史 observation 越多,context、显存、延迟都会跟着上去。固定窗口看似省钱,又可能刚好把关键证据裁掉。比如开局位置只在最早几帧出现,窗口一滑走,后面再问“放回哪儿”,模型只能猜。
论文拿 NativeMEM 做了很好的参照。NativeMEM 会压缩视频历史,已经比直接塞原始历史更聪明。但在同一评测设置里,MemBodied 仍然更像一条可部署路线。
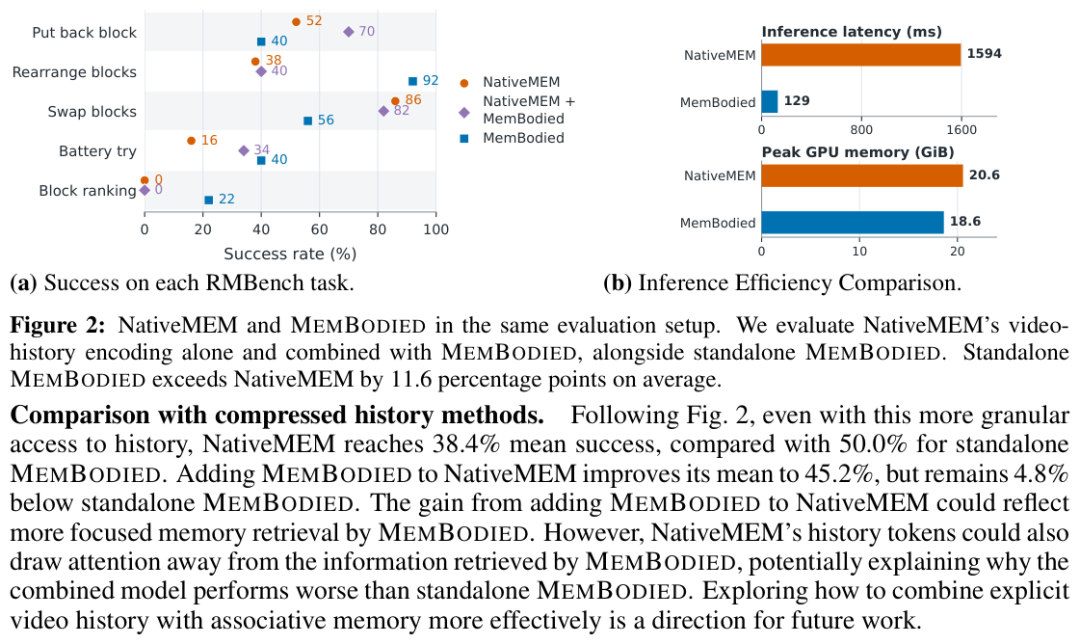
图:重点看右侧效率。MemBodied 延迟 129ms,NativeMEM 是 1594ms;新增参数 40M 对 415M。
MemBodied 对 NativeMEM 的推理延迟低 91.9%,峰值 GPU 显存少 9.5%。参数账也很清楚:40M 新增参数,只占 pi0 的 1.26%;NativeMEM 是 415M,占 12.81%。这就是标题数字之外更重要的部分。它没有背着一卷越来越长的录像带干活,而是把历史压成固定容量的状态,需要时读一下。
我的判断偏正面:机器人记忆如果要进真实系统,延迟和参数比榜单分数更硬。一个方法能在记忆任务上涨分,同时把 1594ms 压到 129ms,这比单纯多赢几个百分点更有工程含金量。
这里还有一层容易被忽略的账。机器人控制不是离线问答,policy call 会反复发生,延迟每多一点都会乘到整段任务上。一个任务如果要调用几十次 policy,单次多一秒,整段执行就会多出几十秒。桌面操作里,物体位置还会在等待中继续变化,慢不只是用户体验差,也会把后续观测变得更难处理。固定容量 memory 的价值,就在于它把历史信息留住,同时不让每一步都背负更重的历史包袱。
一个随身笔记本,加一张开局照片
MemBodied 的结构可以粗略理解成两样东西:一个随身笔记本,一张开局照片。
随身笔记本是 associative state。它记录机器人每次 policy call 前后发生了什么:当前看到什么,做了什么动作,动作后世界变成什么样。它不保存完整视频,只维护一个固定大小的状态。后面需要判断时,policy 可以从里面读出和当前决策有关的信息。
开局照片是 episode anchor。它保存初始场景的紧凑参照。这个设计很有必要,因为随身笔记本会不断被新信息更新,早期细节可能被覆盖。可很多任务偏偏要回头看开局:原来的空位在哪里,哪个物体一开始在左边,哪些位置后来被改变了。
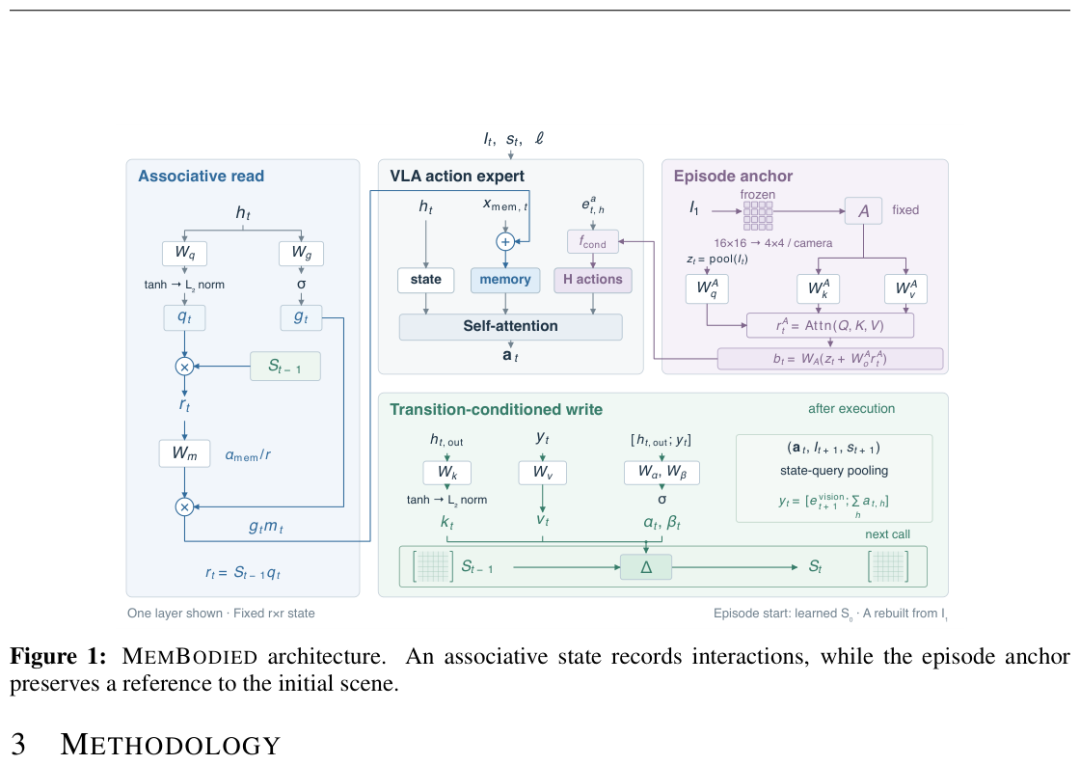
图:左侧 associative state 记录交互历史,右侧 episode anchor 保留初始场景参照。两条路一起影响动作生成。
读写顺序也处理得比较干净。机器人在当前 step 先读旧 memory,生成动作;动作执行后,环境给出新的视觉结果;模型再把这次动作和后果写回 memory。这样做避免了一个讨厌的问题:生成动作时不能偷看动作之后的画面,但记忆又必须知道动作造成了什么变化。
这个细节听起来小,实际很关键。机器人记忆不能只是“我看过什么”,还得知道“我做过什么,以及世界因此怎么变了”。把动作和后果绑定起来,才有可能在后面判断:这个槽已经试过,这个方块已经移过,这个阶段已经完成。
消融实验能看出双路径分工的价值。去掉 anchor 后,MemBodied 在 RMBench 的平均成功率是 37.6%;完整模型是 50.0%。提升很明显。
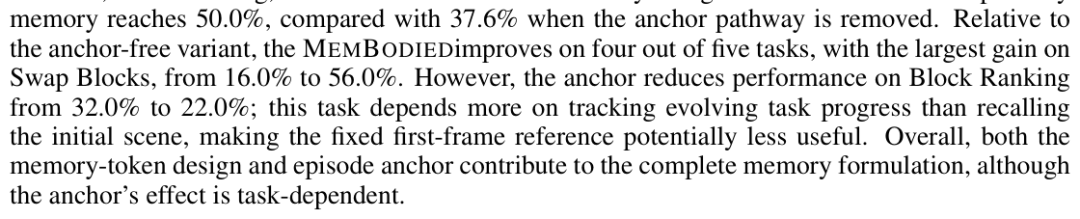
图:anchor 让平均成功率从 37.6% 到 50.0%,但 Block Ranking 上反而下降,说明初始参照并非所有任务都帮忙。
这里我反而最喜欢那个不完美的结果。Block Ranking 里,去掉 anchor 是 32.0%,加上 anchor 变成 22.0%。这说明记忆堆多了也会带来干扰。某些任务更依赖持续追踪进度,固定的开局参照可能会把注意力拉回不该看的地方。论文没有把这一点抹平,反而让方法边界更清楚。
7.81 倍很亮,但 50% 还不能上岗
主表是这篇论文最容易被转发的部分。RMBench 五个任务上,stateless pi0 平均成功率 6.4%,vanilla recurrent memory 是 16.8%,MemBodied 是 50.0%。所以才有 7.81 倍和 2.98 倍这两个数字。
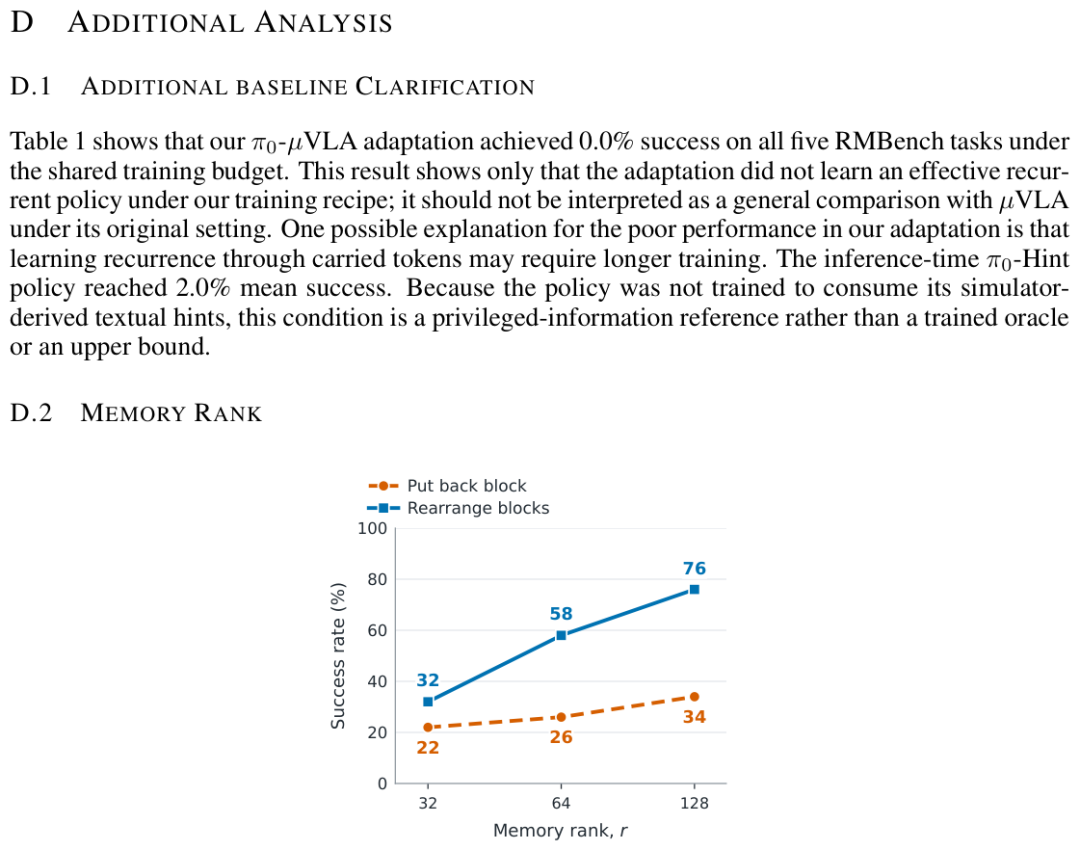
表:MemBodied 平均 50.0%,stateless pi0 只有 6.4%。每个任务 50 次 rollout,涨幅并非来自单个 case。
拆开看也有意思。Rearrange Blocks 从 stateless 的 2.0% 到 MemBodied 的 92.0%,Swap Blocks 从 8.0% 到 56.0%。这些任务恰好都需要记住之前发生过什么。相比之下,Block Ranking 只到 22.0%,也提醒人别把平均分读成全能。
它还换了 pi0.5 backbone。full-fine-tuned pi0.5 baseline 平均 12.4%,MemBodied 版本到 48.0%。真实机器人三项任务里,stateless 从 3.33% 到 26.67%。提升幅度很大,绝对成功率也很低。两句话必须一起说,不然就会把论文吹歪。
真实机器人这组尤其适合冷静看。三项任务分别只有 20 次 rollout,成功率从接近不可用涨到偶尔能成,说明 memory 确实改变了决策,但离产品里的稳定执行还差很远。一个夹爪抓偏、手臂路径没走好、物体被遮住,记忆模块都救不了。它能告诉 policy 目标在哪里、阶段走到哪一步,却不能替低层控制把动作做稳。
这也解释了为什么论文的 failure analysis 很重要。MemBodied 在 Put Back Block 里把 wrong-pad returns 从 37/50 降到 13/50,说明它确实记住了目标位置;但剩下的失败大量来自运动策略和更长的进度追踪。换成工程语言,这个模块把“想错”减少了,没把“做歪”消掉。机器人系统最后拼的是整条链,不是一块 memory adapter 单独封神。
LIBERO 结果给了另一层安慰。这个 benchmark 更偏 fully observable,按理说不一定需要 episodic recall。MemBodied 四套件平均 95.1%,pi0 是 94.2%;LIBERO-Long 上,MemBodied 90.6%,pi0 是 85.2%。
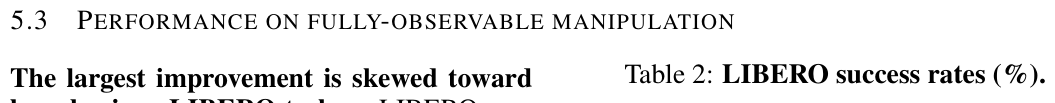
表:MemBodied 没有明显拖垮常规操作能力,LIBERO-Long 还比 pi0 高 5.4 个百分点。
这组结果说明,加 memory 至少没有把普通操作能力毁掉。长程任务上的 90.6% 也符合直觉:任务越长,历史线索越可能派上用场。
但我不会把 MemBodied 写成机器人长期记忆已经解决。RMBench 平均 50.0%,意味着一半任务仍然失败;真实机器人 26.67%,离稳定可用更远。论文的失败分析也提到,MemBodied 能减少目标位置回忆错误,但剩下很多问题来自 motor execution 和更长程 tracking。记住该去哪儿,不等于机械臂一定能去对。
所以这篇工作的价值更像一块拼图。它把 VLA 的一个老麻烦说清楚了:机器人每次看见的当前世界,已经被自己前面的动作改写过。如果 policy 不记得这些改写,长任务就会变成一串失忆的短任务。
回到开头那个方块。机器人要把它放回原处,光会描述桌面还不够,更要记得桌面曾经是什么样、自己刚才把它改成了什么样。MemBodied 把这件事往前推了一步。还没到能放心上岗,但路线是对的,云栈社区也会持续跟进这一方向的后续进展。
 发表于 4 天前
|
查看: 12|
回复: 0


