一个 21.8 万权重的 MLP,从 32 位浮点压到 4 位整数,MNIST 上的准确率从 97.62% 掉到 97.44%——只掉了 0.18 个点。这个数字不是抄来的,是本机刚跑出来的实测结果。
一、它是什么?
brevitas 是 AMD 开源的一个 PyTorch 量化库,只干一件事:让你在训练的时候就把权重和激活的位宽定死。
它解决的是一个老问题——模型训好了,塞不进板子。手上的 FPGA 就那么点 BRAM 和 DSP,一个像样的网络张口就是几百 KB 权重、上亿次乘加。现在能不能用?能。pip install brevitas 就够了。最新的 v0.13.4 发布于 2026-09-23,一周前。纯软件,不需要板子,也不需要仿真器。
二、位宽是个能拧的旋钮
量化最容易走错的一步,是把它当成训练结束后的压缩。训完再砍权重,代价通常很难看。
brevitas 把顺序反了过来。它不是压模型,而是在训练过程里就把位宽定死。前向传播时权重和激活都被量化到指定位宽,梯度照常回传,网络全程按 4 位整数在学。此时量化不是后处理,而是网络学习方式的一部分。
换位宽在这里就是换一个数字。同一个 784-256-64-10 的 MLP,同一份 MNIST,同样训 8 轮,只改了这一个数字:
- 全 32 位浮点,准确率 97.62%
- 权重和激活都 8 位,准确率 97.68%
- 权重和激活都 4 位,准确率 97.44%
- 权重和激活都 2 位,准确率 11.6%
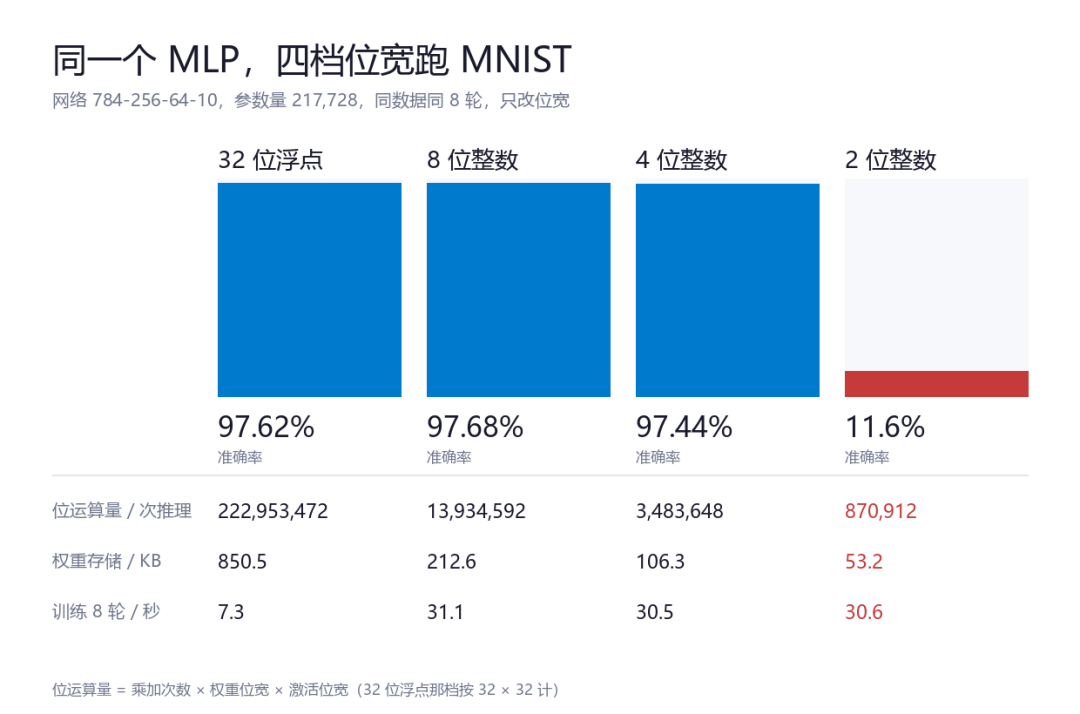
8 位那一档比浮点还高了 0.06 个点。这不是调参调出来的——量化本身带一点正则化作用,多跑几次都会看到这个现象。
4 位那一档掉了 0.18 个点。这 0.18 个点换来的东西,才是这篇文章想说的那本账。
三、这笔账该怎么算
先算存储。
上面那个网络有 217,728 个权重。按 32 位浮点存要 850.5 KB,按 4 位整数存只要 106.3 KB。位宽砍到八分之一,字节也跟着砍到八分之一。落到板子上,这就是能不能再放一个网络的差别。
再算算力。
硬件真正掏钱的不是权重占多少字节,而是每次推理要做多少次位运算。一次乘加在 8 位乘 8 位上,和它在 32 位乘 32 位上,不是同一件事。
这个 网络一次推理有 217,728 次乘加。全浮点口径是 2.23 亿次位运算,4 位口径是 348 万次,差了 64 倍。原因很简单:不是模型太大,是位宽太贵。
这场改动在代码里只有一行,nn.Linear 换成 QuantLinear,加个参数指定位宽,optimizer、epoch、数据加载全都照旧。
四、如何装、怎么跑,还有哪些坑?
它是纯 Python 库,README 写着需要 Python 3.10 以上、PyTorch 1.13 到 2.13。Windows 上没任何特殊依赖,也没有板子的事。许可证是 BSD 三条款,版权行写的 AMD,只是 GitHub 没自动识别,SPDX 显示 NOASSERTION。
坑有三个,都不致命,但都得知道。
位宽有下限,2 位就是悬崖。 上面那档 2 位的准确率是 11.6%,也就是十分类里瞎猜的水平。它不是精度变差,是网络直接不收敛。想把 4 位再往下压,靠的不是继续改这个数字,而是换更细的量化粒度或者缩放策略。
量化训练更慢。 同样 8 轮,浮点用了 7.3 秒,量化版本花了 31 秒,四倍多。原因是量化层在前向里多做了一套取整和缩放。样本少的时候无所谓,跑 ImageNet 那种规模就得老实上 GPU,README 里也是这么建议的。
它是研究项目。 这句不是我说的,是 README 的原话:「Brevitas is a research project and not an official Xilinx product」。另外我本机装的是 torch 2.14,已经超出它声明的测试范围,实测能跑通,但这条边界值得记着。
绕行方案也是有的。模型已经训好、只是想让权重小一点的话,brevitas 也支持训练后量化,不用重训。省下的是训练时间,代价是精度通常比量化感知训练差一截。
五、它不解决什么
brevitas 的输出仍然是一个 PyTorch 模型。它管的是数字怎么表示,不管这块板子跑不跑得动。
从量化模型到真正的 RTL,中间还有一层。hls4ml 和 FINN 站在这条链的下游,负责把量化好的模型翻译成硬件。此前文章介绍过 hls4ml,那是消费者侧,brevitas 是它的上游。想一步到位把模型变成比特流的人,会在这里失望。
六、仓库信息卡
- 仓库:
github.com/Xilinx/brevitas
- Stars 1582,Forks 253(抓取 2026-09-30)
- 许可证 BSD 三条款(AMD 版权,SPDX 显示 NOASSERTION)
- 语言 Python,首个提交 2018-08-21,跑了 8 年
- 最近提交 2026-09-24,最新版本 v0.13.4 发布于 2026-09-23
谁该看:做边缘推理、要把网络塞进小容量 FPGA、或者正在做 HLS 部署的人。
谁别碰:指望它直接生成 RTL 的人,以及以为「量化一下就能上板」的人。
仓库地址:github.com/Xilinx/brevitas。想把位宽这本账算清楚,一个晚上够用。
 发表于 2 小时前
|
查看: 4|
回复: 0


