Anthropic 官宣了开发者新家 claude.dev 正式上线。这里会提供工程深挖、Claude Code 与 API 指南,以及来自打造 Claude 的团队的一线经验。
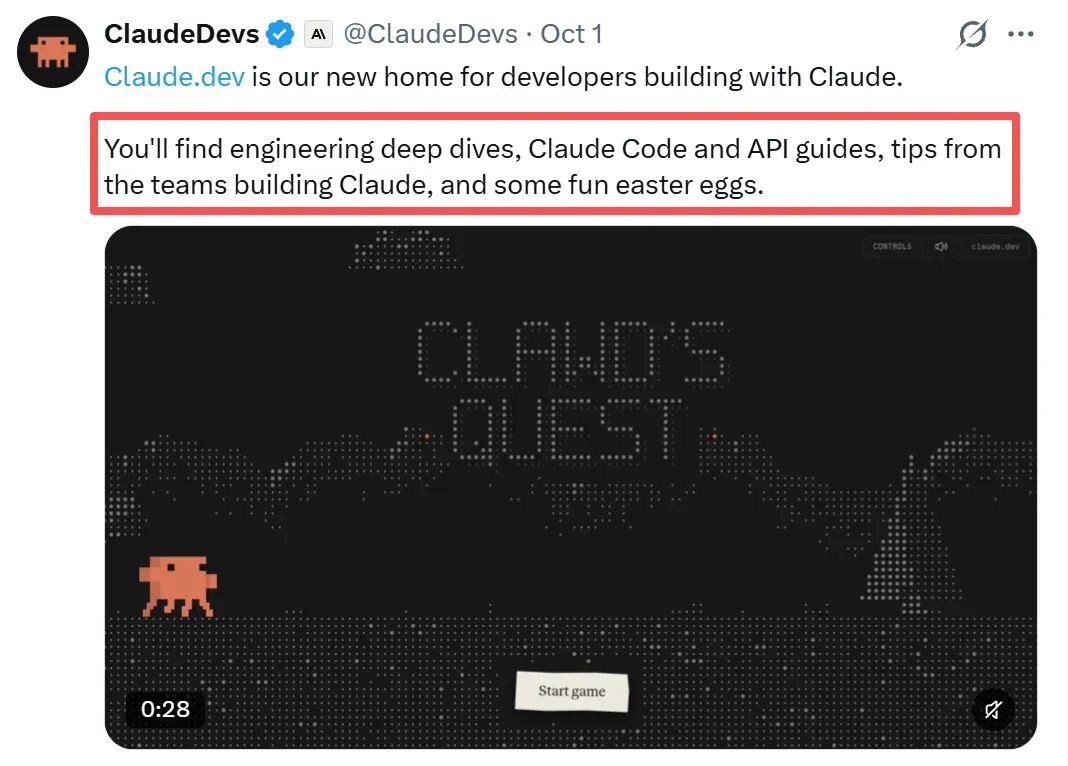
Anthropic 把过去两年内部如何用 Claude、又如何让 Claude 从单兵作战进化成协同 多智能体团队 的方法论,系统性地公开了出来。
全站内容分成几个栏目,正好对应 Agent 工程的不同层面:
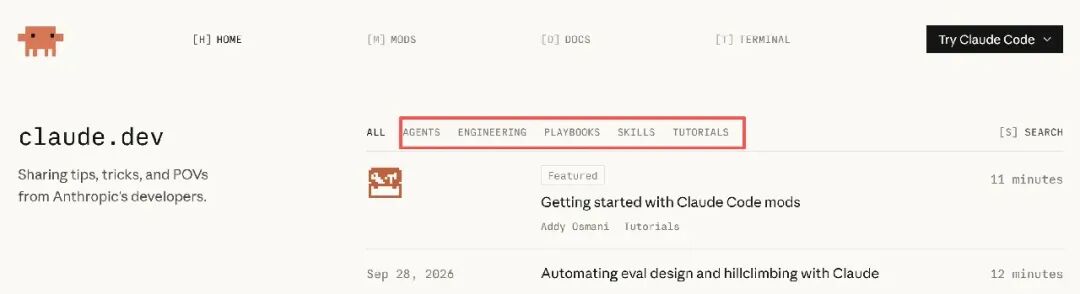
- AGENTS:怎么编排多智能体
- SKILLS:怎么沉淀和分发能力
- ENGINEERING:怎么做新模型时代的上下文工程
- PLAYBOOKS:怎么用 eval 把改进变成可测量的数字
- TUTORIALS:指导开发者使用 Claude 的各项功能的指南
AGENTS:Claude 现场给自己写作战编队
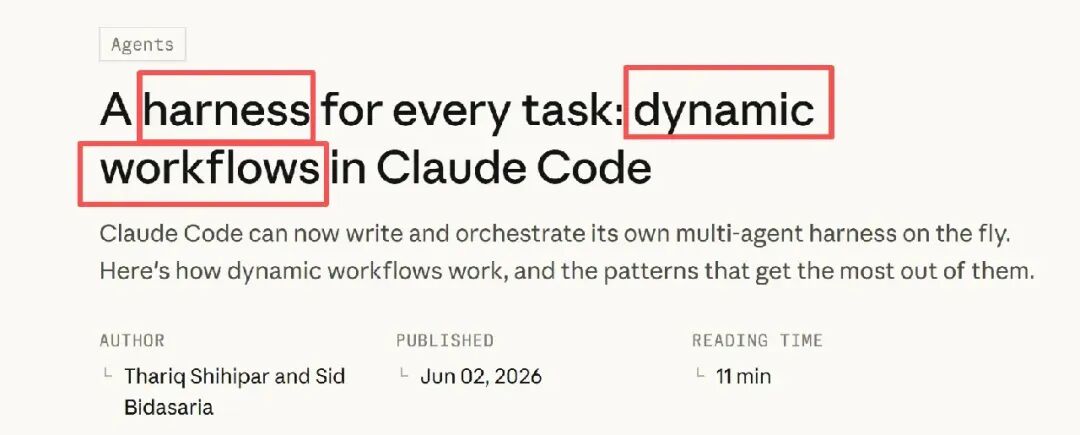
过去要让多个 Claude 协同工作,往往需要人先写好固定流程(静态 harness),对所有任务一视同仁。而 Claude Code 现在的能力是:Claude 可以针对眼前这个任务,现场编写并指挥一支定制的多智能体团队——也就是 dynamic workflows。
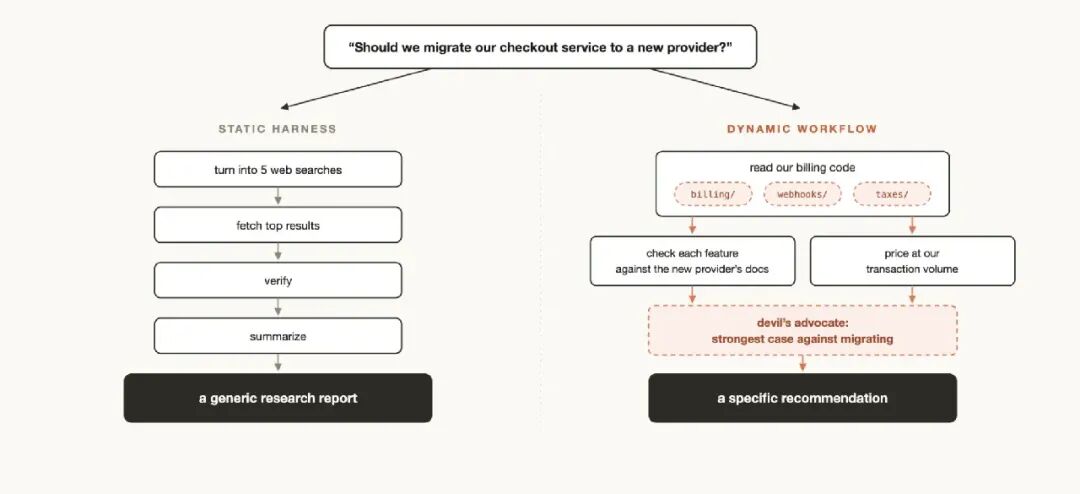
为什么需要多智能体?单上下文窗口的三大失败模式:
- Agentic laziness:安全审查 50 项,做到 35 项就宣布“完成”
- 自我偏好偏差:让 Claude 给自己的结果打分,它总会手下留情
- 目标漂移:长任务反复压缩上下文后,“别做 X”这类约束悄悄丢失
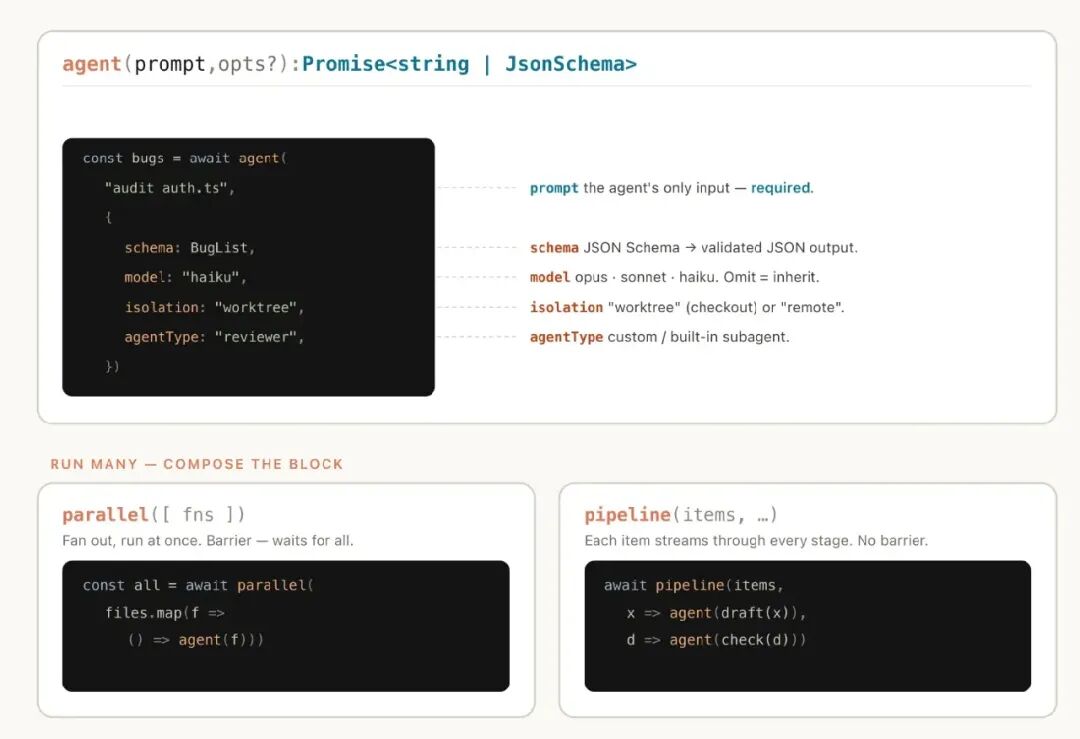
解法是三个积木:agent() 派生一个子智能体,parallel() 扇出并发,pipeline() 流水线串联。每个子智能体拥有独立、干净的上下文窗口,目标单一,互不污染。
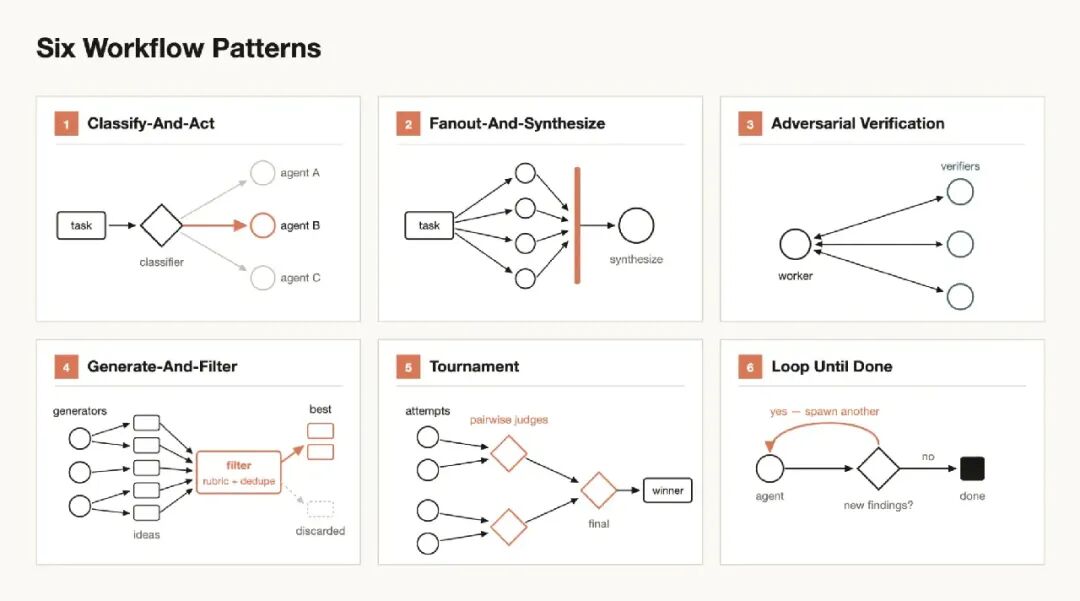
Anthropic 给出了六种可组合的编队模式:分类路由、扇出-综合、对抗验证(每个干活的智能体配一个唱反调的)、生成-过滤、锦标赛排序、循环直到收敛。Bun 从 Zig 到 Rust 的整体重写,就是用这套方式完成的。
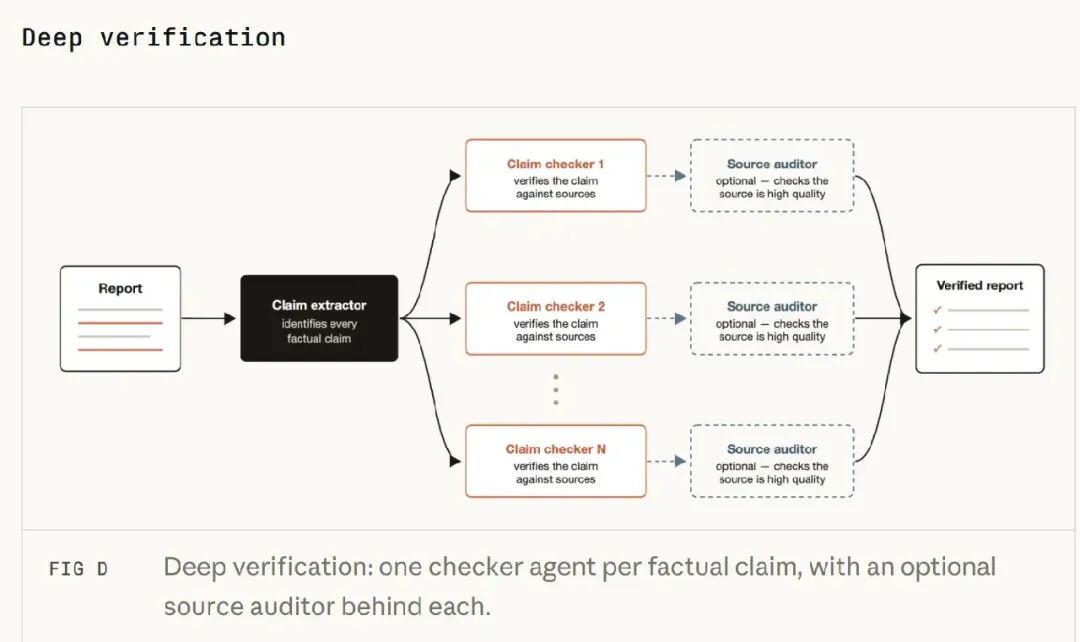
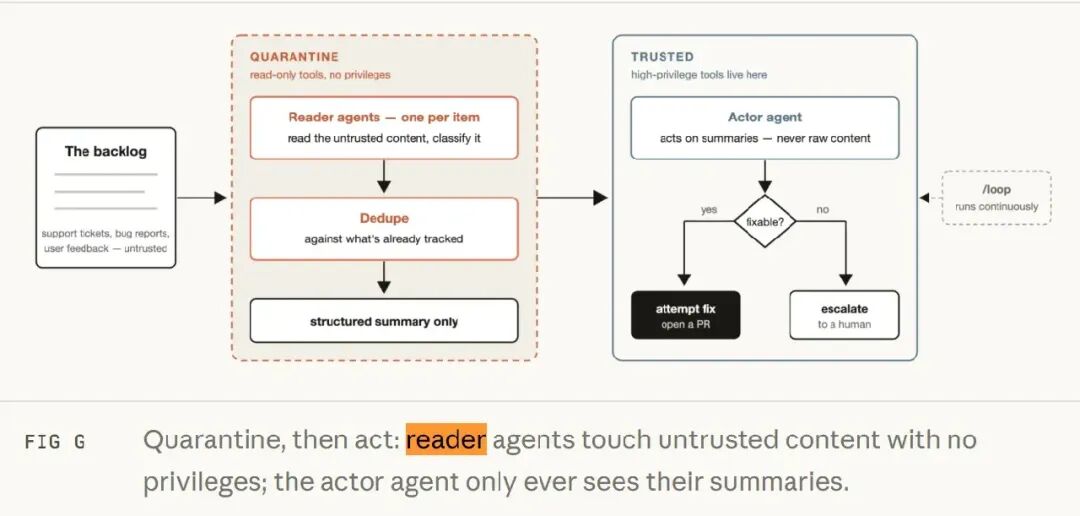
安全设计也被结构化了:处理不可信内容(例如公开渠道的用户反馈)时,reader 智能体只有只读权限,actor 智能体永远只看摘要,这道“隔离区”防线是架构级的,不是靠提示词叮嘱。配合 /loop 还能让分拣团队 7×24 小时值班。
当然也有代价。作者明确提醒:workflows 烧 token 明显更多,适合复杂、高价值的任务;一次深度研究跑到 22 个智能体、110 万 token 是常态。
一句话总结这个栏目:并行与专业化必须挣回它们的协调成本——不是所有任务都配拥有一支团队。
SKILLS:数百个内部技能压出的九类清单
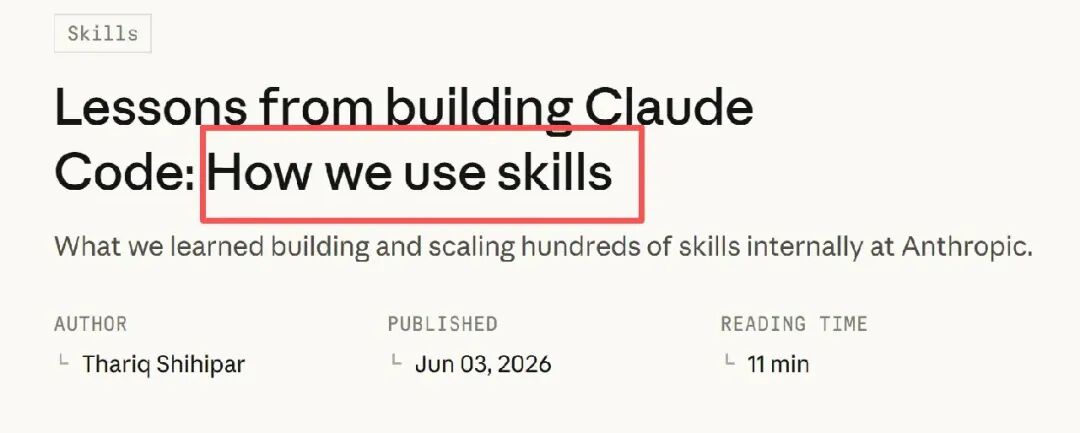
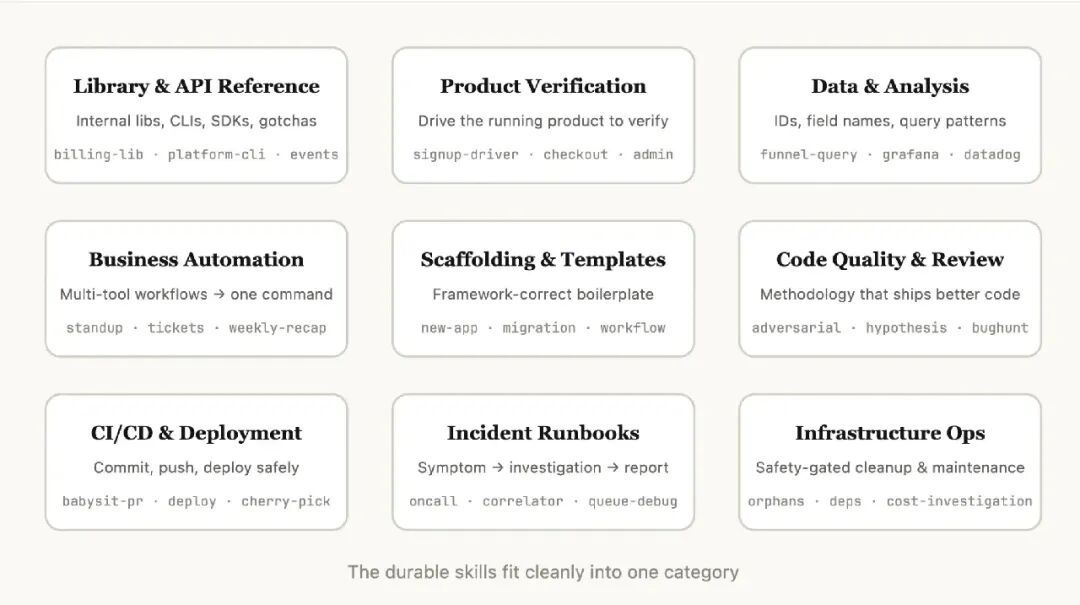
Anthropic 内部正在活跃使用的 skill 有数百个。团队把它们全部盘点一遍,发现干干净净落入九个类别:库与 API 参考、产品验证、数据获取分析、业务流程自动化、脚手架模板、代码质量评审、CI/CD、值班 runbook、基础设施运维。
有几个判断相当反直觉:
- 验证类技能价值最高。团队认为值得让一个工程师花整整一周,只为把验证 skill 打磨到极致
- description 不是写给人看的简介,而是写给模型看的触发条件。模型每次开会话都要扫一遍技能清单决定“这事归谁管”,所以描述里要塞进触发词
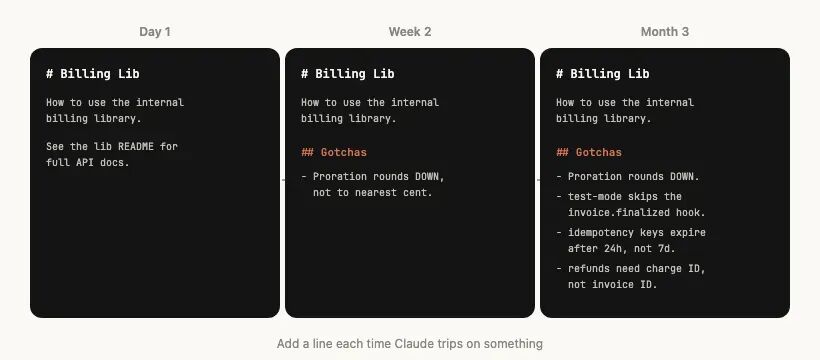
- Gotchas(踩坑记录)是任何技能里信号最强的内容,应该随使用持续累积
另一个要点是别把 skill 当“一个 markdown 文件”:它是一个文件夹,SKILL.md 只做枢纽,具体情况指向具体文件——整个文件系统都是渐进式披露的上下文工程。
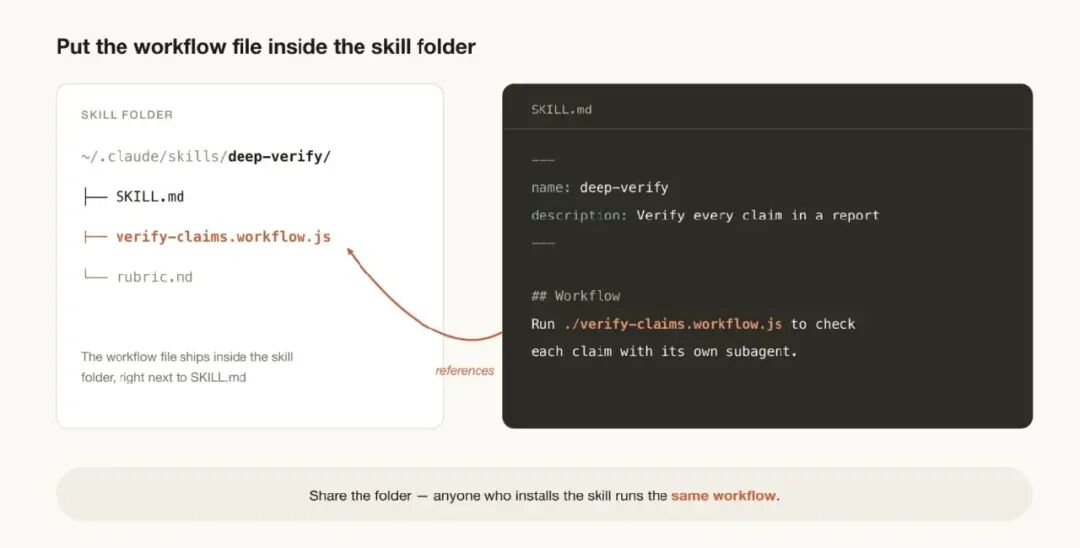
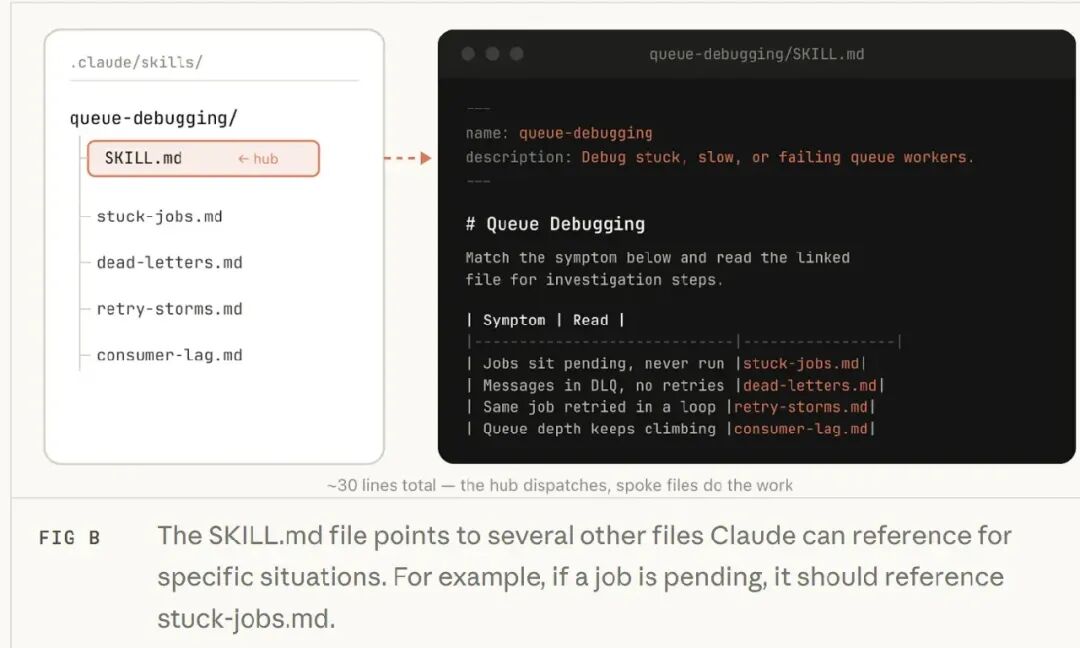
分发和治理也有完整答案:小团队直接把 skills 提交进仓库的 .claude/skills;规模上来以后改用内部插件市场,让团队按需安装。
ENGINEERING:删掉 80% 系统提示词,模型反而更强
这可能是全站最“炸裂”的一个数字:面向 Claude 5 这一代模型,Anthropic 删掉了 Claude Code 超过 80% 的系统提示词,编码评测没有任何可测量的损失。
原因很扎心:很多旧规则是在给老模型“打石膏”。比如旧提示词强硬规定“永远不要写多行注释”,因为老模型会写错;新模型有判断力了,石膏反而成了束缚。内部 transcript 里甚至能看到系统提示、skill、用户请求三方指令互相打架。
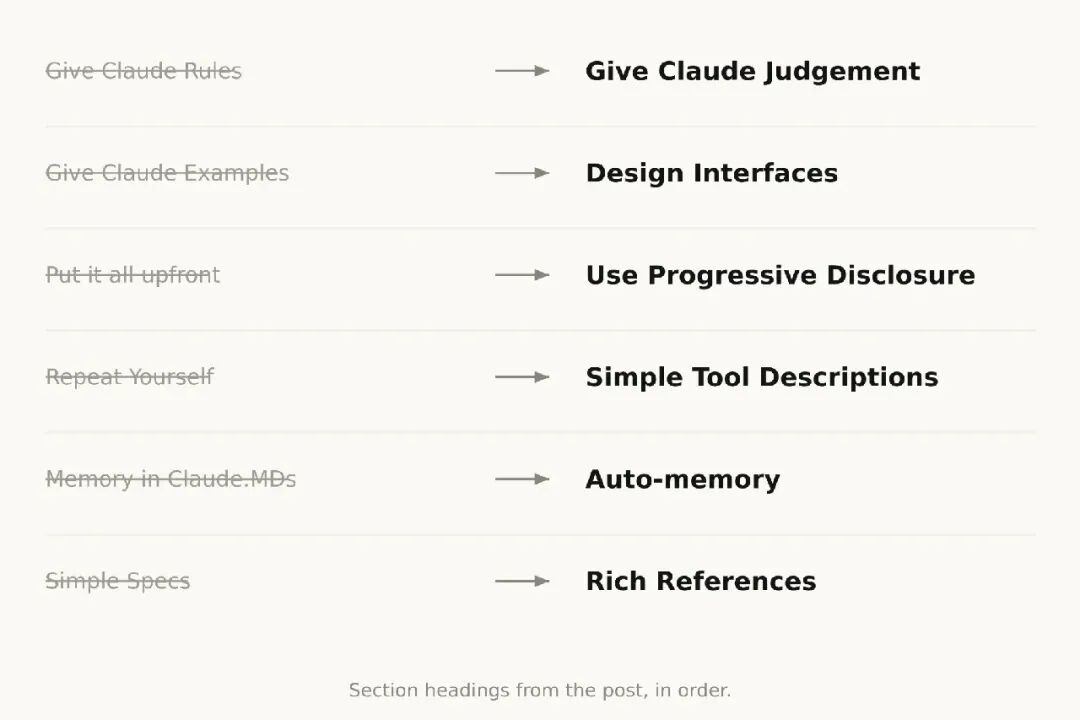
给出六条“过去→现在”的翻转,每一条都值得抄下来:
- 给规则 → 给判断力
- 给示例 → 设计好接口(示例会把模型限制在特定探索空间里)
- 全部前置 → 渐进式披露
- 反复强调 → 简洁的工具描述
- CLAUDE.md 当记忆 → 自动记忆
- 简单规格 → 富引用(HTML mockup、测试套件、rubric 都可以是规格)
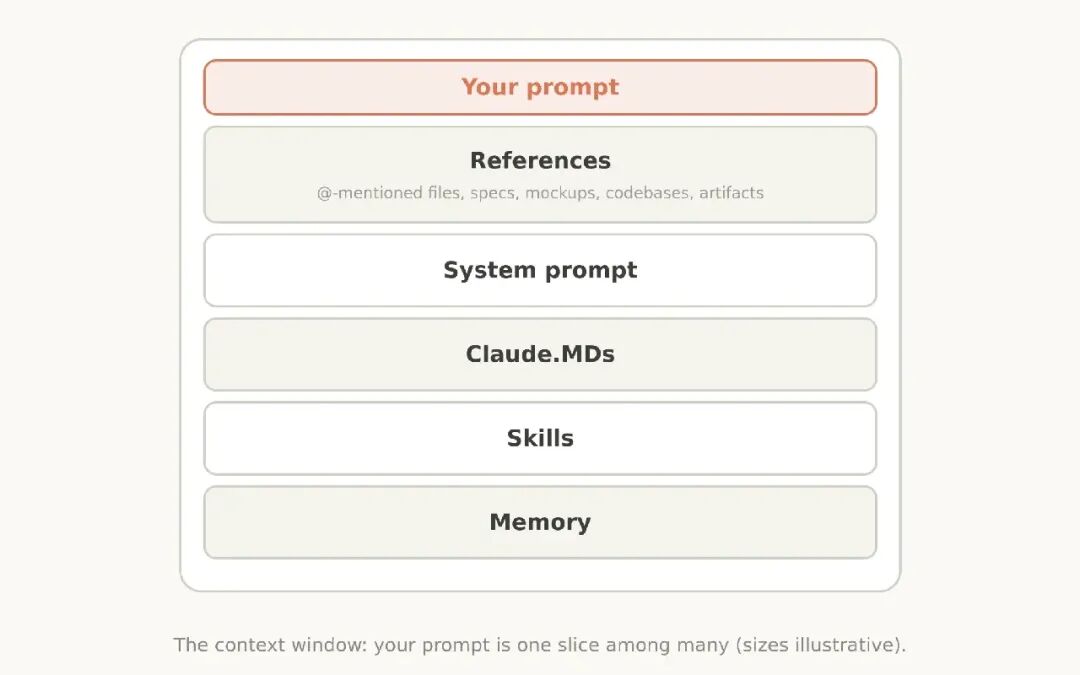
落到你的项目上,文章的建议是:CLAUDE.md 保持轻量,token 主要花在代码库特有的“坑”上;系统提示词绑定产品语境,自建 harness 时最值得投入;引用优先用代码而不是自然语言描述——一个 HTML mockup 传达的设计,胜过一段文字或一张截图。
配套动作也很实在:Claude Code 里跑 /doctor,它会帮你给 CLAUDE.md 和 skills “瘦身”。
PLAYBOOKS:把“感觉变好了”变成数字
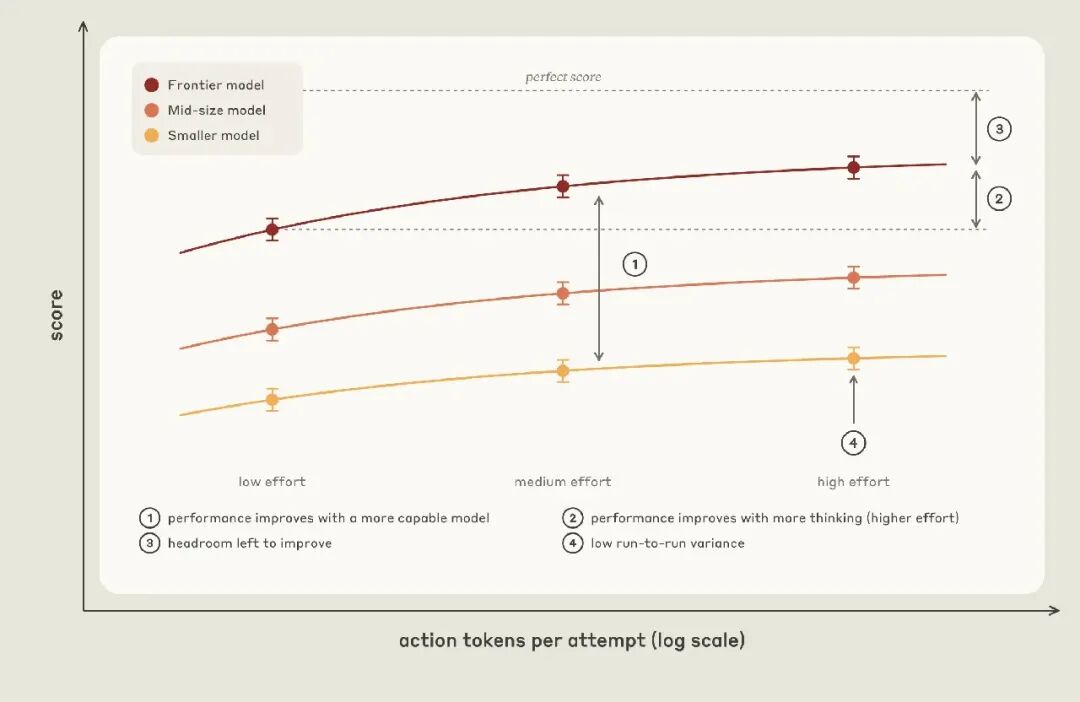
前面三个栏目讲的都是“怎么做”,这个栏目回答“怎么证明做对了”。文章给出好 eval 的四要素:任务分布贴生产、更强模型得分更高、前沿模型仍有 headroom、多次运行方差低。
还有一个容易踩的坑叫对抗采样:因为“今天的模型做错”而挑选的 case,测的其实是这个模型的失败指纹,而不是任务本身的难度。正确姿势是人能说出“这题为什么难”再收录,case 来自生产流量、bug 报告和工单。打分器则按输出空间选择:封闭输出用程序化校验,开放输出用 LLM-as-judge,且裁判模型不能是被测模型。
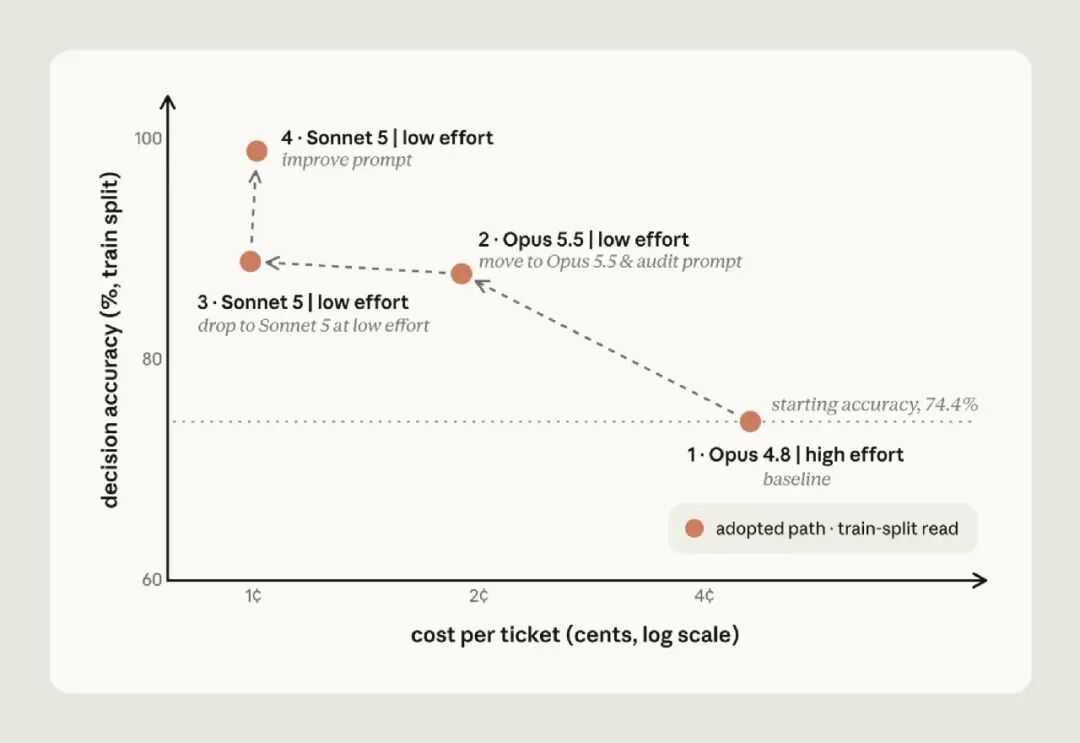
更精彩的是 hillclimbing(爬山法)的防自欺机制:评估集切成 train/test,train 涨、test 平就判过拟合、回滚补丁;永远不把失败样例原文粘进提示词,防止模型“奖励黑客”。
实战数字相当能打。内部客服 benchmark 上,从 Opus 4.8 高 effort 起步(74.4% 准确率、每单 4.6 美分),爬山法一路降模型、降 effort、改提示词,最终在从未见过的 held-out 集上拿到 90.5% 准确率,成本只有原来的约五分之一。
连 claude-api skill 自己也被爬了一遍:通过率从 66% 一路爬到约 88%,中途还顺手抓出两个“任务本身写错了”的评估 bug。
写在最后
Anthropic 的方法论其实是一条闭环:用 workflows 组队干活,用 skills 沉淀经验,用新上下文工程给模型松绑,用 eval 验证每一步。Claude 进化成协同智能体团队的背后,不是某个单点突破,而是这套可以复利的工程纪律。
https://claude.dev/
https://x.com/ClaudeDevs/status/2105391694741119047
 发表于 1 小时前
|
查看: 5|
回复: 0


