用多智能体查代码漏洞,DeepAudit 挖出的 49 个 CVE 值得拆开看。
代码安全审计从来都是一笔不小的开销。要么养人手工翻代码,要么采购 SAST 产品,买回来还得自己消化一堆误报。所以当看到有人用 AI 干这件事,而且真的挖出了 49 个 CVE,我自然会认真看一遍。
这篇文章的主角是 DeepAudit。它把审计拆成一条流水线,四个 Agent 接力,最后一步是把漏洞拿到沙箱里真的打一遍。
这是什么样的项目
DeepAudit 是 lintsinghua 开发的开源项目,定位是代码漏洞挖掘系统。核心能力包括自主协作审计、自动化沙箱 PoC 验证,支持 Ollama 私有部署,也能一键生成报告。协议是 AGPL-3.0,这一点后面单独说。
它自述是国内首个开源的代码漏洞挖掘多智能体系统,目前在 GitHub 上有七千多 Star。
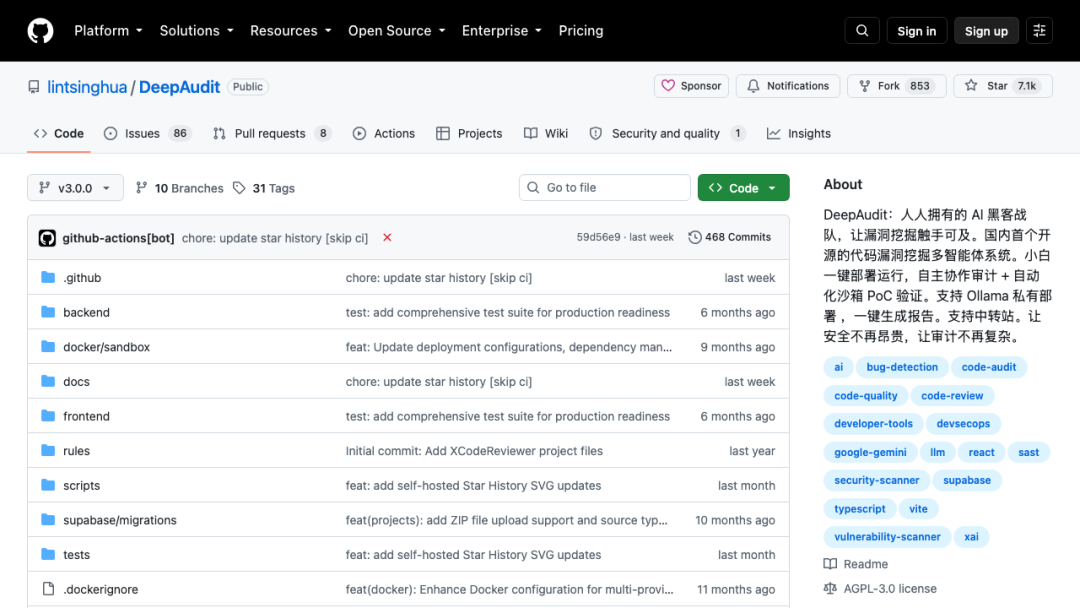
DeepAudit 仓库首页,Star 7.1k
先把一件事说清楚:这里的 Multi-Agent 不是给模型套一层壳就自称 Agent。四个角色之间有真实的上下游关系,上一个角色的产出是下一个角色的输入。
四个 Agent 把审计拆成流水线
第一个角色是 Orchestrator,相当于总指挥。你把项目丢给它,它先分析代码库结构、判断技术栈,再把任务拆解下发。审计跑完后,由它汇总结果、剔除误报、生成最终报告。
第二个是 Recon Agent,干侦察的活。它扫项目结构、识别框架依赖、找出 API 入口点,先把整个项目的攻击面画出来。传统 SAST 在这块很弱,因为它们不理解路由,也不理解框架约定。
第三个是 Analysis Agent,负责挖漏洞本身。它背后挂着一个装载 CWE/CVE 数据集的 RAG 知识库,分析代码时调库做语义比对。这比纯跑规则引擎聪明,代价是 token 消耗更高。
第四个是 Verification Agent,也是这套系统真正的分水岭。
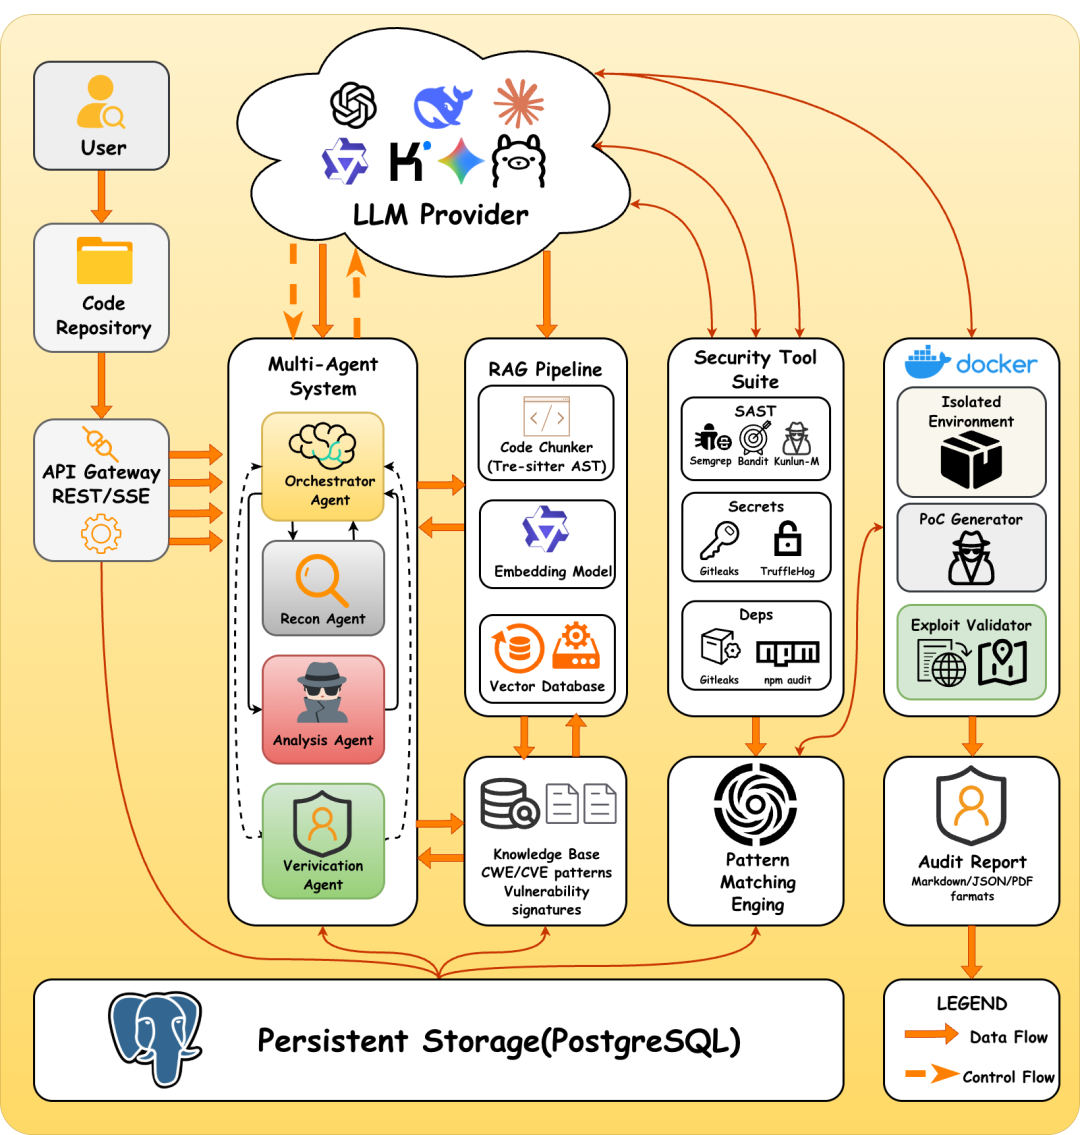
DeepAudit 官方架构图
技术栈方面,后端用 Python FastAPI,Agent 编排基于 LangGraph,向量库是 ChromaDB,数据库是 PostgreSQL 加一个 Redis。前端用 React 配 TypeScript,UI 组件库是 shadcn/ui。代码结构也很直白,backend/agents/ 下面就是四个文件:orchestrator.py、recon.py、analysis.py、verification.py。
沙箱里跑不通就丢掉
这是我认为整个项目最值得关注的设计。
Verification Agent 会对每一个疑似漏洞自动写一份 PoC 脚本,然后扔进 Docker 沙箱里执行。脚本跑通了,这个漏洞才进报告;跑不通,直接丢掉。
传统 SAST 的痛点是告警太多——一百条里真有五十条就算不错,剩下全靠人消。DeepAudit 的思路是只留能打通的,把消误报这件事从人工挪进了流程。
沙箱本身是独立镜像,与主服务隔离。这个设计是对的,不能让一段自动生成的攻击代码直接在宿主机上跑。
两种模式:重活和轻活分开
Agent 深度审计是主角。你可以从 GitHub、GitLab、Gitea 导入项目地址,或者直接传 ZIP 包,它就开始跑。界面上能实时看到 Agent 的思考过程和执行日志。日志这个设计很实用——你能看到它在想什么、在干什么,出问题时也好定位。
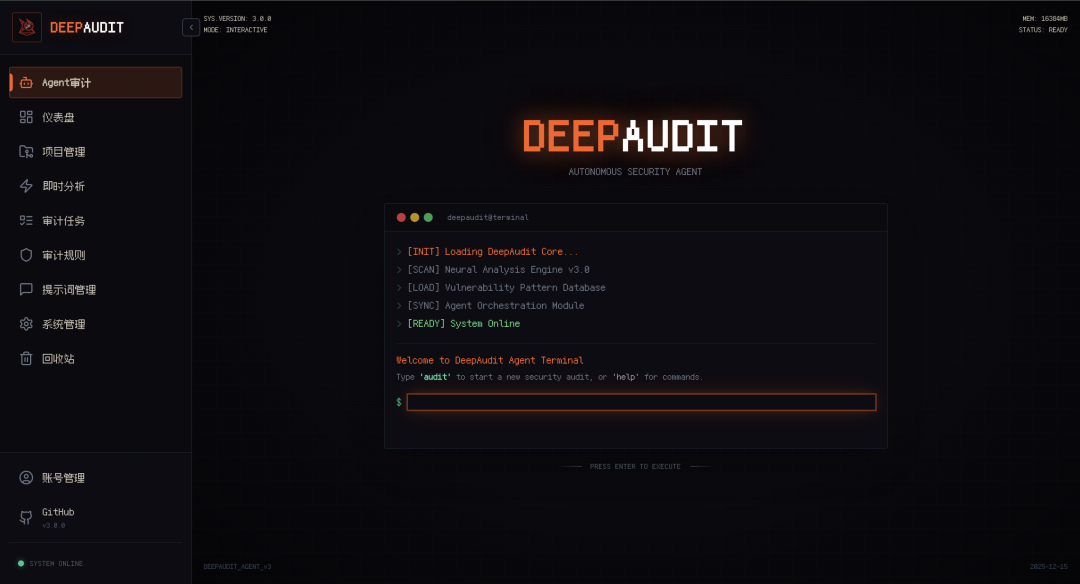
Agent 审计入口首页
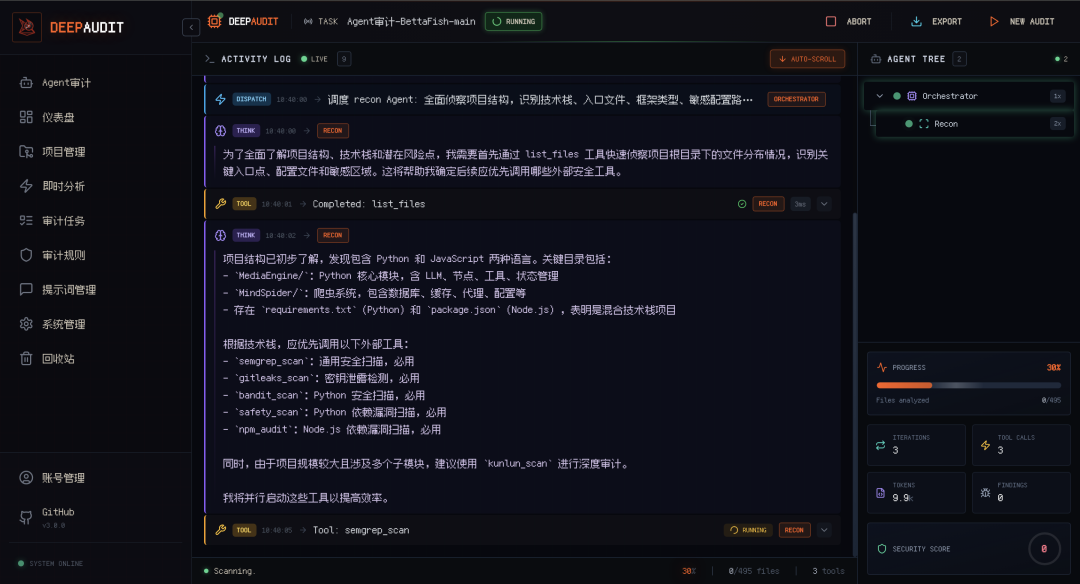
审计流实时日志
即时分析更轻量。粘贴一段代码进去,秒级出结果,覆盖安全问题、Bug、性能、代码风格、可维护性五个维度。它比传统 AI 代码审查多了一层 What-Why-How,会讲清为什么有问题、该怎么修。
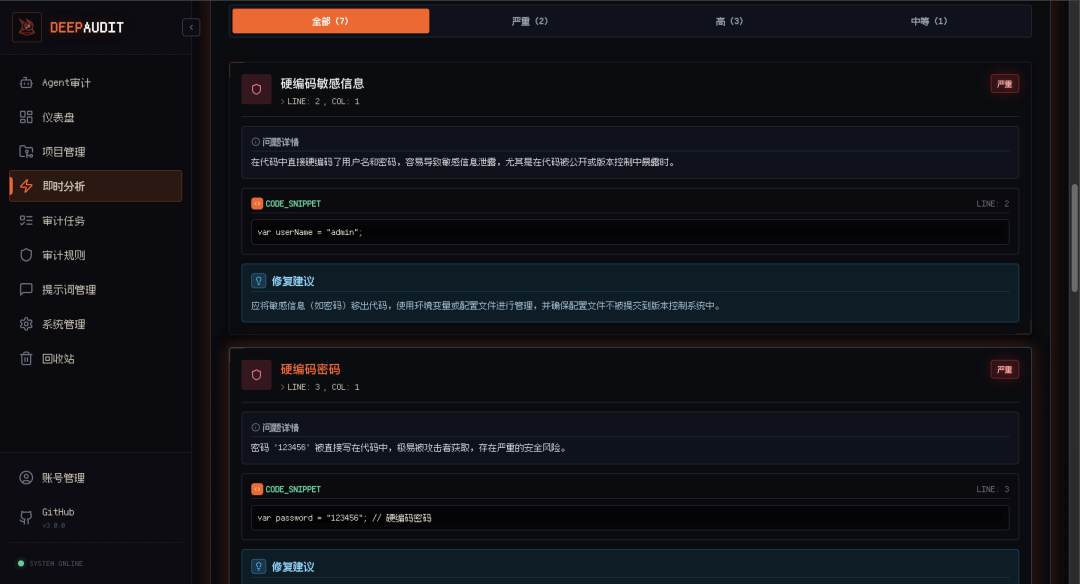
即时分析功能
界面里能看到什么
仪表盘把项目的整体安全态势摊开,项目管理支持多仓库并行。报告可以一键导出 PDF、Markdown 或 JSON。
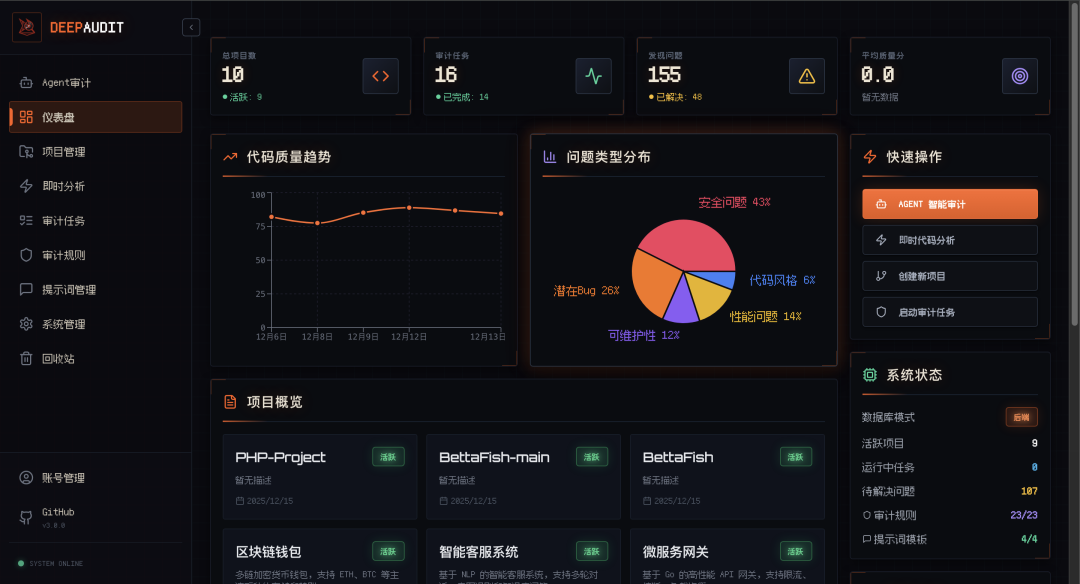
智能仪表盘
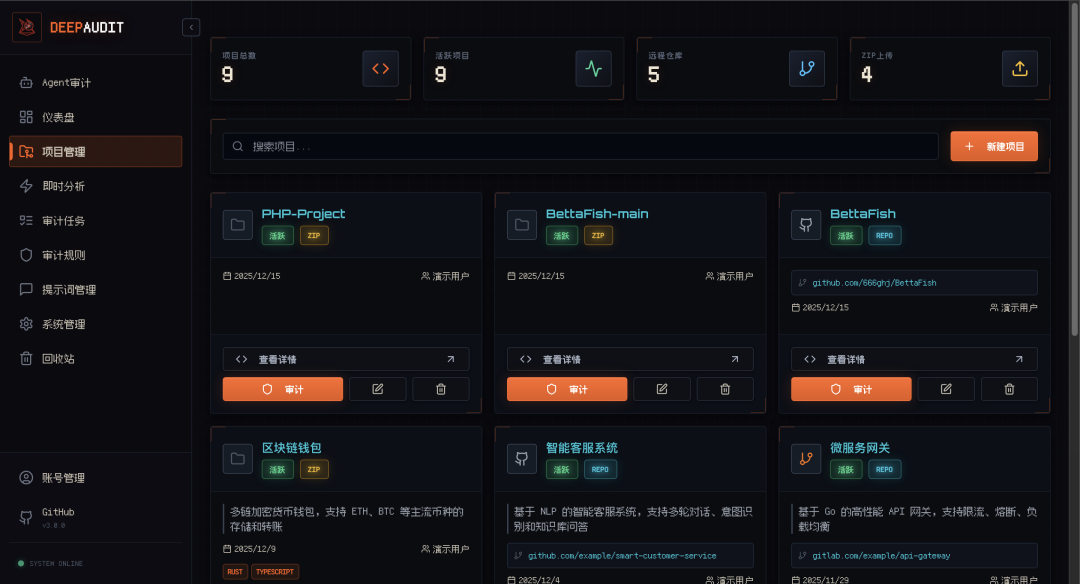
项目管理界面
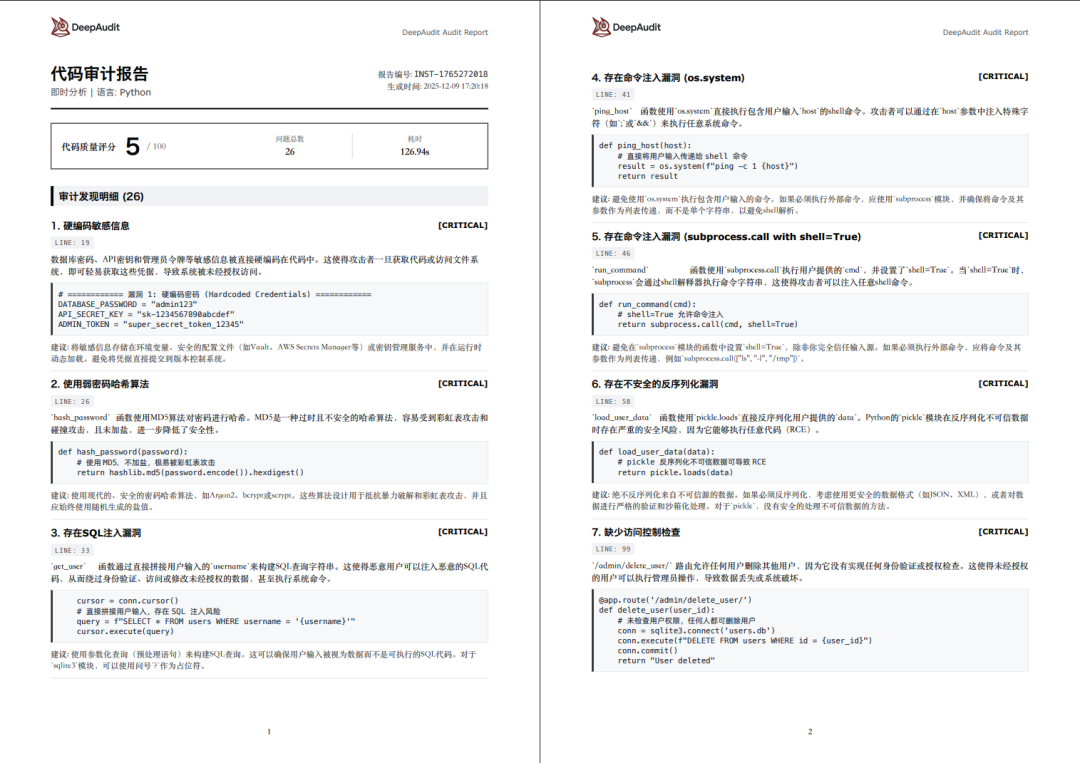
审计报告示例
49 个 CVE 的成色
这部分是它能被认真讨论的原因。
团队用自己的工具跑了一批国内知名开源项目,产出的 CVE 都能在 NVD 上查到。禅道 PMS 上找到 SSRF 和权限提升,CVSS 最高 9.1。DataEase 挖出三个 JNDI 注入,CVSS 全是 9.8,另外还有一个 9.8 的 SSRF。H2O-3 两个反序列化,同样 9.8。
再往下看。O2OA 有一批 XSS,密密麻麻将近二十个。Jimureport 的反序列化 9.8,Litemall 的硬编码凭据 9.8。Mall、xxl-job、eladmin 这些更常见的项目也都在列。OpenClaw 上还贡献了 6 个 GHSA,类型包括命令注入、RCE、签名验证绕过和凭证泄露,多个 High 级别,对应项目官方都发了公告。
官方仓库里的 CVEList.md 当前统计是 49 个 CVE、涉及 16 个项目、12 类漏洞。这些漏洞都被对应项目官方确认过,这比任何自评都硬。
部署只要一行命令
部署不复杂,官方给的就是一条命令:
curl -fsSL https://raw.githubusercontent.com/lintsinghua/DeepAudit/v3.0.0/docker-compose.prod.yml | docker compose -f - up -d
国内拉取慢的话有加速版,走南京大学的镜像站:
curl -fsSL https://raw.githubusercontent.com/lintsinghua/DeepAudit/v3.0.0/docker-compose.prod.cn.yml | docker compose -f - up -d
容器起来之后访问 http://localhost:3000 ,在系统设置里填上 LLM API Key 就能用。模型配置在浏览器里改,不用重启服务,想对比不同模型的效果非常方便。
如果要做源码开发,环境要求是 Python 3.11 以上、Node.js 20 以上、PostgreSQL 15 以上,用 uv 管 Python 环境,前端用 pnpm。
上生产前必须认清的几件事
第一,模型依赖太重。四个 Agent 都靠 ReAct 格式驱动,也就是 Thought、Action、Action Input 那一套,模型得能稳定遵循这个格式。用 GPT-4o 或 DeepSeek V3 问题不大,换成参数较小的本地模型,比如 Qwen2.5-7B,跑几步就开始格式漂移,编排直接断掉。支持 Ollama 和什么模型都能用好,是两件事。
第二,大仓库扫起来慢而且贵。四个 Agent 轮番工作,每一步都在烧 token。审一个几十万行的项目,光 API 费用就不是小数目,扫完可能要以小时计。传统 SAST 比如 Semgrep 几秒钟就能出结果,速度上不在一个量级。
第三,沙箱 PoC 验证不是万能的。它目前在 SQL 注入、命令注入这类偏通用的漏洞上效果不错,但如果漏洞触发需要复杂的多服务环境,沙箱根本搭不起来。遇到内存破坏类漏洞,自动生成的 PoC 成功率也会打折。报告显示验证通过,不代表百分之百可利用。
第四,社区反馈过一些具体问题。有人遇到加载项目失败,有人发现报告里的漏洞路径缺绝对路径或行号有偏差,定位代码时要自己再核对一遍。南京大学的镜像站之前还下架过 sandbox 镜像,导致国内拉取失败。
第五,协议问题。AGPL-3.0 拿来做内部工具没问题,要在商业产品里集成,就得认真读一遍许可条款。
最后的判断
模型支持范围是够用的。GPT-4o、Claude 3.5、Gemini Pro、DeepSeek V3 都在,国内的通义千问、GLM-4、Kimi、文心一言、豆包也能接。支持 Ollama 本地部署这点尤其重要,可以跑 DeepSeek-Coder、Llama3、Qwen2.5、CodeLlama,代码不出内网,有合规要求的场景就得靠它。
免责声明写得挺实在。开头就把「代码会被发到所选 LLM 服务商的服务器」摆在最前面,还列出几类不该上传的代码。商业机密、敏感数据、受法规限制不能外传的内容,以及未经授权拿到的第三方代码,都点名了。结论也清楚:这类代码要走 Ollama 本地模型或者私有部署的 LLM 服务。
文档这块做得也不含糊。仓库 docs/ 目录下有 Agent 审计、架构、部署、配置、LLM 供应商、常见问题等专题文档,还有中英日三版 README,上手前值得先翻一遍。
整体看下来,它现阶段适合当安全研究人员的辅助工具,或者中小团队给自己的项目做一次安全摸底。方向有价值,但 Issues 里的反馈说明它还不成熟,会漏东西、也会误报,还出现过卡死。
想动手的话,直接从那条 Docker Compose 命令开始就好,项目地址是 https://github.com/lintsinghua/DeepAudit 。
 发表于 4 天前
|
查看: 14|
回复: 0


