在 SQL 里判断一个字段是否为空值,用 WHERE status = NULL 去查,结果集是空的;必须写成 WHERE status IS NULL 才能正确返回数据。这个问题看似简单,背后其实是 SQL 关系模型里一个很核心的设计:NULL 根本不是值。
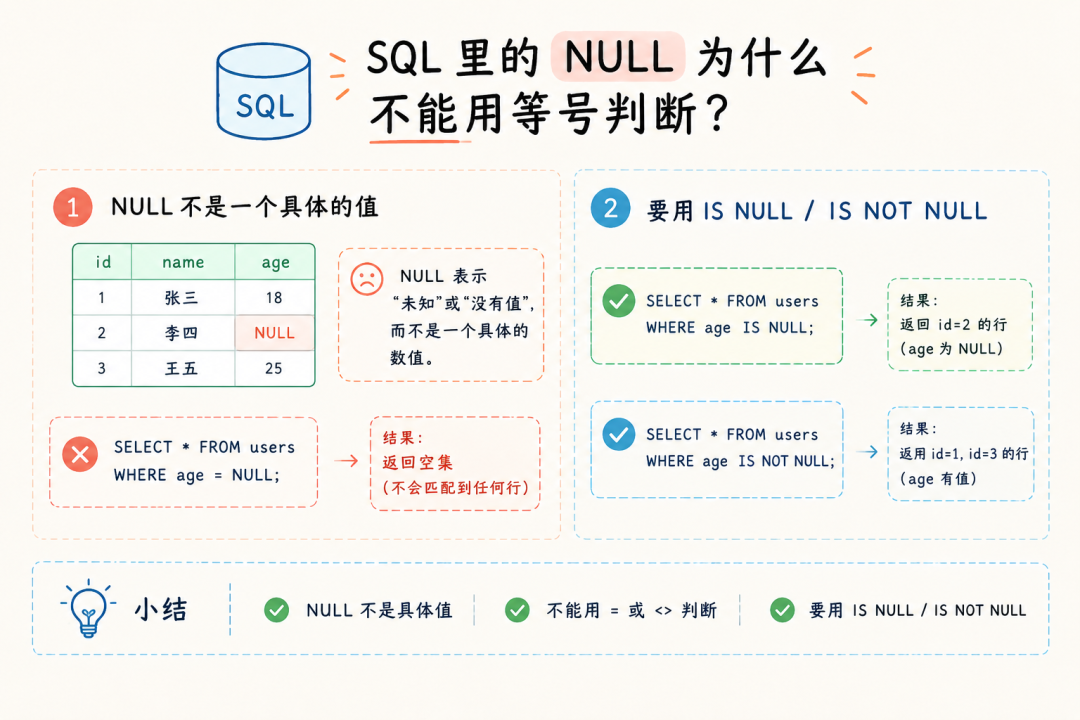
NULL 不是一个值
大多数编程语言里,null 是一个特殊值,表示"空"或"没有对象"。Java 里可以写 if (obj == null),Python 里可以写 if x is None,这些判断都成立,是因为 null/None 在语言层面就是一个可以参与比较的值。
但在 SQL 的关系模型里,NULL 不是值,而是一种状态,表示 unknown 未知。它不是空,不是零,不是空字符串,而是"我不知道这个值是什么"。
一个员工的离职日期是 NULL,并不是说他的离职日期是空的,而是说我们不知道他什么时候离职,也许他还没离职,也许只是还没录入。这个语义差异,直接决定了 NULL 不能用等号比较。
等号比较的逻辑
SQL 的等号 = 是一个比较运算符,返回值是布尔类型:TRUE、FALSE。
SELECT1 = 1;    -- TRUE
SELECT1 = 2;    -- FALSE
当 NULL 参与比较时,结果既不是 TRUE 也不是 FALSE,而是第三种状态:UNKNOWN。
SELECTNULL = NULL;   -- UNKNOWN(不是 TRUE)
SELECTNULL = 1;      -- UNKNOWN(不是 FALSE)
SELECTNULL <> 1;     -- UNKNOWN(也不是 TRUE)
SELECTNULL > 0;      -- UNKNOWN
为什么 NULL = NULL 不是 TRUE?
因为 NULL 的语义是未知。两个未知的东西,没法断言它们相等。一个员工的离职日期未知,另一个员工的离职日期也未知,你能说他俩同一天离职吗?不能。
SQL 的布尔表达式有三种结果:TRUE、FALSE、UNKNOWN,这是 SQL 标准里明确定义的。
WHERE 子句只要 TRUE
这是 NULL 导致查询结果"丢失"数据的直接原因。
WHERE 子句过滤行的规则很简单:只保留条件结果为 TRUE 的行,FALSE 和 UNKNOWN 都会被过滤掉。
-- 假设 employee 表有这些数据:
-- id=1, name='张三', quit_date='2024-06-01'
-- id=2, name='李四', quit_date=NULL

SELECT * FROM employee WHERE quit_date = NULL;
对于 id=1:'2024-06-01' = NULL → UNKNOWN,不返回
对于 id=2:NULL = NULL → UNKNOWN,不返回
结果集是空的。两行数据都不满足条件,因为任何值跟 NULL 做等号比较,结果都是 UNKNOWN,而 UNKNOWN 不是 TRUE。
-- 正确写法
SELECT * FROM employee WHERE quit_date ISNULL;
IS NULL 不是比较运算符,它是一个专门的谓词(predicate),直接判断这个值的状态是不是 NULL,返回 TRUE 或 FALSE,不存在 UNKNOWN 的问题。
隐蔽的坑:NOT IN 遇上 NULL
等号比较的 UNKNOWN 问题在 NOT IN 里表现得更加隐蔽。
-- 找出不在部门 10、20 里的员工
SELECT * FROM employee WHERE dept_id NOTIN (10, 20, NULL);
这条查询的返回结果是空的,一条数据都没有。
展开看就明白了,NOT IN (10, 20, NULL) 等价于:
WHERE dept_id <> 10 AND dept_id <> 20 AND dept_id <> NULL
dept_id <> NULL 的结果永远是 UNKNOWN。在三值逻辑里,TRUE AND UNKNOWN = UNKNOWN,所以整个 WHERE 条件对每一行的结果都是 UNKNOWN,全部被过滤掉。
这个坑在实际业务里特别容易踩:子查询返回的结果集里混进了一个 NULL,外层的 NOT IN 就会静默地返回空结果,不报错也不提示!
-- 这种写法有风险
SELECT * FROM employee WHERE dept_id NOTIN (SELECT dept_id FROM department);
-- 如果 department 表里有一行 dept_id 为 NULL,结果就是空的

-- 安全写法:用 NOT EXISTS 替代
SELECT * FROM employee e
WHERENOTEXISTS (
SELECT1FROM department d WHERE d.dept_id = e.dept_id
);
NOT EXISTS 不受 NULL 影响,因为它判断的是子查询是否返回行,不涉及值的比较。
聚合函数里的 NULL
NULL 的未知语义在聚合函数里同样有影响。
-- 假设 score 列有值:80, NULL, 90, NULL, 70
SELECTCOUNT(score) FROM exam;      -- 3(NULL 不参与计数)
SELECTCOUNT(*) FROM exam;          -- 5(COUNT(*) 统计行数,不看具体列)
SELECTAVG(score) FROM exam;        -- 80(= (80+90+70)/3,不是 /5)
SELECTSUM(score) FROM exam;        -- 240
COUNT(列名) 会跳过 NULL,COUNT(*) 不会跳过。
AVG 在计算平均值时,分母只算非 NULL 的行数。这有时候会让统计结果跟预期完全不符:你以为平均分是 240/5=48,实际上数据库算出来是 240/3=80。
如果业务上希望 NULL 参与计算,当作 0 处理,得显式转换:
SELECTAVG(COALESCE(score, 0)) FROM exam; -- (80+0+90+0+70)/5 = 48
MySQL 的一个特殊行为:<=>
MySQL 提供了一个非标准的运算符 <=>,叫 NULL-safe equal。它比较两个 NULL 时返回 TRUE,一个 NULL 一个非 NULL 时返回 FALSE,其他行为跟 = 一致。
SELECTNULL <=> NULL;   -- 1(TRUE)
SELECTNULL <=> 1;      -- 0(FALSE)
SELECT1 <=> 1;         -- 1(TRUE)
这是 MySQL 的扩展语法,不是 SQL 标准。PostgreSQL 里对应的写法是 IS NOT DISTINCT FROM,标准 SQL 也采用这个。不过日常业务代码里用得不多,大部分场景下 IS NULL / IS NOT NULL 表达更清晰。
说在最后
SQL 的 NULL 不能用等号判断,根本原因在于 SQL 对 NULL 的定义与大多数编程语言不一样。日常写 SQL 如果碰到莫名其妙的"查不出数据",不妨优先检查一下参与比较的参数里是否混进了 NULL。
在云栈社区,不少开发者都分享过自己在生产环境里踩 NULL 坑的经历,这类问题往往隐藏得很深,排查起来格外费劲。多了解一点三值逻辑的底层机制,遇到诡异查询时就能多一条排查思路。
 发表于 昨天 23:32
|
查看: 3|
回复: 0


