导读
近日,云器科技正式对外公布了面向 AI 时代的开源项目——incremental-skills(增量 Skill),同期还发布了配套生产级工具 cz-cli。他们把过去数年积累的增量计算核心算法,封装成一套可被主流 AI编码Agent 直接调用的“算法手册”,让 AI 具备把传统全量批处理 SQL 自动改写为增量计算逻辑的能力,真正做到“一句话让 AI 搞定增量数据开发”。云器科技 CTO 关涛与增量 Skill 核心研发工程师陈唯共同介绍了这一能力,并通过三组现场演示,完整展示了从算法生成到生产级落地的全过程。
主要内容包括以下几个部分:
- 从“不可能三角”说起:为什么需要增量计算
- 实测数据:性能提升近10倍,成本最高可降90%
- AI时代的新命题:能否让大模型学会增量计算?
- incremental-skills:算法与数据源解耦,适配任意引擎
- 现场实测:从单表滑窗求和到双流Left Join,收益量化可见
- 引擎无关、完全开源:一条命令即可安装
- cz-cli:生产级增量能力,引擎接管数据一致性保障
- 写在最后:“能用”只是第一步
01 从“不可能三角”说起:为什么需要增量计算
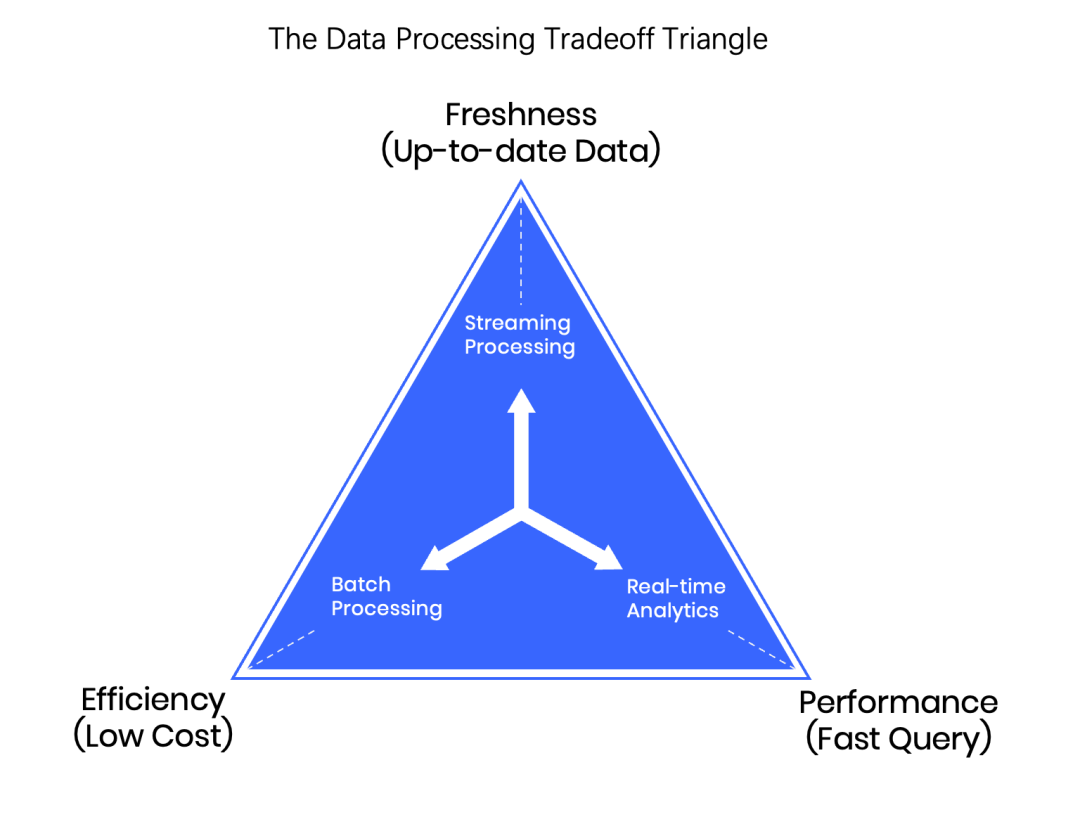
图1|数据处理的不可能三角:数据新鲜度、执行效率与查询性能难以被单一引擎同时满足
数据处理领域长期存在一个“不可能三角”:Freshness(数据新鲜度)、Efficiency(执行效率与成本)、Performance(查询性能)三者很难被单一引擎同时满足。这也解释了为什么企业数据栈通常要同时维护流处理、批处理、交互分析等多套系统,分别覆盖三角形的不同侧面,架构复杂度和维护成本也随之走高。
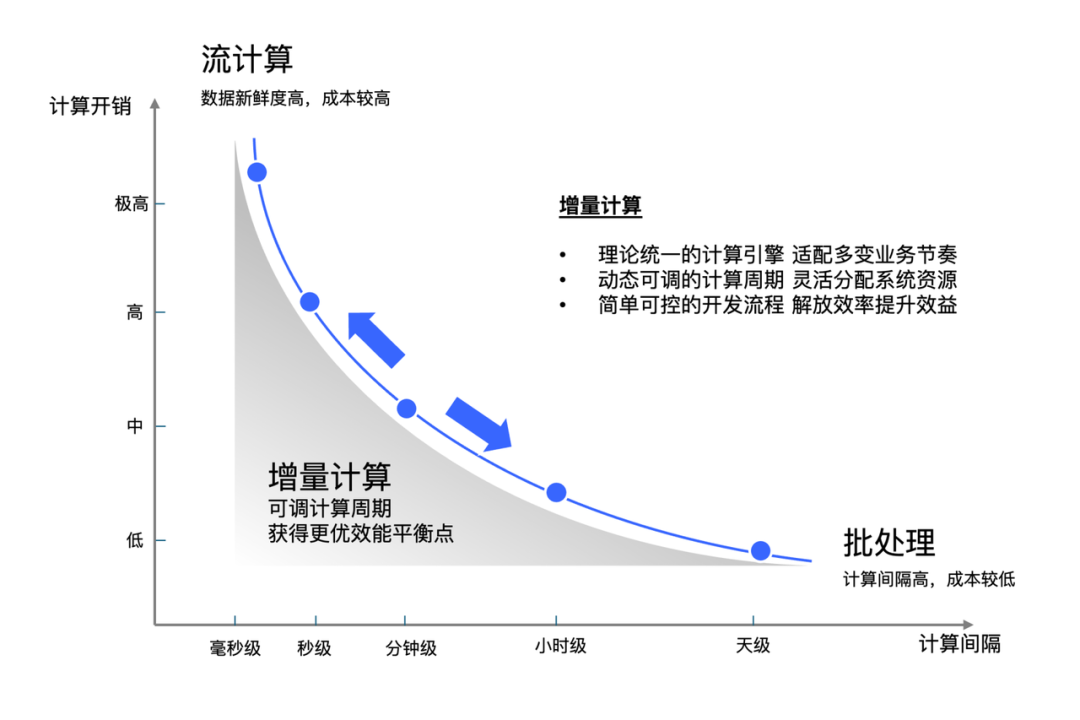
图2|增量计算在计算周期上的位置:周期越短越接近流计算,越长越接近批处理
云器科技提出的增量计算,核心思路可以概括为一个简洁的公式:ResultSet(T0) + Δ(T0,T1) = ResultSet(T1)。当新数据到达时,系统无需从零开始重新计算,而是复用此前已算得的结果,仅针对新增(或变化)的“增量数据”进行计算,并将结果与历史结果融合,从而以远低于全量计算的代价得到最新结果。计算周期越短,其行为越接近流计算;计算周期越长,则接近批处理,由此实现在“数据新鲜度”与“执行成本”之间的灵活调节。
CREATE DYNAMIC TABLE sales
AS
SELECT
  p.product_name,
  SUM(o.price) AS total_sales_amount
FROM
  products p
INNER JOIN
  orders o
ON p.product_id = o.product_id
WHERE product_name != 'Latte'
GROUP BY p.product_name;
在云器 Lakehouse 引擎中,用户只需将建表语句中的 CREATE TABLE 替换为 CREATE DYNAMIC TABLE,业务 SQL 逻辑无需任何改动,系统即可自动完成增量化改造。
02 实测数据:性能提升近10倍,成本最高可降90%
云器 Lakehouse 是完全自主研发的 AI+Data 下一代数据基础设施,以 Single-Engine 架构统一流处理、批处理与交互分析三种计算形态。在 TPC-DS 10TB 基准测试中,云器引擎性能达到 Spark 的 9.51 倍;依托增量执行、避免重复计算的核心机制,客户综合成本最高可降低 50%–90%。目前,云器已在小红书、快手、长安汽车、大众(Volkswagen)、Ninja Van、长城汽车(GWM)、火花思维、Synagie 等头部客户落地,覆盖汽车、金融、零售电商、社交媒体、物流、电信等行业,业务跨中国与东南亚市场。
小红书案例:在小红书 App 全量行为日志(数千亿/天)及维度表更新(数亿/天)分析链路中,相比此前 “Flink+ClickHouse” 方案,云器 Lakehouse 方案把资源投入从 5000 core 降到 1800 core,数据延迟优化到 5 分钟量级,同时准确性从 Diff < 5% 提升到 Diff < 1%,指标维度也可自由扩展到上百个。综合来看,单一引擎带来了架构、开发、存储成本“三个 1/3”的下降。
图3|小红书 × 云器:数据架构的演进
快手案例:在不同复杂度场景下,增量计算都展现出明显的时效性和资源优势。中等复杂度场景中,端到端时效从离线 T+1 小时缩短至 5–30 分钟,资源消耗(核天)从 200 降到 64.3 左右;复杂场景下,离线需要 T+3.5 小时产出,增量最快 30 分钟内完成,资源消耗从 280 降至最低 154.3 核天。收益主要来自单次增量数据量小、避免重复全量计算,同时更早产出也降低了关键指标的破线风险。
图4|快手 × 云器:破解千亿数据处理痛点
03 AI时代的新命题:能否让大模型学会增量计算?
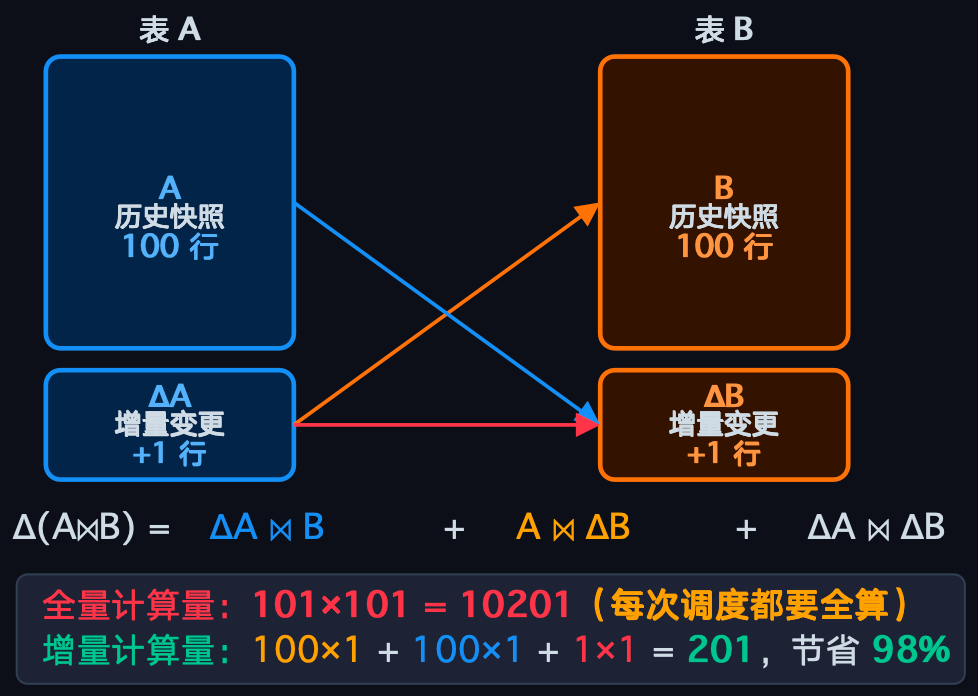
图5|双表 Inner Join 的增量推导:全量重算 101×101=10201 行,增量计算仅 201 行,节省约 98%
增量计算本质上是一套具备严谨数学基础的形式化算法。以最简单的双表 INNER JOIN 为例:表 A、表 B 各有历史数据 100 行,此后各新增 1 行增量数据。全量重算的计算量为 101×101,理论上超过 1 万行;而增量计算的公式是 Δ(A⋈B) = ΔA⋈B + A⋈ΔB + ΔA⋈ΔB,最终计算量只有 100×1+100×1+1×1=201 行,相比全量计算节省约 98%。
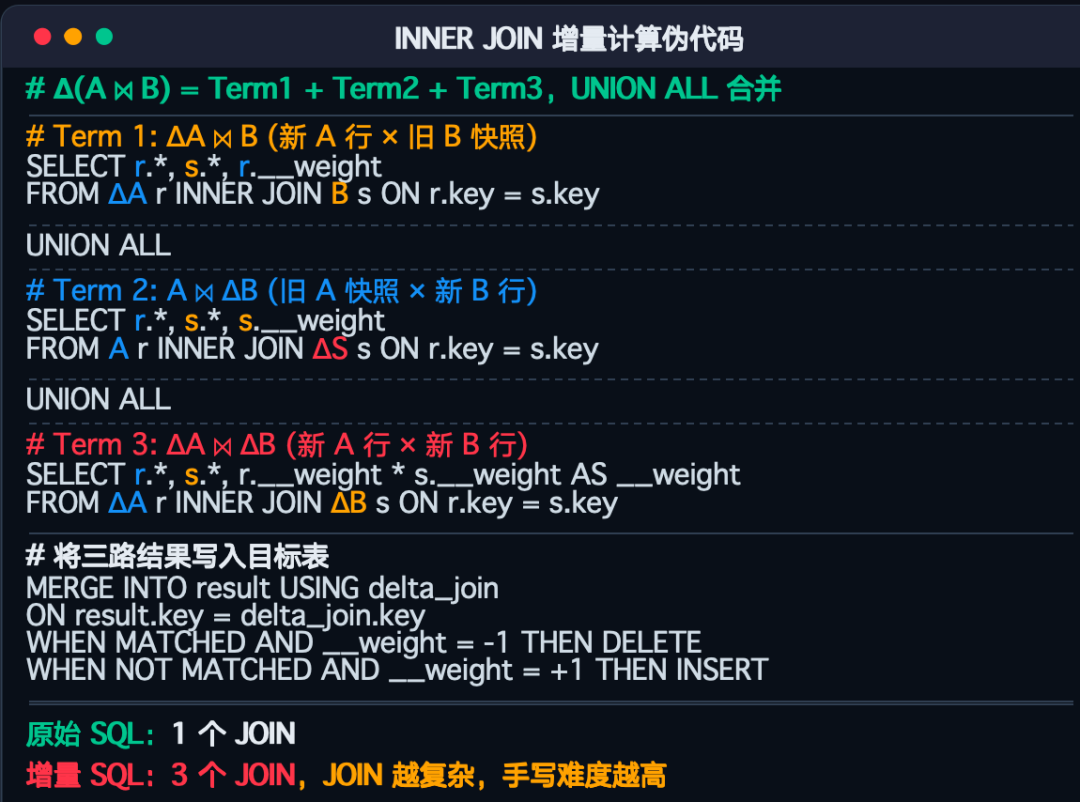
图6|INNER JOIN 增量计算伪代码:语法重写、标准逻辑、JOIN 语法与伪代码
但这套算法改写起来并不简单。原本一行的 JOIN 语句,改写成增量形式后需要拆成三个子查询,再做 UNION ALL 合并,最后通过 MERGE INTO 更新目标表。算子越复杂,手写改写难度越呈非线性上升,规则复杂度和空间复杂度在生产场景中往往难以控制,这也是 SQL 级别的增量改写此前长期未被大规模采用的核心原因。
大模型的通用编码能力为这个问题提供了新解法,但云器科技的测试也表明,直接依赖大模型“裸写”增量算法并不可靠。算法本身有理论门槛,模型生成的改写结果有时会包含隐蔽的逻辑遗漏,而这类错误的人工排查成本极高。因此,云器科技选择了一条更稳健的路径:不是让 AI 自由发挥,而是为 AI 安装一套“专业知识插件”(Agent Skill),让它系统地选择正确算法、生成正确增量代码,而不是凭记忆猜测或即兴发挥。
04 incremental-skills:算法与数据源解耦,适配任意引擎
incremental-skills 采用分层架构设计:
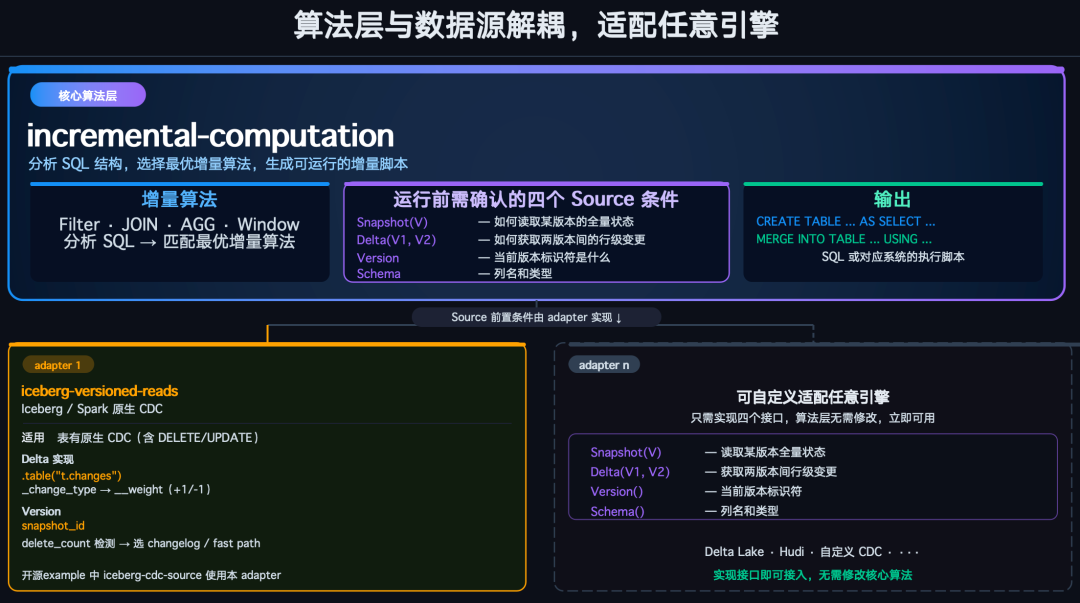
图7|算法层与数据源解耦:incremental-computation 与两类 Adapter 的对应关系
核心算法层(incremental-computation):负责分析 SQL 结构(涵盖 Filter、JOIN、AGG、Window 等主要算子),匹配最优增量算法,并生成可运行的增量脚本。运行前只需确认四个数据源前置条件:如何读取某版本的全量快照(Snapshot)、如何获取两个版本间的行级变更(Delta)、当前版本标识符(Version)、以及列名与类型(Schema)。
Adapter 适配层:项目已预置两类典型 Adapter——面向 Iceberg/Spark 原生 CDC 能力的 iceberg-versioned-reads,以及面向无原生 CDC 能力场景的 business-driven-versioning。后一个 Adapter 揭示了一个关键洞察:分区的进出本质上就是增量变更。新增分区可视为 +1 权重,滑出窗口的分区可视为 -1 权重,无需依赖 CDC 即可推导出完整增量语义。理论上,它可以覆盖 append-only(日志表/事实表)、overwrite(维度表定期刷新,需对新旧快照做 Diff)、sliding-window(滚动窗口聚合)三类典型 ETL 场景,适配 Hive、Spark、Iceberg 等任意引擎及自定义 DWD 分区表。开发者只需实现 Snapshot、Delta、Version、Schema 四个接口,核心算法层无需任何修改即可立即接入。
05 现场实测:从单表滑窗求和到双流Left Join,收益量化可见
增量 skill 研发工程师陈唯在会上演示了三组由浅入深的真实改造场景:
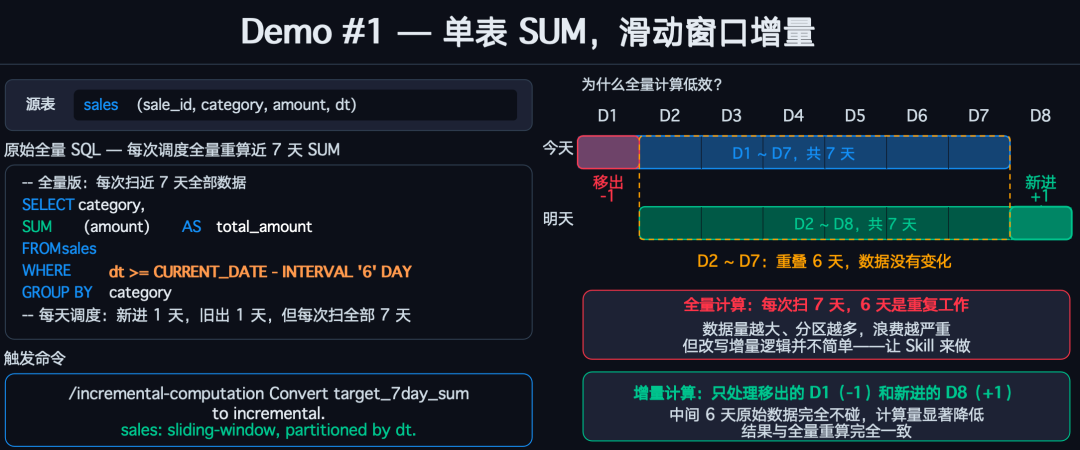
图8|Demo #1 改造方案:单表 SUM 滑动窗口的增量拆分
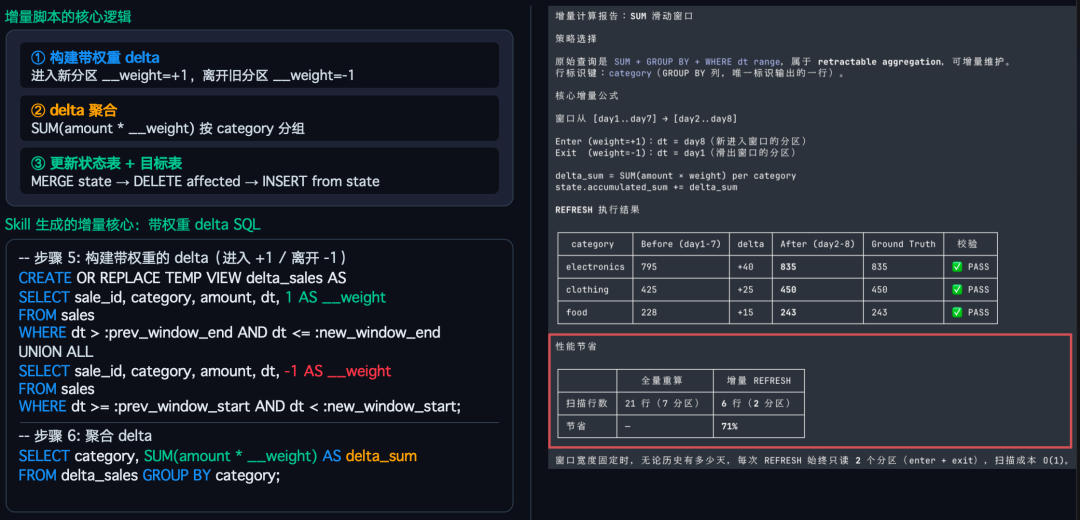
图9|Demo #1 增量计算报告:带权重 delta 脚本与 REFRESH 执行结果,扫描行数由 21 行降至 6 行
Demo #1:单表 SUM 滑动窗口。针对每日全量重算近 7 天分类别销售额的典型报表需求(SELECT category, SUM(amount) ... WHERE dt >= CURRENT_DATE - 6 DAY GROUP BY category),开发者只需输入一句指令:/incremental-computation Convert target_7day_sum to incremental. sales: sliding-window, partitioned by dt.。increment-skills 即自动生成带权重 Delta 的增量脚本:新进分区权重记为 +1,滑出分区权重记为 -1,通过 SUM(amount * __weight) 更新状态表与结果表。实测显示,全量重算需扫描 21 行(7 个分区),增量刷新仅需扫描 6 行(2 个分区,即新进与滑出各一个),性能节省 71%。而且窗口宽度固定时,无论历史数据积累多久,每次刷新的扫描成本恒定为 O(1),结果与全量重算逐行比对完全一致(PASS)。
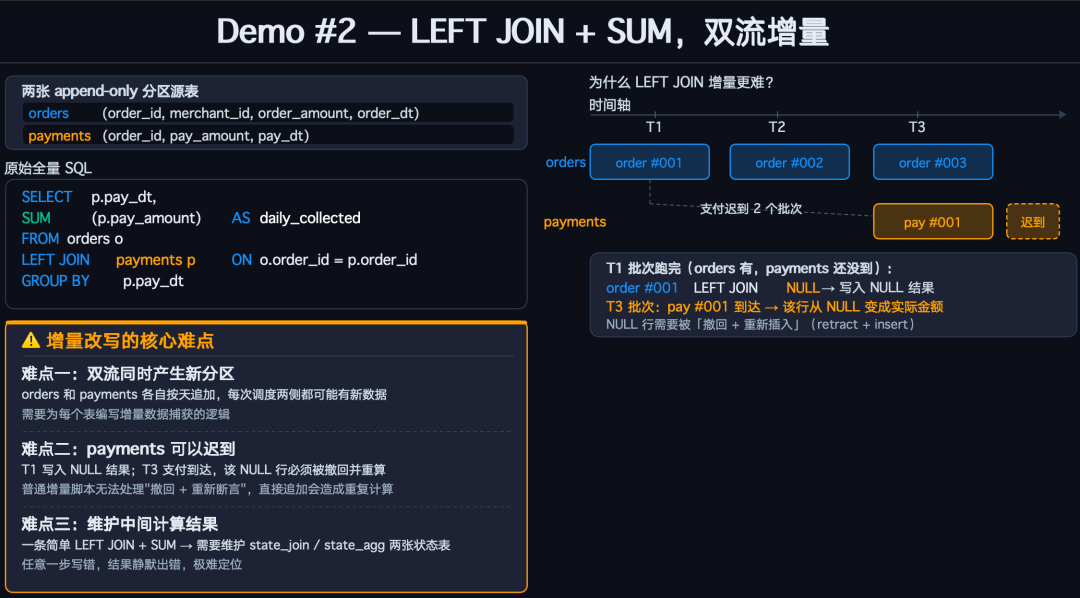
图10|Demo #2 改造方案:LEFT JOIN + SUM 的双流增量拆分
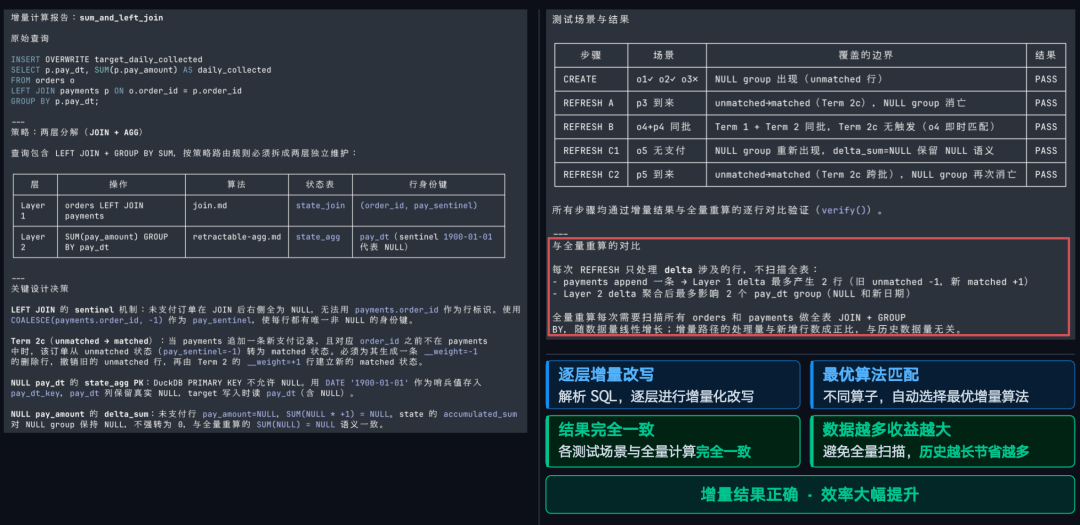
图11|Demo #2 增量计算报告:两层算子分解、Sentinel 机制与 5 个边界场景的逐行验证
Demo #2:双流 LEFT JOIN + SUM 聚合。这是一个复杂得多的双流场景:orders 与 payments 两张 append-only 分区表各自按天追加数据,且 payments 存在“迟到”问题。订单先到、支付延迟到达时,LEFT JOIN 会先产生 NULL 结果;待支付数据到达后,该 NULL 行必须被“撤回并重新计算”(Retract & Insert),普通增量脚本很难正确处理这种撤回逻辑。increment-skills 会自动把该查询分解为 JOIN 与可撤回聚合(Retractable AGG)两层带状态算子,分别维护 state_join 与 state_agg 两张状态表,并通过精心设计的 Sentinel 机制(用固定占位值代替 NULL 参与 JOIN,避免 NULL 语义歧义)保证撤回与重算的正确性。全部测试场景——包括 NULL 分组出现、跨批撤回、迟到数据触发的 Term 重算等边界条件——均通过与全量重算结果的逐行对比验证(PASS)。验证也证明:每次刷新只处理有变化的 Delta 数据,不扫描全表;数据量越大,增量计算相较全量计算的收益越大,而增量处理量只与新增行数相关,与历史数据总量无关。
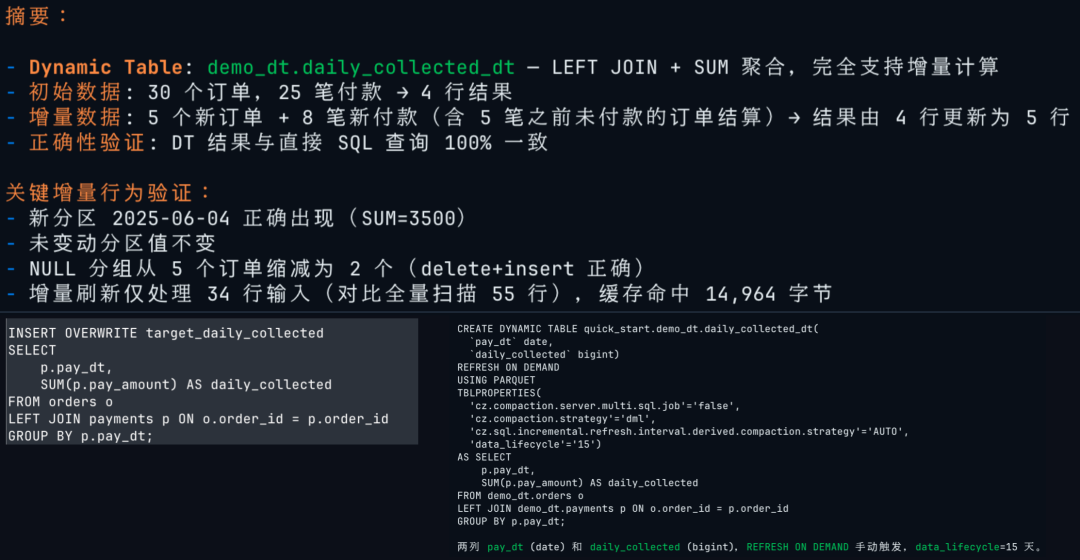
图12|Demo #3 实测:基于 CREATE DYNAMIC TABLE 的生产级验证结果
Demo #3:接入 cz-cli,动态表生产级验证。团队进一步展示了如何用云器的 cz-cli 将 Demo #2 中的 LEFT JOIN 案例改造为可直接生产运行的 Dynamic Table:只需在原始 SELECT 语句前加一段 CREATE DYNAMIC TABLE ... REFRESH ON DEMAND ... 表头声明,业务 SQL 本身零改动。实测中,初始 30 个订单、25 笔付款对应 4 行结果;新增 5 个订单及 8 笔付款(含 5 笔历史未付款订单完成结算)后,结果更新为 5 行,且 Dynamic Table 查询结果与直接 SQL 全量查询 100% 一致。关键是,增量刷新仅处理了 34 行输入数据,相较全表扫描的 55 行,行级增量捕获能力使得计算量随数据量增长而进一步凸显收益,且无需依赖分区假设。
06 引擎无关、完全开源:一条命令即可安装
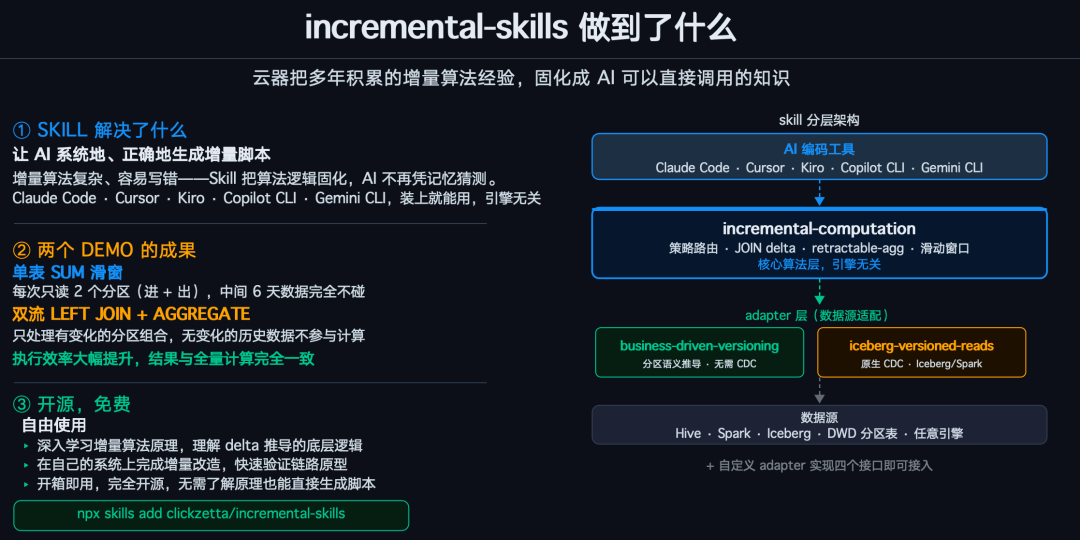
图13|incremental-skills 与主流 AI 编码工具的适配矩阵
incremental-skills 的定位是一套引擎无关的形式化知识体系。云器科技 CTO 关涛在现场特别强调:“即便你的基础设施只有最基础的 Parquet 分区、连数据湖表格式都没有升级,也完全可以通过分区级别的逻辑定义接入这套体系。”
目前,incremental-skills 已在 GitHub 正式开源(clickzetta/incremental-skills),遵循 ClickZetta Incremental Skills License v1.0 协议,面向非商业用途完全免费使用,欢迎社区 Star 与贡献。开发者仅需一条命令即可完成安装:
npx skills add clickzetta/incremental-skills
该 Skill 已适配 Claude Code、Cursor、Kiro、Copilot CLI、Gemini CLI、Codex 等所有主流 AI 编码 Agent,理论上兼容任何支持 Agent Skills 规范的工具。安装后,开发者只需用自然语言描述改造需求(如“帮我把这个 SQL 改成增量的”),Skill 即会自动完成数据源前置条件确认、SQL 结构解析与算子匹配、增量脚本生成、正确性逐步验证的完整流程,并输出包含算法解析、正确性校验、性能量化分析的完整报告,帮助团队理性判断某段链路“是否值得改”,而不是“为了增量而增量”。
07 cz-cli:生产级增量能力,引擎接管数据一致性保障
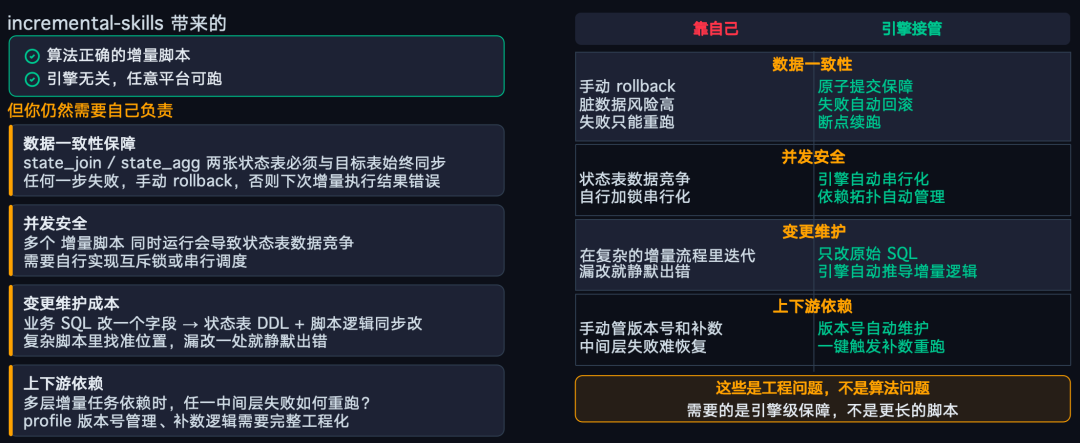
图14|增量脚本对比:靠自己 vs 引擎接管
云器科技特别指出:incremental-skills 生成的增量脚本虽然算法正确、引擎无关,但严肃生产环境仍需要更多平台级工程保障——包括状态表与目标表的数据一致性维护、并发写入的互斥调度、业务 SQL 变更时状态表与脚本逻辑的同步维护、以及多层级联依赖失败时的补数与重跑机制。这些是工程问题,而非算法问题,需要的是引擎级保障,而不是更长的脚本。
为此,云器科技同期发布了 cz-cli——面向 ClickZetta Lakehouse 的开源命令行工具,核心思路是“你写 SQL,引擎替你维护增量流程”。cz-cli 具备三种使用形态,共享同一套云器账号、Profile 与权限体系,便于统一治理与审计:
- Standalone Agent:无需配置任何上层 AI 工具,
cz-cli agent 直接进入完整对话式 Agent 模式,支持自然语言转 SQL 执行、智能 Schema 发现,高风险操作强制人工确认;
- Subagent:作为 Claude Code、Cursor、Kiro、Gemini CLI、Codex 等主流 AI 编码工具的子 Agent 被调用(
cz-agent run),可读取真实 Warehouse 上下文、执行 SQL、诊断 Job,将 ClickZetta 操作无缝纳入 AI 开发工作流;
- CLI Commandline:传统命令行形态(
cz-cli sql),适合脚本、CI/CD 自动化及需要精确可复制命令的场景,支持多环境 Profile 切换(dev/test/prod)。
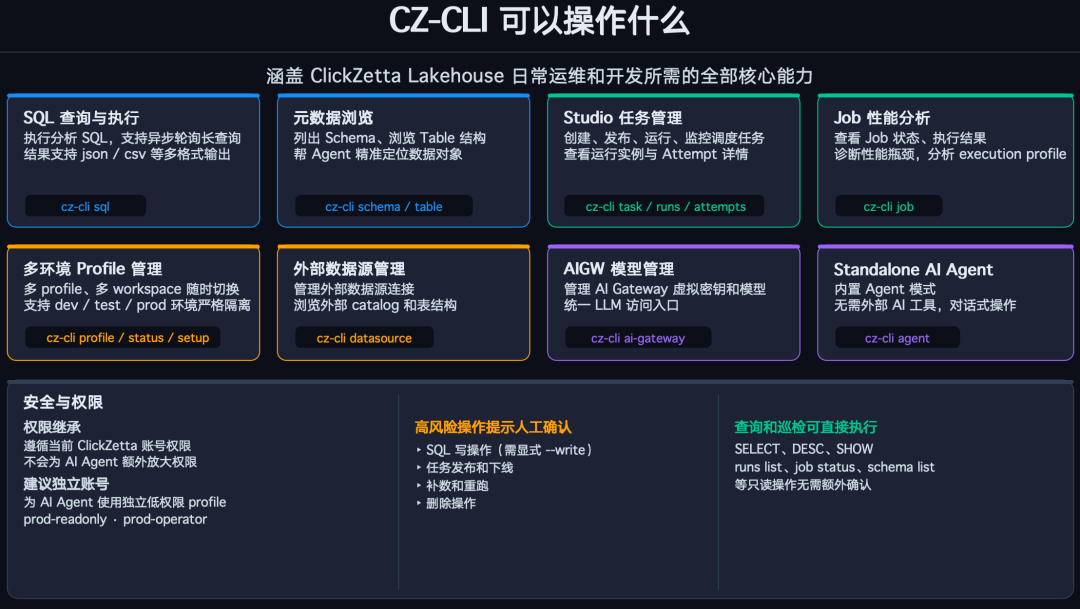
图15|cz-cli 的功能覆盖矩阵
功能覆盖 SQL 查询执行、元数据浏览(Schema/Table)、Studio 任务全生命周期管理(创建/发布/运行/监控)、Job 性能诊断、多环境 Profile 管理、外部数据源管理及 AI Gateway 模型管理等数据工程师日常所需的核心能力。安全设计上,cz-cli 遵循当前账号权限继承、不为 AI Agent 额外放大权限,并建议为 AI Agent 配置独立的低权限 Profile(如 prod-readonly);查询、巡检等只读操作可直接执行,而 SQL 写操作、任务发布下线、补数重跑、删除等高风险操作均需显式参数确认。
安装同样只需一条命令:
curl -fsSL https://cz-cli.ai/install.sh | sh
随后执行 cz-cli setup 完成快速配置,cz-cli status 验证连接。新用户完成配置后即可获赠 1000 万免费 Token,用于体验 AI Agent 原生湖仓接口能力。
08 写在最后:“能用”只是第一步
云器科技 CTO 关涛表示:“增量计算的价值分为三个层次——先解决‘能不能用’,再解决‘好不好用’,最后追求‘能不能做到秒级甚至毫秒级的极致实时’。这次开源的 incremental-skills,解决的正是第一层‘能用’的问题,让任何团队、任何引擎都能低成本地迈出增量化的第一步;而云器的 Lakehouse 引擎与 cz-cli,则致力于在此基础上持续解决‘好用’与‘更实时’的问题。我们希望通过开源的方式,让增量计算这套沉淀多年的技术思想,真正成为整个数据社区可以共享和共建的公共知识。”
 发表于 2 小时前
|
查看: 8|
回复: 0


