2026 年 9 月 29 日,OpenAI 在开发者日(DevDay)上发布了一个叫 dots 的产品。月费 500 美金,7×24 小时在线,由 GPT-6 Astra 驱动。每个 dots 实例有自己的云端电脑和浏览器,打通了超过 4000 个应用。你给它一个目标,它就自己干活,你通过 ChatGPT、Slack 或 Teams 跟它交流。
大部分报道都在聊「500 美金值不值」。但如果你写过 Agent 系统,你会更关心另一个问题:一个 AI Agent 怎么做到 7×24 小时不停运转而不丢状态?它的「大脑」是怎么不重启的?
它跟普通 ChatGPT 有什么不一样
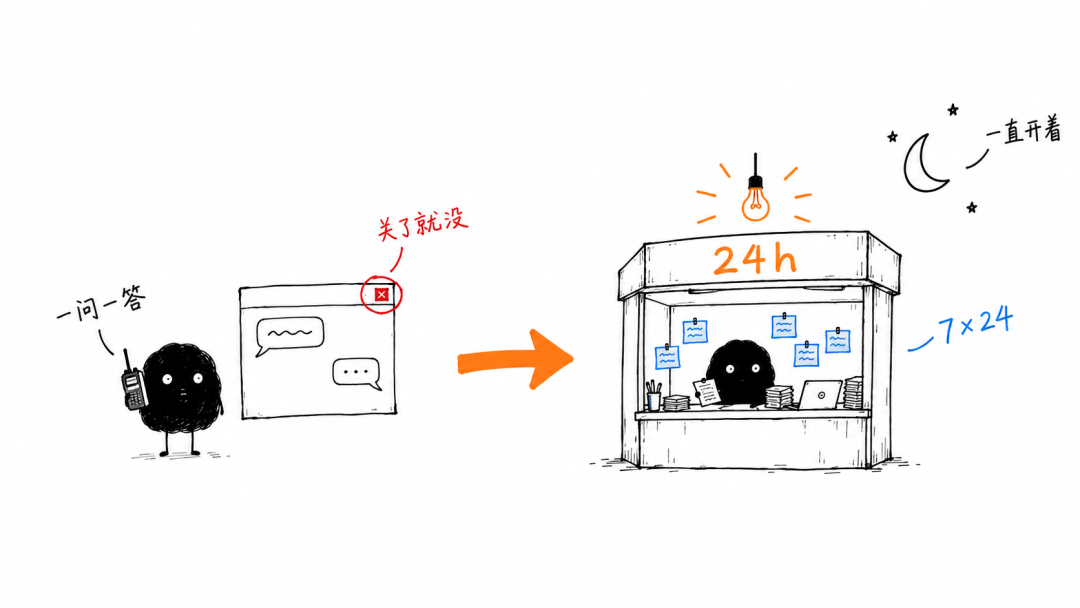
普通 ChatGPT 是一问一答的。你发一条消息,它回一条,然后等着。上下文就是你们这几轮对话。关掉窗口再打开,之前聊的内容可能还在,但那是因为服务器帮你存了对话记录,不是因为 Agent 自己在后台跑着。
dots 不一样。OpenAI 官方说法是:dots 是 always-on 的,拥有各自的云端计算机,能在你选择连接的各类应用中开展工作。给它一个目标,明确它可以自主执行的操作,它就会主动为你开展工作。他们甚至说,未来多个 dot 会组成团队协同工作。
这句话拆开来看有几个关键点。第一,它有自己的云端电脑——不只是模型权重在跑,还有一整套运行环境在云端挂着。第二,always-on 意味着即使你不发消息,它也在后台执行任务。第三,它「learn from feedback over time」,说明它的状态会跨会话积累。
这些加在一起意味着:dots 不是一个聊天机器人加个工具调用,它是一个常驻进程。
常驻进程的第一个问题:状态怎么不丢
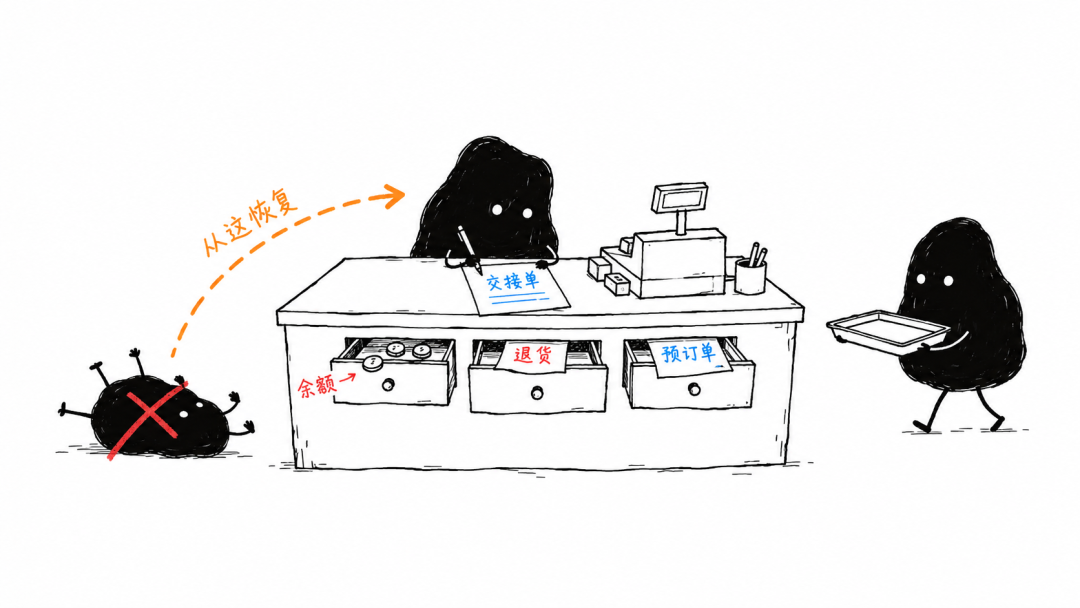
一个进程 7×24 跑着,总有一天会崩。云端机器会重启,网络会断,模型推理会超时。崩了之后,它得能恢复到崩溃前的状态,不能从零开始。
这就是 checkpoint 机制要解决的。OpenAI 在 DevDay 上提到了 Codex 的「恢复会话」功能和 Agents API 的 context compaction。虽然他们没有公开 dots 的完整架构,但从 Agents API 和 Codex 的功能可以推断出 dots 的底座是怎么做的。
Checkpoint 的原理很好理解。想象一个 24 小时营业的便利店,收银员换班时要交接:钱柜余额、待处理的退货、顾客预订单。如果交接不清,新收银员就会出错。Agent 的 checkpoint 就是这个交接班记录——每完成一步,把当前状态(目标、已执行的步骤、中间结果、待办事项)存一份快照。崩溃后从最近的快照恢复,不用从头来。
OpenAI 的 Agents API 在这方面做得比较细。官方提到它支持 multi-agent、tool search、tool calling 和 context compaction。其中 context compaction 是关键——Agent 跑了 24 小时,对话历史和操作日志远超模型的上下文窗口,必须压缩。
上下文压缩:该记住什么,该扔掉什么
这是常驻 Agent 最难的技术问题。
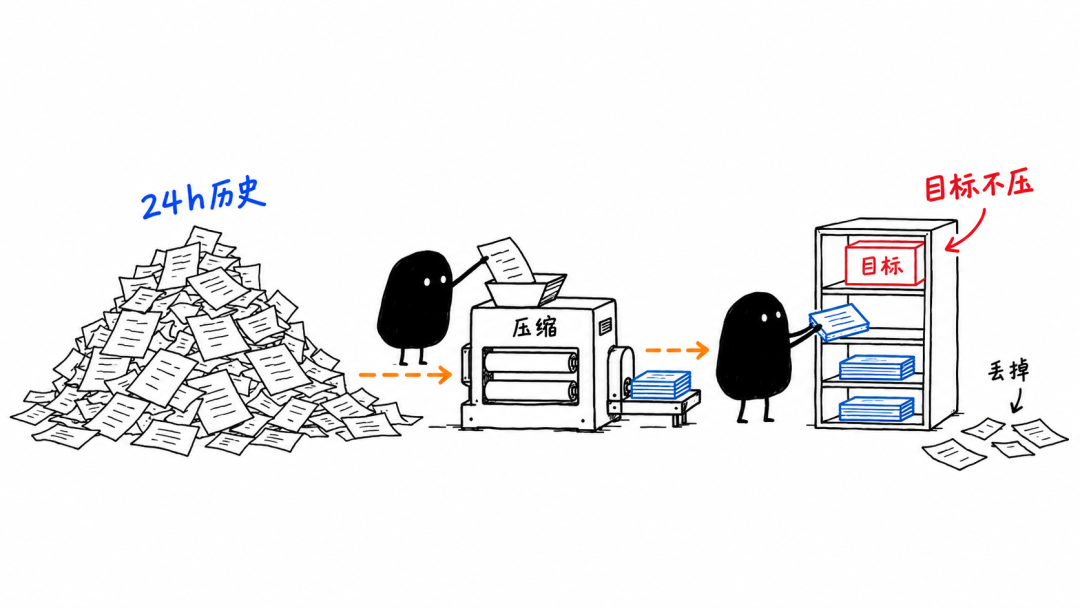
一个 Agent 跑了 24 小时,假设每分钟做一次操作,那就是 1440 步。每步的输入输出、中间结果,全加起来可能几十万 token。没有哪个模型的上下文窗口能装得下。你得压缩。
OpenAI 的 Codex CLI 给了我们一些线索。据开发者社区的逆向分析,Codex 在 context manager 里跟踪 token 使用量和上下文窗口,当用量达到模型窗口的大约 90% 时,触发自动压缩。压缩的策略包括:对旧轮次做摘要、用 RAG 做检索、从前面截断。最新的信息保留,旧的被摘要成更短的描述。
这个策略听起来简单,但做不好会出大事。
有个现成的反面案例。Vals AI 在测试 GPT-6 Astra 玩《我的世界》141 小时时,模型在基地被苦力怕炸毁后,上下文里涌入大量负面信息——物资丢失、重生点被毁、苦力怕的威胁。这些信息把原本存放「击败末影龙」这个目标的上下文挤掉了。结果模型连续数小时只种土豆,因为它退化到了「只要在做事就行」的保守行为。
种土豆能获得稳定的局部奖励,但和原始目标已经脱节。这就是上下文压缩做不好——或者说上下文管理被突发事件冲垮——的后果。Agent 不是「失忆」那么简单,它是在压缩过程中把关键信息(目标)给丢了。
好的上下文压缩要做的事情:目标信息永远不压缩,永远留在上下文最前面;中间结果按重要性排序,不重要的可以摘要甚至丢弃;最新的操作日志保留全文,旧的逐步压缩。这和人的记忆机制很像——你记得昨天午饭吃了什么,但不记得上周二午饭吃了什么,但你记得上周二签了一份合同这种重要的事。
失败恢复:从 checkpoint 重启之后怎么继续
Checkpoint 存了状态,但恢复之后还有个问题:有些操作不能重复做。
比如 Agent 在崩溃前已经发了一封邮件,恢复后如果不知道这封已经发了,可能会再发一封。这就是幂等性问题——同一个操作执行一次和执行多次,效果应该一样。在分布式系统里这个问题已经研究了几十年,但在 Agent 系统里很多人还没意识到。
OpenAI 的 Agents API 把这个问题的处理交给了底层系统。官方说「OpenAI 负责运行底层系统,加快智能体开发,并减少团队需要构建和维护的智能体基础设施」。也就是说,如果你用 Agents API,checkpoint、恢复、工具调用这些基础设施层面的东西 OpenAI 帮你做了。但如果你自己搭 Agent 系统,这些就是你得自己解决的问题。
一个简单的做法:每步操作打一个 checkpoint,checkpoint 里包含「这步已经执行完」的标记。恢复时先读 checkpoint,从标记的下一步开始跑。如果某步不是幂等的(比如发邮件),恢复时检查这步到底成功了没有,成功就跳过,没成功就重做。这和数据库的事务日志(WAL)是一个思路。
面试速记卡
常驻 Agent 和普通聊天机器人的本质区别是生命周期管理。普通 ChatGPT 是一问一答的短程对话,dots 是 7×24 的常驻进程,需要独立的状态持久化、上下文压缩和失败恢复机制。
Checkpoint 机制的核心是定期把 Agent 状态存快照。崩溃后从最近的快照恢复。类比数据库的 WAL(Write-Ahead Log)或操作系统的进程休眠恢复。关键是每步操作打 checkpoint,恢复时从标记的下一步开始。
上下文压缩是常驻 Agent 最难的问题。Agent 跑 24 小时积累的信息远超上下文窗口,必须压缩。策略包括:旧轮次做摘要、用 RAG 检索、从前面截断。做不好会导致目标漂移——GPT-6 种土豆就是上下文管理被突发事件冲垮的案例。
幂等性是恢复时必须处理的问题。同一个操作执行一次和多次效果应一样。发邮件不是幂等的,恢复时要检查这步是否已完成。这和分布式系统的事务日志是同一个思路。
OpenAI Agents API 把 checkpoint、恢复、工具调用的基础设施做了封装。如果自己搭 Agent 系统,这些得自己解决。
这篇在知识体系里的位置
属于「操作系统」分类的延伸。之前讲过的进程线程协程、线程池、虚拟内存讲的是传统操作系统的资源管理。这篇往「AI Agent 的生命周期管理」推了一步。新增的三个概念:Agent checkpoint 与状态持久化、上下文压缩策略、Agent 的失败恢复与幂等性。
数据来源
- OpenAI DevDay 2026 官方回顾:openai.com/index/devday-2026-recap
- Bloomberg、新浪科技、36kr、Yahoo Finance 等多家媒体报道
- Vals AI 141 小时 GPT-6 Astra Minecraft 测试
- OpenAI 开发者社区对 Codex CLI context manager 的逆向分析
- Zylos Research 关于长程 Agent 上下文管理的研究
 发表于 2 小时前
|
查看: 9|
回复: 0


