最近一直在用 AvalonDock 这个组件,把以前写过的模块重新布局。本文从一个可编译运行的 WPF 项目出发,拆解实时采集、阈值报警、SQLite 上下文检索与大模型诊断怎么串成闭环,并复盘四个容易被“界面已经能跑”掩盖的工程问题。
🎯 开头:报警响了,然后呢
车间里最让人头疼的往往不是设备报错,而是报错之后那段空白:报警代码摆在屏幕上,温度、电流、位置偏差散落在不同页面,维修记录还得翻表格。老师傅看一眼能猜出八九分,新同事却可能绕半天。
本文拆解的 DeviceDiagnosisApp,尝试用 .NET 8、WPF、MVVM、SQLite 和大模型把这条链路接起来。读完你能带走三样东西:一条可落地的诊断数据流、一套“AI 失败也能工作”的降级设计,以及几个原型走向生产前必须补上的坑。
看看 AvalonDock 布局
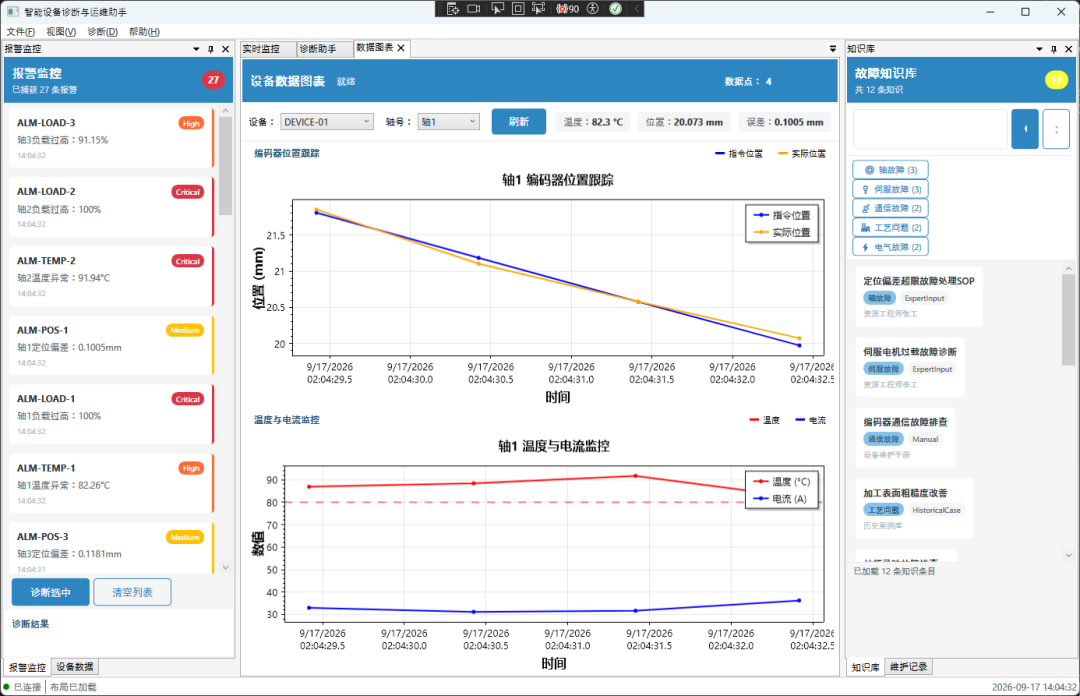
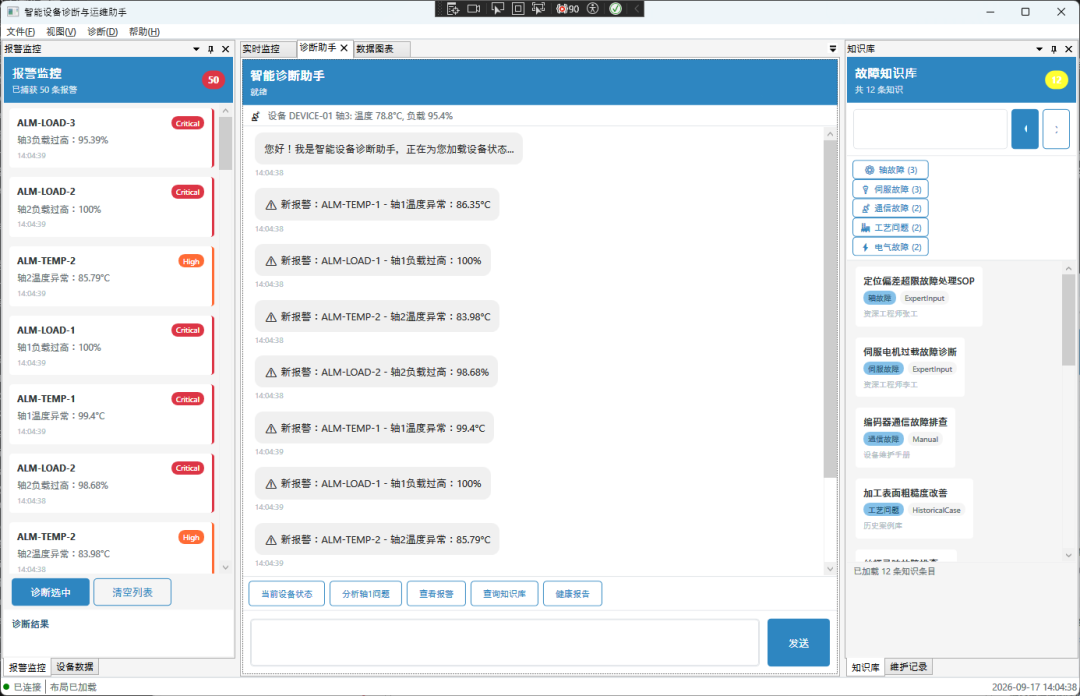
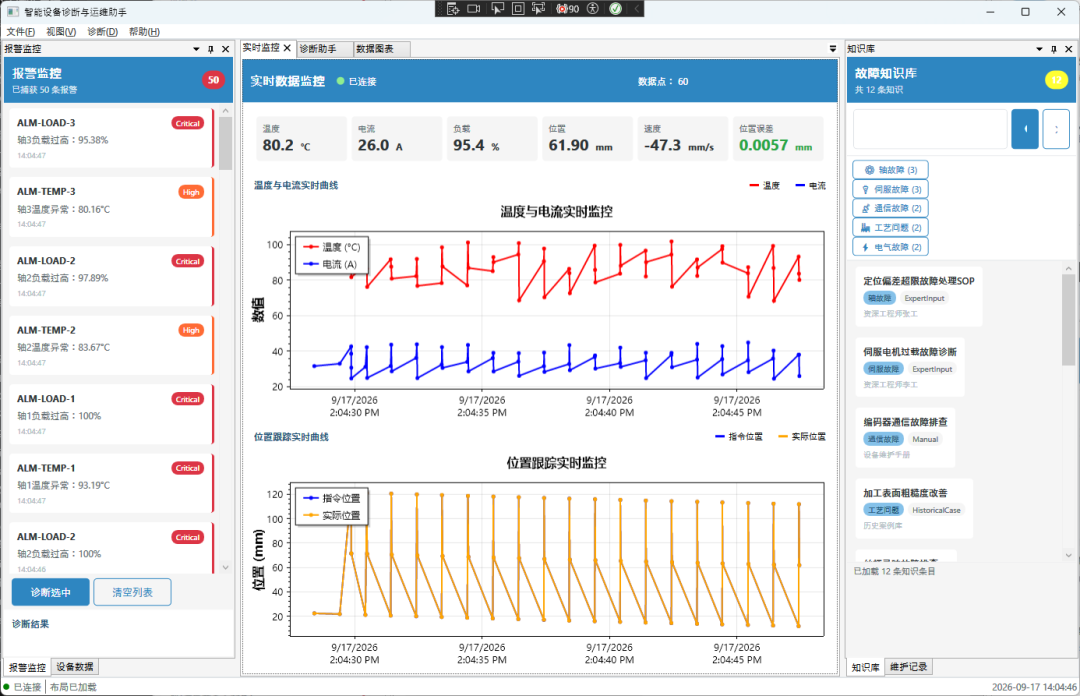
🔍 先看全貌:它不是一个聊天窗口
很多“AI 诊断”演示,做着做着就成了输入框加 API。这个项目不太一样,它先搭设备软件的骨架,再把模型放进诊断环节:
DeviceMonitorService 每秒生成三条轴数据;- 采集值写入线程安全的最新值表和历史队列;
- 温度、负载、位置误差越过阈值时发布报警事件;
- ViewModel 切回 WPF UI 线程,刷新曲线和报警列表;
- 用户触发诊断后,服务查询最近六个月维保记录和前三条知识条目;
- 大模型返回结构化原因与建议;API 不可用时,本地规则立即接班。
这条链路的重点不是“用了 AI”,而是 先形成确定性数据闭环,再让概率模型参与判断。顺序反过来,系统很容易变成一本正经地猜。
项目技术栈也比较克制:.NET 8、WPF、CommunityToolkit.Mvvm、EF Core SQLite、ScottPlot,以及兼容 OpenAI 协议的 DeepSeek 接口。依赖注入集中在启动阶段完成,界面只依赖接口:
services.AddDbContext<AppDbContext>();
services.AddSingleton<IDeviceDataService, SqliteDeviceDataService>();
services.AddSingleton<IAlarmService, SqliteAlarmService>();
services.AddSingleton<IMaintenanceLogService, SqliteMaintenanceLogService>();
services.AddSingleton<IKnowledgeBaseService, SqliteKnowledgeBaseService>();
services.AddSingleton<IDiagnosisService, AgentDiagnosisService>();
services.AddSingleton<IDeviceMonitorService, DeviceMonitorService>();
看起来只是几行注册,实际划出了三层边界:采集是采集,资料查询是资料查询,诊断编排是诊断编排。以后把模拟数据换成 OPC UA、Modbus TCP 或厂商 SDK,原则上不用重写诊断界面。
🧠 实时数据流:别拿 UI 线程硬扛采集
WPF 有一条老规矩:ObservableCollection 和绑定属性最好由创建它们的 UI 线程修改。项目里的采集由 System.Threading.Timer 触发,自然落在后台线程;ViewModel 收到事件后,再通过 Dispatcher 更新界面。
privatevoidOnDataUpdated(object? sender, DeviceDataEventArgs e)
{
    Application.Current.Dispatcher.Invoke(() =>
    {
        CurrentTemperature = e.Data.TemperatureCelsius;
        CurrentLoad = e.Data.LoadPercent;
        PositionError = e.Data.PositionError;
        LastUpdateTime = e.Data.Timestamp;

        TemperatureHistory.Add(e.Data.TemperatureCelsius);
while (TemperatureHistory.Count > 60)
        {
            TemperatureHistory.RemoveAt(0);
        }
    });
}
短,却关键。
采集层用 ConcurrentDictionary 保存各轴最新值,用 ConcurrentQueue 保存历史值。每个“设备 + 轴”最多留 3600 个点;当前周期是一秒,因此单轴约保留一小时窗口。界面曲线只留最近 60 个点,约一分钟。一个负责计算与追溯,一个负责显示,别混成一锅粥。
不过这里也藏着性能拐点。Dispatcher.Invoke 是同步调用,采集线程会等 UI 更新结束。当前只有一台设备、三根轴、每秒一次,压力不大;若扩展到数百测点和 100 ms 周期,UI 一卡,采集也跟着排队。更稳的做法是让采集只写有界缓冲区,UI 按固定帧率批量取最新数据:
privatereadonly Channel<DeviceDataEntity> _updates =
    Channel.CreateBounded<DeviceDataEntity>(new BoundedChannelOptions(1024)
    {
        FullMode = BoundedChannelFullMode.DropOldest,
        SingleReader = true,
        SingleWriter = false
    });

publicboolPublish(DeviceDataEntity data) => _updates.Writer.TryWrite(data);
这段模板的取舍很明确:实时看板优先显示“最新状态”,在消费跟不上时丢弃旧帧,避免内存无边界增长。若数据用于质量追溯,就不能丢,应改走数据库批量落盘。两条通道,各干各的。
🚨 阈值报警:能报出来,还不够
项目设置了三组直观阈值:温度高于 80℃、负载高于 90%、位置误差绝对值高于 0.08 mm。超过更高阈值时,严重程度升级为 Critical。这类规则解释性强,现场人员一眼能懂,很适合第一版。
问题也来得直接:只要温度连续十秒超限,同一个轴就可能连续产生十条报警。响个不停。真接到短信、声光器或工单系统,值班人员大概率先把通知关掉。
生产实现至少应补三件事:
- 迟滞:80℃触发,降到 78℃以下才恢复,避免阈值附近反复横跳;
- 去重窗口:同设备、同轴、同类型报警在限定时间内合并;
- 状态机:明确
Normal → Active → Acknowledged → Resolved,而不是每次采样都创建新记录。
还有一个细节。界面上的“暂停采集”按钮目前只翻转 IsCollecting 和提示文字,并没有通知 DeviceMonitorService 停止定时器。也就是说,屏幕写着“已暂停”,后台仍在采。这个问题不玄乎,却很典型:UI 状态不等于领域状态。命令应调用服务的 StartAsync、PauseAsync 或取消令牌,状态再由服务反向通知界面。
🛠 诊断核心:先取证,再问模型
AgentDiagnosisService 的可取之处,是没有把报警描述原样丢给模型。它先查询关联轴最近六个月的维保记录,再检索最相关的三条知识库内容,最后连同报警代码、严重程度和参数快照一起组成上下文。
var maintenanceLogs =
await _logService.GetMaintenanceLogsAsync(alarm.RelatedAxisId, 6);

var knowledgeEntries =
await _kbService.SearchAsync(alarm.Description, topK: 3);

var context = new
{
    alarm.AlarmCode,
    alarm.Description,
    alarm.Severity,
    alarm.RelatedAxisId,
    alarm.ParameterSnapshot,
    Maintenance = maintenanceLogs.Select(x => new
    {
        x.MaintenanceDate,
        x.Description,
        x.Result
    }),
    Knowledge = knowledgeEntries.Select(x => new { x.Title, x.Content })
};
这其实是一个轻量 RAG:SQLite 保存本地事实,查询层缩小上下文,模型负责归纳。好处是成本低、离线资料可控;不足也明显,当前知识检索采用 Contains,并且把空格切出的多个词用 Where 连续叠加,相当于 AND 查询。中文故障描述通常没有空格,语义相近但字面不同的内容也搜不到。
演进路线可以分三步,别一上来就架向量数据库:
- 先做关键词归一化、同义词表和 SQLite FTS5;
- 数据量变大后,再增加 Embedding 召回与关键词混合排序;
- 最后补来源标识、版本、生效设备范围,让模型回答能追到证据。
诊断结果要求模型返回 JSON,代码再提取 causes、recommendedActions 和 summary。这种结构化契约比解析自然语言靠谱,但当前实现通过查找首尾花括号截取 JSON,遇到多个 JSON 块或字段类型漂移,仍可能失败。更扎实的写法,是采用模型的结构化输出能力,并用 DTO、JsonSerializer 和字段校验统一兜底。
🛡 AI 掉线,设备软件不能跟着躺下
项目最实用的一笔,是本地诊断规则。没有 API Key、初始化异常、网络调用失败、返回内容解析失败,最终都能回到 GenerateLocalDiagnosis。例如 ALM-002 会优先检查散热系统,再考虑负载和伺服参数。
可复用的骨架如下:
publicasync Task<DiagnosisResult> DiagnoseAsync(AlarmRecord alarm)
{
var localResult = _localRules.Evaluate(alarm);

if (!_aiClient.IsAvailable)
return localResult;

try
    {
var aiResult = await _aiClient.DiagnoseAsync(alarm);
return aiResult.IsValid ? aiResult : localResult;
    }
catch (Exception exception)
    {
        _logger.LogWarning(exception, "AI diagnosis degraded to local rules");
return localResult;
    }
}
确定性规则托底,AI 提供增量判断。这个次序很重要。工业软件首先要可用,然后才轮到聪明。
当前代码还有一处容易误读的地方:AgentTools.cs 已经定义了设备数据、维保记录和知识库工具,但它们没有注册进 DI,也没有挂到模型的函数调用流程。聊天界面显示的“读取设备数据”“检索知识库”,目前只是根据用户输入关键词生成的展示项,并非模型真正执行了 Tool Calling。做技术验收时,得把“界面显示调用”与“后端真实调用”分开检查。
🗄 SQLite 与生命周期:原型能跑,生产要收口
SQLite 文件放在应用输出目录,EF Core 创建报警、维保、知识、诊断会话、聊天消息和设备数据等表,并建立时间与设备维度索引。对单机诊断工具而言,这个选型够轻,部署也省心。
但 DI 生命周期需要调整。AddDbContext<AppDbContext>() 默认注册为 Scoped,而多个持有它的服务被注册成 Singleton。在桌面应用根容器中解析后,这个 Scoped 实例可能被单例长期持有。DbContext 既不是线程安全对象,也不适合无限期跟踪实体。
更合适的做法是注册 IDbContextFactory<AppDbContext>,每次操作创建短生命周期上下文:
services.AddDbContextFactory<AppDbContext>();

publicsealedclassMaintenanceLogService
{
privatereadonly IDbContextFactory<AppDbContext> _factory;

publicMaintenanceLogService(IDbContextFactory<AppDbContext> factory)
        => _factory = factory;

publicasync Task<List<MaintenanceLogEntity>> QueryAsync(
        CancellationToken cancellationToken)
    {
awaitusingvar db = await _factory.CreateDbContextAsync(cancellationToken);
returnawait db.MaintenanceLogs
            .AsNoTracking()
            .OrderByDescending(x => x.MaintenanceDate)
            .ToListAsync(cancellationToken);
    }
}
另外,SqliteDeviceDataService 这个名字略有迷惑性:它返回的是随机生成的设备快照和历史曲线,并没有读 SQLite。命名最好诚实一些,例如 SimulatedDeviceDataService。等真实采集适配器就位,再提供 OpcUaDeviceDataService 或 ModbusDeviceDataService。名字对了,团队脑中的地图才不会歪。
📊 性能与取舍:先算容量,再跑测试
本文没有虚构吞吐数字。仅从代码可以确认:采集周期为一秒、三轴每轮三条数据、单轴历史队列上限 3600、界面曲线窗口 60、最近报警内存上限 100。它适合演示和小规模单机监控,但不能据此宣称支持多少台设备。
| 方案 |
当前实现 |
扩展方向 |
主要代价 |
| UI 更新 |
每条事件同步 Dispatcher |
定时批量刷新 |
增加缓冲与合并逻辑 |
| 历史数据 |
内存队列 |
批量写 SQLite/时序库 |
需要保留策略 |
| 知识检索 |
Contains |
FTS5 + 向量混合检索 |
索引和评估成本 |
| AI 诊断 |
单次请求 + 本地兜底 |
超时、重试、熔断、审计 |
状态管理更复杂 |
真正压测时,应固定 .NET 版本、CPU、采样周期、设备数与测点数,至少观察四项:采集回调耗时、Dispatcher 排队长度、进程内存、报警端到端延迟。再逐级把设备数从 1 放大到 10、50、100。先找到拐点,后谈性能优化;否则“快了 40%”这种话,听着热闹,没法复现。
⚠ 上线前还要补的四块
- 异常可观测性:多处空
catch 会吞掉采集和 UI 更新错误,应接入结构化日志与健康状态。
- 事件退订:部分 Singleton ViewModel 会长期订阅服务事件,问题不大;Transient 的聊天 ViewModel 若反复创建却不退订,可能残留引用,应实现
IDisposable。
- 配置安全:API Key 优先放环境变量或系统凭据存储,不要随
appsettings.json 分发。
- 数据迁移:
EnsureCreated 适合原型,正式版本应使用 EF Core Migration 管理模式升级。
顺手说一句,当前工程已通过 dotnet build,结果为 0 个错误、8 个警告。代码基线能编译,不代表上述边界已经消失;恰恰相反,编译通过只是工程质量的起跑线。
💬 讨论与实战练习
可以拿这个项目做两个小练习:
- 给温度报警增加“80℃触发、78℃恢复、30 秒内不重复”的状态机,并为边界值写单元测试;
- 把
DbContext 改成工厂模式,为知识库查询加入 AsNoTracking 和取消令牌。
也留两个问题:在你的设备现场,报警去重是按时间窗口,还是按“发生—恢复”周期?当 AI 建议与维护手册冲突时,系统应该如何展示、审计和裁决?这两个答案,往往比换一个更大的模型更重要。
✅ 结尾:把 AI 放在正确的位置
回头看,这套 C# 开发方案真正值得借鉴的有三点:第一,用事件和线程安全容器隔开采集与界面;第二,让报警、维保和知识库共同构成诊断证据;第三,为外部 AI 准备确定性的本地兜底。与此同时,原型走向生产还要补齐报警状态机、上下文生命周期、可观测性和真实 Tool Calling。学习路线可以按 WPF/MVVM → 并发与 Channel → EF Core 生命周期 → 全文检索/RAG → 模型结构化输出与审计 逐步推进,不必一口吃成胖子。
三句技术洞察
- 实时系统不是“数据来得快”,而是拥塞时仍知道该保什么、丢什么。
- AI 诊断的上限取决于模型,下限取决于本地规则和数据质量。
- 界面上出现“工具调用”四个字,不等于后端真的调用了工具。
这些问题也适合在后续设计设备监控、报警中心或本地 RAG 功能时继续回看。
学习路径: WPF 数据绑定 → CommunityToolkit.Mvvm → System.Threading.Channels → EF Core SQLite → RAG 检索 → LLM 结构化输出
 发表于 5 小时前
|
查看: 4|
回复: 0


