过去十年,应用微观计量的方法论经历了一轮密集迭代。双重差分在异质性处理效应面前逐渐暴露负权重问题,工具变量的弱工具与单调性假设被重新审视,断点回归的带宽选择与推断方法不断细化,聚类标准误该聚在哪一层、要不要聚类也有了新的答案。
对实证研究者而言,方法更新的速度常常快过自己读文献的速度。
经济学者 Christine Cai 整理的一份文献清单恰好可以帮大家补上这一课。这份清单以 Michal Kolesár 在普林斯顿大学、Arindrajit Dube 在麻省大学阿默斯特分校开设的应用计量课程为底本,同时吸收了学界同行的推荐而来。
全书覆盖 OLS、随机实验、双重差分与事件研究、标准工具变量、Shift-Share 工具变量、断点回归、合成控制、匹配、聚束估计、充分统计量、分解方法及综合类共十二个板块,每篇文献均附原文摘要。其中双重差分板块篇幅最大,从 Goodman-Bacon 分解、Callaway 和 Sant'Anna 估计量,到 Borusyak 等的插补估计量、局部投影 DID,再到 2025 年发表于 JEL 的实践指南,基本串起了该领域近年的演进脉络。
无论你正在写论文、回复审稿意见,还是想系统补一补方法课,这份清单都值得收藏备查。
全书结构总览
| 序号 |
章节 |
篇数 |
主题 |
| 1 |
OLS |
16 |
线性回归的推断与系数解释靠不靠得住。 |
| 2 |
RCT |
9 |
随机实验的设计、推断与依从性问题。 |
| 3 |
Diff-in-Diff & Event Studies |
40 |
交错处理、异质效应与平行趋势。 |
| 4 |
Standard IV |
17 |
弱工具推断与 LATE 的可解释性。 |
| 5 |
Shift-Share IV |
4 |
Bartik 类工具变量的识别与推断。 |
| 6 |
RD Designs |
22 |
带宽、偏误修正、密度检验与设计扩展。 |
| 7 |
Synthetic Control |
9 |
权重构造、拟合不佳与推断。 |
| 8 |
Matching |
5 |
匹配估计量的自助法推断。 |
| 9 |
Bunching |
5 |
扭结与缺口处的堆积识别。 |
| 10 |
Sufficient Statistics |
2 |
充分统计量方法的适用边界。 |
| 11 |
Decomposition |
12 |
分位数处理效应与工资差距分解。 |
| 12 |
General |
9 |
综述、教材与跨方法的工具。 |
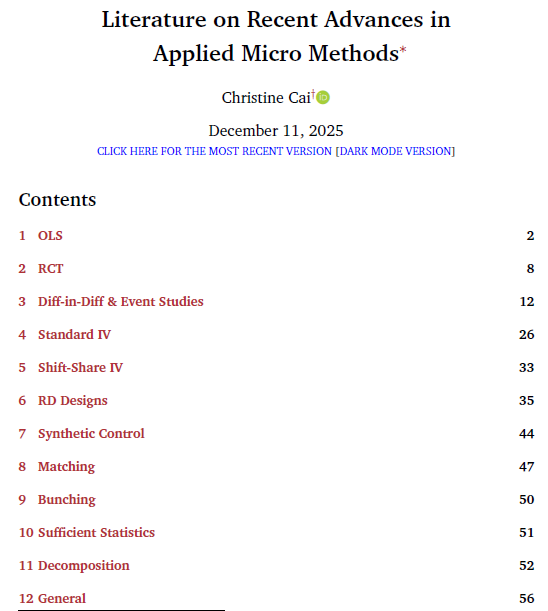
DID 与事件研究一节收录 40 篇,RD 一节收录 22 篇,两者合计已占整份清单的四成以上;标准 IV 与 Shift-Share IV 两节合计另有 21 篇。三类方法加起来超过半数,可见因果识别仍是近十年方法论研究最集中的领域。相比之下,匹配、聚束估计和充分统计量三节合计仅 12 篇,收录数量明显偏少,折射出这些方向近十年的方法论进展相对平缓。
逐节内容与最新进展
1. OLS(16 篇)
这一节处理的是最基础、也最容易被忽略的一类问题:普通最小二乘的标准误是否可靠,以及回归系数究竟该如何解释。
聚类推断占据了超过一半的篇幅。Abadie、Athey、Imbens 和 Wooldridge 发表于 QJE 的文章讨论什么时候需要进行聚类,MacKinnon、Nielsen 和 Webb 发表于 JE 的文章则更偏向实务操作。面对小样本和聚类数量较少的情形,Canay、Santos 和 Shaikh 讨论了 wild bootstrap 方法,Ibragimov 和 Müller 提出了适用于少量异质聚类的 t 统计量方案。空间相关方面,Müller 和 Watson 在 ECMA 发表了稳健推断方法,Colella 等进一步讨论了任意聚类结构下的推断问题。
另一条主线关注回归系数的含义。Słoczyński 指出,当处理效应存在异质性时,OLS 对不同群体赋予的权重并不相同,小组反而可能获得更大的权重。Gibbons、Serrato 和 Urbancic 重新分析了八篇有影响力的论文,发现固定效应在实际回归中发挥的作用,有时与原作者的理解并不一致。
最新进展
Goldsmith-Pinkham、Hull 和 Kolesár 在 2024 年的 AER 提出了 contamination bias,即当多个处理变量同时进入回归时,一个处理变量的系数可能混入其他处理的效应。他们重新分析了九项应用研究,发现这种污染在观测性研究中无论从经济意义还是统计意义看都不可忽视;实验研究由于倾向得分的变异较小,污染程度相对有限。
同年,Arkhangelsky、Imbens、Lei 和 Luo 在 QE 提出双重稳健的双向固定效应方法,通过处理分配模型构造单位权重,为传统 TWFE 提供了一种新的修正思路。MacKinnon 在 2023 年的研究则把注意力转向另一端:随着数据集越来越大,很多在常规样本下习惯使用的推断方法,在大样本环境中未必仍然可靠,不能简单沿用过去的标准做法。
2. RCT(9 篇)
随机实验本身无法保证推断正确,本节收录的正是围绕实验推断展开的各类修正方法。其中影响最大的当属 Young 发表于 QJE 的文章。他沿用 Fisher 的随机化推断思路,重新分析了 53 篇 AEA 期刊上的实验论文,发现单个处理效应的显著结果比原作者方法少 13% 至 22%,多个处理效应的联合检验则少 33% 至 49%,表明常规推断可能明显高估了结果的显著性。
其余文献涉及面板数据下的实验设计与功效计算、加入协变量的随机化检验、存在溢出效应时的识别,以及半参数处理效应估计等问题。针对不完全依从和不可忽略的样本缺失,Gabriel、Sjölander 和 Sachs 在 JASA 上提出了非参数界,并指出常用的最坏情况插补在完全依从的盲法研究中可能过于悲观,在不完全依从时甚至无法界定正确的估计目标。
最新进展
Muralidharan、Romero 和 Wüthrich 在 2025 年的 REStat 论文中聚焦因子设计实验。他们梳理了 2007 至 2017 年顶五期刊发表的 27 项因子实验,发现其中 19 项采用了不含交互项的短模型。重新纳入交互项后,超过一半原本显著的结果失去显著性,可见忽略处理之间的交互作用可能明显改变实验结论。作者同时指出,借助近期的计量方法进展,研究者仍有可能在保证推断有效的前提下获得高于长模型的功效,并为新实验的设计和已完成实验的分析提供了操作建议。
同年,Kessler、McQueen 和 Rokkanen 讨论了 A/B 测试中的样本分割问题。当各项测试的真实效果无法观测时,研究者常将每项测试的数据一分为二,借此评估不同估计量和决策规则的表现。作者建立的理论框架表明,由此得到的样本分割估计量对全样本表现通常有偏,但能够一致地估计其样本分割版本。他们还推导了相应的渐近分布与置信区间,并刻画了分割设计中的偏误与方差权衡。
3. Diff-in-Diff 与事件研究(40 篇)
本节是整份清单篇幅最大的部分,几乎可以视作近年 DID 方法革命的完整索引。其中文献大致可沿五条线索来理解。
第一条线索是传统 TWFE 究竟出了什么问题。de Chaisemartin 和 d'Haultfœuille 在 AER 上揭示了负权重问题,Goodman-Bacon 给出了经典分解,Baker、Larcker 和 Wang 在 JFE 上借助模拟展示了偏误如何产生。在交错处理设定下,传统双向固定效应会把已接受处理的组当作对照组,一旦处理效应存在异质性,估计结果便可能出现严重偏误。
第二条线索是用什么替代传统 TWFE。Callaway 和 Sant'Anna 提出适用于多期交错处理的 DID 估计量,Sun 和 Abraham 改进了事件研究的估计,Borusyak、Jaravel 和 Spiess 发展出插补估计量,Gardner 等提出两阶段 DID,Wooldridge 借助双向 Mundlak 回归构建扩展 TWFE,Arkhangelsky 等融合合成控制思路提出合成 DID。各类方法都在回应传统 TWFE 的缺陷,但识别思路、估计目标和适用场景各有不同。
第三条是平行趋势到底有多可信。Roth 指出,先做平行趋势预检验、再根据检验结果决定是否报告事件研究估计,会引入新的选择问题。Roth 和 Sant'Anna 进一步讨论平行趋势假设对函数形式有多敏感,Rambachan 和 Roth 则把问题推进一步,允许平行趋势存在一定偏离,再据此构造敏感性区间。
第四条是 DID 设计如何向更复杂场景扩展。这里包括连续处理、多重处理、处理强度异质、空间溢出,以及边际处理效应等问题。DID 研究已经从最初的二元处理和简单分组,扩展到越来越接近现实数据结构的复杂环境。
第五条是综述与使用手册。Roth、Sant'Anna、Bilinski 和 Poe 发表于 JE 的综述覆盖最全面,de Chaisemartin 和 d'Haultfœuille 在 EJ 也有一篇系统性总结,Sun 和 Shapiro 在 JEP 上的文章则更适合作为入门读物。若把这几篇和前面的核心方法论文结合起来,基本就能搭起近十年 DID 方法发展的完整框架。
最新进展
2025 至 2026 年间,DID 文献集中出现了一批带有总结和收束意味的新成果。Baker、Callaway、Cunningham、Goodman-Bacon 和 Sant'Anna 在 JEL 发表的实操指南,对近年的主要争议和估计方法作了系统梳理,是目前很适合作为入口的一篇文章。
方法上的扩展也在继续。Dube、Girardi、Jordà 和 Taylor 在 JAE 提出局部投影版 DID,希望用一个更统一、简洁的框架处理传统 TWFE 中的负权重问题,同时还能扩展到协变量和非吸收性处理。Ghanem、Sant'Anna 和 Wüthrich 则把问题进一步推回平行趋势的来源,推导不同选择机制下平行趋势成立的充要条件,并据此对 DID 偏误进行基于选择机制的分解。Faletto 利用机器学习对 Wooldridge 扩展双向固定效应中的大量参数进行融合,以缓解参数过多带来的效率损失。
另一项重要扩展来自数据结构。Sant'Anna 和 Xu 在 2026 年的 JE 专门研究重复截面中样本构成随时间变化的问题,并推导 ATT 的半参数效率界。DID 方法的发展已从早期修正 TWFE 偏误,逐步转向更复杂的数据环境、选择机制和效率问题。
4. 标准 IV(17 篇)
这一部分大致可以分成两条主线。
第一条主线是弱工具变量与统计推断。Andrews、Stock 和 Sun 发表于 ARE 的综述可作为入门读物,系统梳理了弱工具变量下的识别与推断问题,尤其关注异方差、序列相关和聚类数据的情形。Lee、McCrary、Moreira 和 Porter 提出依据第一阶段 F 统计量调整标准误的 tF 方法,使单一工具变量下的 t 比推断重新变得可靠;Mikusheva 和 Sun 将分析拓展至工具变量数量众多且普遍偏弱的情形;Keane 和 Neal 从理论与实践两方面讨论工具变量需要多强才算够用,认为常用的 F 大于 10 门槛偏低。Young 发表于 EER 的文章则直接检视了 AEA 旗下期刊 30 篇论文中的 1309 个 IV 回归,发现其中相当一部分研究的推断可靠性有待重新审视。与上述偏悲观的判断形成对照,Angrist 和 Kolesár 认为多数微观应用中恰好识别 IV 的常规推断基本可靠,只需按第一阶段系数的符号进行筛选,即可使中位数偏误大致减半。
第二条主线围绕 LATE 的解释展开。Mogstad、Torgovitsky 和 Walters 讨论多个工具变量同时进入 2SLS 后,估计量对应怎样的因果效应;Mogstad 和 Torgovitsky 研究如何将工具变量识别的局部效应外推至政策关心的更广泛人群。Huntington-Klein 关注第一阶段效应存在异质性时产生的偏误与局部性问题,Andresen 和 Huber 则聚焦排他性约束,指出将多值处理变量二值化可能破坏该约束,并提出相应的检验方法。
最新进展
本节近两年收录的四篇文章,大体沿两个方向推进。
第一条线索是重新界定单工具 IV 的适用边界。Angrist 和 Kolesár 在 JE 上为恰好识别的单工具 IV 作了辩护,认为在多数微观应用中常规推断总体可靠,反倒是依据第一阶段 F 统计量进行预检验会加剧偏误并扭曲推断。Słoczyński 在 2024 年的工作论文中考察了另一种情形:当识别需要依赖协变量,而简约式和第一阶段回归又因隐含的同质性限制存在误设时,只要单调性仅以较弱的形式成立——即部分协变量取值处只有依从者、另一些取值处只有违抗者——部分条件 LATE 就会获得负权重,线性 IV 估计值随之失去因果解释。采用 Angrist 和 Imbens 提出的交互设定可以消除该问题,但此类设定在应用研究中仍较少使用。
第二条线索是让 LATE 具备更清晰的政策含义。Hoff、Lewbel 和 Mellace 在 REStat 上提出有限单调性假设,并在此基础上识别出合并依从者 LATE,其政策解释力强于 2SLS 给出的 LATE 加权平均,估计时只需在特定子样本上以一个构造的工具变量运行 2SLS。Mogstad、Torgovitsky 和 Walters 则在部分单调性条件下重建了边际处理效应框架,借助部分识别方法估计明确界定的政策相关参数,并展示了如何综合多个工具变量,得出比单独使用任一工具更具信息量的结论。
5. Shift-Share IV(4 篇)
本节仅收录 4 篇,篇幅不大,却几乎都是 Bartik 工具变量文献中绕不开的代表作。Adão、Kolesár 和 Morales 发表于 QJE 的文章聚焦 shift-share 设计下的统计推断,指出常用标准误会导致严重的过度拒绝,根源在于部门份额结构相近的地区之间残差存在相关性。Goldsmith-Pinkham、Sorkin 和 Swift 在 AER 上进一步拆解 Bartik 工具变量,说明此类设计可以等价理解为以暴露份额作为工具变量,识别依赖于份额的外生性。
Borusyak、Hull 和 Jaravel 发表于 REStud 的文章则从另一条路径重建识别逻辑,将重点放在冲击本身的准随机性上,并允许暴露份额内生。Goldsmith-Pinkham 等侧重份额端的外生性,Borusyak 等侧重冲击端的识别,两条思路共同构成了近年理解 Bartik 工具变量的核心框架。
最新进展
Borusyak 和 Hull 在 2023 年的 ECMA 论文中将上述思路推广至更一般的情形。当处理变量或工具变量由多个变异来源按已知公式合成,且其中仅有部分决定因素受到外生冲击时,研究者可以设定一组同样可能实现的反事实冲击,计算处理变量在各反事实冲击下的期望值,并以此作为暴露非随机性的汇总指标加以调整,从而避免遗漏变量偏误。
作者将该框架用于估计中国高铁建设带来的市场可达性提升对就业的影响,以纠正非随机暴露造成的偏误。该方法适用范围相当广泛,既可处理社会网络和交通网络中的溢出效应,也能覆盖基于政策资格规则构造的模拟工具变量。
6. RD 设计(22 篇)
这是全书第二大板块,内容大致可以分成三层。
最底层是估计与推断的基础工具。带宽选择方面,Arai 和 Ichimura 提出在断点两侧分别选取带宽,Calonico、Cattaneo 和 Farrell 则从置信区间的覆盖误差出发推导面向推断的最优带宽,并指出常用的 MSE 最优带宽用于构造稳健偏误修正区间时偏大。区间估计方面,稳健偏误修正置信区间与 Armstrong 和 Kolesár 提出的诚实置信区间代表了两条不同思路。Cattaneo、Jansson 和 Ma 则提供了局部多项式密度估计方法,并据此构造出新的密度断点检验,为检验驱动变量是否受到操纵提供了工具。
中间一层关注 RD 设计本身是否有效,包括密度连续性检验、离散驱动变量下的统计推断、检验协变量分布连续性的近似置换检验,以及 Gelman 和 Imbens 论证为何应避免高阶多项式的经典文章。最上层则是设计的扩展,包括模糊 RD 的外部有效性、多断点外推、处理效应异质性与分布效应检验,以及回归拐点设计中的置换检验。Cattaneo、Idrobo 和 Titiunik 的两卷本实操手册贯穿上述各层,与 Cattaneo 和 Titiunik 发表于 ARE 的综述一道,基本串起了现代 RD 从基础估计、有效性检验到复杂扩展的完整框架。
最新进展
近两年的研究开始向更复杂的 RD 场景推进。Noack 和 Rothe 研究了 donut RD,即主动剔除断点附近观测值的稳健性做法。他们发现,donut RD 估计量的偏误和方差可能明显大于常规 RD 估计量,置信区间也相应更长,并为比较两类估计结果提供了正式的检验框架。Lehner 将注意力转向空间 RD,指出文献中常用的估计量在一般情况下无法识别边界上的局部平均处理效应,并引入随机化推断,通过随机平移边界构造检验,相关工具已集成于 R 包 SpatialRDD。
Xie 在 JE 上讨论了连续处理变量下的模糊 RD,在单调性和光滑性等形状约束下,对断点处非线性、不可分的结构函数进行非参数识别,并利用时区边界造成的自然光照时间断点,估计了睡眠时长对健康的因果效应。近期 RD 文献已从标准的一维断点设计,扩展到剔除局部样本、空间边界和连续处理等更复杂的设定。
7. 合成控制(9 篇)
这一部分主要围绕两个问题展开:权重如何构造,以及预处理期究竟要拟合到什么程度。
Abadie 发表于 JEL 的使用指南可作为入门读物,系统介绍了合成控制法的适用条件、数据要求与方法细节。Botosaru 和 Ferman 进一步讨论了协变量的作用,提醒研究者处理前结果拟合良好,未必意味着协变量同样实现了平衡。Ferman 和 Pinto 分析了处理前拟合不完美时合成控制估计量的性质,发现若处理分配与未观测的混杂因素相关,即便处理前期数很长,估计仍然有偏,而去均值版本的合成控制在偏误和方差上可优于 DID。Ferman、Pinto 和 Possebom 则指出,由于匹配变量的选择缺乏明确规范,合成控制法在实际应用中仍给研究者留下了挑选有利设定的空间。
方法层面的拓展同样迅速。Ben-Michael、Feller 和 Rothstein 提出增广合成控制,借助结果模型修正处理前拟合不完美带来的偏误;Athey 等将反事实估计转化为矩阵补全问题;Arkhangelsky 等融合 DID 与合成控制的思路,提出合成 DID;Ben-Michael 等随后又将合成控制推广至交错采纳情形。
最新进展
Gunsilius 在 2023 年的 ECMA 论文中提出分布式合成控制,将合成控制法拓展到数据颗粒度更细的场景。许多应用关心的是地区、机构或群体层面的总体政策效应,研究者手中却往往掌握更细的个体或子单元数据。分布式合成控制充分利用此类信息,以对照单位分位数函数的加权平均复制处理单位的分位数函数,从而以非参数方式刻画聚合单位内部的效应异质性。该方法既适用于面板数据,也适用于重复截面数据,即便只有一期处理前数据亦可使用。
Ben-Michael、Feller 和 Rothstein 则将合成控制推广至交错采纳情形。他们证明,平均效应的估计误差同时取决于每个处理单位各自的不平衡程度和处理单位整体的平均不平衡程度,只顾其一都可能导致偏误。为此,作者提出部分合并(partially pooled)的合成控制权重,对两类不平衡加权后一并最小化。相应方法已集成于 R 包 augsynth,便于实际应用。
8. 匹配(5 篇)
这一节几乎全部围绕匹配估计后的统计推断展开,较少讨论匹配本身。Otsu 和 Rai 在 JASA 研究平均处理效应匹配估计量的 bootstrap 推断,Adusumilli 进一步处理倾向得分需要事先估计时的自助法,Ferman 关注处理单位很少、控制单位很多的情形,Imai、Kim 和 Wang 则把匹配方法推广到时间序列截面数据。
最新进展
近两年本节仅收录了 Zheng(2024)一篇工作论文。他将 bootstrap 重抽样、匹配方法与高维假设检验相结合,用于处理随机化在实际执行中未能充分实现的 A/B 测试。本节近年新增文献很少,在一定程度上反映出匹配方法已相对成熟,方法研究的重心正逐步转向其他领域。
9. Bunching(5 篇)
Kleven 发表于 ARE 的综述可作为该方向的入门读物。文章清晰阐述了 bunching 方法的基本逻辑:选择集在斜率上的不连续(扭结,kink)或水平上的不连续(缺口,notch)会诱发行为堆积,研究者可据此识别经济主体的反应参数。该方法最初主要用于税收研究,此后逐步扩展到社会保障、社会保险、福利项目、教育、监管以及参照点依赖偏好等领域。
其余几篇主要围绕识别条件与方法修正展开。Blomquist、Newey、Kumar 和 Liang 发表于 JPE 的文章提出了一个强有力的质疑:若不对偏好分布施加限制,无论是扭结还是缺口处的堆积,甚至整个应税收入分布,都无法揭示应税收入弹性的大小。bunching 中看似直观的局部堆积,还需要借助更强的分布假设,才能转化为具有明确经济含义的行为参数。
最新进展
2024 年的两篇文章从不同方向给出了应对之策。Marx 在 JEM 上指出,标准截面 bunching 估计所依赖的异质性假设,可能因选择变量存在序列相关或出现与阈值相关的样本流失而失效。为此,他转向面板数据,利用同一个体内部的相对变化实现识别,并由此估计出若干新的参数,包括弹性的相关因素、因果效应以及扩展边际反应。
Caetano、Caetano 和 Nelson 在 JBES 上则从内生性入手,针对处理变量在其支撑集一端出现堆积的情形提出了一种控制函数方法。两篇文章分别沿面板识别和内生性修正两条路径,拓展了 bunching 方法在更复杂数据环境中的适用范围。
10. 充分统计量(2 篇)
这是全书最短的一节,只有两篇,但都带有很强的方法论立场。
Kleven 发表于 ARE 的文章系统回顾并推广了充分统计量方法。其思路在于把政策变化带来的福利效应表示为可直接估计的简约式弹性,从而尽量绕开对完整结构模型的估计。Kleven 逐一放松了该方法赖以成立的三个条件:政策变化足够小、政府政策是市场不完善的唯一来源,以及对环境和偏好施加的若干高层次限制。在更一般的条件下,研究者仍能写出透明的充分统计量公式,但估计要求随之大幅提高;沿此思路推演下去,可行的实证实现实际上已经属于结构方法。
另一篇来自 Lee、Leung、O'Leary、Pei 和 Quach。他们采用分解思路,将政策对政府预算的总影响拆分为行为效应与机械效应,以非参数方式测量失业保险造成的无谓损失,并借此追问政策评估是否必须依赖充分统计量。结果显示,提高每周失业救济金比降低项目的隐性收入税更有效率,每转移一美元机械性收入对应 53 美分的财政外部性。两篇文献放在一起,实际上指向同一个问题:充分统计量究竟是一条独立于结构方法的道路,还是在更一般的环境下终将回到结构估计。
11. 分解(12 篇)
这一节主要围绕两类问题展开,一类是群体差距如何分解,另一类是处理效应如何沿着结果分布的不同位置展开。
差距分解方面的文献相对集中。Firpo、Fortin 和 Lemieux 系统阐述了基于再中心化影响函数(RIF)回归的分解方法,将 Oaxaca-Blinder 分解推广到各类分布统计量,RIF 回归也已成为工资分布与无条件分位数分析中的标准工具。Słoczyński 讨论了用 Oaxaca-Blinder 分解分析劳动力市场种族差距时可能落入的解释陷阱,指出回归估计结果的含义取决于各组的相对规模。Guo 和 Basse 则将 Oaxaca-Blinder 估计量推广至随机实验中的协变量调整,使研究者可以借助非线性模型获得更窄的置信区间。
分位数方面的文献覆盖面更广。Wüthrich 给出了存在内生性时分位数处理效应的闭式估计量,Callaway、Li 和 Oka 将分位数处理效应引入仅有两期数据的 DID 框架,Hausman 等发表于 ECMA 的论文则处理了被解释变量存在测量误差时的分位数回归问题。其余研究还涉及网络与面板数据中的分位数效应、无条件分位数处理效应的残差化估计框架,以及分位数回归估计量的偏误修正。
最新进展
Chetverikov、Liu 和 Tsyvinski 在 2022 年提出加权平均分位数回归,构造出具有根号 T 一致性和渐近正态性的估计量,并将其应用于行业组合的期望损失因子结构分析。
此后近三年,此节没有再出现新的代表性条目。与匹配方法类似,分位数处理效应与分解这一方向的方法体系已经相对成熟,近年的方法创新活跃度明显低于 DID、RD 等领域。
12. 综合(9 篇)
本节收录的文献难以归入前面 11 类,却同样不容忽视。Abadie 和 Cattaneo 发表于 ARE 的项目评估方法综述覆盖面最广,可作为整个因果推断工具箱的总览。Cunningham 的《Causal Inference: The Mixtape》更偏教材性质,并提供在线 HTML 版本,既适合系统入门,也便于随时查阅。
其余文献各自回应更一般或更具体的问题。Słoczyński 和 Wooldridge 给出了双重稳健估计的一般性结果,Chernozhukov、Wüthrich 和 Zhu 为反事实与合成控制方法构造了精确且稳健的共形推断程序,Han 则讨论了动态处理效应的非参数识别。上述文献共同构成了前面各专题之外的一组重要补充。
最新进展
两篇文献都偏工具性,几乎可以直接用于实证研究。Broderick、Giordano 和 Meager 提出了一套自动化的有限样本稳健性指标,称为近似最大影响扰动(AMIP)。其核心问题是:若删掉极少量观测值后原有结论是否会发生翻转。借助该指标,研究结果对少量数据扰动的敏感程度便转化为一项可以系统报告的稳健性诊断,且适用于 OLS、IV、MLE、GMM 等常用方法。
Ferman(2025)的《Assessing inference methods》系统比较了研究者借助模拟评估推断方法的各类方案,进而判断所用推断方法能否有效控制假阳性率。文章指出,不同方案在识别问题的能力、有限样本表现、序贯检验引发的扭曲、选择性报告的风险以及实现难度等方面各有取舍。需要强调的是,shift-share 设计中一种常用的模拟评估可能得出误导性结论,Ferman 为此提出了替代方案。
 发表于 2 小时前
|
查看: 3|
回复: 0


