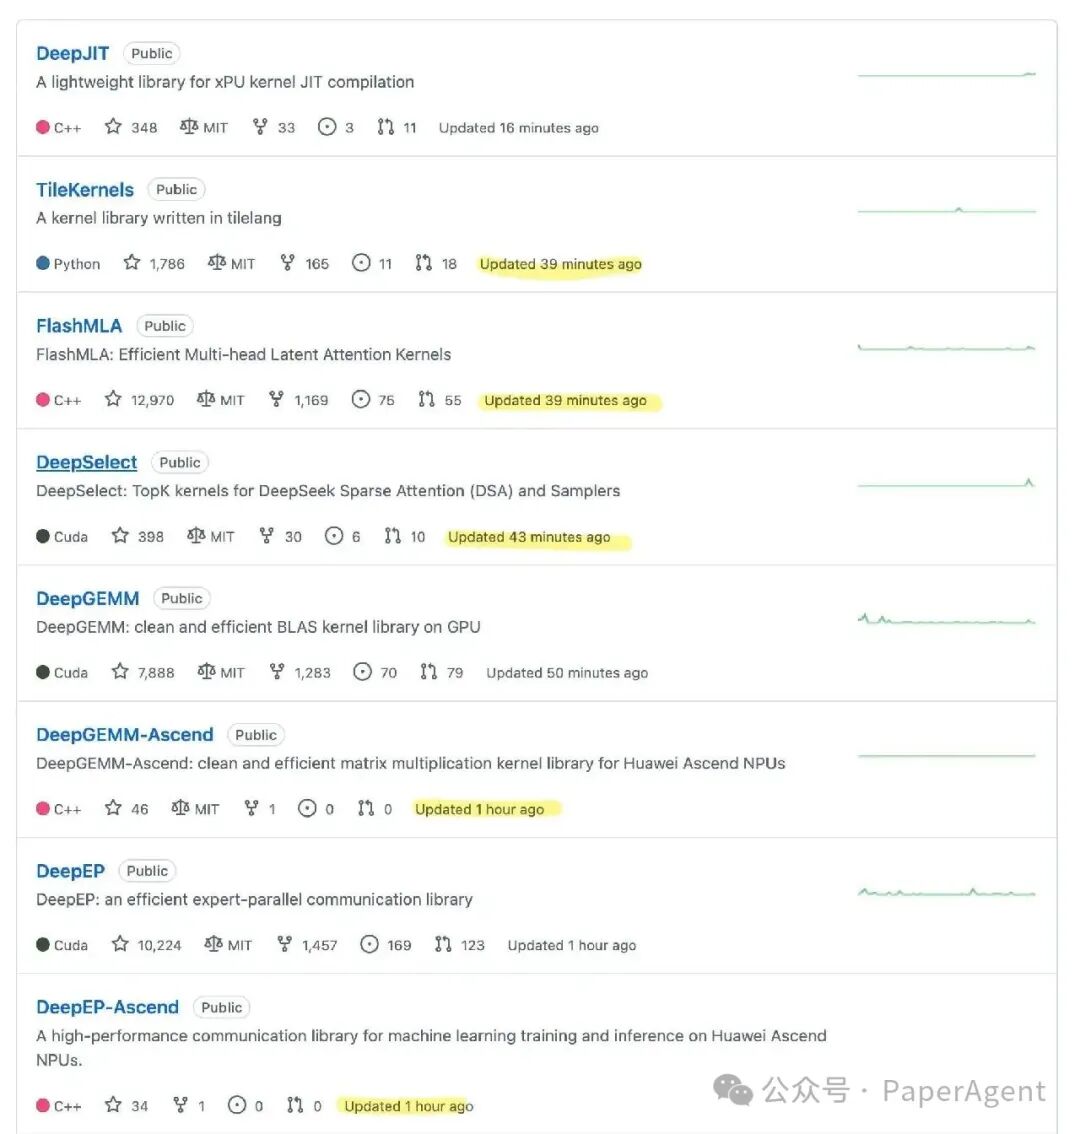
DeepSeek 又在节假日前搞突袭了,这次直接扔下一颗重磅炸弹:正式开源面向华为昇腾算力平台的基础设施组件。这也是 DeepSeek 在大模型底层软件栈上一次重要的生态扩张——从高级语言编译工具到计算库、再到分布式通信库,一口气端出六个项目,与此前面向英伟达平台的开源组件一一对应。
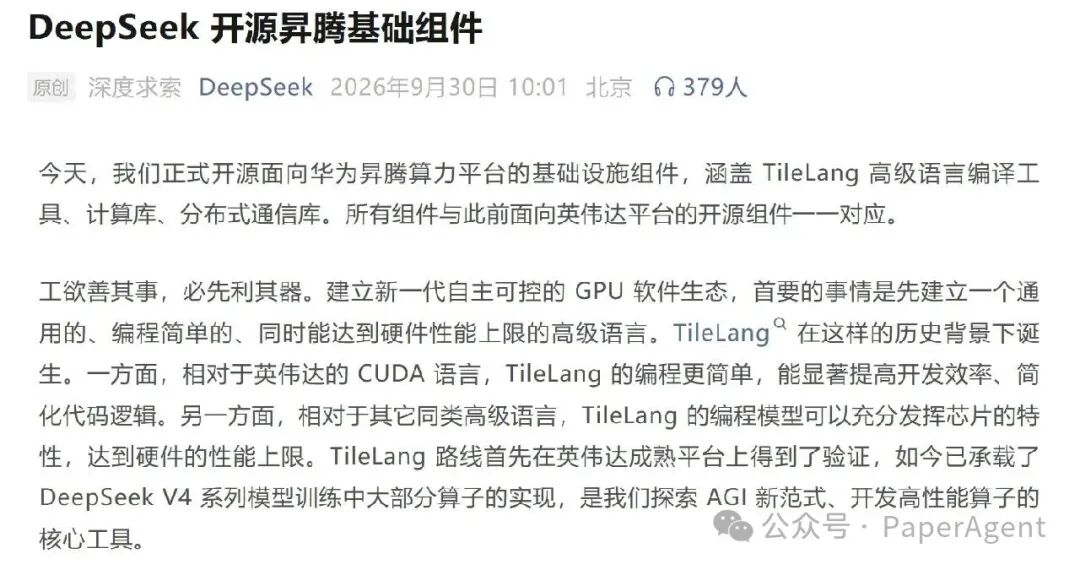
背后意图官方说得直白:要建立新一代自主可控的 GPU 软件生态,首要的事是先建立一门通用的、编程简单的、同时能逼近硬件性能上限的高级语言。DeepSeek 不只是想把模型跑在昇腾上,更想把自己在英伟达平台上验证过的整套算子方法论完整地移植到国产芯片上,给更多 AI 芯片打个样。
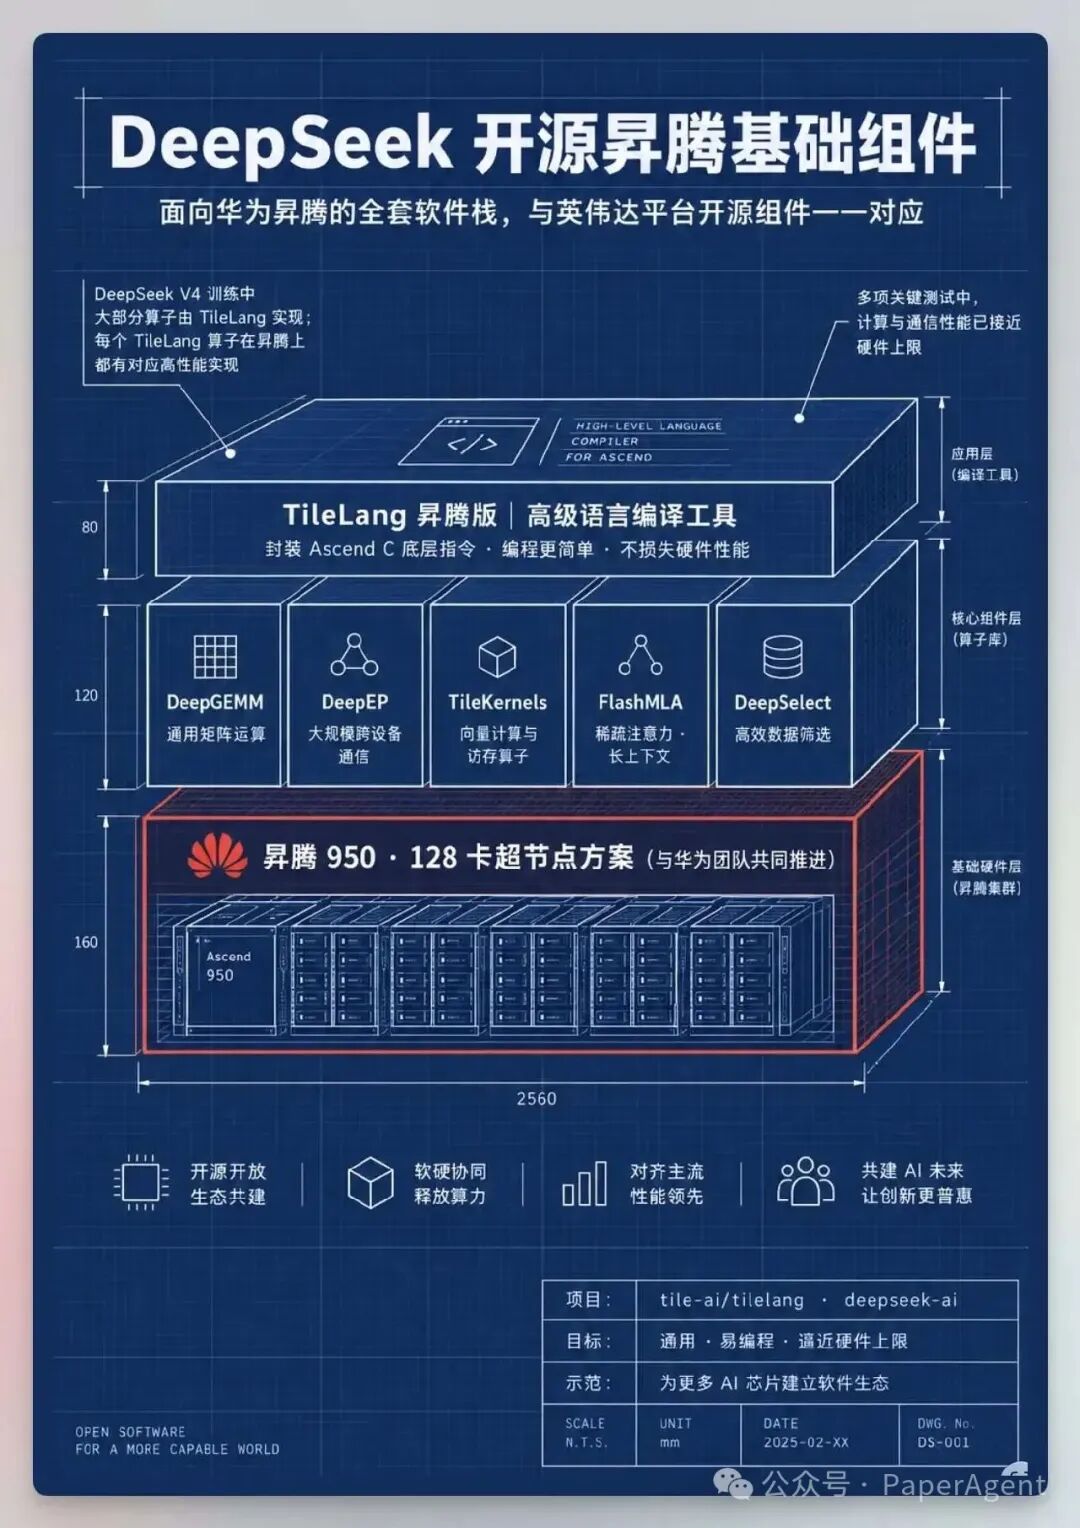
来源:https://x.com/vista8/status/2105134736670949671
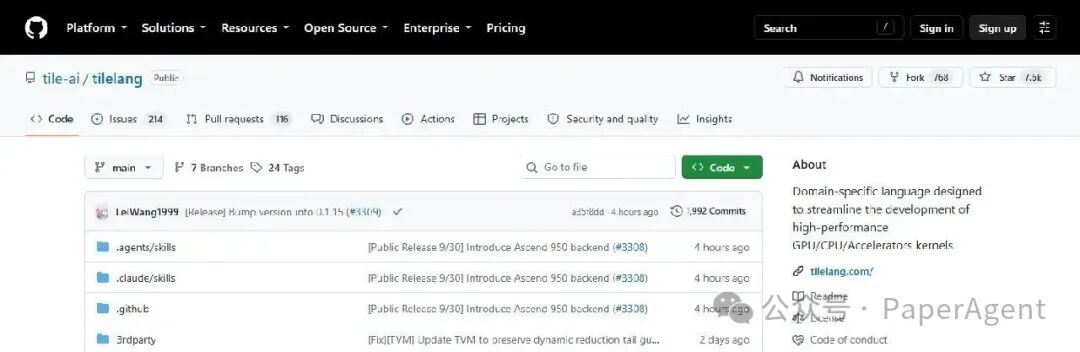
TileLang:一切的起点,国产芯片的「通用语言」
如果说这次开源是一盘大棋,TileLang 就是棋眼。它是一个精简的领域专用语言(DSL),用 Pythonic 的语法写高性能算子,底层编译器构建在 TVM 之上。
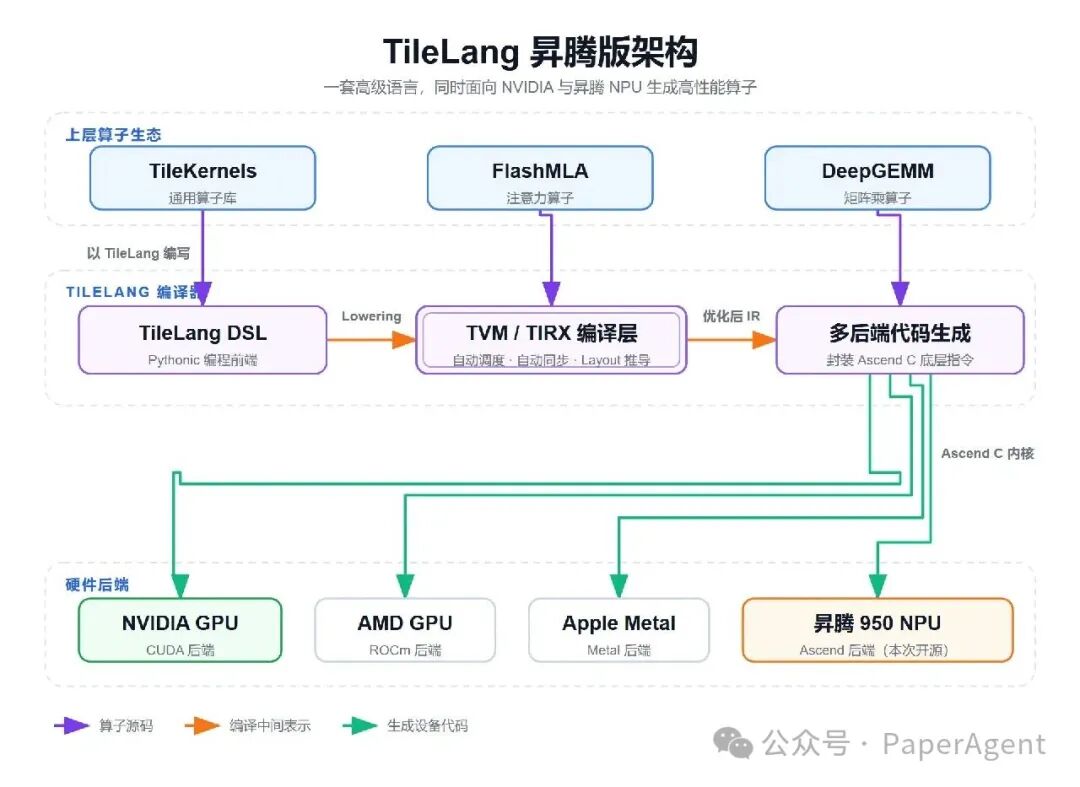
这次开源的昇腾版本,做的事情是把昇腾 Ascend C 底层指令封装起来,让开发者用高级语言的方式编程,同时不损失硬件性能。如今 TileLang 的后端列表已经拉得很长:NVIDIA CUDA(SM70 到 SM120)、AMD ROCm、Apple Metal,现在再加上昇腾 950。DeepSeek 的野心是,让 TileLang 成为更多 AI 芯片建立高可用软件生态的示范。
DeepGEMM-Ascend:矩阵乘干到硬件上限的 99.8%
大模型训练和推理说到底,大部分时间都在做矩阵乘法。DeepGEMM 是 DeepSeek 在英伟达平台上成名已久的 GEMM 库,这次的 DeepGEMM-Ascend 是它的昇腾移植版,而且做到了 API 完全兼容——同一个包名、同一套接口、同一个开发流程,用户装好之后几乎无感切换。
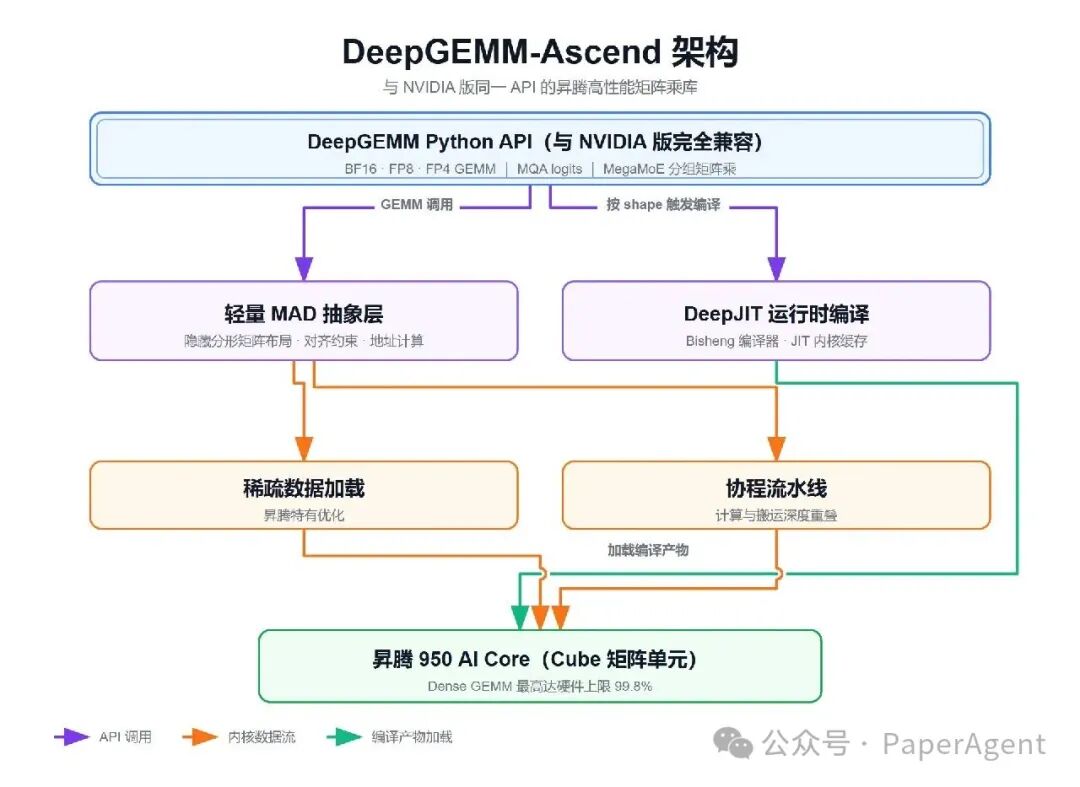
功能上它支持 BF16、FP8、FP4 的 GEMM,以及 MQA logits 和 MegaMoE 算子。实现上对昇腾的矩阵乘加原语(MAD)做了一层轻量抽象,把分形矩阵布局、对齐约束、地址计算这些琐碎细节全部隐藏起来,再叠加昇腾特有的稀疏数据加载和基于协程的流水线优化。
在昇腾 950DT 上,Dense GEMM 最高达到硬件上限的 99.8%(BF16),FP8 也有 99.5%,FP4 为 98.3%。
DeepEP-Ascend:128 卡超节点的通信大动脉
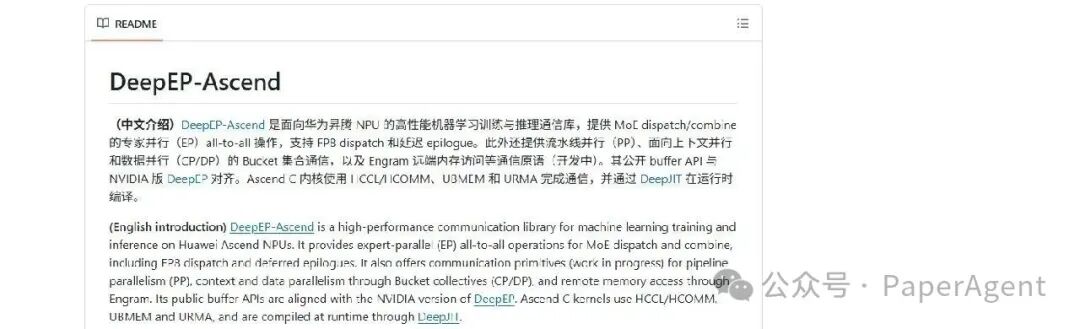
MoE 模型的命门在通信。DeepEP 是 DeepSeek 开源的专家并行通信库,负责 MoE 训练推理中 dispatch 和 combine 的 all-to-all 操作。昇腾版同样与英伟达版的公开 Buffer API 对齐,除了核心的 EPBuffer(支持 FP8 dispatch 和延迟 epilogue),还规划了流水线并行的 PPBuffer、面向上下文并行和数据并行的 BucketBuffer,以及 Engram 远端内存访问。
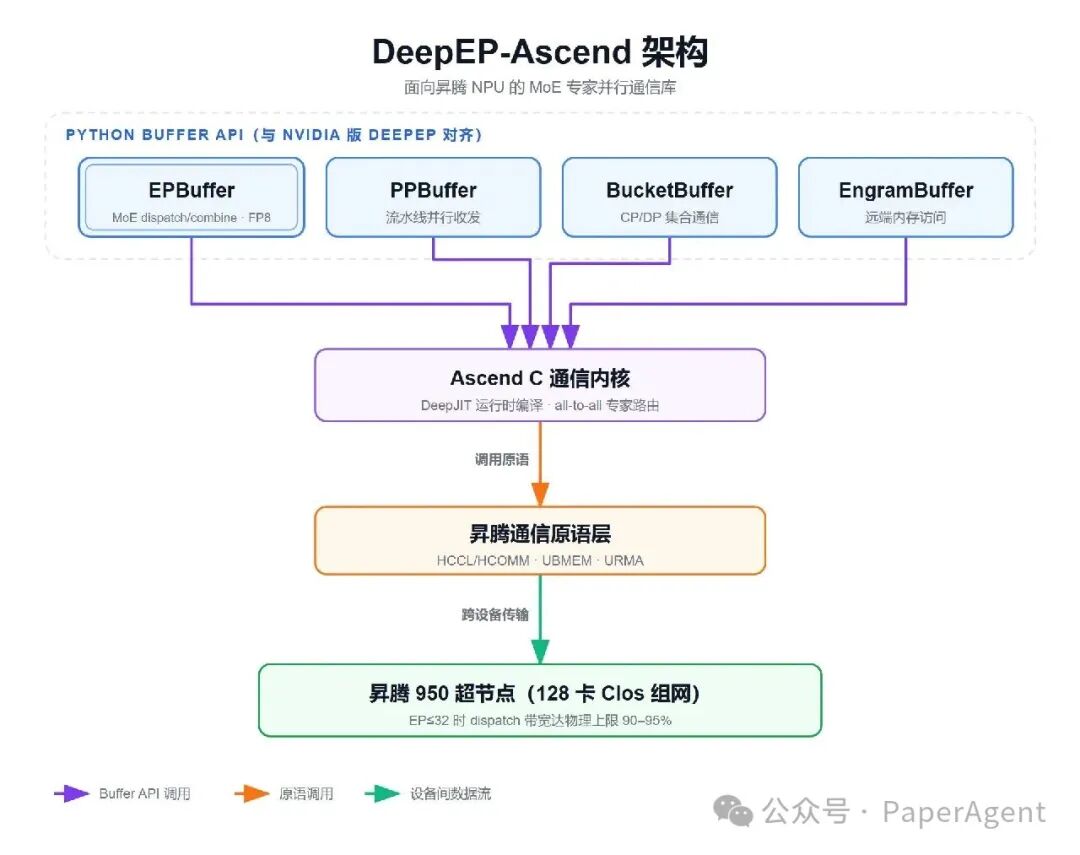
技术栈上,它的 Ascend C 内核跑在 HCCL/HCOMM、UBMEM 和 URMA 这套昇腾通信原语之上,并且通过 DeepJIT 在运行时编译。性能方面,在昇腾 950DT 超节点的外部 Clos 网络上,EP 规模不超过 32 时,dispatch 持续带宽能达到物理载荷带宽上限的 90% 到 95%。
TileKernels:DeepSeek 内部武器库公开
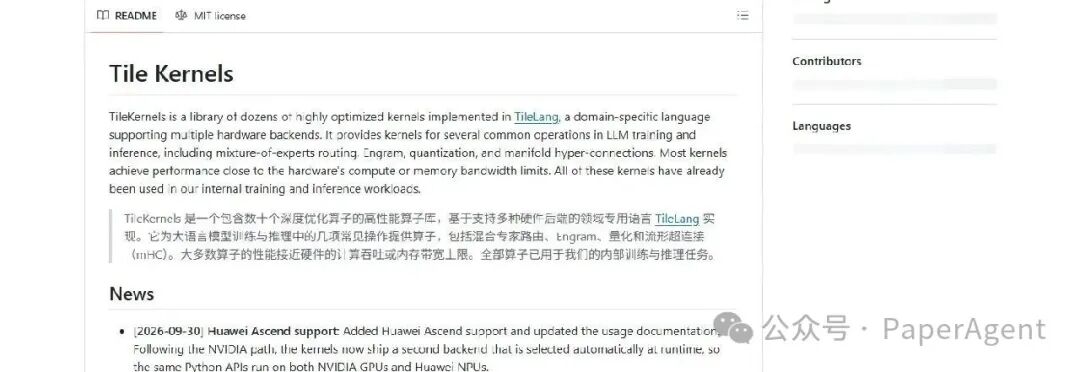
TileKernels 是一个包含数十个深度优化算子的高性能算子库,全部用 TileLang 实现,覆盖大模型训练与推理中最常见的几类操作。
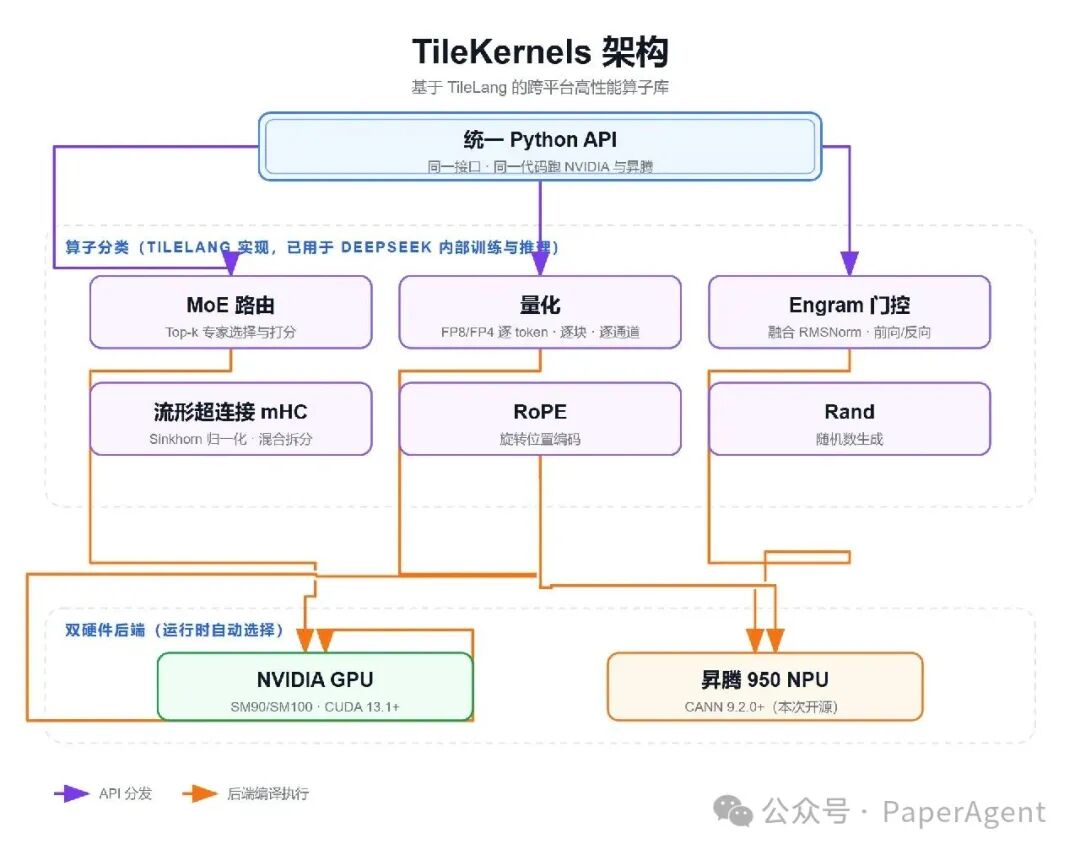
具体包含:MoE 路由的 Top-k 专家选择与打分、逐 token/逐块/逐通道的 FP8/FP4 量化(还融合了 SwiGLU)、Engram 门控(融合 RMSNorm,含前向反向)、流形超连接 mHC(Sinkhorn 归一化那一套)、RoPE 旋转位置编码和随机数生成。
FlashMLA:长文本推理的稀疏注意力利器
FlashMLA 是 DeepSeek 的高性能注意力算子库,如今支撑着 DeepSeek-V4.1 模型在英伟达 GPU 和昇腾 NPU 上的推理。核心是 token 级的稀疏注意力(DeepSeek Sparse Attention,DSA):由 Lightning Indexer 先为每个 query 选出最值得关注的 topk 个 token,注意力计算只在选中的 token 上进行,长上下文的计算量因此大幅下降。
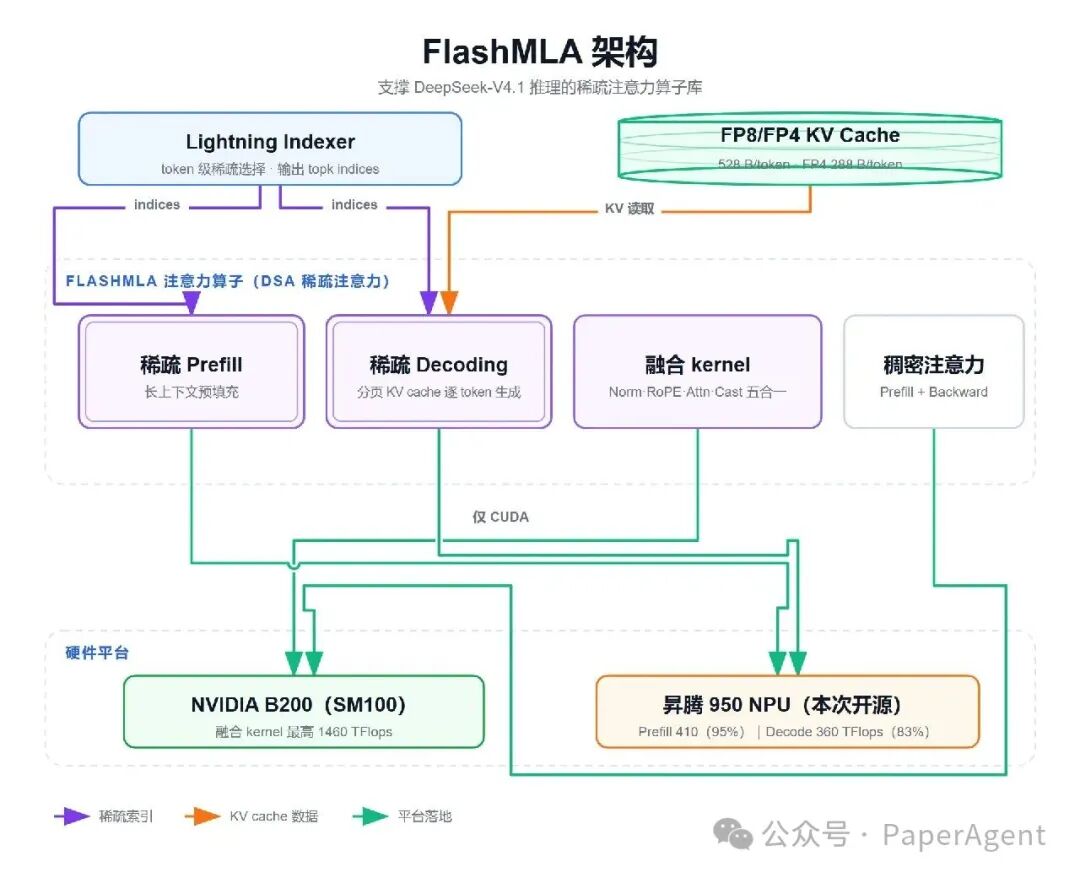
这次开源的昇腾版包含稀疏注意力的 Prefill 和 Decoding 算子,搭配 FP8/FP4 格式的 KV cache——V4.1 每 token 528 字节,FP4 版压到 288 字节。
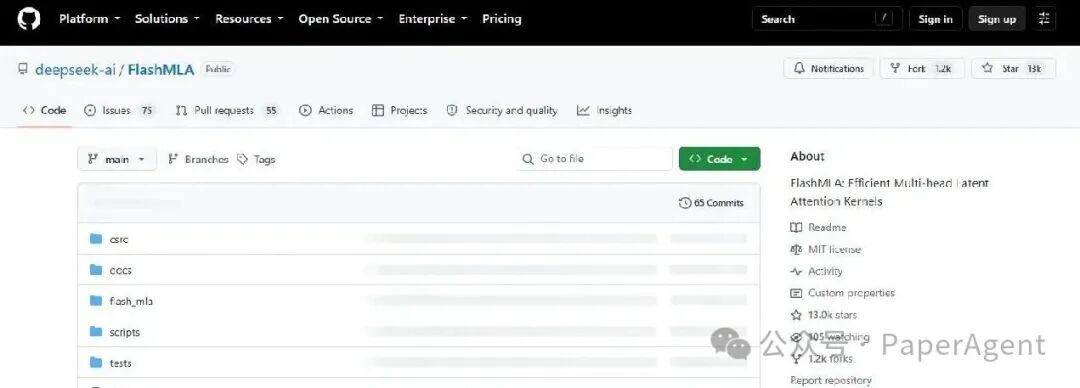
性能数字很硬:昇腾 950 上 Prefill 最高 410 TFlops,达到理论硬件峰值的 95%;Decoding 最高 360 TFlops,为峰值的 83%。官方还顺带放出了一篇讲算法和优化技巧的技术报告。
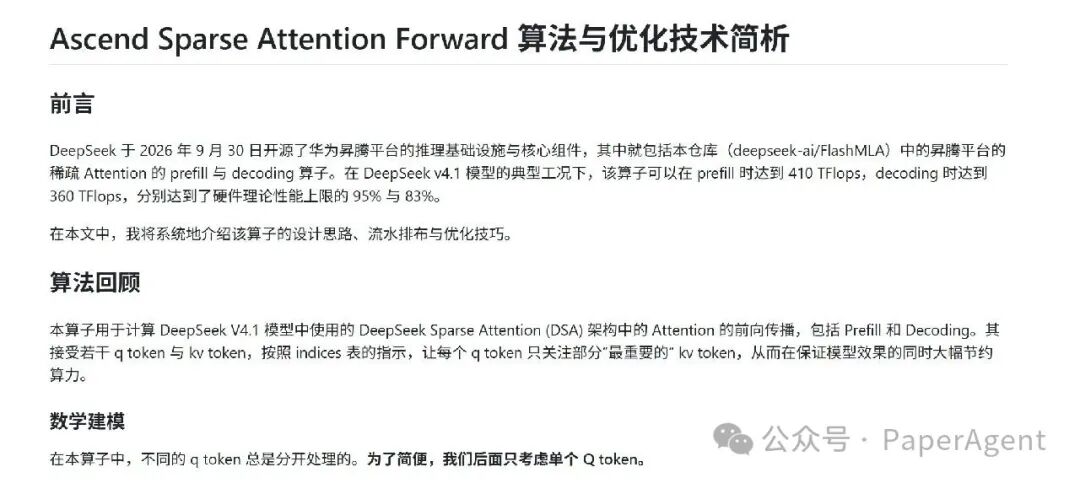
技术报告:https://github.com/deepseek-ai/FlashMLA/blob/main/docs/20260930-ascend-prefill-deep-dive-zh.md
DeepSelect:把 TopK 这件「小事」做到极致
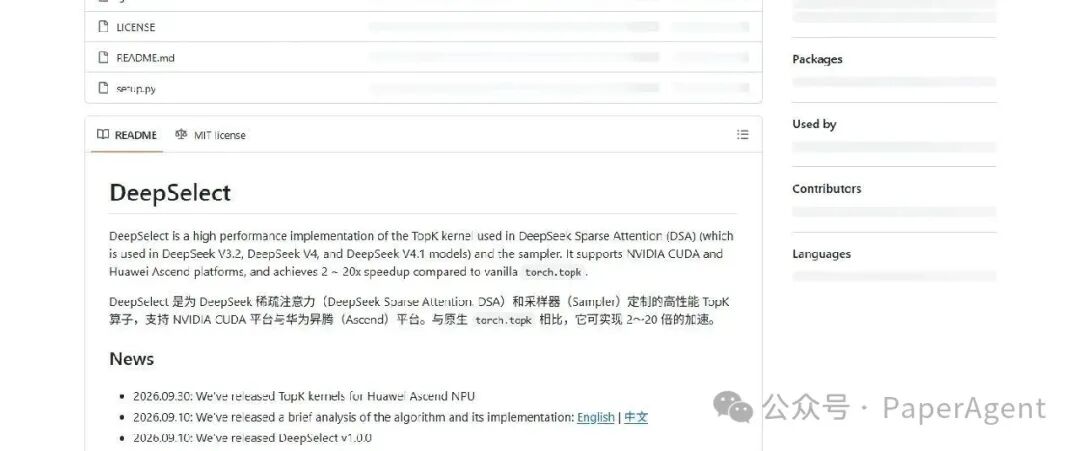
DeepSelect 是六个项目里最「小」的一个,干的活也很聚焦:高性能 TopK 算子。
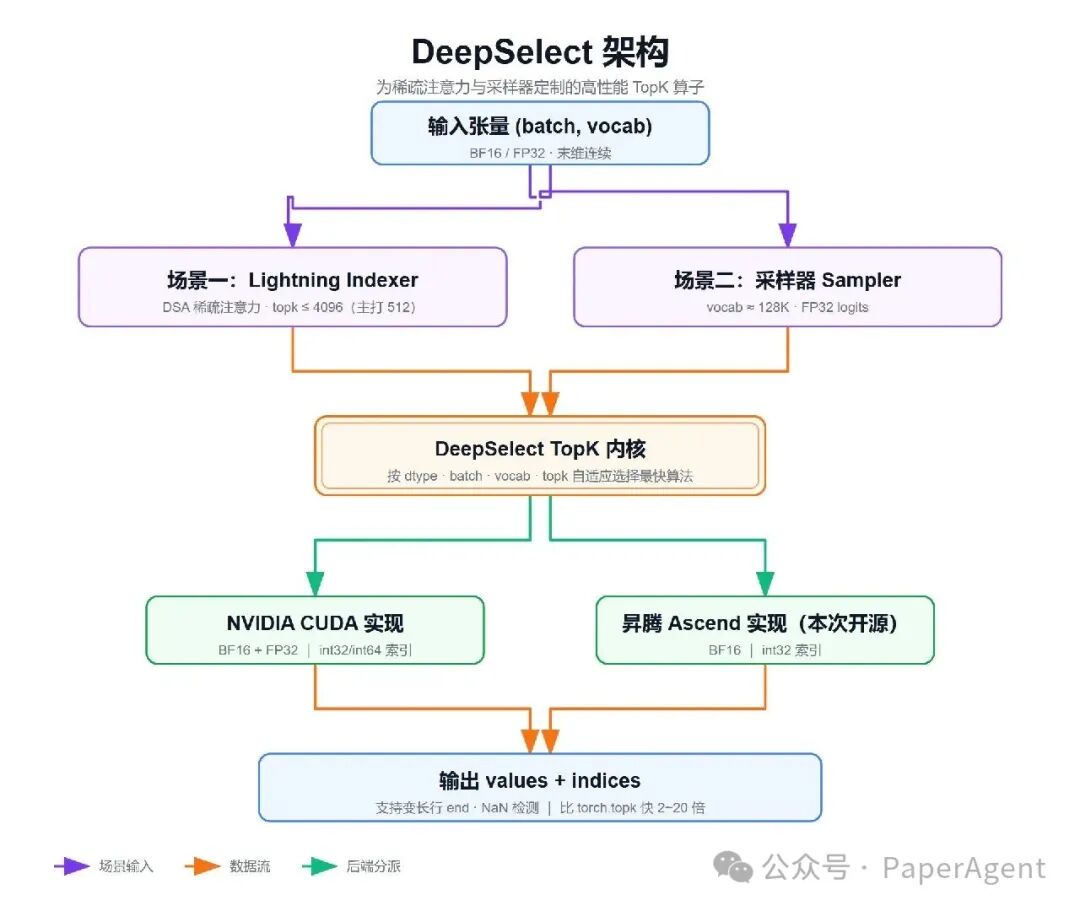
但它的应用场景恰好卡在两个要害位置上:一个是 DSA 稀疏注意力里 Lightning Indexer 的 token 筛选(每行从超长词表中选出 topk,DeepSeek V4 的 topk 就是 512),另一个是推理采样器从约 128K 词表中做 TopK 采样。这两处都是每生成一个 token 就要跑一遍的热路径。
六个项目的代码仓库地址如下:
https://github.com/tile-ai/tilelang
https://github.com/deepseek-ai/DeepGEMM-Ascend
https://github.com/deepseek-ai/DeepEP-Ascend
https://github.com/deepseek-ai/TileKernels
https://github.com/deepseek-ai/FlashMLA
https://github.com/deepseek-ai/DeepSelect
对这类开源基础设施项目感兴趣的话,欢迎来云栈社区和更多开发者一起讨论。
 发表于 1 小时前
|
查看: 3|
回复: 0


