现在写东西的人多多少少都碰上过这种尴尬:稿子明明是自己敲出来的,读者扫一眼就甩一句「这是 AI 写的吧」。想改,不知道从哪里动手;不改,又显得敷衍。
今天聊的这个项目叫 Humanizer,作者 blader,在 GitHub 上拿了 5 万星。
它既不是 AI 检测器,也不是用来骗过检测器的那种工具。它做的事很实在:以维基百科编辑们整理的《AI 写作特征》为基准,一条一条把文字里的机器味挑出来,重写掉,但不动你的原意。
作者在说明文档里放了一组前后对照,我抄一段你们自己感受。
先看改出来的效果。
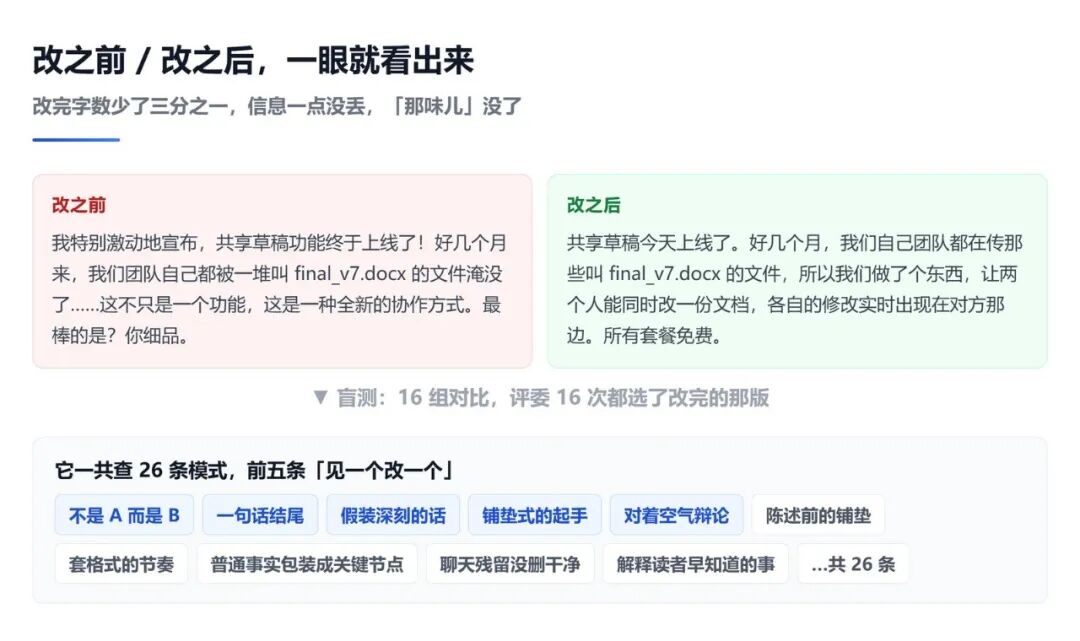
改之前是这样的:
我特别激动地宣布,共享草稿功能终于上线了!🚀 好几个月来,我们团队自己都被一堆叫「最终版_第7稿」的文件淹没了。我们知道一定得有更好的办法。现在两个人可以同时编辑同一份文档,每一次修改都会实时出现在对方屏幕上。这不只是一个功能,这是一种全新的协作方式。最棒的是?今天所有套餐都能用,完全免费。你细品。
改完之后:
共享草稿今天上线了。好几个月,我们自己团队都在传那些叫「最终版_第7稿」的文件,所以我们做了个东西,让两个人能同时改一份文档,各自的修改实时出现在对方那边。评论会一直钉在它对应的那句上,就算旁边文字改了也不会跑。所有套餐免费。
看出区别没:字数少了三分之一,信息一点没丢,但那味儿没了。
作者说这个改动做过盲测:16 组对比里,评委 16 次都选了改完的那版。这数据我反复看了两遍——通常这类工具的效果没这么干净。
01 它盯的五个最明显特征
作者把 26 条模式按强度和频率排了序,前五条属于「见一个改一个」,不用犹豫:
- 不是 A 而是 B —— 最常见的一条。「这不只是一个功能,这是一场变革。」把普通事实硬拔成转折。
- 一句话结尾 —— 单句成段的收尾。「你细品。」「自己体会。」补一句没有任何新信息的总结。
- 假装深刻的话 —— 听着有道理的空话。「说到底,真正重要的是……」
- 铺垫式的起手 —— 先来个引子。「事情是这样的。」「说实话?」直接说就行。
- 对着空气辩论 —— 先立个假靶子。「我不是说 X,但是……」没人说 X,你自己先反驳上了。
第一条和第五条我中招最多。尤其是「不是 A 而是 B」,这个句式我写稿时不自觉地就往外蹦,因为它读起来「有力量」。说白了,不过是用修辞掩盖信息量不足。
它总共查 26 条,剩下 21 条分散在几个大类里:陈述之前的铺垫、按规矩套的节奏和格式、普通事实被包装成关键节点、聊天里没删干净的残留、还有把读者已经知道的东西再解释一遍。
02 它为什么有效:模型选最通用的,人选最贴合的
说明文档里有一段解释,算是说到根子上了。
一个语言模型写作时,选的是「接下来最可能出现的内容」。所以它默认挑的是对最广的读者、最广的话题都成立的那个说法。而一个真人写东西时,他是为一个读者、一个话题做选择。
每一条 AI 特征,本质都是这种「默认通用选择」留下的痕迹:一句只表示「这很重要」却没增加任何事实的话;按规矩而非按内容凑出来的节奏;一个普通事实被写成关键转折;聊天里没删掉的东西;把读者早知道的事又解释一遍。
它的工作方式也不含糊:先标出所有特征,从最强的开始动手;然后起草一版重写,不把原文结构当固定框架;再把草稿跟模式清单和原文事实逐条核对;最后才出终稿。中间过程它会全部展示给你:第一版、一段自我批评、终稿。你能看到它自己跟自己较劲。
03 一条我特别喜欢的规矩:不许编
这条是我对它好感的主要来源。
它的规则是:姓名、数字、日期、引用、出处的来源,必须来自原文或者你本人。如果某句话需要补一个细节而这细节缺失,它问你要,而不是自己编一个塞进去。
看着简单,其实是重写类工具最容易翻车的地方。不少「润色」工具为了让文字顺,会顺手给你补个形容词、加个数字,用户不细看根本发现不了。等你发出去被人指出来,那才叫尴尬。
指文件就不要瞎动别的
你把一个文件丢给它,它只改正文散文,代码、数据、文档头部信息、链接目标一律不碰。它还分语境:个人化的文字保留作者的观点和怪癖;技术和说明性文字保持中性朴素。这种分寸感,比自己硬写提示词靠谱。
04 怎么装,怎么用
它是标准技能包,几个 AI 编程工具都有对应装法:
npx skills add blader/humanizer --global --agent claude-code
换个工具名就行:
npx skills add blader/humanizer --global --agent codex
装完直接调用,把文字贴进去:
/humanizer

[把你的文字贴在这儿]
或者用大白话也行,中文也能认:
帮我把下面这段文字去一下 AI 味:[你的文字]
在 Claude Code 里要求版本 2.1.142 以上,版本低了就用前面那条命令装。网页端和桌面端可以下压缩包,在设置里当技能上传。
我把它的规则扒出来,扫了一遍自己的稿子
光讲它怎么用没意思,我干了个更实在的事:把技能说明里那 26 条规则抽出来,写成检测脚本,回头扫我自己写的三篇文章。
规则是这么分的:A 类「装腔而不是陈述」、B 类「按规矩凑节奏」、C 类「注水」、D 类「格式化」、E 类「残留」、F 类「写错读者」。其中第 1 到第 5 条是见一次就该动手的强特征,标着「单独出现不算数」的那些,得跟别的特征一起出现才成立。
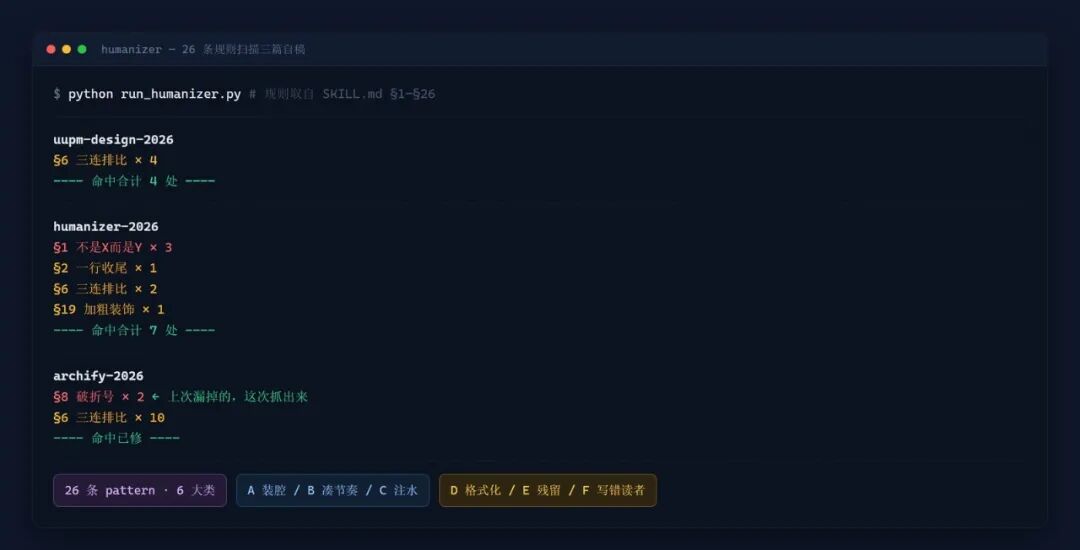
结果挺打脸。三篇里最干净的那篇命中 4 处,全是三连排比;讲去 AI 味那篇自己犯了 3 次「不是 X 而是 Y」;架构图那篇最脏,命中十几处。
最有用的是最后那一行:它抓出了两处我上一轮自己漏掉的破折号。我本来以为清干净了,结果规则一跑又冒出两处。这就是「清单」比「感觉」靠谱的地方:感觉会漏,清单不会。
05 一个我特别想说的功能:模仿你的文风
这个功能我是真没想到。
你可以在调用时,先贴两三段自己写的东西当样本,再贴要改的 AI 文字。它会跟着样本的节奏、用词、标点、还有你故意留的那些怪习惯走,包括你有没有爱用破折号。规则写得比我说的细:破折号这种「个人风格标记」,你用了它就跟着用,你没用它绝不自己加。
这就有意思了。以前你去 AI 味,去完是一股新的「标准人味」,读起来还是不像你。能对上你自己的调子,这个才有实用价值。
06 我得说点实在的
三点你得提前知道。
第一,它不是用来骗检测器的。 作者自己说了:让内容通过 AI 检测器,不是它的目标。检测器照样会把大部分它的输出标成 AI。它改的是给真人读的感觉,不是给机器看的分。
第二,去味不等于有内容。 它能把你一段空话改得更像人话,但空话还是空话。写作的底子还得你自己有。
第三,中文效果要打折。 它的 26 条模式是从英文维基那份清单来的,例子也全是英文。中文的 AI 味儿有自己的一套——比如爱堆「协同」「加持」这类大词,还有翻译腔的从句结构——它不一定认得出来。拿它当中文改稿的主力,别指望满分。
那中文稿子怎么用它?
我的做法是:当检查清单用,不当自动改稿用。把它标的那些模式,对照自己的中文稿子过一遍脑子里那关。「不是 A 而是 B」你有没有犯、「一句话结尾」你有没有犯。这个意识有了,比工具替你改管用。
07 收个尾
这个项目我最认可的一点,是它老实。
它不吹自己能绕过检测,不吹自己是万能润色,还专门写清楚自己的效果边界在哪。一个 5 万星的项目,敢在说明文档里承认「检测器还是会标你」,这个态度就值得看一眼。
要是你也碰上过「自己写的被当成 AI 写的」这种事,把它装上,先拿那 26 条清单对一遍自己的稿子。
 发表于 昨天 23:11
|
查看: 4|
回复: 0


