最近 Agent 越用越多,不管是每天让它帮我拉科技新闻做摘要、还是丢一篇深度长文让它帮我拆解分析、追问细节、关联其它观点,这些事单次对话都挺好使,但一旦任务拉长或者跨了几次会话,问题就来了。
大家在用 Agent 处理长任务时可能都遇到过这个痛点:多步骤、长任务处理过程中,工具调用产生的中间结果会迅速吃满上下文,导致注意力稀释、目标漂移,甚至任务直接失败。
而在跨会话场景下,我们又总是在反复告诉 Agent 同样的事——固定的 SOP、项目背景、工具习惯、输出格式。这些信息不应该每次重新解释,但也不应该被无脑地全塞进上下文。
比如我早上让它分析一篇 AI Infra 的长文,中间追问了很多细节以及关联思考,下午接着聊的时候它可能对早上那篇文章的关键论点已经开始含糊了——不是完全忘了,而是上下文压缩之后细节走样,给出的关联分析也开始跑偏。
再比如我连续几天让它追踪同一个话题,前天标注过“这个观点存疑,后续关注”,隔天再问它已经当成定论在引用了。
这种“上下文一压就变味”的问题,用过长链路 Agent 的应该都有体感。
让 Agent 有更强的记忆管理能力
应对这类问题常见的做法是:扩大 context window 或截断历史,但这两者都没有回答一个更根本的问题:信息离开上下文之后,Agent 还能否找到它、读懂它、继续用它?
从 Agent Infra 的角度看,这其实触及了一个更深层的问题:一个真正面向生产环境的 Agent 系统,缺的从来不是更大的窗口,而是更成熟的运行框架。
当 Agent 需要连续执行几十步工具调用、跨越多个子任务、处理上百万 token 的中间产物时,能否建立一套可靠的记忆卸载与恢复机制,决定了它能否走向长程任务真正可用。
正好我们团队有小伙伴一直在做 Agent 记忆方向的研究,做了一套面向 AI Agent 的分层记忆引擎,并且最近开源了——TencentDB Agent Memory,开箱即用,支持 OpenClaw 和 Hermes Agent 接入。
这个分层记忆引擎不是让 Agent 记住更多,而是让 Agent 具备更强的记忆管理能力:将完整信息卸载至外部文件系统,将任务执行过程压缩为一张可导航的 Mermaid 任务地图。
项目地址:https://github.com/Tencent/TencentDB-Agent-Memory
我自己接上跑了一段时间,效果确实不错,这里分享下实际感受。
符号化短期记忆 + 分层式长期记忆
一句话概括这个记忆引擎:TencentDB Agent Memory = 符号化短期记忆 + 分层式长期记忆。
传统方案要么把对话历史暴力堆砌进上下文,要么不可逆地压缩成一段摘要——前者 Token 爆炸,后者信息丢失。而 Agent Memory 是设计了一套有层次的记忆系统:
符号化短期记忆——解决单次长任务的信息过载:
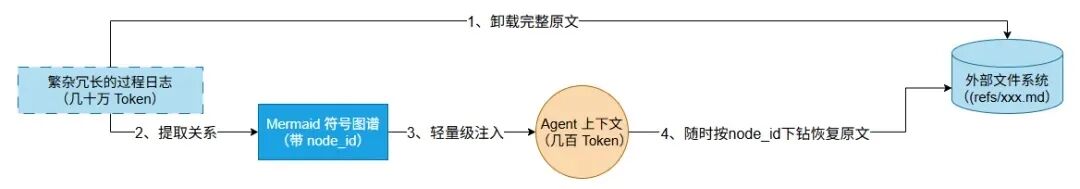
把厚重的工具日志和中间结果卸载到外部文件系统,逐步总结成轻量级的 Mermaid 结构符号留在上下文里。
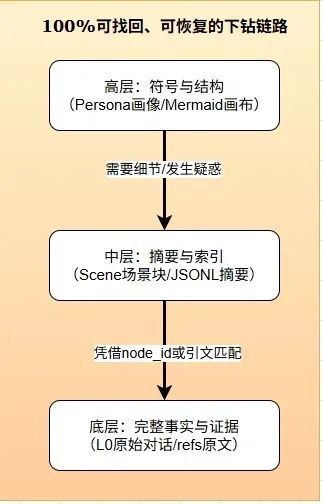
Agent 平时只看这张高密度的“任务地图”做推理,需要核对细节时再沿着索引下钻找回完整原文——既大幅降低 Token 消耗,又保证 100% 可溯源,不存在“压缩了就找不回来”的问题。
这个设计带来三个直接好处:
- 更省 Token——长网页、长日志、长工具输出不再长期占据上下文窗口
- 更稳完成长任务——Mermaid 画布保留任务结构,Agent 始终知道做到哪了、下一步该做什么
- 更容易复盘和恢复——原文、摘要、节点之间有清晰索引,任务断点和失败原因都可以追溯
这个能力尤其适合办公提效、调研分析、内容创作、编程这类“资料多、步骤长、反复改”的场景。
比如连续搜索网页做行业研究、多轮改写一篇报告、反复读文件跑测试修 bug,这些任务如果把所有中间产物都堆在上下文里,越做越重,Agent 很容易忘记原始目标或重复执行已完成的步骤。
短期记忆压缩让它保持轻量和连续,需要时再逐层找回。
分层式长期记忆——解决跨会话的经验沉淀:
把碎片化的对话层层提炼,而不是扁平地堆成向量:
- L0 原始对话全量保留(兜底,原文不丢)
- L1 自动提取事实、偏好、约束(结构化的“原子记忆”)
- L2 按任务场景聚合(同一话题的记忆归到一起)
- L3 长期用户画像(持续蒸馏出你的稳定偏好)
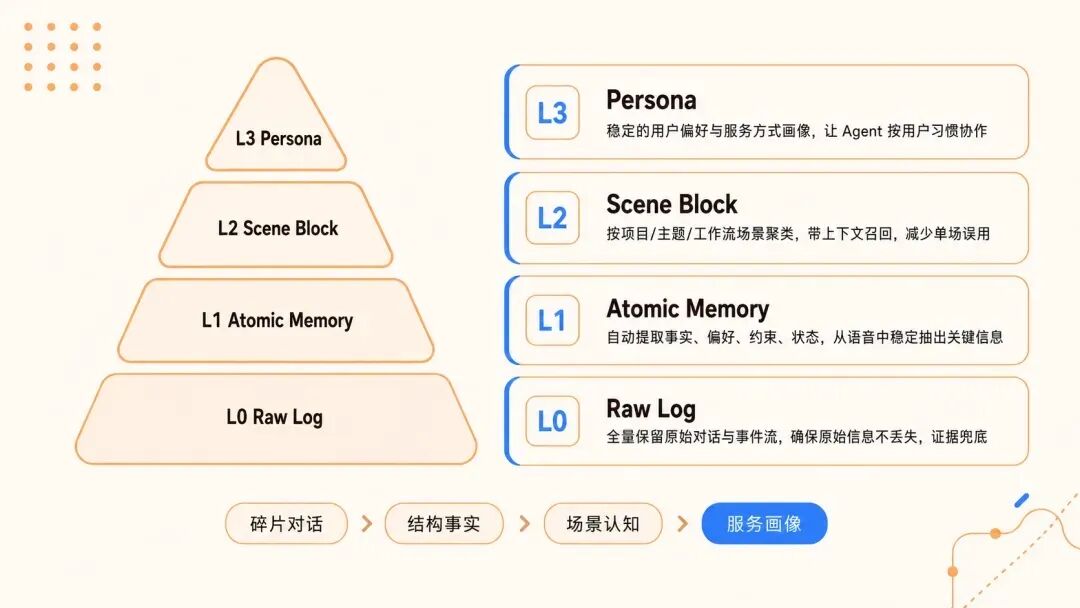
平时靠高层画像把握偏好,需要考证细节时再检索底层原文。每一条信息都可以沿着“画像 → 场景 → 原子事实 → 原始对话”的链路找回,不做任何不可逆的黑盒压缩。
实际体验
接上跑了一段时间,短期记忆和长期记忆的好处都比较明显。
短期记忆带来的变化——长任务不再越跑越飘:
以前让 Agent 连续做一个复杂调研,跑到后半程明显能感觉到它“忘了自己在干嘛”——重复搜索已经看过的内容、偏离最初的分析方向、对中间结论前后矛盾。现在工具调用的中间结果不会堆在上下文里撑爆,Agent 始终能看着那张任务地图知道做到哪了、下一步该做什么,连续跑一下午也不会因为 Token 膨胀而目标漂移。
长期记忆带来的变化——跨会话不用重复交代自己:
每天早上用 Agent 拉科技新闻、读深度文章,经常会追问细节、让它关联之前几天看过的观点。以前隔一天基本就得重新交代背景,现在它能记住我之前关注过哪些话题、对哪些观点存疑、偏好什么样的分析角度。不是把所有历史一股脑塞回来,而是在需要的时候精准召回相关的记忆,衔接起来自然多了。
接入方式
OpenClaw 两行命令:
openclaw plugins install @tencentdb-agent-memory/memory-tencentdb
openclaw gateway restart
Hermes Agent 用 Docker:
docker run -d \
  --name hermes-memory \
  --restart unless-stopped \
  -p 8420:8420 \
  -e MODEL_API_KEY="$MODEL_API_KEY" \
  -e MODEL_BASE_URL="$MODEL_BASE_URL" \
  -e MODEL_NAME="$MODEL_NAME" \
  -e MODEL_PROVIDER="$MODEL_PROVIDER" \
  -v hermes_data:/opt/data \
  agentmemory/hermes-memory:latest
内置腾讯云 DeepSeek-V3.2 默认配置,换模型传环境变量即可。如果你不想折腾 API 网关,也可以从 RouteFast.ai 这类模型 API 中转直接拿 Key 接入主流模型。
# 检查 Gateway 状态
curl http://localhost:8420/health

# 进入 Hermes 对话
docker exec -it hermes-memory hermes
接入很顺滑,几分钟搞定。
最后
Agent Memory 不是为了让 AI 存下所有东西,而是为了让人不必重复所有事情。
这个项目想做的事很朴素:让 Agent 记住该记的——你的流程、你的偏好、你的上下文,让人把注意力留给判断、创造和真正有价值的工作。
如果你也在用 OpenClaw 或 Hermes 做一些需要持续追踪、多轮深入的任务,推荐试试。也欢迎来云栈社区分享你的 Agent 记忆实践。
 发表于 昨天 23:43
|
查看: 5|
回复: 0


