一个嵌入式数据库,撑起了十三亿人的聊天记录。
前阵子有个小伙伴问了我一个挺有意思的问题:“三哥,微信每天产生那么多聊天消息,服务器是怎么存的?是不是也用 MySQL?”
我反问他:“你知道你手机里存了多少条聊天记录吗?”
他想了一下:“我用了五年微信,估计几十万条吧。”
“那你打开微信,搜索几年前的某条聊天记录,要等多久?”
“挺快的,基本秒出。”
这就是答案。你的聊天记录根本没有存在腾讯的服务器上,而是存在你自己的手机里——用一个叫 SQLite 的数据库。
十三亿人的聊天记录,全部以 SQLite 文件的形式,安安静静地躺在一部部手机里。腾讯的服务器只负责“转发消息”,不负责“长期保存”。这个设计决策,背后是一整套关于成本、架构和用户体验的权衡。
今天这篇文章,就把微信为什么用 SQLite、怎么用的、以及从中学到了什么,从头到尾拆解一遍。
一、你的聊天记录,不在腾讯服务器上
有些小伙伴可能会说:“聊天记录不是应该存在服务器上吗?不然换手机怎么同步?”
微信的聊天记录,默认是不上云的。 你换了一部新手机,登录微信之后,聊天记录是空的。你得用“聊天记录迁移”功能,把旧手机里的数据导过去。这个设计在当时被很多人吐槽——QQ 可以漫游聊天记录,微信为什么不行?
但如果你理解了微信的体量,就会明白这个决策背后的逻辑。
假设微信把十三亿用户的聊天记录全部存在服务器上,是什么概念?
每个人每天产生几十条消息,一条消息平均几百字节。十三亿人,每天就是几十 PB 的数据增量。存一年,就是 EB 级别。这需要建多少数据中心?花多少钱?
而且,聊天记录是“冷数据”——90% 的消息在发送后的几天内就不会再被查看了。为了这 90% 的冷数据去建一个 EB 级的存储集群,成本上完全不划算。
所以微信做了一个“反直觉”的选择:聊天记录存在本地,服务器只负责转发。
这带来的直接好处是:
- 服务器成本极低:腾讯不需要为每个用户的聊天记录建存储
- 隐私保护更好:你的聊天记录只在你自己的设备上
- 响应速度极快:搜索本地数据,不需要网络往返
代价就是——聊天记录不漫游,换设备要手动迁移。 但这个代价,微信认为可以接受。
二、一张图看懂微信的本地存储架构
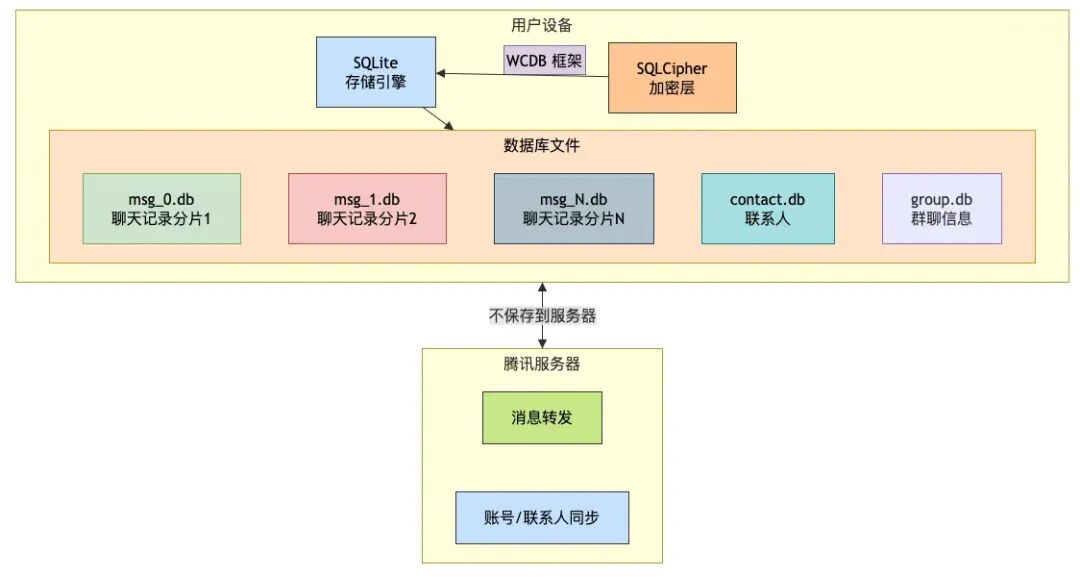
关键理解:微信本地使用的是 WCDB(WeChat Database) ——这是腾讯基于 SQLite 封装的一套数据库框架。底层还是 SQLite,但腾讯在上面加了一层 SQLCipher 加密。
每个聊天会话对应一个表,表名通常是 Chat_<hash> 格式。每个数据库文件(msg_X.db)在超过约 240MB 时会自动拆分为 msg_1.db、msg_2.db……
三、SQLite 为什么适合微信?
3.1 SQLite 的本质
一个库,不是一个服务。这是理解 SQLite 最关键的一点。
MySQL 是一个“服务端数据库” 。你启动一个 MySQL 进程,它监听 3306 端口,客户端通过网络连接它,发送 SQL,拿回结果。它有连接池、有用户管理、有权限控制。从架构层面看,这是一套完整的 CS 模型。
SQLite 是一个“嵌入式数据库” 。它没有独立的进程,没有网络层。你的程序直接调用它的 C 函数,它直接读写本地文件。SQLite 的整个引擎,就是一个几百 KB 的 C 语言库。
// SQLite的使用方式——直接调用库函数
sqlite3 *db;
sqlite3_open("msg_0.db", &db);              // 打开数据库文件
sqlite3_exec(db, "SELECT * FROM Chat_abc", callback, 0, 0);  // 执行SQL
sqlite3_close(db);                           // 关闭
这个架构差异,决定了 SQLite 的适用场景。
微信是一个手机 App。手机 App 不能启动一个独立的数据库服务进程——那会消耗额外的内存和 CPU。微信需要的是一个能直接嵌入 App、随用随开的数据库引擎,SQLite 正好满足这个需求。
3.2 单文件存储:聊天记录就是一个文件
SQLite 的另一个特点是单文件存储。一个数据库就是一个 .db 文件,所有的表、索引、数据都在里面。这对微信意味着什么?
备份和迁移变得极其简单。 你想把聊天记录从旧手机导到新手机?拷贝几个 .db 文件就行。你想备份到电脑?微信的“备份与恢复”功能,本质上就是在拷贝这些文件。
如果用 MySQL,你得导出 SQL、传输、导入,中间还有版本兼容问题。SQLite 的单文件格式,跨平台、跨版本,直接拷贝就能用。
3.3 FTS5:全文搜索的“秘密武器”
微信聊天记录搜索为什么那么快?答案在 FTS5 ——SQLite 内置的全文搜索扩展。
传统的 SQL 搜索用 LIKE '%关键词%',需要逐行扫描,数据量一大就慢得不行。FTS5 用的是倒排索引——它维护一个从“词”到“文档 ID”的映射表,搜索时直接查索引,不需要扫全表。
实测数据:在 1 万条长文本中查询,FTS5 的中位响应时间约 0.14 毫秒,比 LIKE 快 15 倍。微信的聊天记录搜索,底层用的就是 FTS5。你输入“张三 发票”,它能在几十万条消息里瞬间定位到相关记录。
四、WCDB:腾讯在 SQLite 上做了什么?
微信用的不是“裸 SQLite”,而是腾讯自研的 WCDB 框架。它在 SQLite 之上加了几层关键能力:
第一层:SQLCipher 加密
你的聊天记录数据库是加密的。macOS 版微信使用 AES-256-CBC 加密,密钥为 32 字节。这意味着即使有人拿到了你的 .db 文件,没有密钥也打不开。
第二层:性能优化
WCDB 针对微信的场景做了大量优化。比如:
- 批量写入:微信的消息是高频小批量写入,WCDB 对此做了专门优化
- 连接池管理:多个聊天窗口同时操作数据库时,WCDB 管理连接复用
- 监控与诊断:WCDB 内置了性能监控,能发现慢查询
第三层:多线程并发
SQLite 默认只支持单写多读——同一时间只能有一个写操作,但可以有多个读操作。WCDB 在应用层做了协调,让多个聊天窗口的读写尽可能不互相阻塞。这部分涉及 多线程并发控制 的经典问题,在嵌入式场景下尤其考验设计功力。
五、SQLite 的“天花板”在哪里?
SQLite 很强大,但它不是万能的。理解它的局限性,才能理解微信为什么“本地用 SQLite,服务器用别的”。
5.1 并发写入的限制
SQLite 的核心限制是:同一时间只能有一个写操作。WAL(Write-Ahead Logging)模式改善了这个情况——写操作和读操作可以并行,但写和写之间仍然是串行的。
这对微信意味着什么?每个用户的聊天记录,在本地是串行写入的。 你同时给三个人发消息,这三条消息的写入是排队进行的。在手机端,这个限制影响不大——你不可能同时产生成千上万条消息。但如果在服务器端,几百万用户同时写,SQLite 就撑不住了。这也是为什么 高并发系统设计 中几乎不会考虑 SQLite 作为主力存储。
5.2 没有网络层,没有用户管理
SQLite 没有网络层,所以它不能作为“服务器数据库”使用。它也没有用户管理、权限控制——因为它假设只有一个应用程序在访问它。这些限制,在手机端恰好不是问题。微信 App 是唯一的访问者,不需要用户管理,不需要网络层。
六、从微信的设计中学到了什么?
微信的 SQLite 使用,给我们几个重要的架构启示:
启示一:不是所有数据都需要“上云”
“数据上云”是趋势,但“全部上云”是浪费。冷数据存本地,热数据存云端,这个分层策略在成本上更合理。微信的聊天记录是“冷数据”——存了之后很少读,不值得为它建 EB 级云存储。
启示二:嵌入式数据库被严重低估
很多人觉得 SQLite 是“玩具数据库”。但事实上,SQLite 的部署量可能比所有其他数据库加起来都多。你的手机里有几十个 App 在用 SQLite,你的浏览器在用 SQLite,你的 IDE 也在用 SQLite。在 数据库技术选型 的讨论里,SQLite 往往是被忽视但实际无处不在的存在。
启示三:加密是本地存储的底线
聊天记录存在本地,意味着设备丢失 = 数据泄露。微信用 SQLCipher 加密数据库,用 AES-256 保护密钥,这是本地存储的底线。如果你的 App 也在本地存敏感数据,加密是必须的,不是可选的。
七、优缺点
SQLite 的优点
1. 零配置,零运维:没有独立的服务器进程,不需要安装、配置、启动。一个文件就是整个数据库。
2. 单文件存储,跨平台:一个 .db 文件,可以在 Windows、macOS、Linux、iOS、Android 之间直接拷贝使用。
3. ACID 事务支持:SQLite 支持完整的 ACID 事务——原子性、一致性、隔离性、持久性。这意味着数据不会因为崩溃而损坏。
4. 全文搜索(FTS5) :内置的 FTS5 扩展提供高性能全文搜索,比 LIKE 快 15 倍。
5. 极低的内存占用:整个引擎就是一个几百 KB 的 C 库,运行时内存占用极低。
6. 加密支持:通过 SQLCipher 扩展,可以对数据库进行 AES-256 加密。
SQLite 的缺点
1. 单写多读的并发限制:同一时间只能有一个写操作,写和写之间串行。不适合高并发写入场景。
2. 没有网络层:不能作为服务器数据库使用,无法支持多客户端网络访问。
3. 没有用户管理:没有内置的权限控制、用户管理功能。
4. 大规模数据性能有限:在 TB 级数据上,性能会明显下降。微信的解决方案是分片——超过 240MB 就拆分成新文件。
八、适用场景
| 场景 |
推荐程度 |
理由 |
| 移动 App 本地存储 |
✅✅✅ 强烈推荐 |
微信、QQ 等都在用,零配置嵌入 |
| 桌面应用数据存储 |
✅✅✅ 强烈推荐 |
浏览器、IDE 的本地缓存 |
| 单用户数据管理 |
✅✅✅ 强烈推荐 |
个人笔记、本地知识库 |
| 嵌入式设备 |
✅✅✅ 强烈推荐 |
资源受限环境下的数据存储 |
| 服务端高并发数据库 |
❌ 不推荐 |
单写多读限制,不适合高并发写入 |
| 多用户网络访问 |
❌ 不推荐 |
没有网络层,无法作为服务器数据库 |
九、写在最后
回到最初的问题:微信为什么使用 SQLite 保存聊天记录?
答案不复杂——因为聊天记录是“冷数据”,存本地比存云端更合理。 十三亿人的聊天记录,如果全部存在腾讯的服务器上,是 EB 级的存储成本。而且这些数据 90% 的时间是“沉睡”的,为了这 10% 的搜索需求去建一个 EB 级的存储集群,投入产出比极低。
SQLite 的嵌入式架构,恰好匹配了“本地存储”的需求。 零配置、单文件、ACID 事务、全文搜索——这些特性让微信可以在不增加服务器成本的前提下,提供快速的本地搜索体验。
当然,这个设计也有代价——聊天记录不漫游。换手机要手动迁移,丢手机就丢记录。但这个代价,微信认为可以接受。
技术选型从来不是“什么最好”,而是“什么最适合”。 微信选了 SQLite,不是因为 SQLite 比 MySQL“更好”,而是因为 SQLite 更适合“本地存储”这个场景。如果你正在设计一个需要本地数据存储的系统,SQLite 值得你认真考虑。它可能不是最“高大上”的选择,但它可能是最务实的选择。
十、参考资源
 发表于 2 小时前
|
查看: 0|
回复: 0


