原文地址:https://medium.com/@vndpal/how-i-design-database-schemas-as-a-senior-developer-for-better-results-ae5cf17e575d
原文作者:Vinod Pal
我设计数据库模式已经超过十年,接触过银行、电商、预订和社交媒体等多个领域。
大多数模式至今仍在稳定运行,少数几个则给我们带来了生产环境中断和痛苦的重写。
奇怪的是,好的模式和坏的模式在纸面上看起来几乎一模一样。它们都有主键、外键、清晰的规范化设计,以及正确的索引。
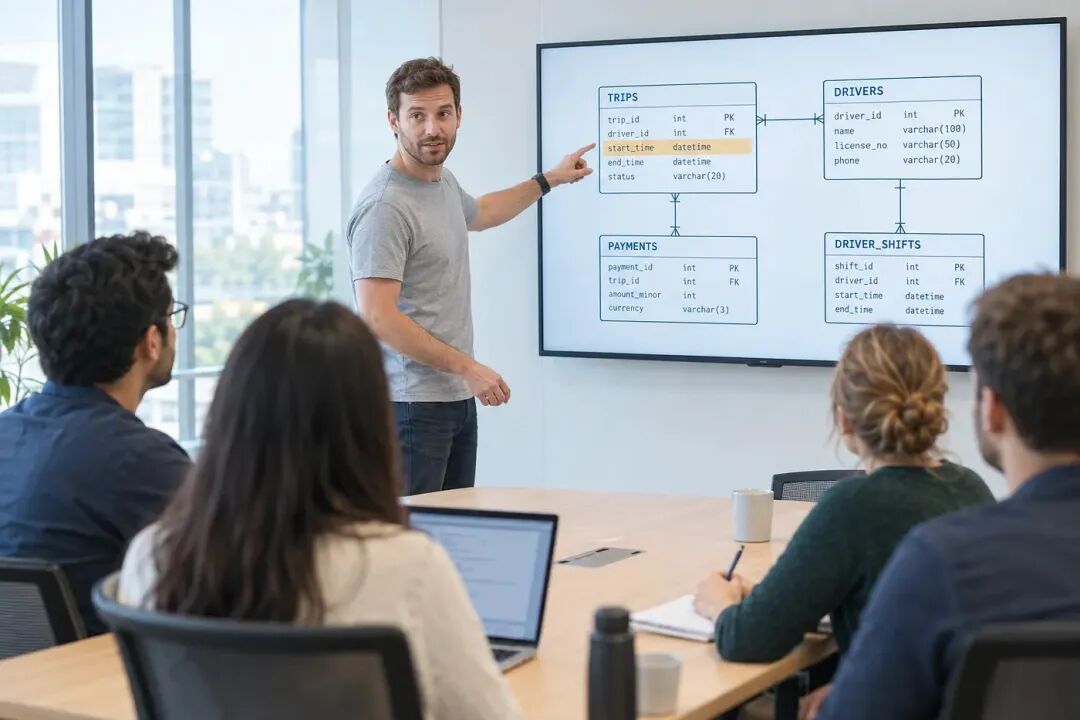
所以,教科书里的规则从来不是区分它们的关键。真正造成差异的,是一些教科书从未提到过的决策。
其中一些决策,我可以在一小时内修好。另一些则花了几个月,因为数据已经扩散到报表和备份里。
在这篇文章中,我会带你了解我用来尽早发现这些问题的思考过程。
我们会一起检查六个模式。每一个都遵循了良好的实践,却仍然在生产环境中出问题。
它们都来自同一个应用:一个类似 Uber 的网约车服务。它起步于柏林,现在已经运行在多伦多和新加坡。
这些思路适用于任何领域。
为什么模式设计决定了一切
模式是系统中唯一一个你无法轻易抽身的部分。
糟糕的代码可以重写,糟糕的数据却会被复制。一个损坏的函数只存在于一个文件中;一列损坏的数据则会扩散到报表、备份,以及每一个读取它的服务。
好的模式让功能开发变得简单。正确的结构意味着新需求可以通过一条查询实现;错误的结构意味着一次迁移、一次回填,以及三个团队开会讨论。
错误的模式不会在第一天就暴露出来。它在测试中运行良好,直到第二年才会出问题——那时数据已经大到无法移动,也重要到不能丢失。
你会永远为一次模式设计错误付出代价。你在它之上编写的每一个变通方案,都会变成另一个必须持续正常运行的东西。
做对了,没人会注意。做错了,你接下来两年都要为那些数字道歉。
每份模式指南都会讲到的实践
首先,是你已经读过一百遍的清单。
- 为每张表设置主键
- 使用外键,确保关联不会断裂
- 先进行规范化,确有实际理由时再反规范化
- 为用于过滤、连接和排序的列建立索引
- 选择能够容纳数据的最小数据类型
- 永远不要用浮点数存储金额
- 使用带时区的时间戳
- 使用枚举或查找表,而不是自由文本的状态值
- 为任何会变化的内容添加
created_at 和 updated_at
- 命名列时,确保下一个读代码的人能够理解
每一条都没错。我全部遵循。
但没有任何一条救过我。下面六个问题都出现在通过了这份清单的模式中。
案例 1:在允许 NULL 之前,先决定 NULL 表示什么
这是第一张表。先读完,再往下滚动。
CREATE TABLE trips (
  id BIGSERIAL PRIMARY KEY,
  rider_id BIGINT NOT NULL REFERENCES riders(id),
  driver_id BIGINT REFERENCES drivers(id),
  cancelled_at TIMESTAMPTZ,
  rating SMALLINT
);
三个列允许为 NULL。花一分钟分别想想它们。
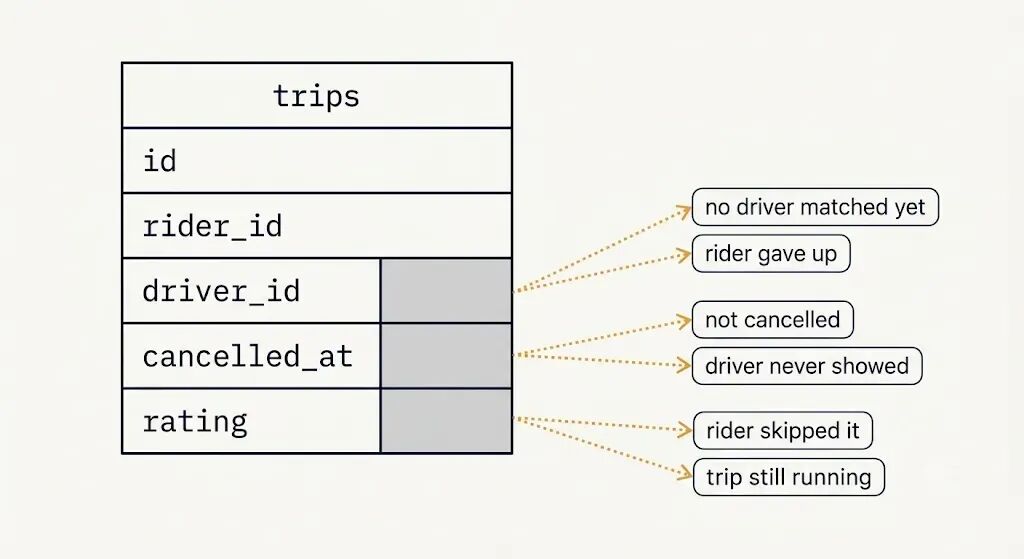
想到了吗?每个 NULL 都表示两种不同的情况,而这张表没有记录其中的区别。
空的 driver_id 可能表示还没有匹配到司机,也可能表示乘客在匹配成功前就放弃了。你无法区分这两种情况。
空的 cancelled_at 可能表示行程没有被取消,也可能表示行程在任何人能够取消它之前就失败了,因为司机根本没有出现。
空的 rating 可能表示乘客跳过了评价,也可能表示行程仍在进行中,因此还没有可供评价的内容。
现在看看这会如何影响查询。有人想查找在新加坡从未接过行程的司机。
SELECT * FROM drivers
WHERE id NOT IN (
  SELECT driver_id FROM trips
  WHERE city_id = 3
);
这会返回零行,而且永远都会这样。
内部列表中的一个 NULL 就能破坏整个查询。数据库无法判断一个司机是否不在包含未知值的列表中。所以它返回 unknown,而 unknown 不等于 true。
你不会收到任何错误。报表只会看起来像是没有人符合条件。更聪明的查询可以绕过这个问题,但在错误报表发布之前,没有人会想到去写那个更聪明的查询。
这是我的规则:当某列不适用于该行时,允许使用 NULL;当 NULL 表示"我们不知道"时,永远不要允许它。
CREATE TYPE trip_lifecycle AS ENUM
  ('requested', 'matched', 'started', 'completed', 'cancelled');

ALTER TABLE trips ADD COLUMN lifecycle trip_lifecycle NOT NULL;

ALTER TABLE trips ADD CONSTRAINT driver_set_after_match
CHECK (lifecycle = 'requested' OR driver_id IS NOT NULL);
现在,空的 driver_id 只有一种含义,而这个检查约束会保持这一点。状态存在于一个列中,而不是隐藏在缺失值里。
案例 2:同时记录事实何时成立,以及你何时得知它
看下一张表。这张表是我设计的。司机的佣金比例会随时间变化,所以我保留了历史记录。
CREATE TABLE driver_rates (
  id BIGSERIAL PRIMARY KEY,
  driver_id BIGINT NOT NULL REFERENCES drivers(id),
  commission_pct NUMERIC(5,2) NOT NULL,
  valid_from TIMESTAMPTZ NOT NULL,
  valid_to TIMESTAMPTZ
);
这已经比生产环境中的大多数表更好了。它保留了旧佣金比例,而不是直接覆盖它们。
那还缺少什么?这个问题更难,所以先来看一个故事。
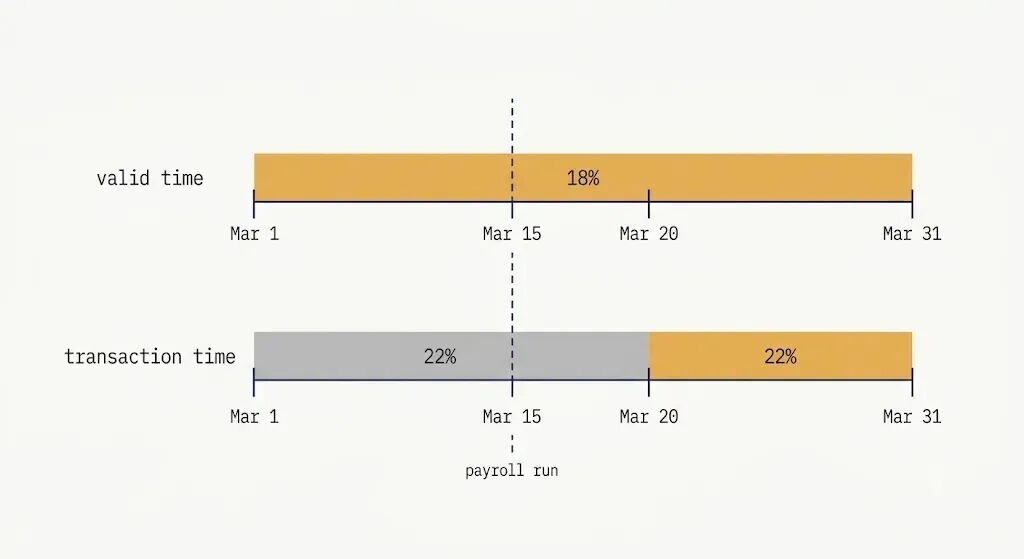
3 月 20 日,运营部门告诉你,一位柏林司机的佣金从 3 月 1 日起调整为 18%。你添加了一行记录,并把 valid_from 设置为 3 月 1 日。
你已经按 22% 的比例支付了这位司机 3 月上半月的佣金。钱在 3 月 15 日已经从银行划出。
现在再次运行 3 月的工资报表。它显示整个月都是 18%,于是你的报表和银行记录不再一致。
两个数字都是正确的。一个回答"当时实际是什么情况",另一个回答"付款时我们知道什么"。
你的表只保存了一条时间线,而业务依赖两条时间线。
解决办法是增加一组列,用来记录你何时知道这件事。
ALTER TABLE driver_rates
ADD COLUMN recorded_at TIMESTAMPTZ NOT NULL DEFAULT now(),
ADD COLUMN superseded_at TIMESTAMPTZ;
valid_from 和 valid_to 表示该佣金比例在现实世界中何时生效。recorded_at 和 superseded_at 表示数据库何时认为它生效。
我们把这两条时间线称为有效时间(valid time)和事务时间(transaction time)。同时保留两者的表叫作双时态表(bitemporal table)。这两个列是最简单的实现方式,所以在真正构建之前,请先深入了解相关内容。
现在你可以分别提出这两个问题。
SELECT commission_pct
FROM driver_rates
WHERE driver_id = 4471
AND valid_from  <= '2026-03-15'
AND (valid_to IS NULL OR valid_to      > '2026-03-15')
AND recorded_at <= '2026-03-15'
AND (superseded_at IS NULL OR superseded_at > '2026-03-15');
可以把它读成同时提出的两个问题:3 月 15 日时实际是什么情况,以及 3 月 15 日时我们知道什么。
不是每张表都需要这样做。大多数表都不需要。但有些表会为工资、账单或监管报表提供数据。对于这些表,请问一个问题:有人能否把更正记录为过去某个时间发生?
如果可以,你就需要两条时间线,因为审计人员问的不会只是实际情况。他们会问你知道什么,以及你是什么时候知道的。
案例 3:在金额发生变化的那一刻冻结它
这是支付表。你的同事说它已经准备好了。
CREATE TABLE payments (
  id BIGSERIAL PRIMARY KEY,
  trip_id BIGINT NOT NULL REFERENCES trips(id),
  amount NUMERIC(10,2) NOT NULL,
  created_at TIMESTAMPTZ NOT NULL DEFAULT now()
);
你发现了容易发现的问题:没有货币列。所以在柏林、多伦多和新加坡,40 代表的是三种不同的金额。
加上货币列,仍然还有一个 bug。这一个最终会让你和财务部门坐在会议室里。
报表需要把所有内容换算成欧元。你有一张汇率表,因此报表在读取数据时连接这张表并进行换算。
这看起来是正确的规范化。既然可以查询汇率,就不需要存储一份副本。
但这也正是为什么上个季度的收入每天早上都会变化。
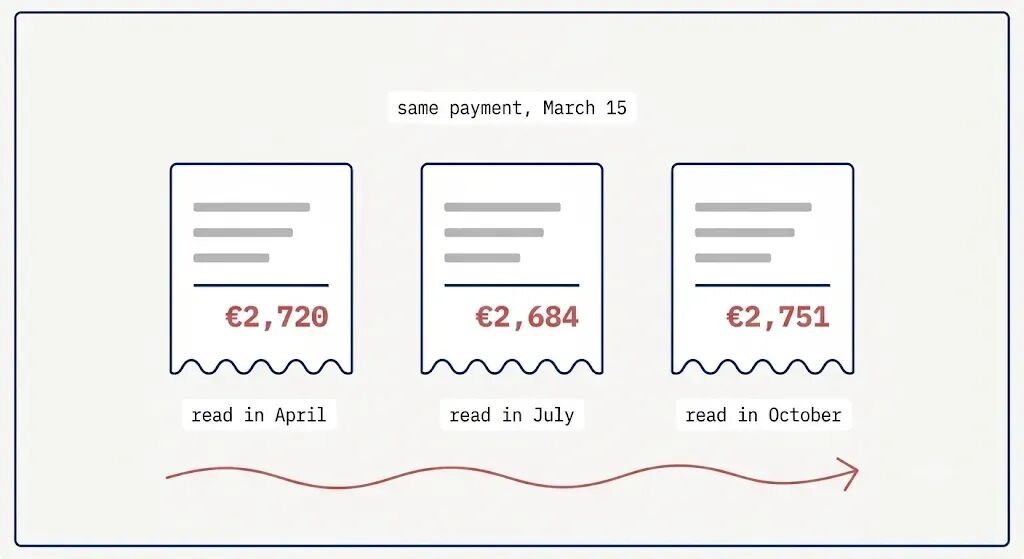
有人会问为什么 3 月的数字变了。你不会有好的答案,因为这个模式是在重建过去,而不是记录过去发生的事情。
CREATE TABLE payments (
  id BIGSERIAL PRIMARY KEY,
  trip_id BIGINT NOT NULL REFERENCES trips(id),
  amount_minor BIGINT NOT NULL,       -- cents, never a float
  currency CHAR(3) NOT NULL,
  fx_rate NUMERIC(18,8) NOT NULL,     -- EUR per 1 unit of currency
  amount_base_minor BIGINT NOT NULL,  -- euro cents, rounded half up
  created_at TIMESTAMPTZ NOT NULL DEFAULT now()
);
注意这些注释。一个没有说明方向的汇率列,就是在等待下一个读表的人踩坑。大多数团队还会记录汇率的来源。
没错,fx_rate 复制了汇率表中已经存在的值。但这份副本正是关键所在。
支付是一种事件。事件应该存储当时的数字,而不是记录一套以后重新计算这些数字的配方。
规范化是一条关于稳定事实的规则。汇率并不是稳定事实,因此这条规则不适用。
你的会计规则决定了这些字段,舍入策略也会决定字段。此外,还有一个问题:哪个金额才是权威值,原始金额还是换算后的金额?
无论具体情况如何,原则都一样:记录发生过什么,永远不要只记录一套重建结果的配方。
案例 4:为任何未来事件保存墙上时钟时间
司机会提前预订班次。看看这些列。
CREATE TABLE driver_shifts (
  id BIGSERIAL PRIMARY KEY,
  driver_id BIGINT NOT NULL REFERENCES drivers(id),
  starts_at TIMESTAMPTZ NOT NULL,
  ends_at TIMESTAMPTZ NOT NULL
);
两个列都使用 TIMESTAMPTZ。每份指南都说这是正确的类型,而对于已经发生的事情,它确实是正确的。
一位多伦多司机预订了一个重复发生的早上 6 点班次。你把它保存为 11:00 UTC 这一时刻。
11 月,多伦多将时钟拨回一小时。现在这个班次在当地时间早上 5 点开始,司机会提前一小时收到提醒。
时间戳存储的是一个确切的时刻。但司机从未同意某个具体时刻,他同意的是早上 6 点。
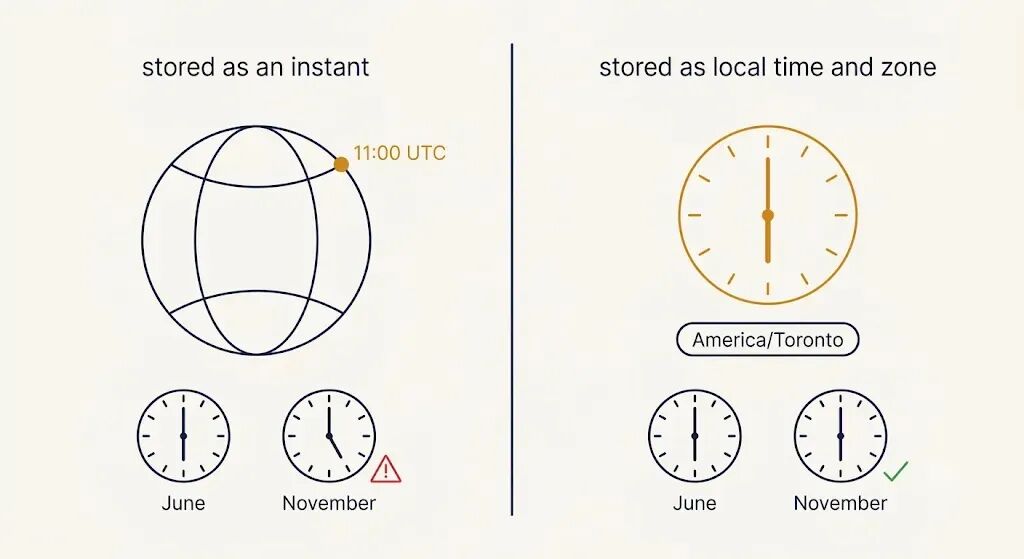
对于未来的任何事情,都要存储当事人的真实意图。
CREATE TABLE driver_shifts (
  id BIGSERIAL PRIMARY KEY,
  driver_id BIGINT NOT NULL REFERENCES drivers(id),
  local_date DATE NOT NULL,
  local_start TIME NOT NULL,
  local_end TIME NOT NULL,
  time_zone TEXT NOT NULL -- 'America/Toronto'
);
需要时,再根据当天适用的规则计算出确切时刻。
还有第二个原因,而且会让很多人感到意外。政府可能会提前几个月修改时区规则。
保存一个确切时刻,就锁定了保存它时所存在的那条规则。保存时钟时间和时区名称,则会在服务器更新时区数据后采用新规则。
判断标准是:双方达成约定时,依据的是谁的时钟。一位司机的早上 6 点班次是一个本地时间承诺,因此要保存时钟时间和时区。必须在固定的全球时刻运行的服务器任务则不是,所以要保存时间戳。
过去的事件总是对应一个确切时刻。未来事件则取决于它属于上述两种情况中的哪一种。
案例 5:添加软删除的当天,检查所有唯一性规则
下面两行都来自开头的清单。
CREATE TABLE riders (
  id BIGSERIAL PRIMARY KEY,
  email CITEXT NOT NULL UNIQUE,
  deleted_at TIMESTAMPTZ
);
电子邮件必须唯一,所以不会有重复账户。使用软删除,因此客服可以恢复账户。
单独来看,两者都没错。放在一起却会产生一个 bug。
一位乘客删除了账户。一个月后,她用同一个电子邮件地址重新注册。插入操作失败。唯一性规则完全不知道 deleted_at 的存在,它仍然会把那条已删除的记录计算在内。
两个常见的修复方案反而会让事情更糟。清空电子邮件地址,会丢掉你之所以保留这行记录的那份信息。
添加类似 anna@example.com.deleted.7741 的后缀看起来更整洁。但现在每个查询都必须删除这个后缀,每份报表都必须知道这件事,而总会有一份报表不知道。
你的真实意图从来不是"所有行之间唯一",而是"活跃乘客之间唯一"。
ALTER TABLE riders DROP CONSTRAINT riders_email_key;

CREATE UNIQUE INDEX riders_one_active_email
ON riders (email)
WHERE deleted_at IS NULL;
现在索引只覆盖未删除的行。旧账户仍然保留着它的电子邮件和历史记录。
添加软删除标记时,要在同一天检查该表上的每一条唯一性规则。每一条规则的含义都已经发生了变化,只是没有告诉你。
案例 6:让错误的行根本无法插入
最后一个问题。司机不能同时上两个班次,所以你的同事在代码中检查班次冲突。
var clash = await _db.DriverShifts
    .AnyAsync(s => s.DriverId == id
                && s.StartsAt < endsAt
                && s.EndsAt   > startsAt);

if (clash) throw new ConflictException("Shift overlaps an existing one");
逻辑是正确的。那它会在哪里失败?
两个请求在同一毫秒到达。它们都执行检查,也都发现没有冲突。然后它们都执行插入。
两个检查都通过了。代码没有任何 bug。
看看生产数据库中任何一条不应该存在的记录。一定有某段代码让它进来了,而那段代码曾承诺这种事情永远不会发生。
数据库可以拒绝这条记录,而不是信任调用者。这个方案仅适用于 PostgreSQL,并且需要启用 btree_gist 扩展。
ALTER TABLE driver_shifts

ADD CONSTRAINT no_overlapping_shifts
EXCLUDE USING gist (
  driver_id WITH =,
  tstzrange(starts_at, ends_at) WITH &&
);
把它读成一句话:同一个司机、时间范围重叠,则拒绝。
无论两个请求以什么顺序到达,现在第二次插入都会失败。
每次验证设计的背后,都有一个问题:谁可以犯错?
你有两个选择。
第一种:每个写入这张表的服务永远都要遵守规则。某个人在午夜运行的回填脚本也一样。
第二种:由一条规则统一守住底线。
让模式保持健康的习惯
上面的检查针对的是表。下面这些习惯针对的是你的工作方式。
- 在写表之前,先写出问题。列出业务会向这份数据提出什么问题,然后反向设计。
- 把每个名称都对团队外的人大声说一遍。任何需要用一句话解释的名称,都是错误的名称。
- 在宣布完成之前,先加载一年的数据。一千行时感觉没问题的结构,到了千万行时才会暴露它的代价。
- 把注释写进数据库,而不是写进 wiki。
COMMENT ON COLUMN 会和列一起存在,wiki 页面却会过时。
- 比审查代码变更更严格地审查模式变更。为它安排第二位审查者,并额外留出一天时间。
- 邀请那些会读取数据的人参与。仪表盘和数据仓库的构建者同样是模式的用户。
- 每次模式变更都分两次部署。先添加、双写、回填,然后删除。一次性部署会让你没有退路。
- 列出所有无法撤销的事情。把审查时间花在这些地方,让可逆的选择快速通过。
数据库设计这件事,纸面上看都是教科书规则,真正拉开差距的却是这些藏在细节里的决策。如果你也在积累数据库实战经验,欢迎到云栈社区与更多开发者一起交流。
 发表于 半小时前
|
查看: 6|
回复: 0


