很多团队刚开始做 Agent 的时候,都把问题想简单了。他们觉得只要 Agent 足够智能,能查知识库、能调用 Tool、还能自动执行任务,这个项目就算是做成了。
但真正把 Agent 接进公司系统以后,麻烦马上就来了——因为最关键的权限与数据隔离方案,从一开始就被忽略了。
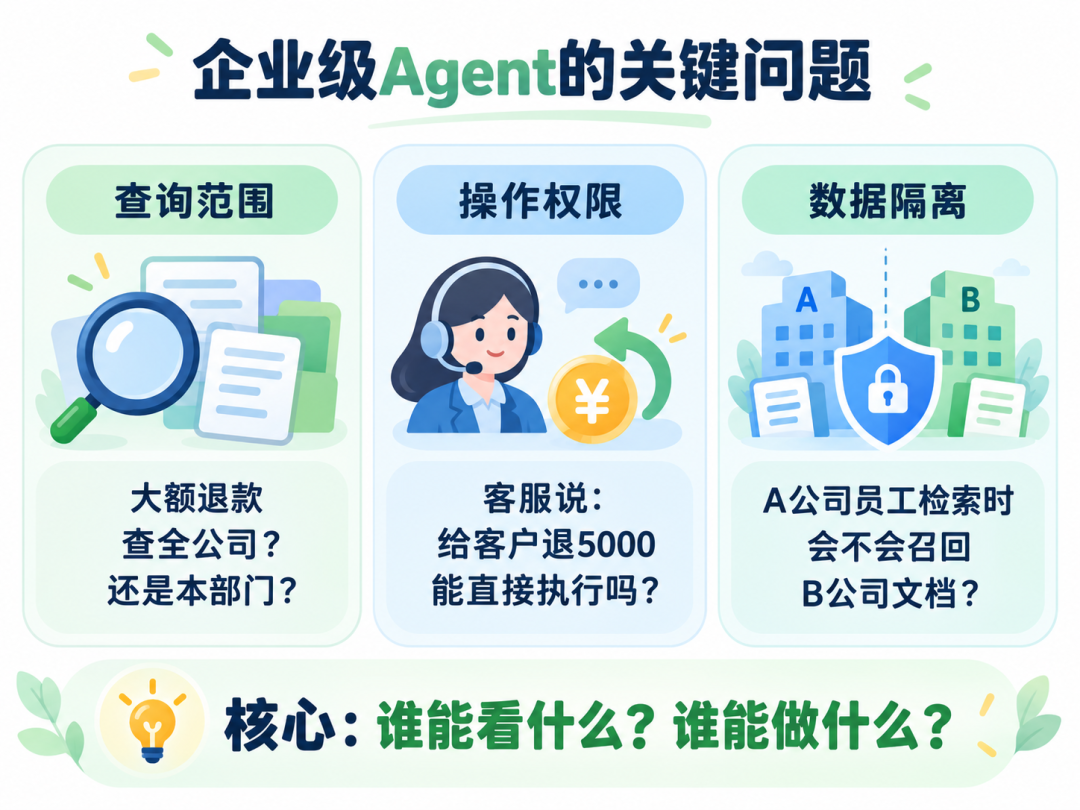
说白了,权限控制要是跟不上,Agent 能力越强,业务风险反而越大。下面聊聊我在实际落地中的一些思考。
01 · 身份认证:先搞清楚当前用户是谁
权限控制的第一步,永远都是身份认证,这是基础。
用户登录 Agent 系统后,后端通常通过 JWT、OAuth2、SSO 等方式拿到当前用户信息,比如 userId、tenantId、departmentId、role 等等。
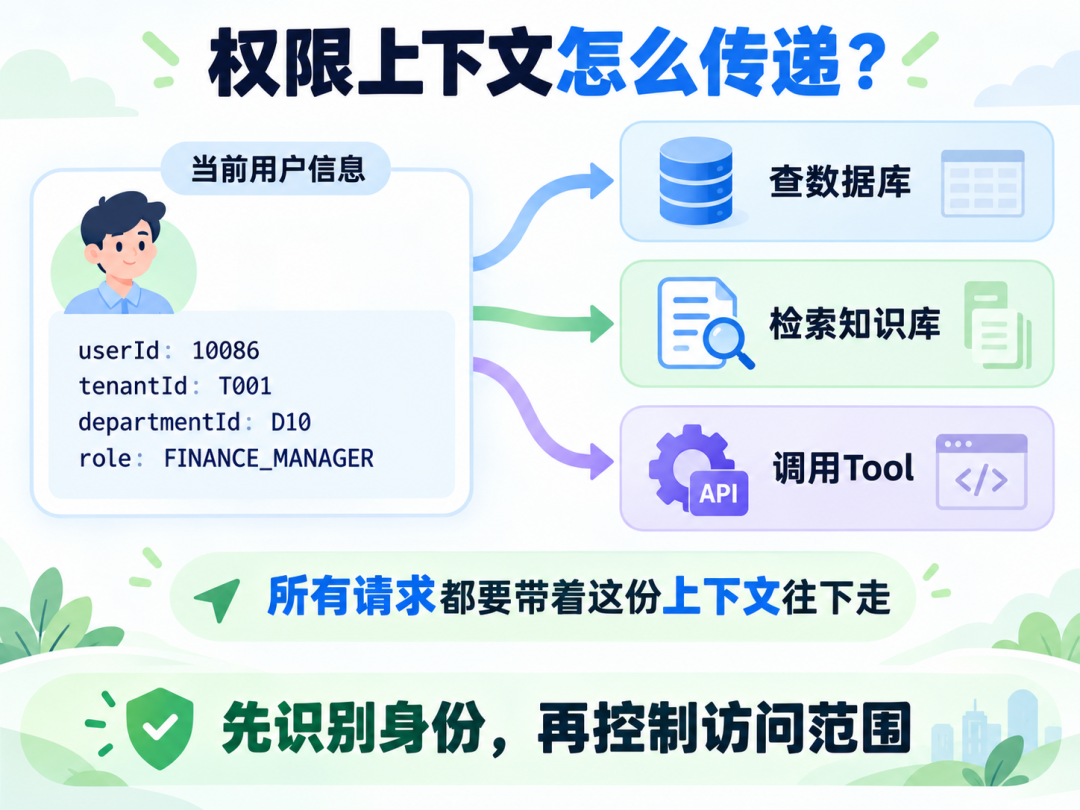
但很多经验比较浅的工程师,特别容易犯这样一个错误:把权限信息都塞进 Prompt 里,然后告诉大模型"当前用户是普通员工,只允许查看自己的数据"。
注意:这么做充其量就是个提醒,不能叫权限控制。Prompt 约束的是大模型的行为,真正的安全边界必须掌握在后端代码手里。
简单来说就是一句话:Prompt 可以提醒大模型别越界,但后端必须保证它想越也越不过去。
02 · 数据隔离:不能等查完以后再做
假设一个企业 SaaS 平台同时服务 100 家公司,A 公司的员工问 Agent:"帮我找一下最近一个月金额超过 1 万元的退款订单。"
这时候 Agent 可能调用订单 Tool,也可能查询 MySQL、Elasticsearch 等系统。最粗糙的实现方式是什么?就是先把符合条件的数据全部查出来,再让大模型判断哪些数据属于 A 公司。
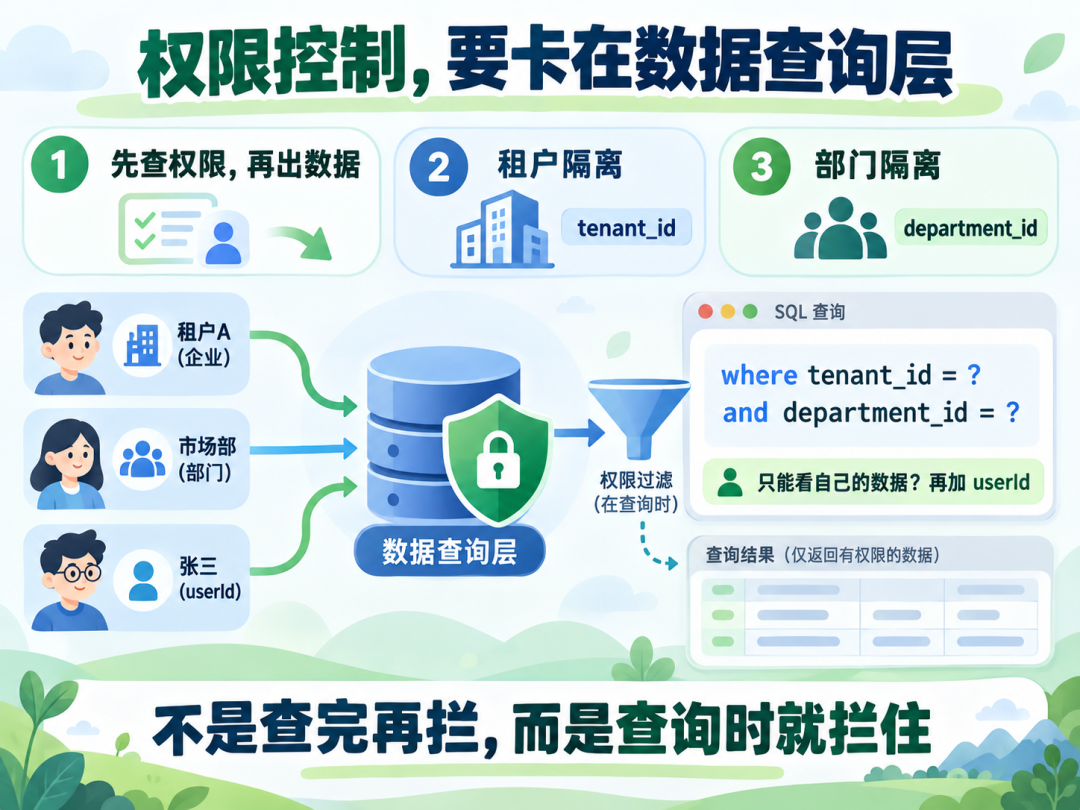
正确的做法是,权限控制必须卡在数据查询层。SQL 查询时直接在 WHERE 条件中带上 tenant_id = ?、department_id = ?;如果用户只能看自己的数据,再加上 userId = ?。没有权限的数据根本不该被查出来。
查询 Elasticsearch 也一样,tenantId、departmentId 等条件应该直接进 Filter。Agent 最终拿到的,应该本身就是一份过滤后的数据,而不是拿到全量数据之后再让大模型去过滤。这个顺序千万别弄反。
03 · RAG 安全:知识库同样会串数据
很多 RAG 项目前期只考虑一个问题:怎么把相关文档召回来。真正到了企业项目里,RAG知识库同样会串数据这个问题就得提前想清楚——那就是:这个用户有没有资格看到这篇文档?
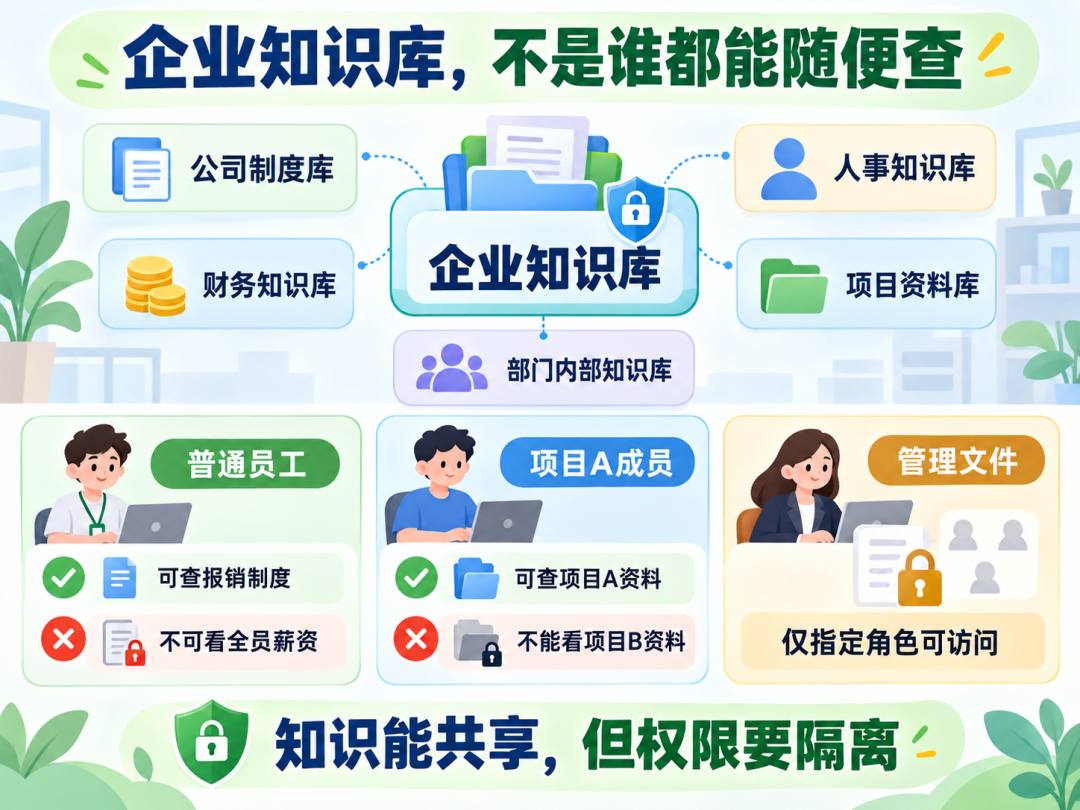
所以文档写入知识库时,除了保存 content、title 和 vector 之外,还需要保存权限控制的元数据,比如 tenantId、departmentId、role、documentLevel 等。后续检索时,就能根据当前用户身份动态生成 Filter。
这样未经授权的文档根本不会进入召回结果,更不会混进 Prompt。这一点非常重要。
数据权限最好在"召回之前"解决,而不是在"大模型回答之前"解决。
如果 Agent 只是回答问题,最坏的结果无非就是答错。但一旦它开始调用 Tool,出问题的严重程度就完全不一样了——创建退款、更新订单、导出客户数据,每一项操作都可能造成真金白银的损失。
所以最好的方式,就是对系统中的 Tool 做风险等级评定和角色权限控制。
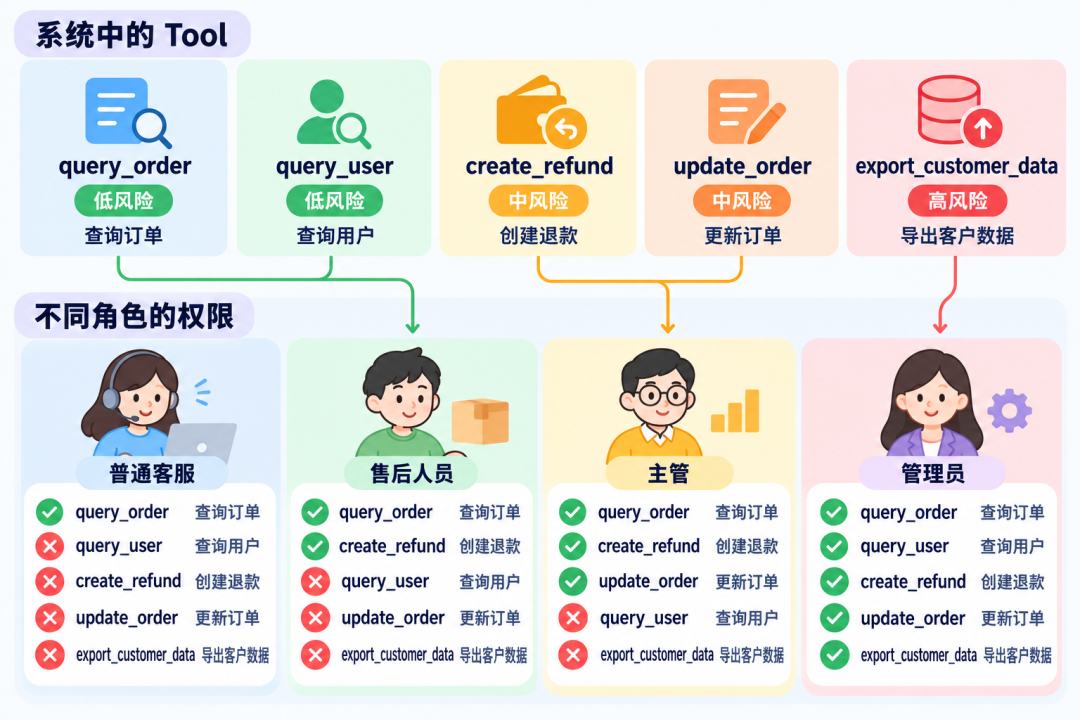
至少需要判断这些维度:当前用户有没有调用这个 Tool 的权限、数据是否属于当前租户、参数是否合法、金额有没有超限、是否需要人工审批。
最核心的一条原则就是:大模型负责决定"想调用什么",后端负责决定"能不能调用",各司其职,各尽其用。
05 · Memory 隔离:不能只当聊天记录看
还有一个特别容易被忽略的地方,就是 Memory。现在很多 Agent 会把历史消息、用户偏好、任务状态甚至长期记忆存到 Redis、MySQL 或向量数据库里。
如果 Memory 只按 conversationId 管理,没有 userId、tenantId 这些隔离维度,就可能出现非常危险的串数据事故。
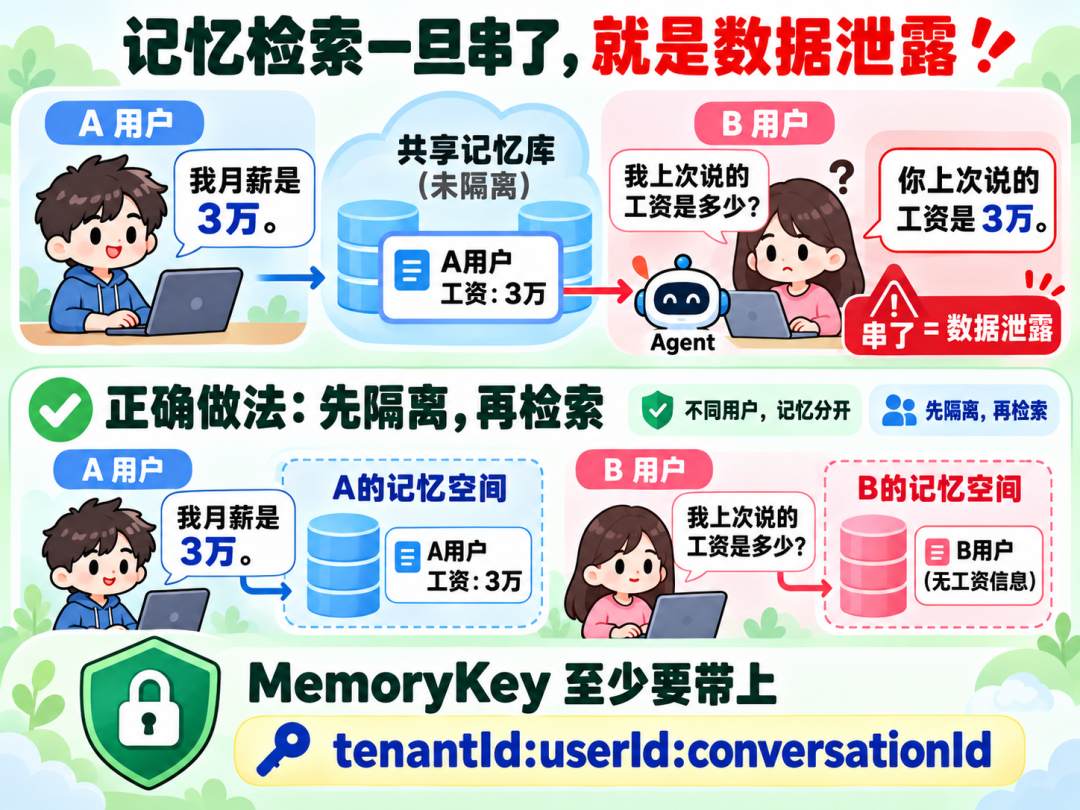
如果企业还存在部门共享记忆、团队记忆,还需要进一步区分个人级、部门级和企业级 Memory。不要把 Memory 只当成"聊天记录"——在企业 Agent 里,它本身就是一类需要权限保护的数据。
06 · 审计:最后一定要留痕
企业系统还有一个硬性要求:一旦出了问题,必须能够回溯。所以 Agent 执行关键操作时,要留下完整的审计记录。
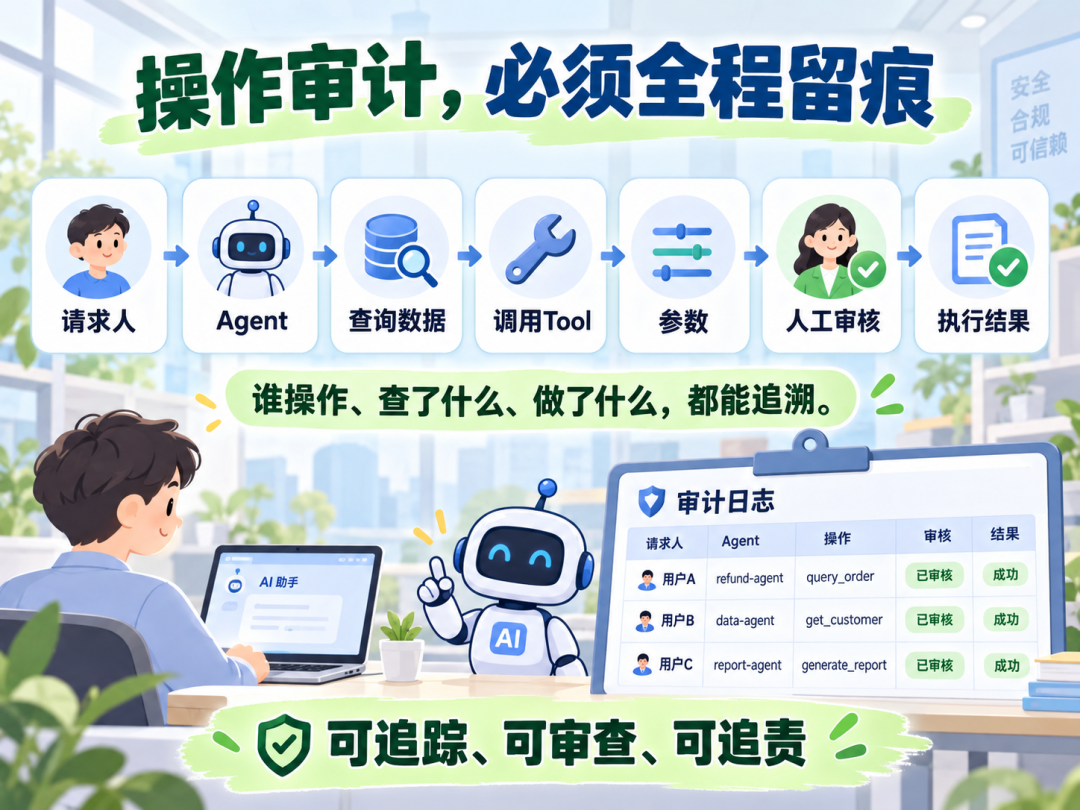
这样以后真的发生越权、误操作或者数据泄露,就能顺着日志把整个执行过程还原出来:谁发起的请求、Agent 查了什么数据、调用了哪个 Tool、参数是什么、有没有经过人工审核、最终结果如何。
总结:权限永远不能交给 Agent 自己决定
个人 Demo 关注的是"Agent 能不能把事情做出来"。企业级 Agent 更关心的则是:"谁让它做的?它看了什么?它做了什么?为什么允许它这么做?出了问题能不能追溯?"
所以企业级 Agent 的权限与数据隔离,绝对不是一个简单的 RBAC 就能搞定的。
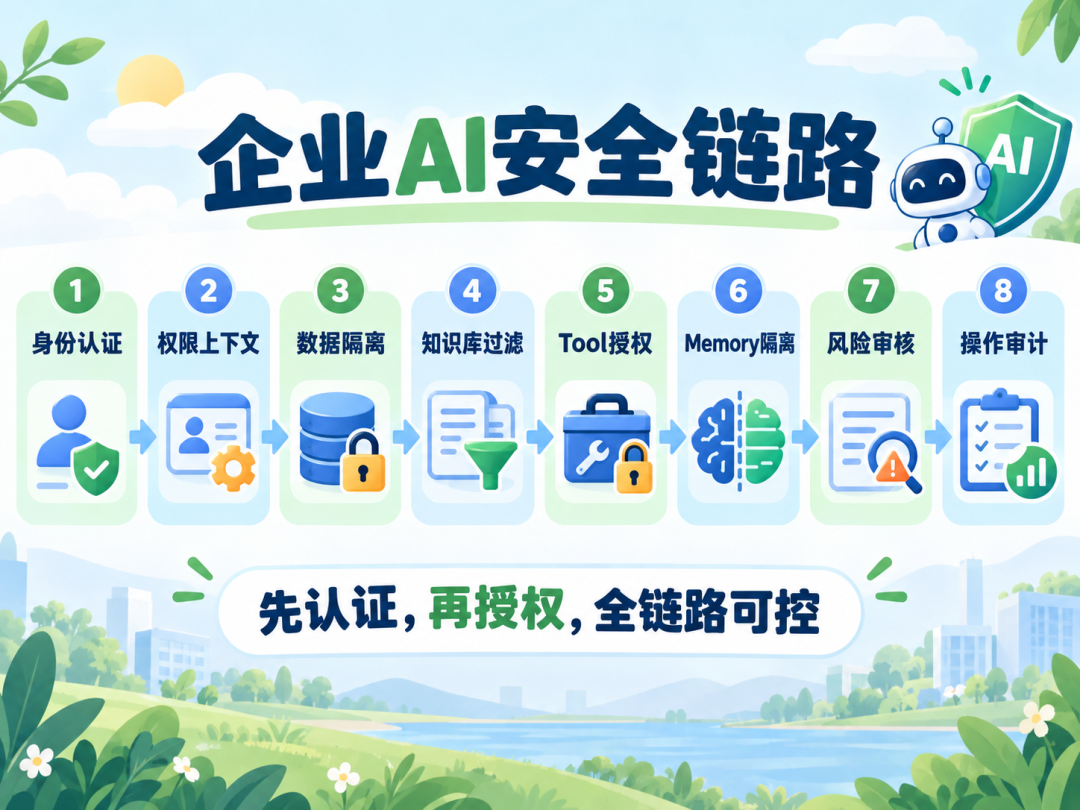
最后记住一句话:Agent 可以越来越聪明,但权限永远不能交给 Agent 自己决定。
在云栈社区上,关于企业级 Agent 落地的讨论一直在持续,欢迎进一步交流。
 发表于 1 小时前
|
查看: 5|
回复: 0


