前阵子在 Google Cloud Tech 上看到一篇挺有意思的文章——《5 Agent Skill design patterns every ADK developer should know》,作者是 Shubham Saboo 和 @lavinigam。他们把市面上大批 SKILL.md 翻了一遍之后,得出了一个扎心的结论:大多数人从第一步就纠结错了地方。
多数人死磕格式:YAML 头怎么写、目录结构怎么摆、规范细则怎么对齐。可问题是,规范只回答了「怎么打包」,从没告诉你「里面的逻辑要怎么组织」。一个封装 FastAPI 惯例的 Skill 和一个四步文档流水线的 Skill,光看 SKILL.md 外表几乎一模一样,内里却是完全不同的两种构造。
眼下 30 多个 agent 工具(Claude Code 也在内)都已经支持 Agent Skills,格式层面大家玩得很熟了,真正的难点变成了:里面装什么。
两位作者把 Anthropic 的仓库、Vercel 的实践、Google 内部规范全翻了个遍,发现不管哪家写 Skill,到头来都会落进五种反复出现的结构。规范解决「怎么打包」,里面装什么逻辑,得靠设计模式来回答。
五种模式总览:Tool Wrapper、Generator、Reviewer、Inversion、Pipeline,全部架在 ADK SkillToolset 之上。
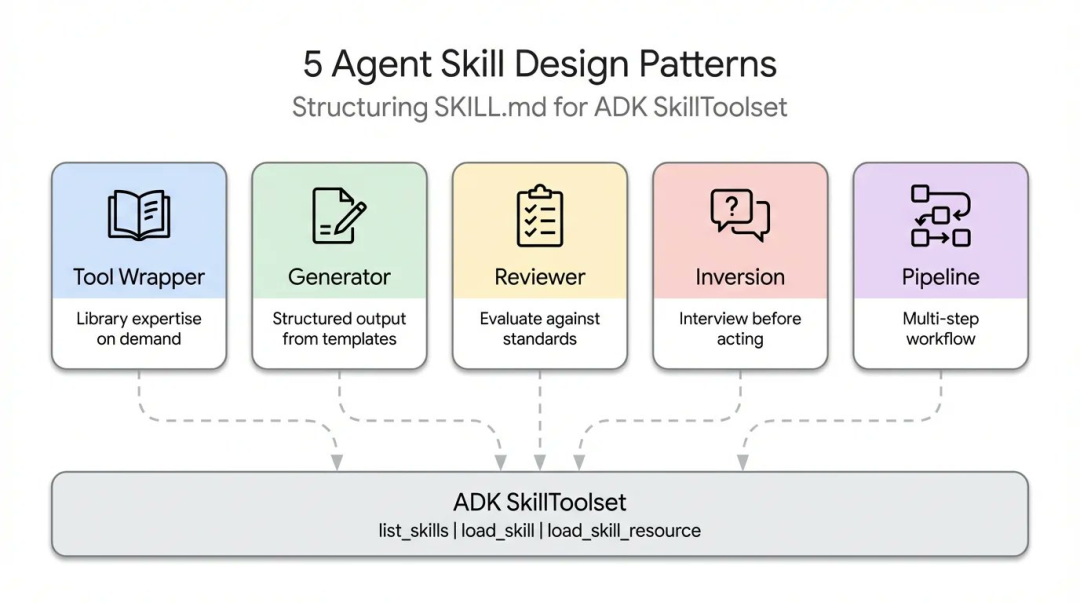
这是五种模式里最轻的一种,本质是给 agent 配一份「某库的按需说明书」。过去的做法是把 API 惯例直接硬编码进系统提示词,结果不管用户问什么,这些规则都常驻上下文。Tool Wrapper 反其道而行:把知识打包成 Skill,由 SKILL.md 盯着用户提示词里的关键词——真碰到 FastAPI 相关任务时,才从 references/ 目录加载内部文档,再把这些规则当作硬约束去执行。
文中的示例叫 api-expert,指令里写得很明确:只在开始 review 或动手写代码时,才去加载 conventions.md。这正是把团队内部编码规范分发到每个开发者工作流里的标准姿势。
把规则封装成 Skill,让 agent 用到才读,算是最省的上下文管理方式。
模式二:Generator,用模板锁死输出结构
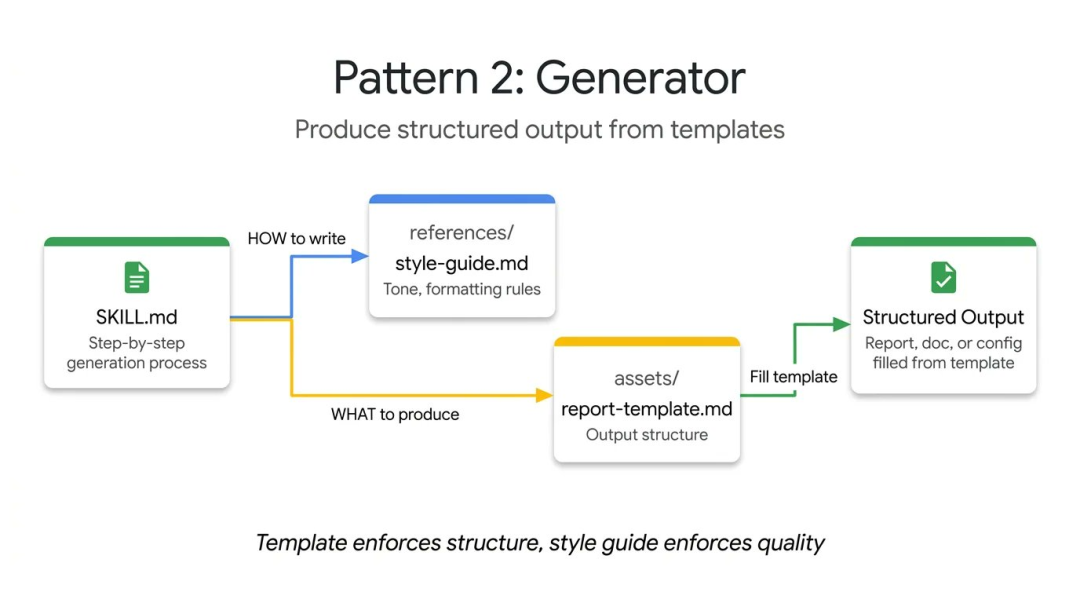
Tool Wrapper 管「给知识」,Generator 管「给格式」。如果你曾被 agent 折磨过——同一个文档每次生成的结构都不一样——这模式就是解药。
它靠两个目录分工:assets/ 放输出模板,references/ 放风格指南。SKILL.md 本身既不写版式也不定文法,只当个项目经理:先加载风格指南,再加载模板,问清用户缺哪些变量,最后照着模板逐节填充,一节都不能少。
示例里的 report-generator 用来生成技术报告,但同样的思路完全可以平移到 API 文档、commit message 规范化、项目脚手架这类「每次都要求长得一样」的活儿上。模板管结构,风格指南管质量,Skill 本身只负责协调。
模式三:Reviewer,查什么和怎么查分开
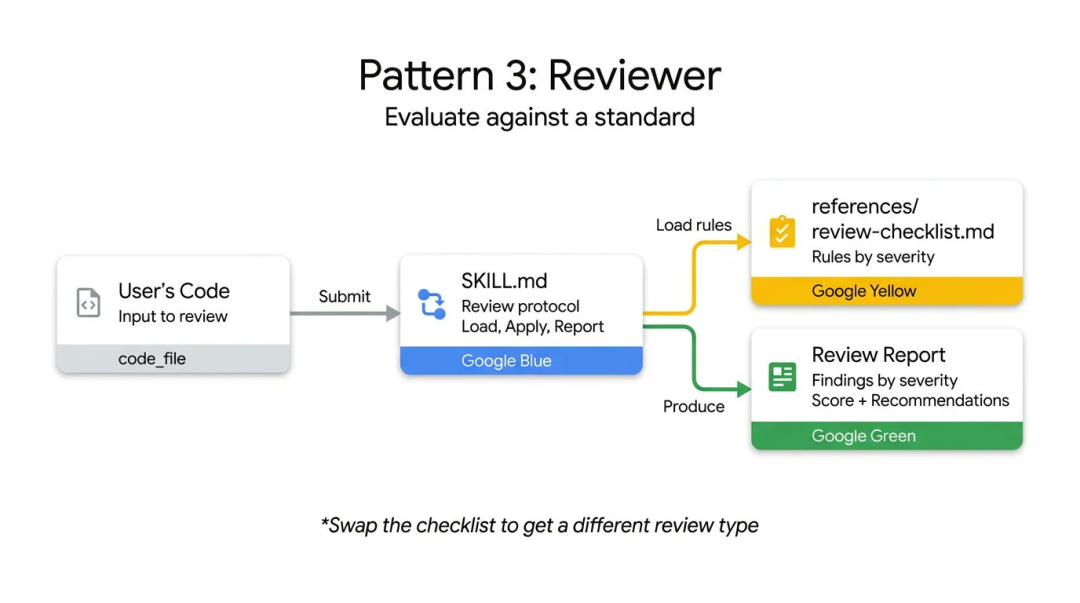
这个名为 Reviewer 的模式把评分规则从主指令里抽离出来,单独放进 references/review-checklist.md。用户提交代码后,agent 先加载这份 checklist,逐条打分,再按严重程度分组输出:error 必须修、warning 应该修、info 可以考虑。
输出格式同样是定死的:先给整体总结,再按严重程度列发现,打一个 1 到 10 的分,最后给出三条最值得改的建议。但这个模式真正的精髓在于「换装」——换一份 checklist,同一套基础设施立刻变成另一种审计。把 Python 风格清单换成 OWASP 安全清单,它就是一次完整的安全审计;拿来跑 PR 自动评审,或是在人肉 review 之前先拦一道漏洞,都很顺手。
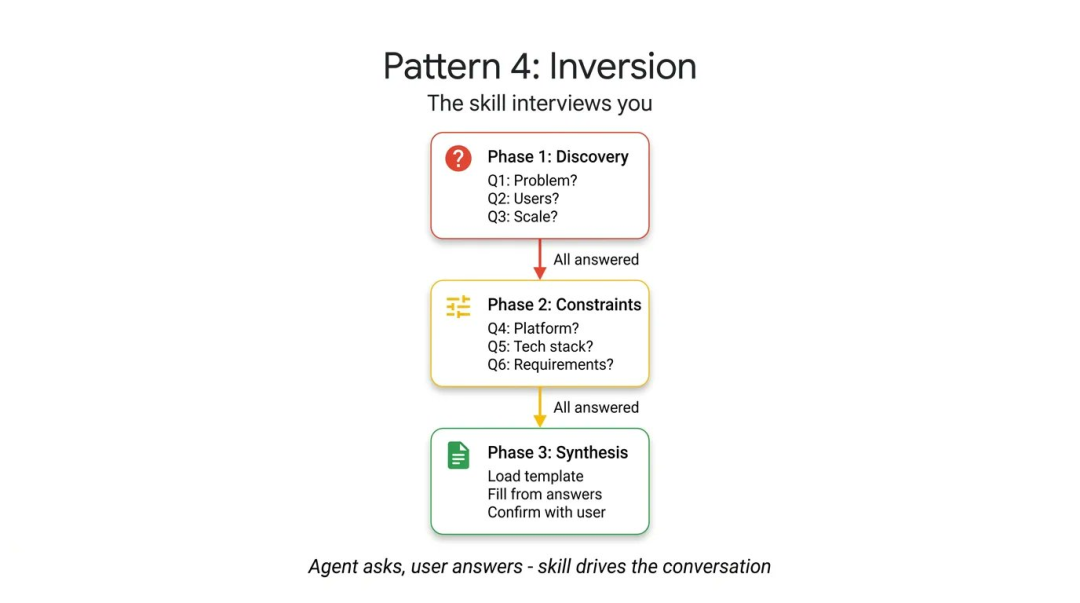
模式四:Inversion,让 agent 先面试你
Agent 天生爱猜,你话还没说完,它可能已经开始输出了。Inversion 模式直接把主动权翻过来,让 agent 当面试官。
实现方式相当硬核:靠一条不容商量的指令按住它——所有阶段完成之前,不许开始构建。接着 agent 分阶段提问,每个阶段把答案收齐,才允许进入下一阶段。
示例 project-planner 拆成三步:先问要解决什么问题、用户是谁、规模多大;再问部署环境、技术栈、底线要求;最后才加载模板、填写、交给你确认,有不同意见就继续改。让 agent 先把需求问明白,它瞎编的概率能降一大半。
模式五:Pipeline,每一步都设门禁
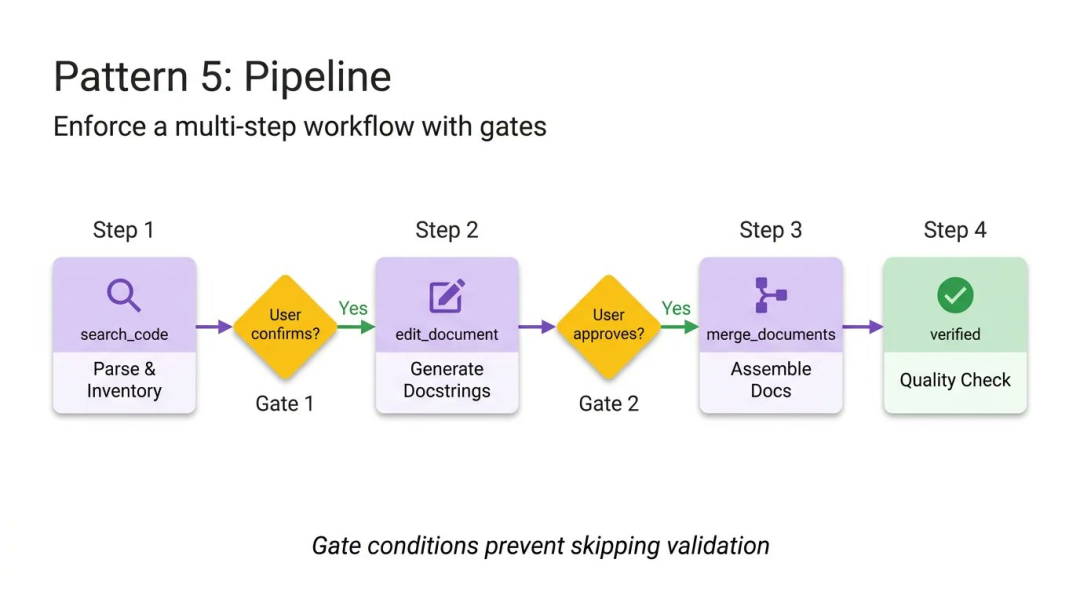
复杂任务最怕跳步。Pipeline 用硬检查点把工作流钉死,指令本身就是流程定义。
拿他们的 doc-pipeline 示例来说,整个流程四步走:解析代码并列出公开 API 清单,先问一句「这就是你要的全部吗」;接着生成 docstring,逐条让用户确认,不确认就不许往下;确认之后才组装文档;最后跑一圈质量检查。两个菱形门禁卡在中间,用户不点头,流程就过不去。
还有个细节很讲究:它虽然用到了所有可选目录,但只在对应步骤才加载需要的参考文件,上下文窗口始终保持干净。靠谱的 agent,靠的是每一步都有门禁。
五种模式怎么选
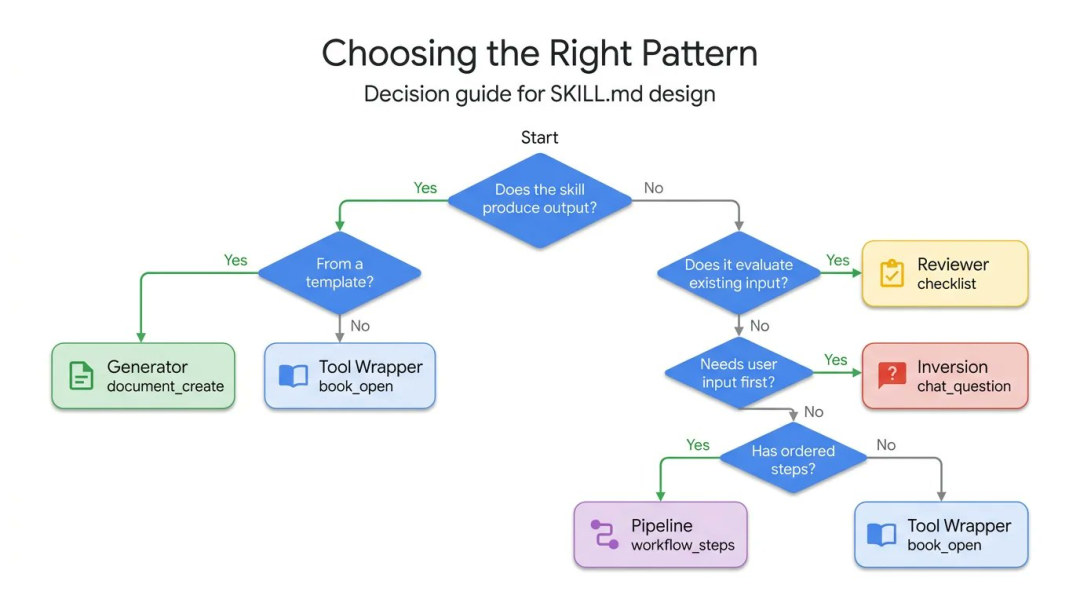
原文给了一棵决策树,我照着梳理一遍。先问这个 Skill 到底产不产出输出?如果产出,再问是不是基于模板来生成——是就用 Generator,不是就用 Tool Wrapper。
如果不产出输出,接着问它是不是在评估已有内容:是,用 Reviewer;不是,再问是否需要先向用户收集信息,需要就用 Inversion。如果这些都不沾,最后看它有没有严格有序的步骤,有就是 Pipeline,没有就退回 Tool Wrapper。
最后,模式可以叠着用
说到底,这五种模式并不互斥。Pipeline 的末尾完全可以挂一个 Reviewer 步骤,让它自己审计自己的产出;Generator 的开头也可以先跑一段 Inversion,把待填变量提前收集好。
因为 ADK 的 SkillToolset 自带渐进披露机制,agent 只会在运行时为当前用到的模式消耗上下文,用不上的部分一个字节都不加载。原文结尾那句话说得够直白:别再试图把复杂又脆弱的指令硬塞进一个 system prompt,把工作流拆开,给每一段套上合适的结构模式,再去构建靠谱的 agent。
 发表于 1 小时前
|
查看: 8|
回复: 0


