现在不少有单片机基础的朋友对端侧 AI 或嵌入式 AI 感兴趣,但刚打开教程就有点懵:Python、神经网络、量化、模型部署、NPU……一堆概念同时涌过来,一时间不知道从哪里下手。
那到底应该先补数学?先学 Python?还是直接买一块带 NPU 的开发板?
我的建议是:选一个能在现有开发板上运行的小模型,从训练一直做到板端输出。在这个过程中,哪里不会补哪里。
学单片机的时候,我们会从点亮 LED 开始,再学定时器、中断和通信。学习端侧 AI 也需要一个类似的“点亮 LED”实验。
一、先确定目的:我们想在什么设备上做什么
手机上运行大语言模型、Linux 开发板做复杂的摄像头识别、STM32 根据六轴传感器判断动作,这些都可以算在端侧 AI 的范围里。但它们的硬件、工具和学习重点相差很大。
如果你已经有了单片机基础,有了项目经验,希望在现有产品中加入声音识别、动作识别或设备异常检测这类更适合做推理的功能,我建议从 MCU 上的 TinyML 开始。本文和文末的路线图,也围绕这个方向展开。
拿动作识别来说:
我们熟悉的部分是:通过 I²C 或 SPI 读取传感器,把数据存进数组,定时处理,再通过串口输出结果。
增加的部分是:把一段数据整理成模型要求的输入,调用推理程序,读取分类结果。
这样你很容易找到学习的起点:只需要理解模型的输入、输出,以及训练得到的文件怎样进入 C 工程就可以了。
刚开始,把两个工作位置分清就够了:
电脑负责处理训练数据、训练和转换模型;
单片机负责采集现场数据,并运行转换后的模型。
云端训练平台可以帮助完成前一部分,设备也可以通过网络上报结果,但第一个实验完全可以在电脑和开发板之间完成。
至于 NPU,可以等到具体模型的性能需求明确以后再选。对于第一个小型传感器模型,优先找你熟悉、能够正常编译和调试、并有对应推理示例的开发板。这样遇到问题时,能减少对下载器、时钟和基础工程的反复排查。
二、先跑通一个小模型,再拆开看它怎么运行
我建议第一个实验用正弦波拟合。输入一个数,输出一个接近正弦值的结果,串口画出来就能看见曲线。
选择正弦波模型主要是因为输入数据好生成、输出结果也好检查,可以集中学习模型的训练、转换和调用。
TensorFlow Lite Micro 的 Hello World 示例就提供了这条训练、转换和推理流程。
1. Python 学到什么程度再开始?
能够读懂这个实验脚本,就可以动手了。
具体包括:
- 看懂变量、循环和函数;
- 知道数组的形状代表什么;
- 能读取文件、画出数据曲线;
- 知道训练函数在哪里调用、模型保存到哪个路径。
遇到不认识的语法,再结合当前脚本去查。暂时用不到的爬虫、网站开发,不必排到这个实验前面。
还有一点,现在 AI 这么强大,不懂的 Python 语法,让 AI 搞定就行。
2. 模型知识怎么学?
模型知识也可以跟着例子学:
输入和输出各是什么,一个隐藏层做了什么,训练为什么会更新权重,损失下降表示什么。至于导数和梯度,先理解它们如何指导参数更新,再随着训练问题深入学习。
3. 完成一整条部署路线
剩下的就是选定一条部署路线。
用 TensorFlow Lite Micro,就学习如何加载模型、准备运行内存、填写输入并调用推理;跟着 STM32 厂商工具链学习,就先沿着对应示例完成模型导入和工程集成。第一轮先把一条路线做完整,后续再比较工具差异。
运行成功以后,做一个很有用的练习:在工程中亲手找到模型数据、输入数组、运行缓冲区和推理函数。 断点停在推理前后,看看输入数值有没有写进去,输出是不是随输入变化。
同时记录软件版本和模型转换命令。换一台电脑、重新建一次工程还能运行,说明环境准备这一步已经掌握。只有串口里出现几个数字,还不足以说明你理解了整个过程。
三、把这张学习路线放在手边
下面把这条学习路线按四个阶段整理出来。每个阶段都有具体产出:学完以后可以用自己的文件、工程和运行结果检查进度。
已经能独立做 STM32 项目的读者,可以快速检查前两个阶段,把时间放在模型流程和完整案例上。遇到不理解的部分,再返回补充对应基础。
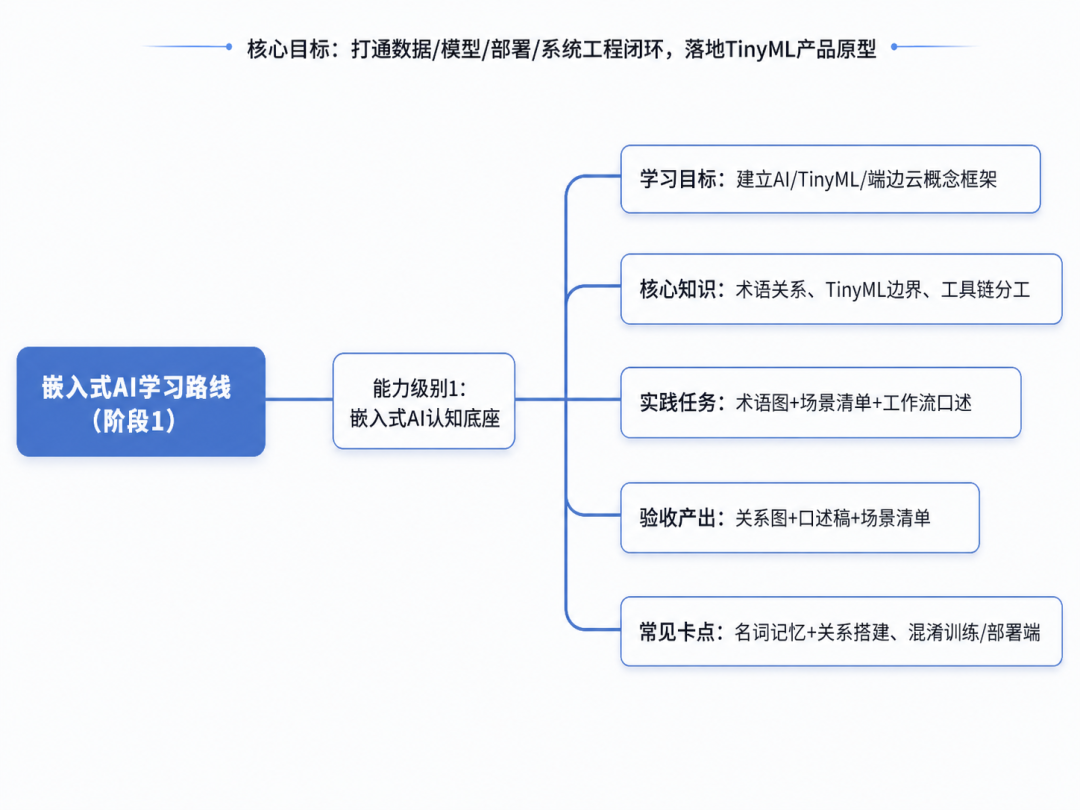
阶段 1:分清概念,选定应用
先能说明模型在哪里训练、在哪里运行,以及打算解决什么问题。图中的场景清单,可以先写你手头最熟悉的一个设备。
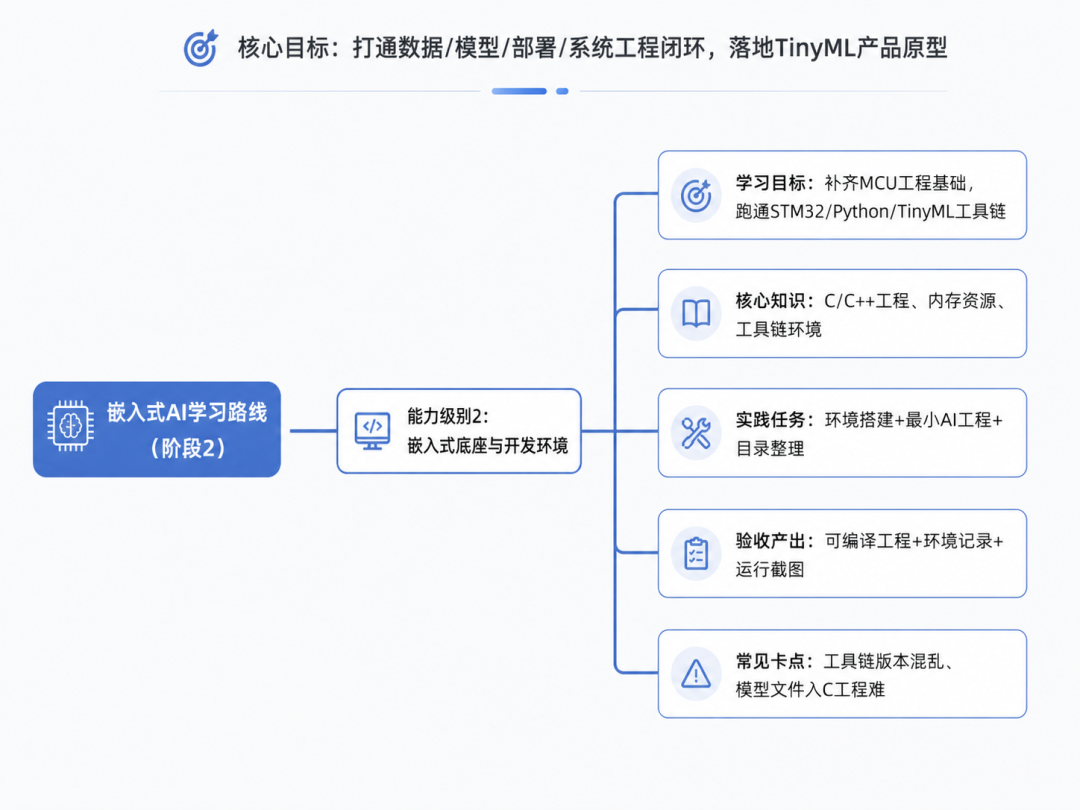
阶段 2:搭好环境,准备能运行的工程
把 C/C++ 工程、Python 环境和部署工具配合起来,保留版本记录、可编译工程与运行截图,方便后续重做实验。
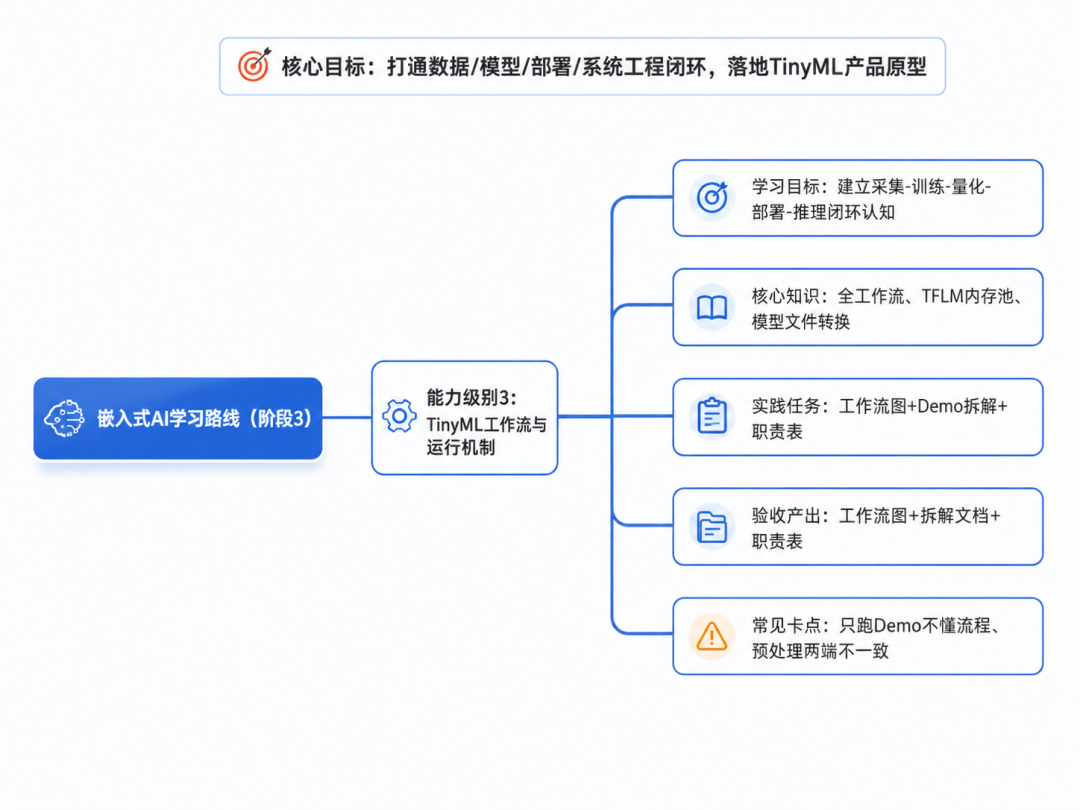
阶段 3:读懂训练到推理的流程
用小模型找到各个文件和函数的作用。TFLM 内存池是使用 TensorFlow Lite Micro 时需要理解的运行内存;采用其他部署方案时,对应查看它的激活缓冲区和工作区。
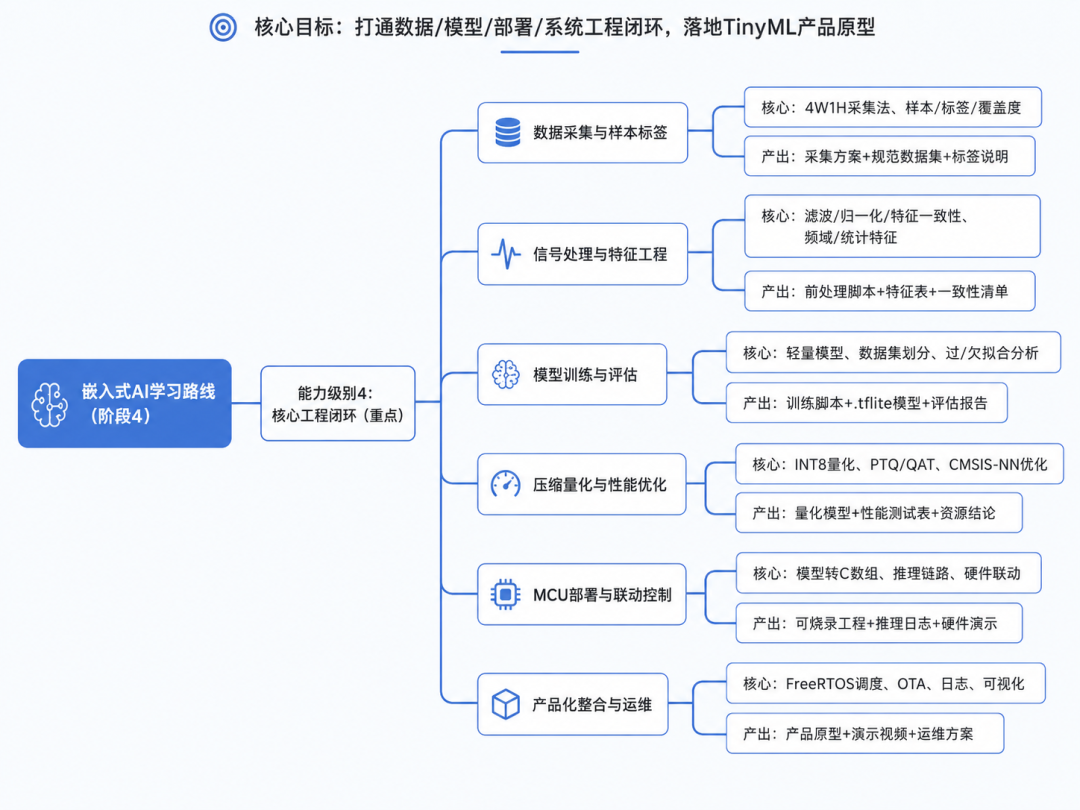
阶段 4:完成自己的 TinyML 项目
沿着图中的顺序,把采集、处理、训练、量化和 MCU 部署放到同一个案例里。项目能运行后,再根据实际需求补充调度、日志和维护功能。每完成一项,就留下图右侧对应的产出。
整个路线走下来,你会发现端侧 AI 的门槛并没有想象中那么高。与其纠结先学什么,不如从一个小模型入手,把训练、转换、部署、推理这条链路完整跑一遍。遇到卡壳的地方,再回头补对应的知识,效率远比漫无目的地刷教程要高得多。如果你也在做 TinyML 相关的项目,欢迎来云栈社区交流分享你的经验和踩坑记录。
 发表于 昨天 04:05
|
查看: 4|
回复: 0


