📖 系列难度说明:本篇为生产扩展,适合已经把 Jev 接进工作流、想知道它为何做出某个选择,以及怎样持续校准与治理的读者。
🎁 核心收获:读完你能为一次 Jev 决策建立最小审计记录,快速区分模型、候选项、外部状态和策略造成的问题,并把日志变成后续评测与成本治理的输入。
Jev 给出了一个很整齐的结果:billing,概率 0.91。
代码据此把工单路由到了账单组。两天后,账单组又把它改派给风控。这个错到底是谁的?是模型没理解用户?候选项边界设计得不好?订单状态没有带进去?还是 0.91 这个高置信度,本来就不可信?
如果系统只保存最终的 billing,你什么也回答不了。
决策模型最大的好处,是输出可以直接进入控制流;它的代价是,每个分支都可能真实改变用户体验、成本和风险。要把它放进生产,不能只记录「模型返回了什么」,还要记录模型看到了什么、系统允许它选什么、最后世界发生了什么。
一次决策不是一个值,而是一条因果链
把 Jev 调用当成一个函数返回值,很容易丢失上下文。更接近真实系统的看法是:一次决策是一条从输入到后果的链。
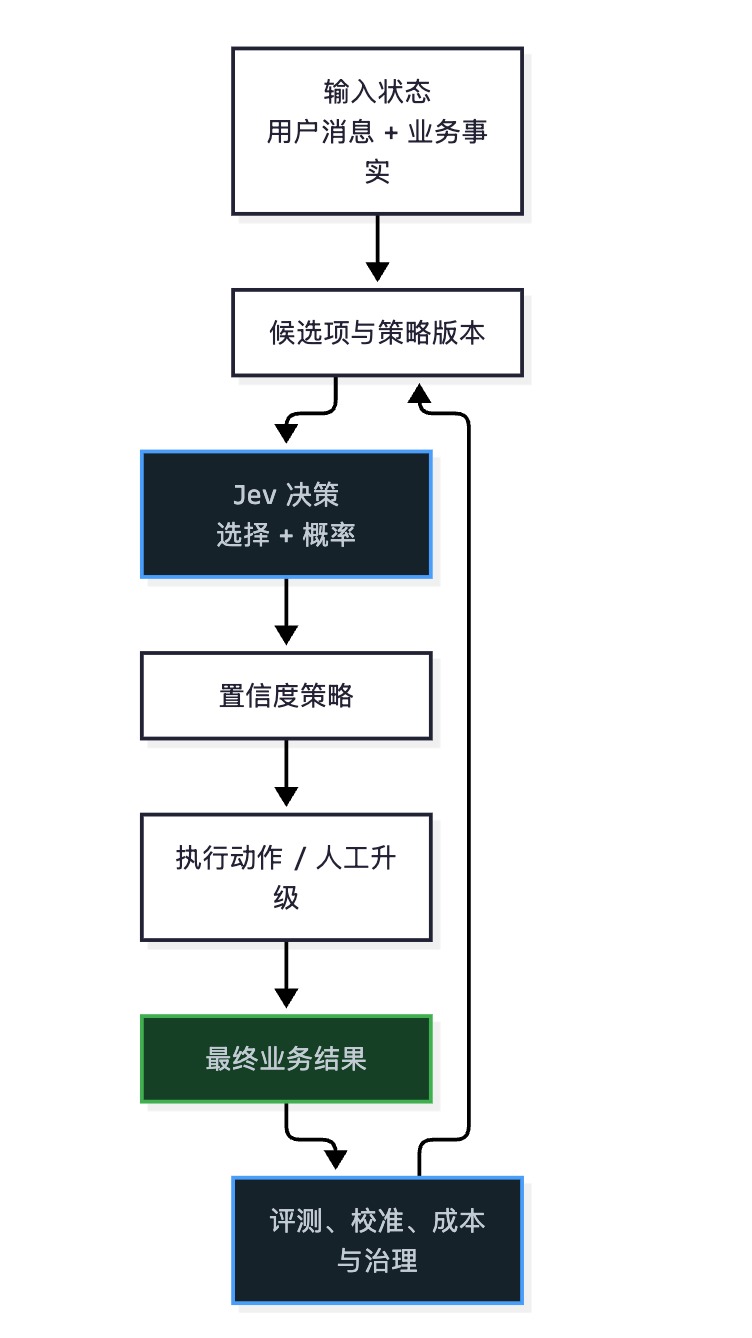
出问题时,任何一环都可能是根因:
- 输入状态缺了订单记录,模型只能从用户文本猜;
- 候选项把
fraud 和 billing 的边界定义得太重叠;
- 阈值策略把本该补证据的 0.78 直接自动执行;
- 下游工具执行失败,模型判断本身其实没错;
- 人工最终改派,也可能是业务规则在事后变了。
所以决策日志的目标不是收集更多字段,而是让系统能回答一句完整的话:
在什么状态下,系统允许模型在什么候选项里选择;模型报了多大把握;策略据此做了什么;最终结果是否支持这次选择。
这句话既是给排障人员看的,也是给未来评测、校准和审计看的。
最小日志:先记住八类信息
刚接入时不需要建一个庞大的可观测性平台。先把最小记录打通,比只打 console.log(choice) 强得多。
| 信息 |
例子 |
为什么需要 |
| 关联 ID |
trace_id、task_id、decision_id |
把一次决策串回完整工作流 |
| 输入摘要 |
用户消息哈希、订单状态版本 |
排查模型到底看到了什么,同时避免滥存敏感原文 |
| 决策定义 |
问题、类型、候选项列表 |
知道模型当时被允许选什么 |
| 版本信息 |
模型、Schema、策略、Prompt/Harness 版本 |
改动后才能比较前后差异 |
| 模型信号 |
choice、各候选概率、置信度 |
判断高置信错误与候选项竞争关系 |
| 策略结果 |
自动执行、补证据、LLM 复核、人工升级 |
区分「模型选择」和「系统最终动作」 |
| 执行结果 |
工具返回码、耗时、重试次数 |
分清下游执行失败和决策失败 |
| 最终真值 |
改派、解决、人工判定、回滚 |
用于校准、评测和复盘 |
可以把它写成一个普通数据结构:
type DecisionAudit = {
  decisionId: string;
  traceId: string;
  createdAt: string;
  modelVersion: string;
  schemaVersion: string;
  policyVersion: string;
  stateSummary: Record<string, string | number | boolean>;
  question: string;
  choices: string[];
  choice: string;
  probabilities: Record<string, number>;
  systemAction: "auto_execute" | "get_evidence" | "llm_review" | "human_review";
  executionResult?: "success" | "failed" | "retried";
  finalOutcome?: "resolved" | "rerouted" | "rejected" | "pending";
};
这里的 stateSummary 很关键。它不等于把所有原始文本和隐私数据永久复制一遍。更好的方式是保留与决策相关的结构化字段、数据版本、脱敏摘要和可受控访问的原始记录指针。可观测性不能以扩大数据暴露为代价。
💡 来源:iajev Playground 与 API 说明 [1] — 一次决策由状态、问题和候选项组成,并返回选择、概率和置信度;页面也建议将决策输入、阈值与最终结果关联保存,以便回看工作流为何走向某条路径。
先区分四类错误,排障才不会乱
一次错误路由很容易被归结为「Jev 不准」。实际上,至少有四类不同问题。
1. 模型判断错了
输入信息足够、候选项定义清楚、下游执行正常,但模型仍选错。这才是狭义的决策错误。
处理方式通常是查看相似失败样本、检查概率是否过度自信、调整候选项描述或阈值,而不是立刻换模型。
2. 候选项或问题设计错了
用户请求同时包含「重复扣费」和「账号异常」,但候选项只有 billing、technical、sales。模型无论选哪个都不完全对。这里问题不在模型能力,而是接口没有给它一个真实可走的动作,例如 fraud 或 human_review。
3. 输入状态错了或不完整
系统没有把「退款已经发起」这个字段带入状态,模型根据用户描述建议补发退款;从它看到的信息看,这个判断可能很合理。根因在数据获取、状态拼装或工具结果,不在决策模型。
4. 策略或执行错了
模型选择 human_review,策略却因为一个错误配置把它映射成自动执行;或者模型正确路由到账单组,但下游队列失败。此时决策信号和最终业务结果不一致,不能拿最终失败直接给模型扣分。
最终失败
   ↓
输入是否完整?──否→ 修数据 / Harness
   ↓ 是
候选项是否能表达正确动作?──否→ 改接口
   ↓ 是
模型选择是否合理?──否→ 改模型、提示或校准策略
   ↓ 是
策略与执行是否按设计发生?──否→ 修配置、工具或权限边界
把这四类问题分开,是从「AI 好像不稳定」走向可维护系统的第一步。
看三张图,比看一条平均准确率有用
前一篇已经讲了准确率、校准、任务完成率和成本。进入生产后,建议把它们做成长期趋势,而不是只在上线前跑一次报告。
图一:候选项流向图
它回答「系统实际把请求送到了哪里」。
输入类型 → Jev 选择 → 系统动作 → 最终队列 / 结果
如果 human_review 突然从 5% 涨到 30%,可能是新模型变保守、数据源缺字段、候选项变得更难区分,也可能是某个业务状态接口失效。趋势本身不告诉你原因,但能让异常尽早浮出来。
图二:概率校准图
它回答「模型的把握值还能不能信」。按 0.1 或 0.05 的概率区间统计预测值与最终正确率。如果高置信度区间的实际正确率持续下滑,应该先收紧自动执行范围,而不是等到整体准确率跌到明显异常。
图三:端到端成本与时延图
它回答「更快的决策有没有让系统更好」。需要同时看:
单任务模型调用次数
工具调用次数与重试次数
人工升级率
从请求到解决的时延
总成本与错误返工成本
Jev 的调用很快,工作流仍可能变慢:因为更多低成本判断让 Agent 走了更多步骤,或因为概率策略把大量案例送进了复核。这不是坏事,但必须被看见,才能判断是否值得。
用「高置信错误」当作最高优先级样本
所有失败样本都应该复盘,但优先级并不一样。
模型报 0.52、随后被人工推翻,通常说明它本来就不确定,系统若已正确升级,风险是可控的。模型报 0.97、系统自动执行、最后造成改派或回滚,则更值得优先处理。
可以按简单的风险分组:
| 样本类型 |
例子 |
优先级 |
| 高置信正确 |
0.95 路由到账单,最终一次解决 |
用于确认自动化收益 |
| 低置信正确 |
0.56 升级人工,人工确认账单问题 |
用于优化策略效率 |
| 低置信错误 |
0.55 复核后发现模型选错 |
用于改候选项或补证据 |
| 高置信错误 |
0.96 自动路由,最终改派到风控 |
最高优先级,检查校准与安全边界 |
高置信错误不一定说明模型整体不好。它可能暴露的是一个漏掉的状态字段、一类新的欺诈表达,或一条过宽的自动执行规则。但它最容易伤害用户,因此应当成为评测集和策略回归测试的常驻样本。
这也让人工审核有了第二层价值:它不仅解决眼前的例外,还在持续生产最值得学习的困难数据。
决策可观测性和成本治理其实是一回事
从表面看,日志是工程问题,预算是管理问题。放到 Agent 里,它们其实是一条链。
没有 decision_id 和 trace_id,你无法把某一笔 Token 成本归到具体产品、工作流和决策分支;没有候选项和策略版本,你也解释不了为什么某次发布后人工升级率上升;没有最终结果,你无法判断多出来的调用是在带来更高完成率,还是只是在制造更多循环。尤其是在 Agent 开发 场景里,一个决策节点看似轻量,却可能驱动起整条工具链的连锁调用。
因此,一个最小的成本归因模型可以是:
产品 / 租户
   ↓
任务 / Trace
   ↓
决策节点
   ↓
模型调用、工具调用、人工升级
   ↓
最终结果、时延与成本
当团队发现某个 Agent 工作流费用上涨时,不要只问「Token 为什么变多」。更值得问的是:
- 是请求量上升,还是每个任务的决策轮次上升?
- 是某个候选项被过度选择,导致工具重试?
- 是模型版本变化后,更多案例进入人工复核?
- 是自动化范围变大,带来了真实业务收益,还是无效调用?
这些问题把「成本异常」重新连接回具体决策。也只有这样,杰文斯式的调用量反弹才不会等到月度账单出来后才被发现。
💡 来源:Do Tuan Anh,《The Jevons Paradox in AI Infrastructure: Efficiency, Rebound, and the Limits of Cost Reduction》— 建议将基础设施、API 用量和按席位订阅统一纳入 AI FinOps,并通过成本归属、预算和总支出 ROI 管理需求增长。
给生产系统加四个报警器
最后,把前面的日志、评测和成本合成四类实用报警。它们不需要一开始就有很复杂的仪表盘,能在异常发生时提醒正确的人就够了——这也是 可观测性 在生产环境里最直接的价值体现。
| 报警器 |
观察信号 |
可能意味着什么 |
第一反应 |
| 质量报警 |
高置信错误、改派率、回滚率上升 |
校准漂移、候选项或数据变化 |
收紧自动执行,抽样复盘 |
| 路径报警 |
某工具或 human_review 被异常频繁选择 |
输入缺失、策略变更、下游故障 |
检查状态字段和候选项边界 |
| 成本报警 |
单任务调用数、重试数、成本突增 |
循环失控、需求扩张、缓存失效 |
限流、熔断、定位 Trace |
| 执行报警 |
工具失败率、权限拒绝、幂等冲突上升 |
下游服务或配置问题 |
暂停自动动作,修执行层 |
注意,报警不等于自动责怪模型。真正成熟的处理流程应先保护用户:降低自动执行范围、保留人工升级、冻结可疑版本;然后再沿着输入、候选项、模型、策略和执行链路逐层排查。
📝 小结
- 一次 Jev 决策应被记录为从输入状态到最终业务结果的因果链,而不是孤立的选择值。
- 最小决策日志要能关联任务、输入摘要、候选项、版本、概率、系统动作、执行结果与最终真值。
- 决策失败至少分四类:模型判断、接口设计、输入状态、策略或执行;不先分类,排障会变成盲目换模型。
- 生产中要持续观察候选项流向、概率校准和端到端成本/时延,尤其关注高置信错误。
- 日志既是调试基础,也是校准、成本归因、预算治理和持续评测的共同数据源。
- 可观测性不是额外装饰:当决策开始影响用户与资金时,它就是自动化系统的一部分。
🔮 后续延伸
到这里,Jev 决策模型的主线和生产扩展已经连起来了。后面如果继续深入,最值得单独展开的方向有三个:
- 用真实业务结果做持续校准与漂移检测;
- 在多 Agent 和长任务中传播、压缩与审计决策状态;
- 将决策日志接入统一的 Agent 可观测性与 AI FinOps 平台。
先别急着把所有能力一次补齐。选择一个候选动作有限、结果能被独立验证的场景,把从决策到结果的这条链记完整,已经是很好的开始。
[1] iajev Playground 与 API 说明: https://iajev.com/
 发表于 12 小时前
|
查看: 0|
回复: 0


