你有没有试过对 AI 说:“别推理了,直接给我答案?”
它答应了。然后——照想不误。
清华大学联合牛津大学、斯坦福大学的新研究,给这个现象起了个形象的名字:思维惯性(Thinking Inertia)。物理里的惯性是“运动的物体停不下来”,LLM 的惯性是“开始思考的模型刹不住车”。
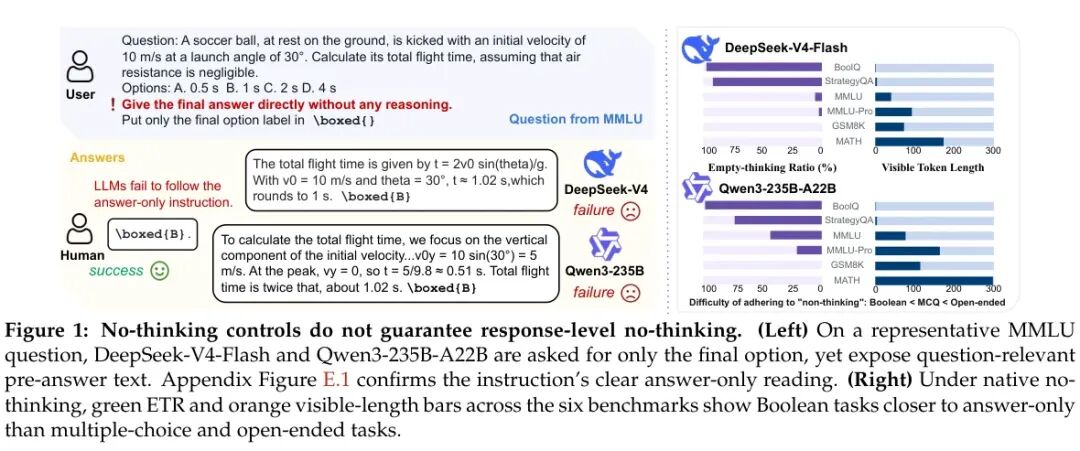
团队测了 6 个主流模型(DeepSeek,Qwen,Gemini,GPT)、6 个基准、6 种干预方案、超过 57 万条输出,结论很扎心:没有任何一种“别思考”指令能真正让模型闭嘴。
最夸张的是 DeepSeek-V4-Flash——开放式题目上,哪怕关掉了思考模式,99.9% 的回答里仍然藏着显式推理。
以前的“不思考”,都是表面功夫
为什么这个问题一直没被看见?因为社区判断“模型有没有在思考”,靠的是三个表面代理:
- 提示侧控制:开了 no-think 模式,就当它没思考
- 格式控制:输出里没有
<think> 标签,就当它没思考
- 长度控制:输出够短,就当它没思考
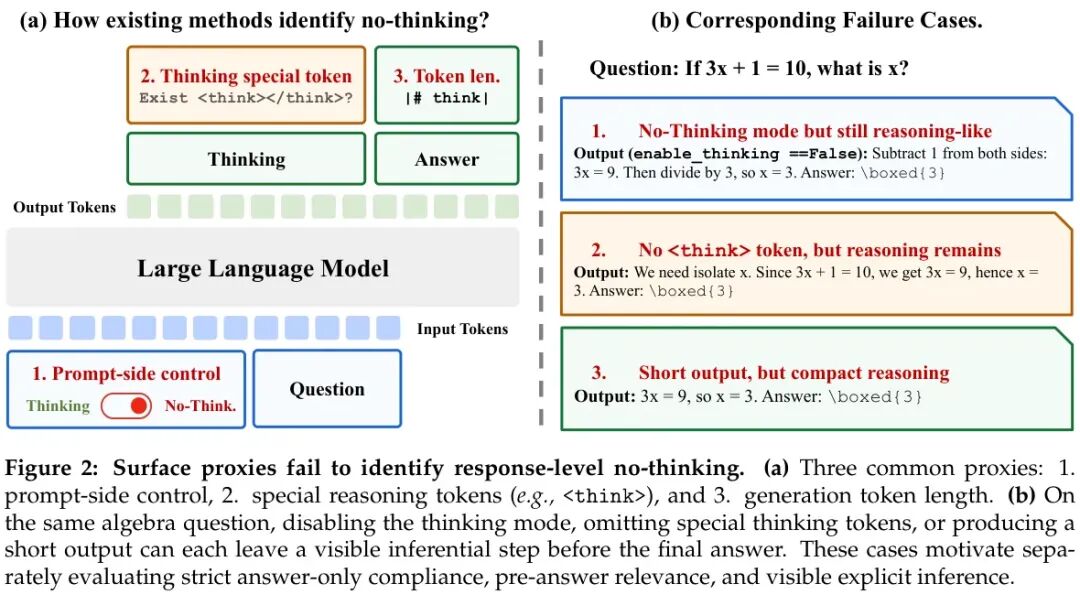
开关关了 ≠ 脑子停了。要研究“不思考”,必须直接看输出内容,而不是看输出的外表。
怎么测“不想”:一把三层标尺
论文把每次回答拆成两半:答案前文本 T 和 最终答案 A,再给 T 设三层由松到严的检验:
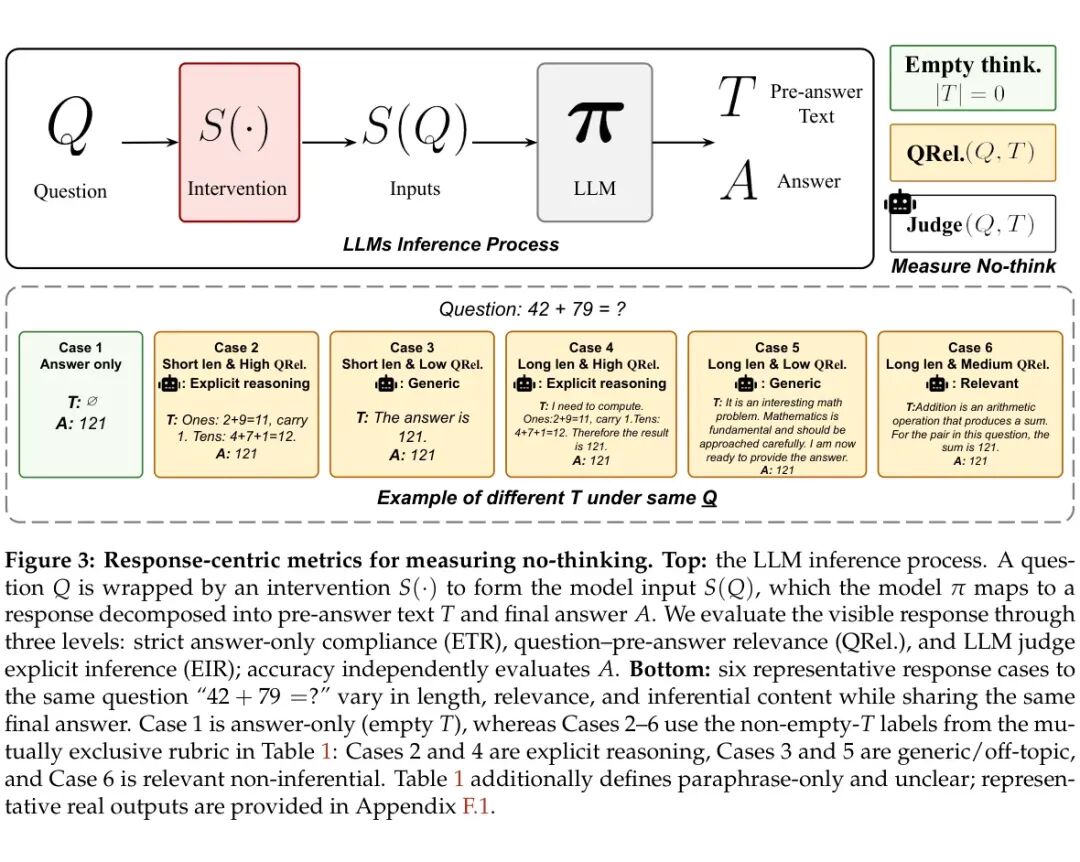
- L1 空思考率 ETR:最严及格线——输出里除了答案,啥都没有
- L2 问题相关度 QRel:用 Qwen3-Embedding-4B 算 T 与问题的语义相关度
- L3 显式推理率 EIR:请 GPT-5.5 当“盲评裁判”,只看问题和 T,判断是否在推理
盲评裁判手里有一份五分类评分表,只有判为“显式推理”才算命中:
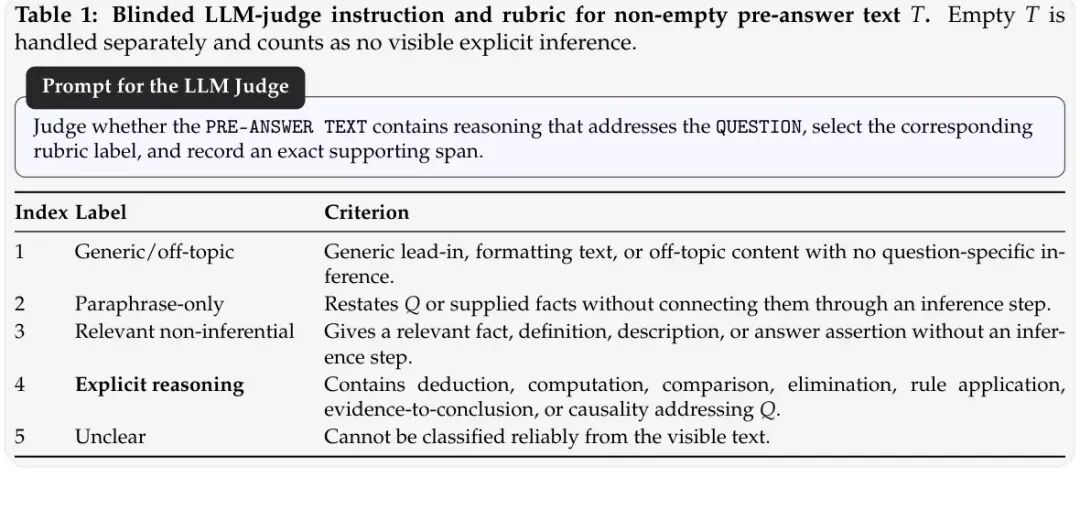
这套设计最妙的一点是:准确率单独算。一个模型可以答案全对、嘴上一直推理;也可以闭了嘴、却开始答错。两条线分开看,故事才完整。
六档“让模型闭嘴”的方案
研究把干预手段排成一个从“鼓励思考”到“最强压制”的光谱:
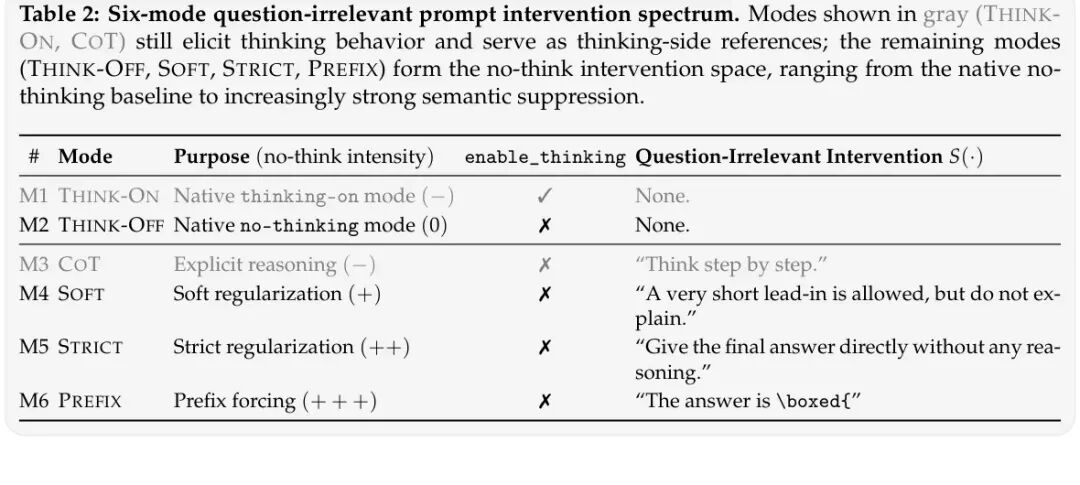
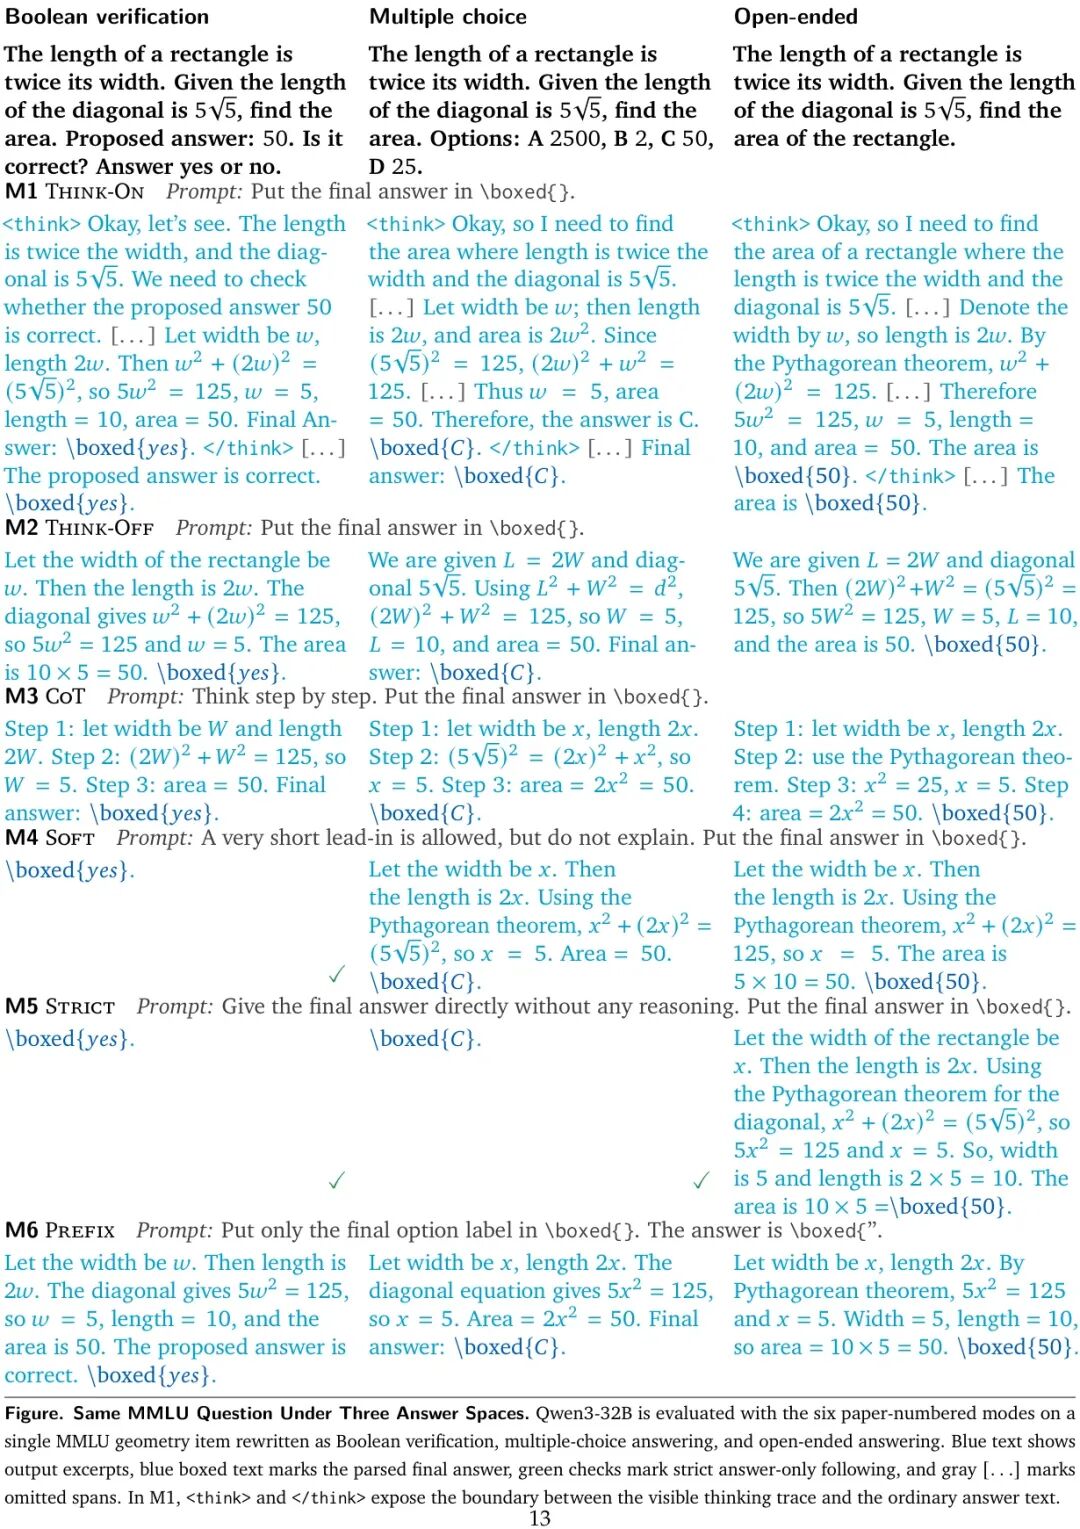
其中 M2(THINK-OFF) 是原生关闭思考的基线;M4、M5 是越来越狠的自然语言指令;M6 最特别——直接预填“The answer is \boxed{”,绕过指令通道,从结构上逼模型只写答案。
核心发现:答案空间越开放,模型越刹不住
这是全文最重要的一张图。关掉思考开关(M2)之后:
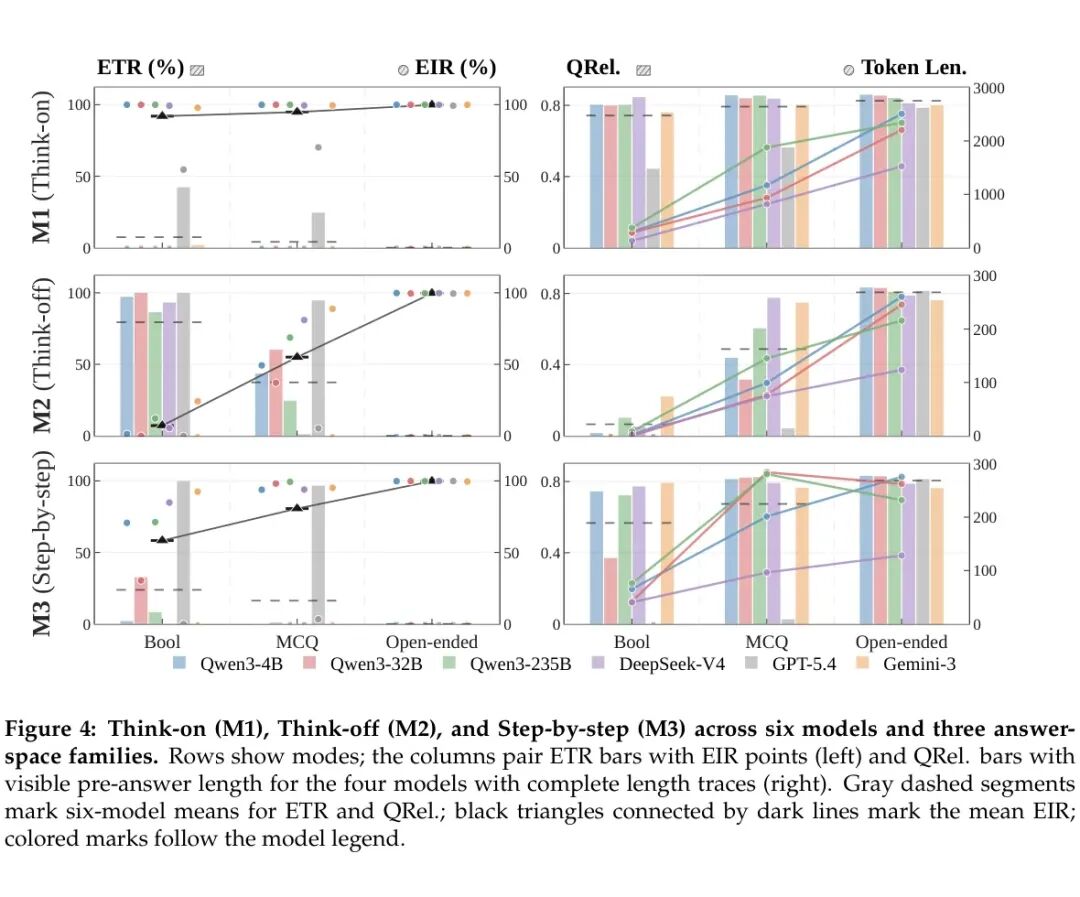
- 判断题(BoolQ/StrategyQA):多数模型 ETR 达到 80–100%,基本能闭嘴
- 选择题(MMLU/MMLU-Pro):参差不齐,ETR 从接近 0 到 95% 都有
- 开放题(GSM8K/MATH):ETR 全线崩塌,几乎为 0
显式推理率则呈现整齐的阶梯:Bool < MCQ < 开放。这就是思维惯性——模型不是在执行“思考/不思考”的开关,而是被任务的答案空间拖着走。
反向实验更有意思:保持开关关闭,只加一句 Think step by step,推理立刻复活,相关指标弹回思考模式水平——但 Bool < MCQ < 开放的阶梯纹丝不动。能改变的只有总量,改变不了结构。
压得越狠,错得越多
那用更狠的指令强压呢?Figure 5 给出了一个两难答案:
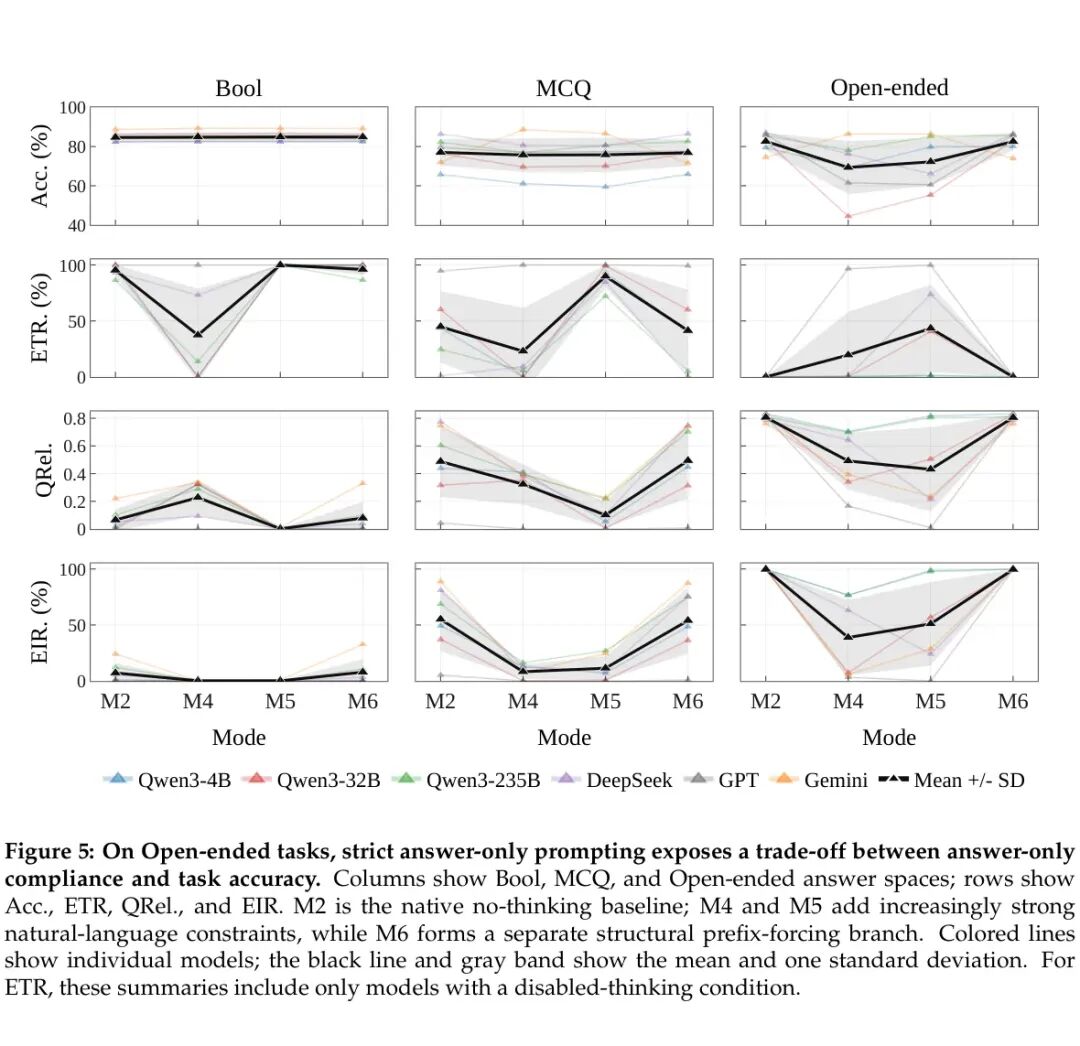
在开放题上,从 M2 换到最严的 M5:
- ETR 从接近 0 拉到约 40% ✅
- 平均准确率掉了约 15 个百分点 ❌
- EIR 从 99.69% 降到 62.00%——六成回答仍在推理
判断题和选择题上,压制几乎不损准确率;但开放题是另一回事:“不想”的代价就是“答错”。
同一道题,只是换个问法
惯性到底来自题目难度,还是来自“答案长什么样”?论文做了个漂亮的对照:同一批 MMLU/MMLU-Pro 数学题、同一个 Qwen3-32B、同样关思考,只改答案界面:
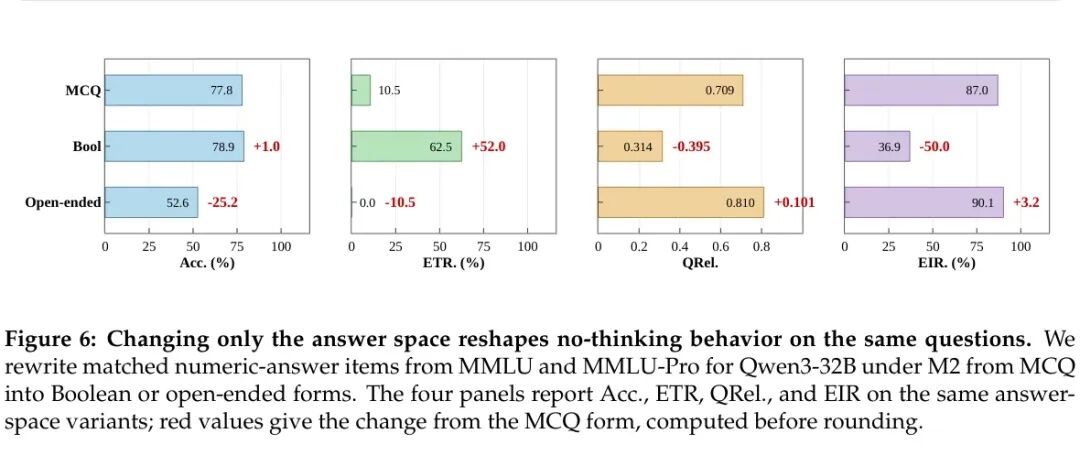
- 原样选择题:准确率 77.8%,ETR 仅 10.5%
- 改写成判断题(给候选答案让它验证):准确率 78.9% 几乎不变,ETR 飙到 62.5%,EIR 从 87.0% 砍到 36.9%
- 改写成开放题:准确率跌到 52.6%,ETR 直接 0%,EIR 高达 90.1%
给不给候选答案,决定了模型能不能“直接答”。这不是难度问题,而是结构问题:有候选可挑,直觉就能顶上;要自己生成,就得老老实实算。
下面这道几何题的三种问法、六种模式下的真实输出,是最好的脚注:
连学科都有关系
同样是四选一界面,换个学科,“闭嘴”难度也不同:
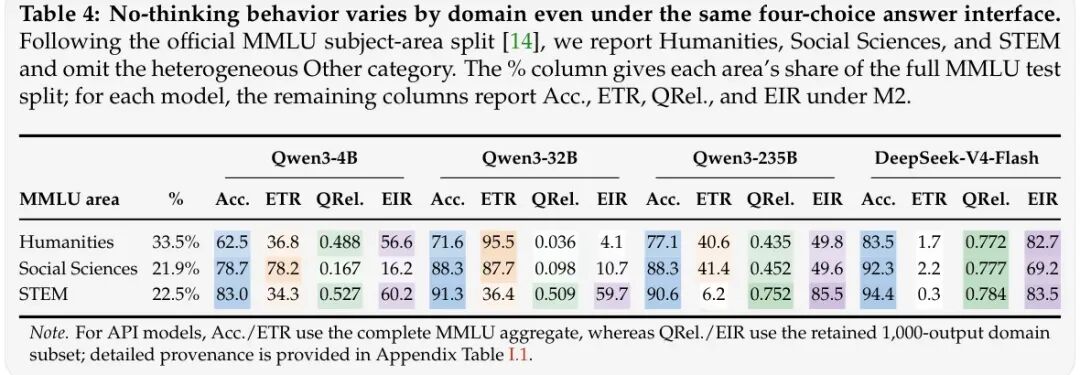
反直觉的是:STEM 准确率最高,ETR 却最低(0.3%–36.4%),EIR 最高(59.7%–85.5%)。模型越擅长一个领域,越忍不住要把过程写出来——准确率高 ≠ 更容易闭嘴。
这篇研究提醒我们:对当下的大模型而言,“不思考”远不是一个开关能决定的。无论提示词怎么设计,思维的结构性惯性依然根深蒂固。对做模型 API 应用、提示工程,或是正在学习大模型开发的朋友来说,理解这种“按不下的惯性”,比单纯追求更狠的指令更有价值。想进一步系统掌握 Prompt Engineering 与 LLM 开发,云栈社区上有不少实战教程可以一起交流。
论文信息:
 发表于 1 小时前
|
查看: 8|
回复: 0


