RocksDB 读路径从最新数据查到最旧数据:依次检查 memtable、L0 和更深层 SST,找到 key 的第一个版本即停止。布隆过滤器用内存检查避免打开肯定不含 key 的文件,块缓存让必须打开的块更便宜,前缀 seek 让特定前缀的范围扫描变快;但墓碑和 merge chain 仍会让范围扫描付出代价。文章用写放大、读放大、空间放大的放大三角解释 LSM 树的取舍,并用可运行示例对比有无布隆过滤器时的 block cache/filter 统计。最后结合 Solana Blockstore 与 RPC 查询模式,说明 slot-first 键设计和 MultiGet 批量处理如何影响真实读性能。
从 key-value store 读取听起来很直接:给一个 key,然后拿到 value。但本系列上一篇文章已经讨论过,这种想法为什么并不成立。LSM trees 做出的取舍是让写入非常便宜,因为它们把组织数据的工作往后推迟了。
读操作必须为此买单。
一个 key 的当前值可能位于 memtable、Level 0 的某个 SST 文件,或者更深任何有序 Level 里。读路径的职责,就是在不必逐个检查所有位置的前提下,找到这个值的最新版本。
本文会展开让这种搜索保持快速的机制,以及衡量其成本的账目。
RocksDB 如何读取一个 key?
RocksDB 中的读取从最新数据到最旧数据进行,在找到 key 的第一个版本时停止。就这样;其他一切只是让这个过程更快。
搜索顺序是固定的,并且镜像上一篇文章描述的写路径,但方向相反:依次遍历 active memtable、immutable memtables、Level 0 的 SST files,以及从 Level 1 往下有序的 SST files。
RocksDB 首先检查 active memtable,因为它保存最新写入、位于内存中,并使用 skiplist。因此,一次查找是一次有序的内存搜索,几乎不产生 I/O 成本。一旦找到该 key,搜索就停止。
在 active memtable 之后,RocksDB 检查所有已写满但尚未 flush 到磁盘的 immutable memtables。它会按从新到旧的顺序检查它们。
然后检查磁盘。Level 0 文件必须逐个检查,从新到旧,因为它们的 key 范围重叠。这是因为每个文件都是 memtable 恰好吸收内容的快照,因此同一个 key 可能同时存在于两个 Level 0 文件中。
每个 Level 0 都是一个 key 可能藏身的独立位置,这正是 Level 0 文件数量会增加读取负担的原因,也是 RocksDB 会暂停写入以保持其有界的原因。
从 Level 1 往下,给定 Level 内的 SST files 是有序且不重叠的,因此每个 Level 最多只有一个文件可能包含该 key。定位那个文件是对文件元数据的二分搜索,然后搜索会下探到文件内部。index block 定位正确的 data block,而 data block 要么包含该 key,要么表明这个 Level 没有它。
Sequence numbers 对 RocksDB 的读路径很重要,因为它们让搜索在找到的第一个版本处停止。这保证这个版本是最新的。例如,如果读取找到一个 tombstone,它就会成功并返回该 key 已被删除。因此,搜索在 tombstone 处结束,并把更旧的值留在磁盘上。
RocksDB 提供哪些读操作?
RocksDB 公开四种读取方式,每种以不同方式使用读路径:Get、MultiGet、Iterators 和 Snapshots。
Get
Get 就是上一节追踪的点查找。也就是说,在从新到旧的搜索中找到一个 key,其中第一个版本胜出。
MultiGet
MultiGet 批量执行点查找。一次读取可以把一组 keys 交给 RocksDB,它会按这些 keys 可能 触及的文件进行排序和分组。
实际上,这帮助 RocksDB 打开单个 SST,并只查询一次其 index 和 filter blocks,同时批量化 I/O。这与 Get 是相同的读路径,但成本被固定并在批次中摊销。
Iterators
Iterators 扫描范围,也就是说它们 seek 到一个 key,然后按有序顺序向前或向后遍历。
实际上,iterator 是一次 k-way merge,也就是说,它把 k 个不同的有序列表合并成一个完全有序的序列。每个活跃数据源——memtable、任何 immutable memtable、每个 L0 文件,以及更深层每个 Level 的一个文件——都贡献自己的有序 cursor,而一个 heap 反复产出持有下一个最小 key 的 cursor。
这种最新版本优先的规则在每一步都适用,因此如果多个源提供同一个 key,最新版本胜出,其余的被丢弃。
随着 iterator 前进,被遮蔽的值和 tombstones 会被跳过,这意味着一个充满已删除 key 的范围,是 iterator 必须默默遍历却不返回任何东西的范围。大量删除的 keyspace 会让扫描以点查找似乎永远不会注意到的方式变慢。
Snapshot
Snapshot 是一个在某个时间点捕获的 sequence number。任何携带它的读取都只是忽略比该数字更新的版本,并返回小于等于该数字的最新版本。这允许一致的时间点读取,实现为一次整数比较。
拍摄 snapshot 实际上是免费的,因为成本会在之后累积;一个 live snapshot 仍然可以看到无法被回收的版本,无论它们有多旧。
Get 和 MultiGet 都确切知道自己想要哪个 key,这意味着搜索可以问一个比“这个 key 在哪里?”更便宜的问题。也就是,“哪些文件肯定没有它?” Iterators 永远得不到这个捷径。回答这个更便宜的问题就是 Bloom filter 的全部工作。
什么是 Bloom filter?
一个 bloom filter 回答关于一个集合的一个问题:这个元素肯定不在其中吗? 答案要么是肯定不在,要么是可能在,从来不是自信的“是”。一个肯定没有某个 key 的文件,就是搜索永远不会打开的文件,从而节省 I/O。
构建 SST 时,它会让每个 key 经过少量 hash functions,每个 hash 在一个紧凑的 bit array(the filter block)中设置一个 bit。
读取时,lookup 以相同方式对要查找的 key 做 hash,并检查那些 bit。如果任何 bit 未设置,该 key 从未被插入,意味着该 key 肯定不在这里。
如果所有 bit 都已设置,该 key 可能 存在——之所以是可能,因为其他 key 的 hash 可能恰好覆盖相同的 bit。
这意味着可能存在 false positives——搜索打开文件、检查,然后什么也没找到,消耗了 filter 本来要节省的 I/O。
在 RocksDB 约每 key 十 bit 的常规设置下,false-positive rate 大约为百分之一。十个 bit 换来 99% 的概率跳过一个缺少该 key 的文件。一个百万 key 的 SST 的 filter 略大于一兆字节,与 index 一起驻留在内存中,并且在不触碰它所保护的磁盘的情况下被查询。系统工程中只有少数结构能以更少代价换来更多收益。
这也是本系列上一篇文章发现 filter block 大小为 0 的原因。Bloom filters 是 opt-in 的,通过 filter_policy 配置,bits-per-key 由应用程序选择,而默认不设置任何 filter。
对于一个不知道自身工作负载的库来说,这个默认值是合理的,但在生产环境中则站不住脚,因为 filter 决定了缺失 key 的成本是每个文件一次内存检查,还是每个文件一次 index-block 读取。
存在的一个限制是,Bloom filters 只有在搜索知道确切 key 时才有帮助。Bloom filter 可以回答 key:0301 是否在这个文件中,但它无法回答这个文件中是否包含 key:0090 和 key:0110 之间的任何东西,因为 hash 破坏了顺序。
Iterators 从不知道自己的下一个 key,因此无法从这个结构获得帮助。Bloom filters 是一项点查找技术;range 密集型工作负载必须到别处寻求缓解。
RocksDB prefix seek 呢?
RocksDB 对扫描问题的部分补救是改变被 hash 的内容。一个 prefix extractor 告诉 RocksDB,key 具有有意义的结构,例如前八个字节,或者分隔符之前的所有内容。一旦 RocksDB 知道什么是 prefix,它就可以基于 prefixes,而不是或同时基于整个 keys 来构建 Bloom filters。一个能回答文件是否包含以某个 prefix 开头的 key 的 filter,可以帮助 iterator。
然而,这个捷径只适用于一个 prefix。
对给定 prefix 的扫描可以像点查找一样跳过文件和 blocks。一个跨越一个 prefix 进入下一个 prefix 的扫描则得不到同样的帮助。如何跨 prefixes 维持迭代顺序保证,值得对使其成为可能的配置细节进行一场深入探讨。
Prefix seek 并不会让 range scans 在一般情况下变得便宜。
相反,它让某个特定且极其常见的 range scan 形态在给定 prefix 下变得便宜。
什么是 RocksDB block cache?
Block cache 是未压缩 blocks 的内存缓存。当从 SST 读取一个 data block 时,它会被解压并保留,因此下一次需要同一个 block 的读取无需触碰磁盘即可找到它。这意味着热 key 聚集在热 blocks 中,而热 blocks 不再产生 I/O 成本。
因此,Bloom filters 试图让搜索不进入文件,而 block cache 让必须进入的文件在再次访问时变得便宜。
一个微妙之处是存在两个 cache。
Block cache 是 RocksDB 自己的,保存它显式管理的未压缩 blocks。在它之下是 操作系统的 page cache,保存 RocksDB 最近读取的原始、压缩文件页。同一份数据可以同时占据两者,也就是说,在 block cache 中未压缩,在 page cache 中压缩。这就是为什么 RocksDB 的真实内存占用长期被低估,以及为什么忽略 page cache 的 cache 大小讨论只考虑了系统的一半。
Index 和 filter blocks 得到特殊待遇。它们很小,在几乎每次到达其文件的读取中都会被查询,而且未命中代价极其高昂,因此让它们常驻几乎是不可谈判的。
它们是位于 block cache 的预算之内,还是位于其外、在 table readers 自己的内存中,是一个配置选择,也就是 cache_index_and_filter_blocks。
tombstone 和 merge chain 给读操作带来什么成本?
Tombstones 和 merge chains 是来自写路径的记录类型,它们影响读路径,但只能由 compaction 来结算。Tombstones 会不断累积,直到 compaction 丢弃它们和被它们遮蔽的尸体;merge chains 会不断增长,直到 compaction 将它们折叠成已结算的值。
对于一个找到 tombstone 的点查找来说,tombstone 很便宜。也就是说,搜索停止并给出答案,因为“已删除”是一个有效结果。然而,iterator 不能在 tombstone 处停止。相反,它必须解析 tombstone,跳过它遮蔽的版本,并继续前进直到找到下一个 live key。大量删除的 keyspace 是一片雷区,其中的条目必须在返回空结果的同时被遍历和丢弃;对它进行扫描可能需要做大量任意工作却产出很少。点查找从不会注意到这一点,而 range scans 对此毫无防御能力。
Merge operands 产生同样的账单,但方向相反。对合并 key 的读取不能在最新记录处停止,因为 operand 是变更的 描述,而不是一个值。所以,搜索必须持续收集 operands,直到它到达一个完整值、一个 tombstone 或树的底部,然后通过 merge operator 折叠这条链。
上一篇文章的走查折叠了一条长度为三的链,但请注意,设计中的任何东西都没有把链限制为三。一个在两次 compactions 之间被合并一万次的 counter,就是一次收集并折叠一万个 operands 的读取,而写路径没有做任何事来阻止它。
放大三角
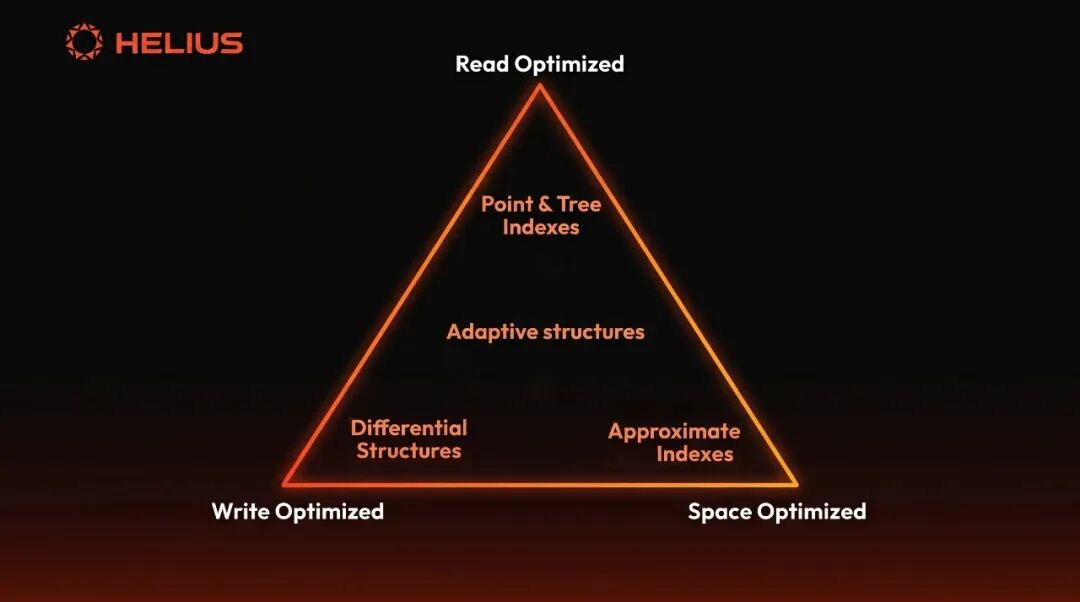
The amplification triangle 是支配每个 LSM tree 的三方权衡:write amplification、read amplification 和 space amplification。改善任意两个都会使第三个恶化。
Athanassoulis 等人将这些权衡形式化为 RUM conjecture (2016),该猜想认为一种访问方法最多可以最小化 read overhead、update overhead 和 memory or space overhead 中的两个,而第三个吸收成本。B-trees 位于一个位置,也就是读便宜、更新昂贵;而 LSM trees 位于另一个位置,也就是更新便宜、读昂贵。这个三角描绘了两者之间的领域。
本文中的所有内容都是这个三角的一个角在为自己辩护。
Write amplification 是物理写入磁盘的字节数与应用程序逻辑写入的字节数之比。一次 Put 会被写入 WAL 一次,flush 到 L0 时写入一次,并且每次 compaction 将其带到下一 level 时再写入一次。这意味着在一个有十几个 levels 的 leveled LSM 中,一次逻辑写入在其生命周期内通常可能变成十到三十次物理写入。上一篇文章赞美其中每一次写入都是顺序的,而本文则为它哀叹。
Read amplification 指的是查询为了找到答案而必须检查的位置数量。对于点查找,最坏情况是每个 memtable、L0 文件,以及更深层每个 level 的一个文件,也就是本文开头追踪的搜索,而实际成本则是经过 Bloom filters 和 block cache 后剩下的部分。对于 range scan,它是同时保持每个源打开的 k-way merge。Read amplification 在很大程度上就是本文所涵盖的内容:filters、caches 和 prefix extractors 作为支付它的机制发挥作用。
Space amplification 是磁盘消耗量与所存储逻辑数据量之比。等待 compaction 的旧版本、tombstones 及其遮蔽的尸体、未折叠的 merge chains,以及 live snapshot 钉住的每个版本,都会为应用程序再也无法读取或不再想要的数据消耗磁盘空间。调优良好的 leveled compaction 会将其保持在 1.1x 附近,而其他安排则要付出高得多的代价。
这个三角认为,改善任意两个角都会使第三个恶化。也就是说:
- 激进地 compact:读取变得更快,空间变得更紧,但每个 key 都会被不断重写,write amplification 攀升
- 懒惰地 compact:写入顺畅,但文件堆积起来等待读取检查,死数据滞留在磁盘上
- 把内存花在 filters 上:caches 和读取得以恢复,但内存是三角各角都在竞标的安静第四资源
没有标着“快”的设置。只有在三角上匹配或不匹配给定工作负载的位置。
读路径走查
下面复用上一篇文章走查中的项目,并启用统计信息。
将 src/main.rs 的内容替换为:
use rocksdb::{BlockBasedOptions, Options, DB};

fn main() {
    let with_bloom = std::env::args().nth(1).as_deref() == Some("bloom");
    let path = if with_bloom { "/tmp/read-bloom" } else { "/tmp/read-nobloom" };

    let mut opts = Options::default();
    opts.create_if_missing(true);
    opts.enable_statistics();

    if with_bloom {
        let mut bbt = BlockBasedOptions::default();

        bbt.set_bloom_filter(10.0, false);
        opts.set_block_based_table_factory(&bbt);
    }

    let db = DB::open(&opts, path).unwrap();

    // 三个 L0 SST,范围完全重叠:文件 b 保存 key % 4 == b 的 key,
    // 全部跨越 0..600。key % 4 == 3 的 key 不存在于任何地方
    for batch in 0..3u64 {
        let mut k = batch;

        while k < 600 {
            let key = format!("key:{:04}", k);
            db.put(key.as_bytes(), b"value").unwrap();
            k += 4;
        }

        db.flush().unwrap();
    }

    // key:0404 只存在于最旧的文件中,这意味着搜索必须越过
    // 两个更新的文件才能到达它
    let hit = db.get(b"key:0404").unwrap();
    println!("get(key:0404) = {:?}", hit.map(|b| String::from_utf8(b).unwrap()));

    // key:0303 在每个文件的范围内,且不在任何文件中
    let miss = db.get(b"key:0303").unwrap();
    println!("get(key:0303) = {:?}", miss);

    if let Some(stats) = db.property_value("rocksdb.options-statistics").unwrap() {
        for line in stats.lines() {
            if line.contains("bloom.filter.useful")
                || line.contains("bloom.filter.full.positive")
                || line.contains("block.cache.data") {
                println!("{}", line);
            }
        }
    }
}
上面有三个已 flush 的 L0 文件,它们的 key 范围完全重叠,因此仅凭范围元数据无法排除任何文件,因为每个文件都是这两个 keys 可能藏身的地方。
命中,也就是 key:0404,只存在于最旧的文件中,迫使从新到旧的搜索在处理两个不包含它的文件之后,才能到达包含它的那个文件。
未命中,也就是 key:0303,位于每个文件的范围内,且不在任何文件中。这意味着除了 Bloom filter,没有任何东西能拯救那次读取。
按原样运行它,然后再带参数 bloom 运行。
没有 filters 时,输出是:
get(key:0404) = Some("value")
get(key:0303) = None
rocksdb.block.cache.data.miss COUNT : 3
rocksdb.block.cache.data.hit COUNT : 3
rocksdb.bloom.filter.useful COUNT : 0
我们要用六次 data-block 访问来回答两次查找。命中从三个文件各读取了一个 data block,其中两个没有帮助,成本为三次磁盘读取。未命中随后检查了同样的三个文件,而它的三次 data-block 访问之所以是 cache hits,只是因为第一次查找刚刚预热了 cache。Block cache 完成了它的工作,而且它是唯一完成工作的东西。
有 filters 时,输出是:
get(key:0404) = Some("value")
get(key:0303) = None
rocksdb.block.cache.data.miss COUNT : 1
rocksdb.block.cache.data.hit COUNT : 0
rocksdb.bloom.filter.useful COUNT : 5
rocksdb.bloom.filter.full.positive COUNT : 1
我们总共有一次 data-block 访问。我们可以手动验证 useful 为 5 的算术:
- 命中查询了最新文件的 filter 和第二个文件的 filter,两者都返回 no。最旧文件的 filter 返回了那一个
full.positive,并被证明是 true positive。这给我们两次跳过
- 未命中查询了所有三个 filters,并得到三个 no,这意味着我们有三次跳过,零个文件被打开
把命中和未命中相加,我们得到五次文件检查。这五次由 filter 从内存中回答的文件检查,就是 no-filter 运行时必须执行的五次 data-block 读取。所以,每 key 十 bit 把六次 block 访问变成了一次。
这实际上是小规模的 amplification triangle。no-filter 运行全额支付了 read amplification,filtered 运行在内存中支付它,也就是每个文件几百字节的 filter,而写路径两种情况下都没有付出任何代价。RocksDB 中的每个调优决策都是这个权衡在更大规模上的体现。
Solana 如何压测读路径?
上一篇文章把 validator 描述为写路径的压力测试。也就是说,shreds 以线路速率持续不断地进来。读侧是这笔交易的另一半,因为一个没人能读回的 ledger 只是一种昂贵的加热数据中心的方式。
本文关于搜索顺序、filters 和 key 设计的每一个论断,都会在 Solana 数据实际被查询的方式中体现出来。
在 validator 内部,Blockstore 的读取有两种不同形态:服务 repair requests,以及 replay 或流式传输一个 block。
服务 repair requests 意味着其他 validators 正在请求它们错过的 shreds。这是按 (slot, index) 进行的点查找。Replay 或流式传输一个 block 的 ledger,是对给定 slot 的 range scan。
因为 shred keys 以 slot 编号开头,一个 slot 的每个 shred 都在磁盘上连续存放,所以“给我 slot n”是一次紧凑的顺序 iterator 遍历,而不是分散的点读取。
写路径中的 key 设计就是读路径优化。也就是说,让 flushes 产生几乎不重叠的 L0 文件的同一 slot-first 布局,让 block 读取成为一次单一连续扫描。
RPC 层会问更难的问题。getTransaction 是按 signature 到 transaction-status 数据中的点查找。这正是 Bloom filters 存在的情况,因为给定 SST 中不存在的 signature 应该只需一次内存检查就能排除,而不是一次 index 读取。
getSignaturesForAddress 是本文前面提到的 prefix 形态扫描。address-to-signature index 以 address 开头,因此一个账户的整个历史占据一个连续的 key 范围,而一个地址的全部活动就变成了该结构擅长处理的 range scan 形态。
然而,应用程序实际提出的问题位于两者之上。没有用于“给我这个地址的所有 transactions”的原语。这类问题会变成对 signatures 的 prefix scan,然后对每个 signature 做一次 point lookup 以获取 transactions。
实际上,一次 range 查询会展开成数百或数千次 Get,这正是 MultiGet 的批处理所存在的工作负载。也就是说,对 signatures 排序,按它们触及的文件分组,并对每个文件的 index 和 filters 只查询一次。
从外部看像一次 API 调用的查询,在读路径上,就是本文描述的所有机制依次开火:iterator、prefix ordering、Bloom filters、batch amortization 和 block cache。
我们构建了那个 API 调用。
历史上,开发者必须运行一个客户端循环:getSignaturesForAddress 和 n 次 getTransaction 调用,还要带上 n+1 模式最终总需要的重试逻辑。
getTransactionsForAddress 把这个循环折叠成一个单一方法,并带有各种与本文讨论的读路径机制相匹配的特性。
升序和降序排序顺序就是 iterator 的两个方向。基于 cursor 的分页会返回一个形式为 slot:position 的 token,这是一个 key position,因此恢复分页查询就是重新 seek 一个扫描到上一次停止的位置。Slot 和 time filters 会限制工作量,而不是事后丢弃工作。
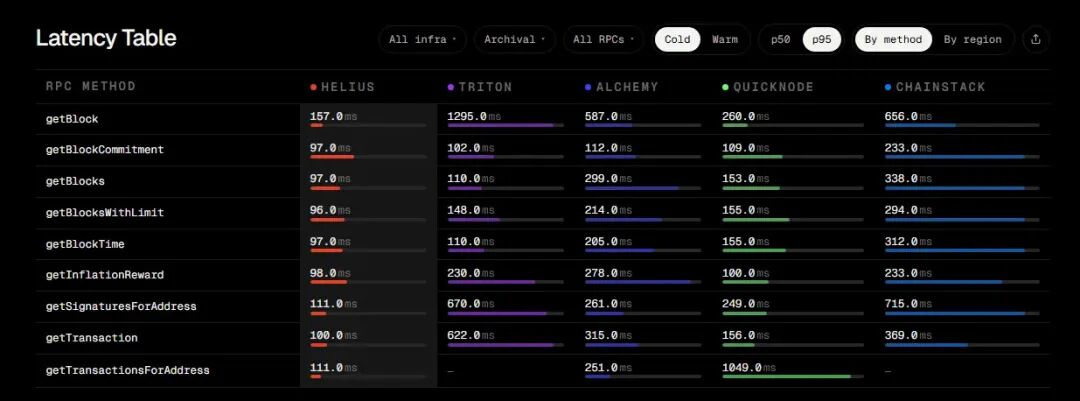
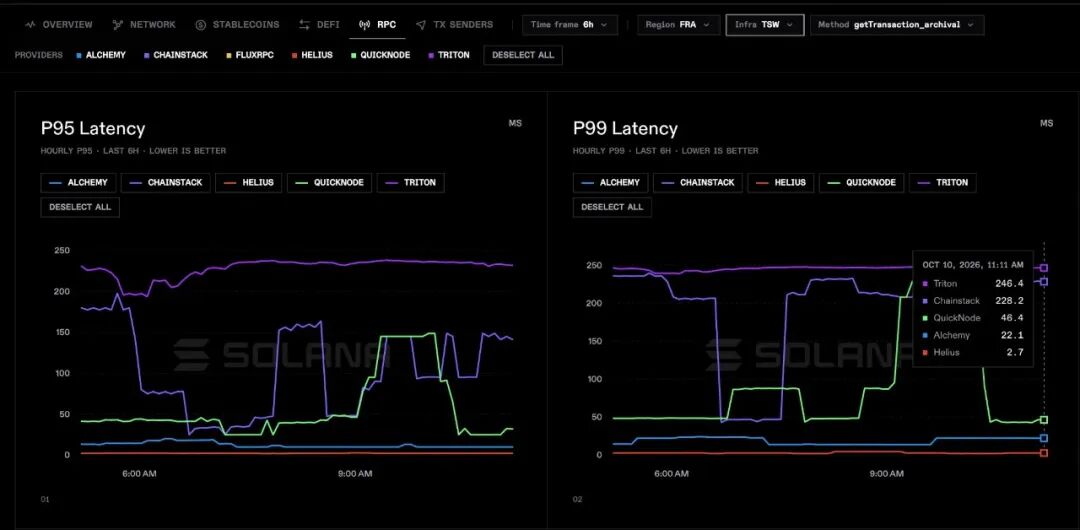
服务该方法的 archival system 在 RocksDB 中保存 Solana 的完整 transaction 历史——数百 TB。我们将它从 ClickHouse 迁移到 RocksDB,这也是本系列存在的原因:这些文章所描述的存储引擎,就是我们逐 column family 调优的引擎,以使一个账户的整个生命周期成为一次连续扫描,并让 signature lookup 成为一次内存检查。这就是为什么我们拥有整个 Solana 中性能最高的 archival system。
结论
读路径是 LSM tree 的还款计划,而本文将其呈现为一份逐项列出的账单。一次 lookup 从新到旧遍历,穿过 memtable、L0 和所有有序 levels,并在找到的第一个版本处停止。其他每个特性和工具的存在,都是为了最小化该搜索所需的触碰次数:Bloom filters 从内存中回答某个 key 是否肯定不在某个文件中,使那个文件保持关闭;block cache 让必须打开的文件在重新打开时变得便宜;prefix 设计把唯一可负担的 range scan 形态变成应用程序实际需要的形态。
The amplification triangle 是记录这一切的账本:读取成本用内存偿还,写入成本以顺序分期更早支付。空间成本则在搜索跨过的每个 tombstone 和被遮蔽版本中悄悄累积。
请注意,本文中的每个结构都只是 管理 累积文件、死版本和未折叠 merge chains 的成本。本文涵盖的内容实际上都没有移除它。移除它的东西在后台持续运行,而决定它运行得有多激进,是 RocksDB 中唯一最重要的调优决策。本系列下一篇文章是 compaction:它做什么、RocksDB 提供的三种风格,以及为什么 Solana 的 Blockstore 以切换风格然后又切回来而闻名。
原文链接:helius.dev/blog/rocksdb-...
 发表于 3 小时前
|
查看: 6|
回复: 0


