高通最新的 Snapdragon X2 Elite 采用大小核混合架构。其中的 Performance Core 虽然叫“性能核心”,实际扮演的却更像效率核心,负责轻量任务、后台负载,以及多线程场景下的吞吐补充。
这颗核心最高运行在 3.6GHz,采用 4-wide 乱序执行架构。与同芯片中更宽的 Prime Core 相比,前端规模明显收缩;但从微架构测试看,高通并没有让后端资源跟着简单缩水。
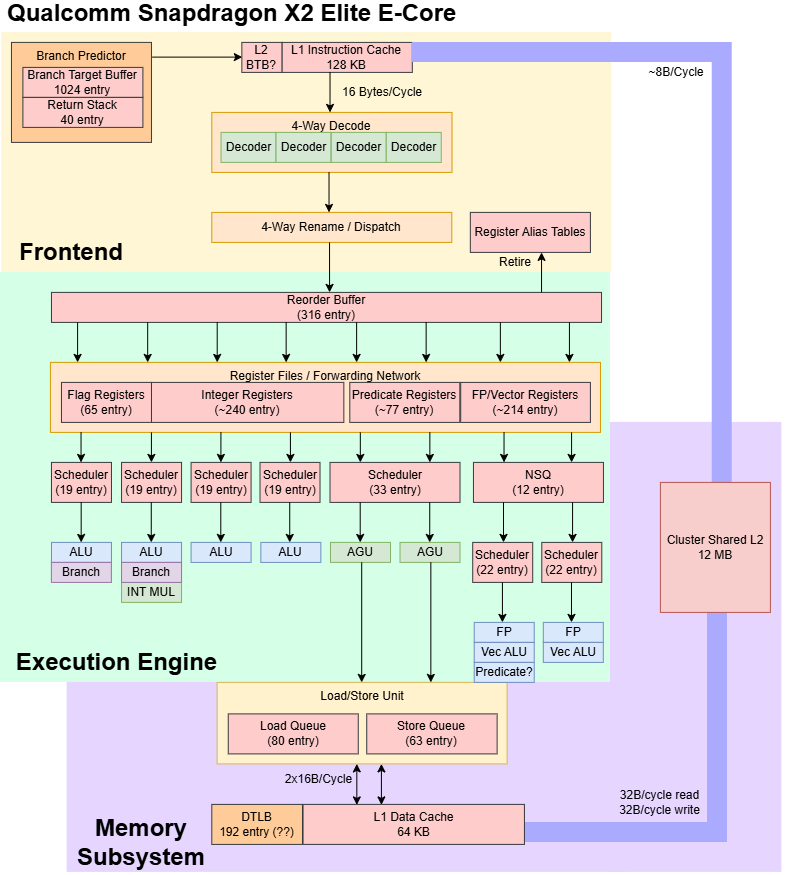
Oryon 小核心(E-Core)的完整微架构框图:BTB 1024 项、128KB L1 指令缓存、4-wide 译码与重命名、316 项 ROB、约 240 项整数寄存器堆、4 个 ALU 端口、双访存管线、64KB L1 数据缓存,以及 12MB 集群共享 L2。来源:Chips and Cheese。
它拥有 4 条整数 ALU 执行端口、2 条浮点/向量执行端口、2 条访存流水线,乱序执行资源也相当充足。L1 指令缓存达到 128KB,L1 数据缓存为 64KB。
为什么前端只有 4-wide,后端配置却如此充足?
01|4-wide 限制了什么?
CPU的宽度决定了流水线每周期能够处理多少条指令。更宽的前端当然能带来更高指令吞吐,但译码、寄存器重命名、依赖检查和调度等环节也会更复杂。
以寄存器重命名为例:同一组指令里,后面指令可能依赖前面结果。每周期处理指令越多,需要检查的依赖关系越多,硬件复杂度随之抬高。
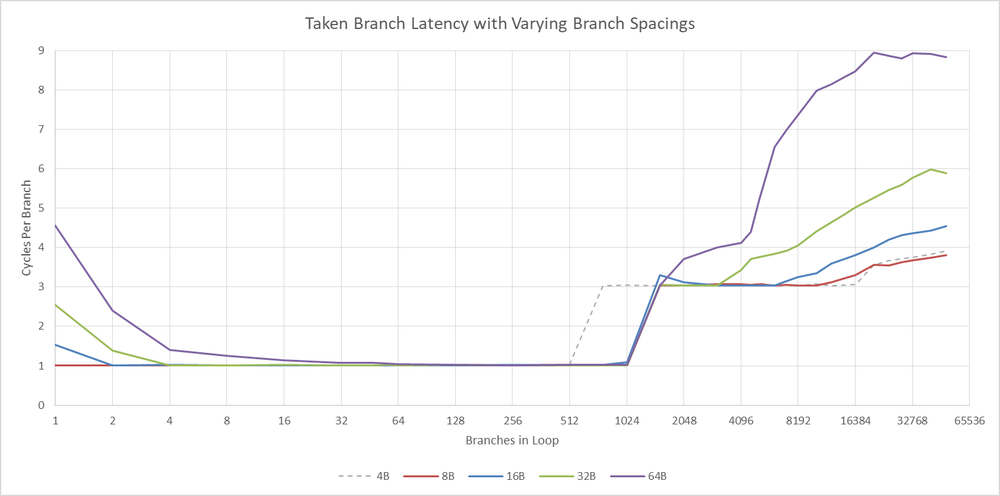
Taken Branch Latency with Varying Branch Spacings:当分支数超过 1024 项 BTB 容量后,每条 taken branch 的延迟从约 1 周期抬升到 3 周期以上;超出 128KB L1 指令缓存后还会进一步恶化。来源:Chips and Cheese。
更宽的流水线还要求更高的指令供给能力。分支预测失败、Cache Miss,或指令间存在依赖,都可能让多出来的执行宽度空转。
所以,对主要运行轻量任务的小核心来说,4-wide 是比较务实的选择。它能在控制前端复杂度的同时,保留一定指令级并行能力。不过,限制每周期进入后端的指令数,并不代表后端只需要配四个简单执行单元。
02|后端为什么不能跟着缩小?
乱序执行 CPU 的性能不只取决于每周期能接收多少指令,还取决于等待数据时能否继续执行其他独立指令。比如一条 Load 指令访问 Cache 时,后续指令可能已经准备好了。如果乱序窗口里保留足够多指令,处理器就能绕开等待数据的操作,让其他执行单元继续工作。
高通这颗小核心的重排序缓冲区(ROB)和寄存器文件规模,更接近 AMD Zen 4 这类更高性能核心,而不是传统的小型 4-wide 处理器。
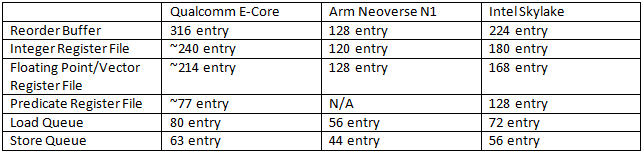
Qualcomm E-Core 与 Arm Neoverse N1、Intel Skylake 的后端跟踪资源对比:ROB 316 项、整数寄存器堆约 240 项,明显高于两类传统核心。来源:Chips and Cheese。
这说明高通压窄了前端,但保留了较强的指令跟踪与乱序执行能力。前端决定每周期能送入多少指令,乱序窗口决定处理器能同时寻找多少执行机会。两者解决的是不同问题,没必要按相同比例缩放。
整数执行部分也体现这一思路。核心有 4 个 ALU 端口,其中 3 个能处理会设置条件标志的整数运算,2 个端口可以处理分支相关操作。这种配置能让后端更灵活地调度不同整数指令,减少多条就绪指令争抢同一执行端口的情况。
当然,4 个 ALU 端口不代表每周期一定执行 4 条任意整数指令。实际吞吐仍受指令类型、端口能力和数据依赖限制。
03|有些指令,根本不需要送进 ALU
高通在寄存器重命名阶段还做了一项优化:直接消除部分 MOV 和立即数 ADD 指令。以寄存器间 MOV 为例,假设程序要把寄存器 A 的值复制给寄存器 B。
通常,这需要执行单元完成一次搬运。但乱序 CPU 内部本就有一张寄存器映射表,记录架构寄存器与物理寄存器的对应关系。如果只是复制寄存器值,处理器可以直接修改映射关系,让两个架构寄存器指向同一个物理寄存器,根本不用真的搬运数据。
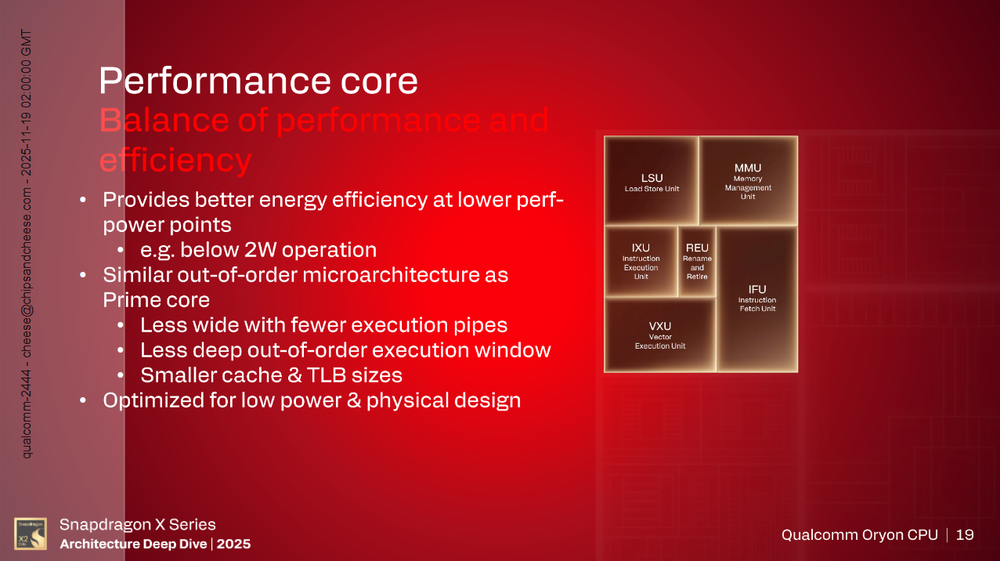
高通官方架构深潜资料(Snapdragon X Series Architecture Deep Dive 2025)显示:Performance core 与 Prime 大核的乱序微架构同源,只是收窄了执行管线宽度、乱序窗口以及 Cache/TLB 规模,以换取低功耗物理设计。说明:原文中 MOV 消除测试未附图表,本图为同文引用的官方资料,不是 MOV 消除测试图。来源:Qualcomm 官方资料,经 Chips and Cheese 引用。
这种操作叫 Move Elimination。实测中,满足特定条件时,高通小核心每周期可以消除两条存在依赖关系的寄存器 MOV 指令。对于部分较小立即数的 ADD,它也能在重命名阶段完成类似优化。不过,该能力受立即数范围和吞吐限制,不可能把所有加法都提前做完。
这类优化的收益很直接:如果一条指令在重命名阶段就能解决,后端就不用为它分配执行端口。对于执行资源有限的小核心,减少无效后端工作,有时比多一条 ALU 流水线更划算。
当然,这并非高通独有。Intel 等处理器也有类似机制,差别在于可消除的指令类型、条件和吞吐能力。
04|128KB L1 指令缓存,是不是太大了?
如果说 4-wide 体现的是高通对前端规模的控制,那 128KB L1 指令缓存则说明,它并不打算在所有前端资源上节省面积。
这颗核心的 L1I 达到 128KB,明显大于不少现代 CPU 使用的 32KB 或 64KB 设计。原因与指令供给有关。
当热点代码能留在 L1I 中,处理器就可以避免频繁从 L2 取指。对前端只有 4-wide 的核心来说,持续、稳定地供指非常重要,因为每次取指停顿都会进一步减少能送进后端的工作。
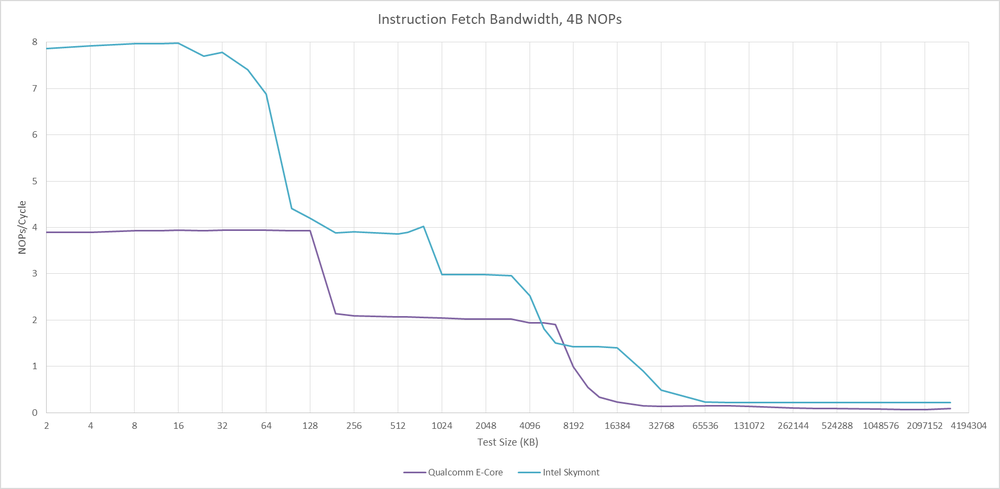
Instruction Fetch Bandwidth, 4B NOPs:当指令工作集超过 128KB L1I、需要从 L2 取指后,取指吞吐跌至约每周期 2 条,对比 Intel Skymont。来源:Chips and Cheese。
测试表明,指令工作集一旦超出 L1I 容量、需要从 L2 取指,前端吞吐就下降到大约每周期两条指令。这也解释了高通为什么愿意给小核心配较大指令缓存:与其继续加宽译码,不如先减少指令供给中断。
当然,大容量 L1I 并非没有代价。它会增加存储阵列面积,并对访问时序和功耗提出要求。高通的选择说明,在这颗核心的目标工作负载下,降低指令缓存失效率可能比继续压缩 L1I 更重要。
05|访存能力也没有简单缩水
数据缓存同样采用了相对积极的配置。
高通小核心拥有 64KB L1D,实测 Load-to-use 延迟约 3 个周期。它还配置了两条访存流水线,两条都能处理 Load 或 Store。也就是说,它虽然不算追求极高吞吐的宽核心,却仍很看重低延迟数据访问。
原因很简单:后台任务和轻量级应用不代表没有复杂数据依赖。指针追踪、对象访问、分支判断等,都可能受 Load 延迟影响。
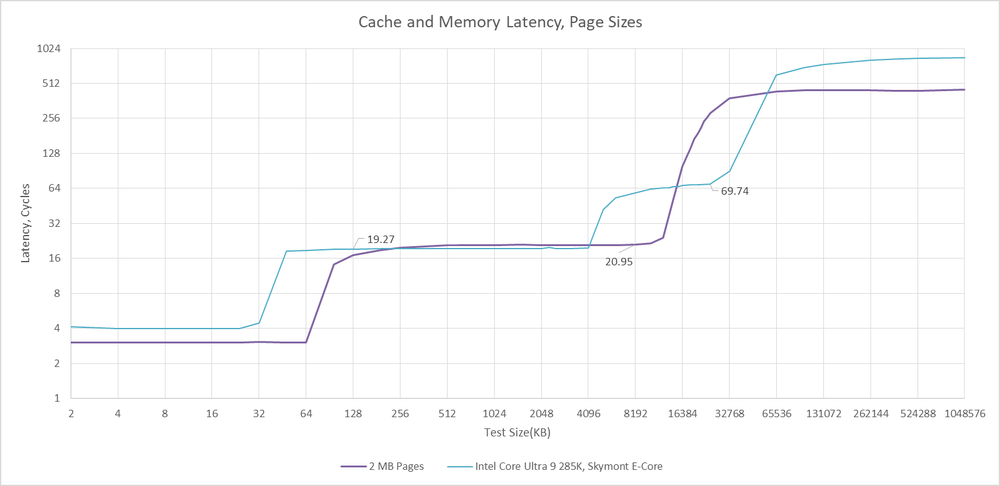
Cache and Memory Latency:64KB L1D 约 3 周期、共享 L2 约 21 周期、访问 DRAM 约 70 周期,与 Intel Core Ultra 9 285K 的 Skymont E-Core 对比。来源:Chips and Cheese。
如果为了省面积让 L1D 访问变慢,后端即便乱序窗口很大,也未必总能找到足够多独立指令来隐藏等待时间。
六颗小核心共享 L2 缓存。实测显示,该 L2 能向整个小核心集群提供超过 400GB/s 的读取带宽,而单颗核心受限于自身访存流水线和 128 位向量宽度,并不能独占这么高的吞吐。这种配置体现了另一个思路:共享缓存的总供给能力可以高于单颗核心的消耗能力,以支撑多核心同时工作。
高通也没有把向量计算做成小核心的主要卖点。虽然它支持 SVE2 和 SME,但 SVE 向量长度只有 128 位,Gather 操作的吞吐也比较保守。
指令集兼容性得到保留,但执行资源仍按小核心的性能和功耗目标配置。
06|小核心究竟应该在哪里省面积?
从这颗 Oryon 核心可以看到,高通并没有简单采用“把大核心所有资源缩小一半”的做法。
它控制了前端宽度和向量计算规模,同时保留较大指令缓存、低延迟数据缓存、充足的乱序执行资源,以及较灵活的整数执行端口。
这些选择围绕同一个目标:让小核心稳定执行轻量任务,尽量减少指令供给和数据等待带来的停顿,同时避免为很少用满的峰值吞吐能力付出过高面积与功耗成本。
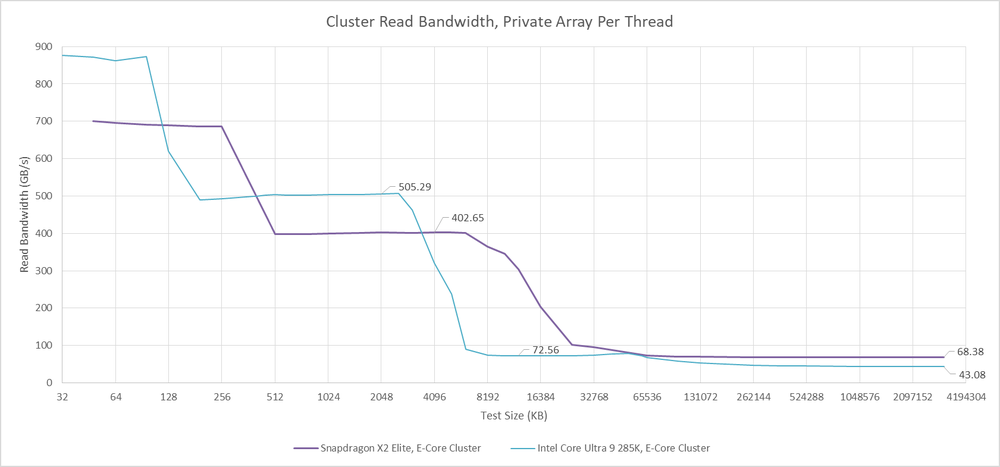
Cluster Read Bandwidth, Private Array Per Thread:6 颗小核共享 L2,向集群提供约 402GB/s 读带宽,对比 Intel Core Ultra 9 285K E-Core 集群。来源:Chips and Cheese。
这也解释了为什么不能只凭 4-wide 判断一颗 CPU 的性能。
CPU 微架构的关键,不是让每个模块都尽可能宽,而是判断哪些资源会成为目标工作负载的瓶颈。对于一颗小核心,前端可以相对保守,但分支预测、Cache 延迟、乱序窗口和访存能力,仍可能决定它在真实程序中的表现。
高通这次给出了很具体的案例:缩小 CPU,首先得知道哪些资源可以减少,哪些资源一旦减少,就会让其他硬件跟着闲置。
 发表于 昨天 21:12
|
查看: 9|
回复: 0
 /1


