有这么个问题:表里存了一两亿条数据,一跑带 GROUP BY 和 ORDER BY 的 SQL 就卡死,EXPLAIN 看着也走了索引,为什么还是慢得离谱?
这个问题挺有代表性的。数据量小的时候写 SQL 毫无压力,GROUP BY + ORDER BY 随便用,几百毫秒就出结果。但数据量一旦过了千万级、到了亿级,同样的 SQL 可能直接跑不出来,或者跑了几分钟被 DBA 把连接给 kill 了。
问题到底出在哪?
EXPLAIN 里的两个指标
亿级表跑聚合排序,先做一件事:看 EXPLAIN 输出里有没有 Using temporary 和 Using filesort 同时出现。
EXPLAIN SELECT city, COUNT(*) as cnt
FROM orders
WHERE create_time > '2025-01-01'
GROUP BY city
ORDER BY cnt DESC;
+----+-------+------+---------------------------------+
| id | table | type | Extra                           |
+----+-------+------+---------------------------------+
|  1 | orders| range| Using temporary; Using filesort |
+----+-------+------+---------------------------------+
Using temporary 意味着 MySQL 创建了一张临时表来存放分组的中间结果,Using filesort 意味着排序没法走索引,得在内存或磁盘上额外做一轮排序。这两个一起出现,数据量小的时候感知不明显,但亿级数据量下,临时表放不进 tmp_table_size(默认 16MB)限制的内存空间,会溢出到磁盘变成 MyISAM 临时表。一亿行数据在磁盘上做聚合再排序,IO 开销直接爆炸。
GROUP BY 和 ORDER BY 的列不一致,索引就没用
MySQL 有一个优化叫做松散索引扫描(Loose Index Scan)。如果 GROUP BY 的列恰好是索引的前缀列,MySQL 可以沿着索引顺序扫描,跳跃式地读取每组的第一条记录,不需要临时表。
举个例子,如果查询是这样:
SELECT city, COUNT(*) FROM orders
WHERE create_time > '2025-01-01'
GROUP BY city ORDER BY city;
给一个 (create_time, city) 的联合索引,WHERE 条件先通过 create_time 缩小扫描范围,然后索引中 city 已经是有序的,GROUP BY 可以直接利用这个顺序做分组,ORDER BY city 也不需要额外排序。EXPLAIN 里不会出现 Using temporary 和 Using filesort,效率差距非常大。
但坑就坑在:生产中的需求往往是 GROUP BY city ORDER BY COUNT(*) DESC,排序列和分组列根本不是同一个东西。COUNT(*) 是聚合之后才算出来的值,索引里压根没有这个信息,MySQL 只能先在临时表里把所有分组算完,再对结果做一次排序。这种场景下索引能帮到的只是减少扫描行数(WHERE 条件过滤),分组和排序那一步该慢还是慢。
就算索引完美命中,亿级扫描本身也扛不住
假设运气好,GROUP BY 和 ORDER BY 的列一致,索引完美匹配,没有临时表没有 filesort。是不是就快了?不一定。
索引解决的是怎么找的问题,但找多少这件事索引管不了。一个 WHERE 条件过滤完还剩 5000 万行需要参与聚合计算,MySQL 要逐行扫描这 5000 万条索引记录,每一行都要做聚合累加。InnoDB 的 B+ 树索引每个叶子节点存在 16KB 的 page 里,5000 万行索引即使每行很短,也得读几十万个 page。
说白了,单纯靠索引在亿级表上跑 GROUP BY,即使最优情况也要几秒甚至十几秒。如果业务对响应时间要求在 500ms 以内,靠调索引根本达不到。
不要在大表上实时聚合
生产中亿级数据的聚合查询,靠谱的做法是预计算,把聚合结果提前算好存进一张小表。
最简单的方案是定时汇总表。每天凌晨或者每小时跑一个定时任务,把聚合结果写进去:
CREATE TABLE order_daily_summary (
    stat_date DATE,
    city VARCHAR(50),
    order_count INT,
    total_amount DECIMAL(12,2),
    PRIMARY KEY (stat_date, city)
) ENGINE=InnoDB;
-- 每天凌晨跑
INSERT INTO order_daily_summary (stat_date, city, order_count, total_amount)
SELECT DATE(create_time), city, COUNT(*), SUM(amount)
FROM orders
WHERE create_time >= CURDATE() - INTERVAL 1 DAY
AND create_time < CURDATE()
GROUP BY DATE(create_time), city;
汇总表就那么几千几万行数据,前端查的时候直接查它,GROUP BY ORDER BY 随便写,毫秒级返回。大表只在凌晨低峰期被扫描一次,不影响白天的在线业务。
如果业务需要更实时的数据,在写入订单的时候同步更新汇总表:
INSERT INTO order_daily_summary (stat_date, city, order_count, total_amount)
VALUES (CURDATE(), '北京', 1, 99.00)
ON DUPLICATE KEY UPDATE
    order_count = order_count + 1,
    total_amount = total_amount + 99.00;
每次下单就做一次增量累加,查询端完全不用碰大表。代价是写入逻辑多了一步,但对于报表场景来说这个 trade-off 完全值得。
分区表能帮多少忙
MySQL 的 RANGE 分区按时间拆表,查最近一个月的数据只扫一个分区而不是全表:
ALTER TABLE orders PARTITION BY RANGE (TO_DAYS(create_time)) (
PARTITION p202501 VALUES LESS THAN (TO_DAYS('2025-02-01')),
PARTITION p202502 VALUES LESS THAN (TO_DAYS('2025-03-01')),
PARTITION p202503 VALUES LESS THAN (TO_DAYS('2025-04-01'))
);
带上时间条件查询时,MySQL 会做分区裁剪(Partition Pruning),只读目标分区。一亿行数据如果按月分 12 个分区,每个分区大概 800 万行,聚合计算量直接降一个数量级。
但分区有个前提:WHERE 条件里必须包含分区键。如果业务需求是统计所有历史数据按城市分组排序,没有时间条件,分区裁剪不生效,还是全表扫描。
GROUP BY 基数太大
还有一种场景:GROUP BY 的列基数特别大,比如按 user_id 分组,几千万个不同用户。分组结果本身就有几千万行,临时表几个 GB 大。这种查询不管怎么优化索引都没用,因为中间结果集太大,MySQL 的行式存储引擎先天不适合做这类大规模分析。
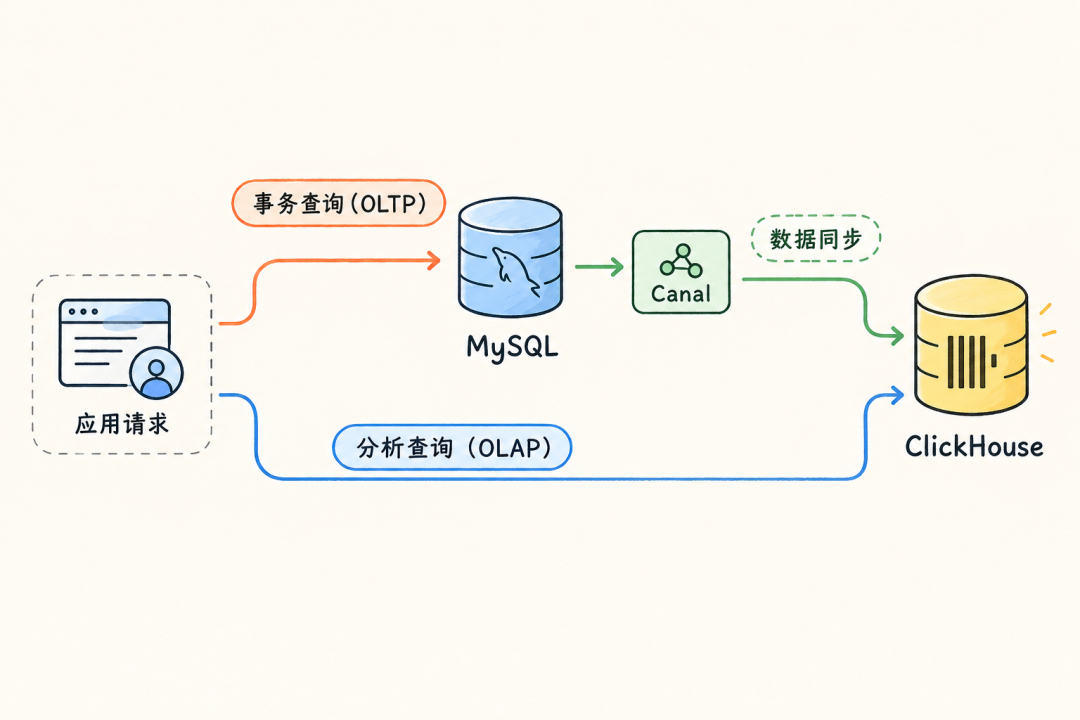
碰到这种需求就得换引擎了。ClickHouse 是列式存储,天生为聚合分析设计,同样的亿级 GROUP BY 查询,可能 1~2 秒就跑完了。不少团队最后走的方案是:MySQL 负责 OLTP 在线事务,数据通过 Canal 或者 Debezium 同步一份到 ClickHouse,报表和分析类查询全部丢给 ClickHouse 跑。两边各干各的事,互不影响。
把查询范围压下来
说了这么多技术方案,很多时候最管用的反而不是技术手段。
跟产品聊一下,报表页面默认展示最近 7 天的数据,而不是全量数据。一亿行数据加上 WHERE create_time > NOW() - INTERVAL 7 DAY 之后可能只剩 200 万行,配合合理的索引,GROUP BY + ORDER BY 瞬间就能跑出来。大部分场景下用户根本不需要看全量汇总,默认 7 天加一个时间选择器,既满足了产品需求,又让数据库压力降了一两个数量级。
这比在数据库层面死磕优化有用得多。
说在最后
亿级数据量下 GROUP BY + ORDER BY 慢,根源不在 SQL 写法,而是 MySQL 的行式存储引擎在大规模聚合场景下的天然瓶颈。索引能解决扫描效率,但解决不了扫描数量。临时表和 filesort 在数据量大的时候性能会断崖式下降,这不是调参数能弥补的。
亿级聚合的正确思路是:要么预先算好结果(汇总表),要么缩小计算范围(分区 + 时间条件),要么换一个适合做聚合的引擎(ClickHouse)。在大表上实时跑 GROUP BY ORDER BY 这条路,走到头了。
 发表于 4 小时前
|
查看: 4|
回复: 0
 /1


