金融交易、游戏网关、网络通信,这些系统里协议本身往往不是最让人头疼的。真正昂贵的是:同一份二进制协议要在多种语言里重复实现,而且每次协议升级都还得保证所有实现逐字节一致。
fin-protoc 正是冲着这个问题来的:用 PacketDSL 保存唯一协议定义,然后生成各语言的序列化、反序列化和测试代码。在已经支持 Java、Rust、Lua(Wireshark)、Go、Python、C++ 的基础上,fin-protoc 这次新增了 Zig 与 C 代码生成器,目标语言达到八种。
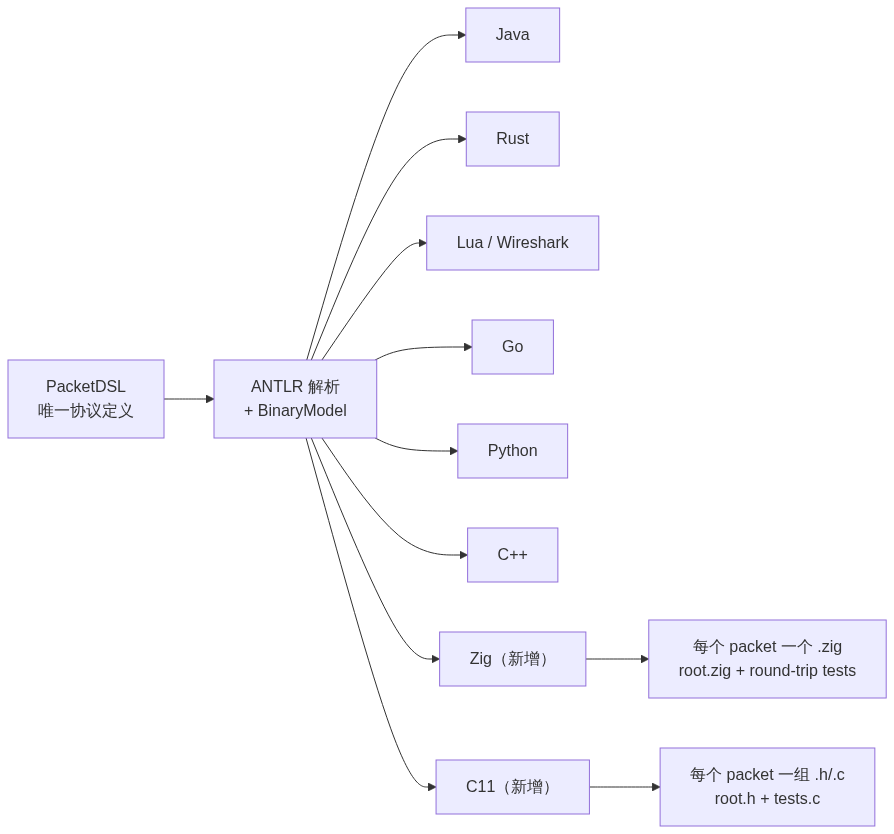
这次更新不只是把字段简单翻译成两种新语法。C 与 Zig 的生成代码和现有语言共用同一套内部模型,也遵循相同的字节序、长度前缀、定长字符串填充、对象嵌套、match 分派和校验和规则。协议演进时,团队依旧只需要维护 PacketDSL。
01 为什么是 C 和 Zig?
C 至今仍是低延迟网关、交易终端、嵌入式设备和跨语言 FFI 最通用的共同接口。部署面足够广,但手工实现协议编解码时,长度计算、union 分派和内存释放都容易出错。
Zig 提供了接近 C 的控制力,同时用显式 allocator、错误联合和 tagged union,让资源所有权与分支关系更容易在代码里表达。对既想保留底层控制、又不愿意把所有约束都压在人工约定上的项目来说,它是一个很自然的目标语言。
两者加入之后,同一份协议就能覆盖服务端、测试工具、Wireshark 分析、客户端 SDK,以及更贴近硬件和交易链路的底层组件。
02 从一份 DSL 生成 C 与 Zig
下面是一份精简的网关消息定义。MsgType 决定消息体类型,BodyLength 由消息体编码长度回填,帧尾则自动计算 CRC32:
options {
    StringPrefixLenType = u16;
    ArrayPrefixLenType = u16;
    LittleEndian = false;
}

packet NewOrder {
    char[12] SecurityID,
    u64 Price,
    u32 Qty,
}

packet CancelOrder {
    char[16] ClOrdID,
}

root packet GatewayMessage {
    u16 MsgType,
    @lengthOf(Body)
    u16 BodyLength,
    match MsgType as Body {
        1: NewOrder,
        2: CancelOrder,
    },
    @calculatedFrom("CRC32")
    u32 Checksum,
}
分别执行:
# Zig
fin-protoc -f gateway.dsl -z ./src

# C
fin-protoc -f gateway.dsl -C ./src

# 也可以在一次解析后同时生成两种语言
fin-protoc -f gateway.dsl -z ./zig/src -C ./c/src
这里特意用大写 -C 表示 C;小写 -c 已经用于 C++。
03 Zig:tagged union、显式 allocator 与生成测试
Zig 生成器为每个 packet 生成一个 .zig 文件,并通过 root.zig 统一导出公共类型。match 字段会成为 tagged union,因此消息类型和消息体之间的关系不再只是运行时约定:
pub const GatewayMessageBodyEnum = union(enum) {
    new_order: NewOrder,
    cancel_order: CancelOrder,
};

pub const GatewayMessage = struct {
    msg_type: u16,
    body_length: u16,
    body: GatewayMessageBodyEnum,
    checksum: u32,

    pub fn encode(self: *const GatewayMessage, buf: *codec.Buffer) !void {
        // 生成的字段编码、长度回填和 checksum 逻辑
    }

    pub fn decode(
        allocator: std.mem.Allocator,
        reader: *codec.Reader,
    ) codec.DecodeError!GatewayMessage {
        // 生成的解码和 match 分派逻辑
    }
};
生成代码依赖 fin-proto-runtime-bin-zig 提供的 binary_codec 模块。整数读写、定长字符串、列表、CRC16/CRC32,以及 SSE_BIN、SZSE_BIN 校验和都由运行时统一实现。每个 packet 还会生成 round-trip 测试,可直接纳入 zig build test。
04 C:C11 数据结构、kind + union 与对称释放
C 生成器会为每个 packet 生成一组 .h/.c,并额外生成统一入口 root.h 和测试文件 tests.c。match 字段被表示为 kind 枚举与 union 的组合:
typedef enum {
    GATEWAY_MESSAGE_BODY_NONE = 0,
    GATEWAY_MESSAGE_BODY_NEW_ORDER,
    GATEWAY_MESSAGE_BODY_CANCEL_ORDER,
} gateway_message_body_kind;

typedef struct gateway_message_gateway_message {
    uint16_t msg_type;
    uint16_t body_length;
    gateway_message_body_kind body_tag;
    union {
        gateway_message_new_order new_order;
        gateway_message_cancel_order cancel_order;
    } body;
    uint32_t checksum;
} gateway_message_gateway_message;

bool gateway_message_gateway_message_encode(
    const gateway_message_gateway_message *self, fc_buffer *buf);
bool gateway_message_gateway_message_decode(
    fc_reader *reader, gateway_message_gateway_message *out);
void gateway_message_gateway_message_free(
    gateway_message_gateway_message *self);
对应的 fin-proto-runtime-bin-c 是一个无第三方依赖的 C11 运行时。生成器会为需要资源清理的消息生成配套 *_free,并在测试中覆盖 encode → decode → equality 的完整 round trip。
05 零拷贝解码的边界要说清楚
C 和 Zig 当前实现都会让解码后的字符串直接借用输入缓冲区,而不是再次复制字符串内容;repeat 字段的外层数组仍然可能需要分配。这种选择降低了解码路径上的分配和复制,但也意味着调用方必须让输入字节活得足够久。
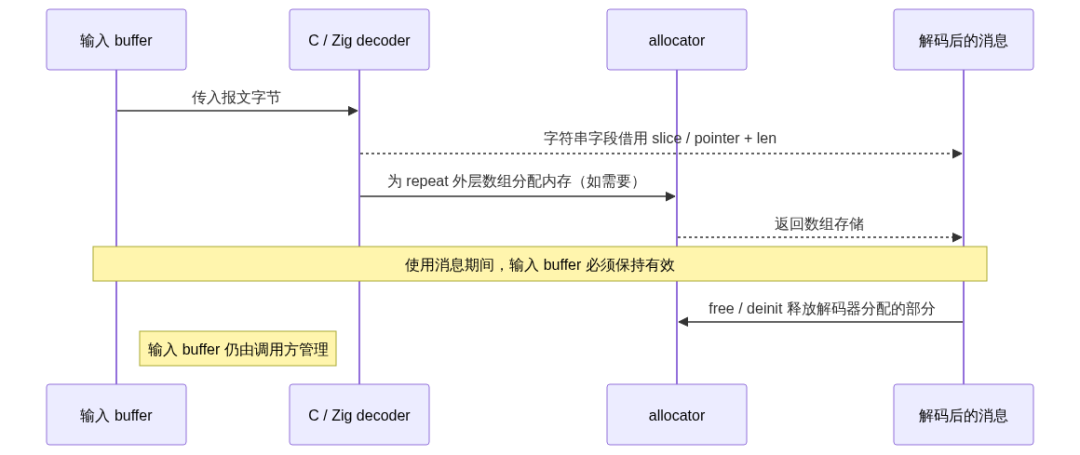
这个生命周期不是隐藏细节,而是生成 API 的一部分:Zig 通过 deinit(allocator),C 通过 *_free 清理解码路径分配的外层数组;被借用的输入缓冲区仍由调用方持有和释放。
06 多语言 Benchmark:Rust、Zig 与 C
为了比较新增实现与既有 Rust 基线,仓库从可复现的 scripts/bench_compare.sh 出发;本轮本地工作树在脚本中增加了 Rust decode_reuse 与 decode_borrowed 采集。三种语言运行相同的预热、批次和取最快批次方法:
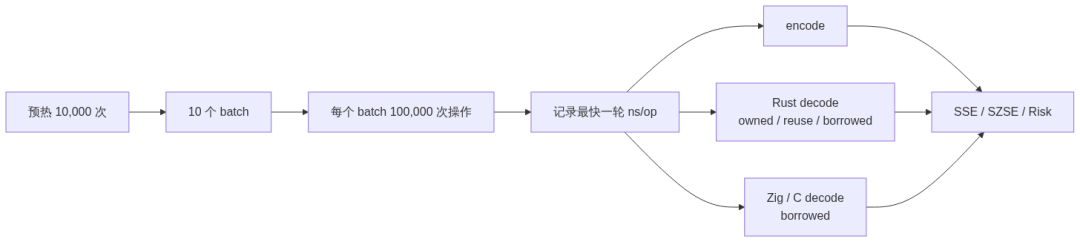
所有数字单位都是 ns/op,越低越好。测试帧分别为 SSE 125 bytes、SZSE 109 bytes、Risk 123 bytes。Rust 使用 release 构建,Zig 使用 ReleaseFast,C 使用 -O2。
Rust 现在同时提供三种解码口径:decode_owned 保留原有 BinaryCodec::decode 行为并构造 owned String;decode_reuse 通过 decode_into 复用已有 String 容量;decode_borrowed 返回带生命周期的 *Ref<'a>,字符串直接借用输入帧。Zig 与 C 的 decode 同样借用输入,因此应与 Rust decode_borrowed 横向比较。第一版新接口针对不含 repeat 的消息生成;decode_into 失败时输出对象可能已经部分更新,调用方只能在返回成功后使用它。
本地 Mac 实测
测试环境:Apple M4 Pro、24 GB 内存、macOS 15.6(Darwin 24.6.0)、Rust 1.92.0、Zig 0.17.0、Apple Clang 17.0.0;测试日期为 2026-10-31。fin-protoc 以 0ab901b 为基线,叠加本轮 Rust decode_into 与 borrowed decode 生成器改动;三套 Rust 协议代码均由这一本地版本重新生成。
测试在日常桌面环境中进行。完整三语言运行开始前,后台占用最高的是 Codex Service 18.6%、WindowServer 16.0%、Codex Renderer 14.1%;整个过程没有终止任何用户进程。随后单独复跑 Rust 时,decode_reuse 与 decode_borrowed 的差异大多在 0.4%~6.0% 之间。所以这些数字更适合观察趋势,别把它们当成独占机器的实验室基线。
| 协议 |
操作 |
Rust |
Zig |
C |
最快 |
| Risk(123 B) |
encode |
55.4 |
76.9 |
100.2 |
Rust |
| Risk(123 B) |
decode_owned |
202.5 |
— |
— |
— |
| Risk(123 B) |
decode_reuse |
58.6 |
— |
— |
— |
| Risk(123 B) |
decode_borrowed |
23.7 |
16.4 |
32.5 |
Zig |
| SSE(125 B) |
encode |
57.1 |
88.5 |
93.4 |
Rust |
| SSE(125 B) |
decode_owned |
412.0 |
— |
— |
— |
| SSE(125 B) |
decode_reuse |
78.0 |
— |
— |
— |
| SSE(125 B) |
decode_borrowed |
42.8 |
15.2 |
29.2 |
Zig |
| SZSE(109 B) |
encode |
77.5 |
41.2 |
73.6 |
Zig |
| SZSE(109 B) |
decode_owned |
536.1 |
— |
— |
— |
| SZSE(109 B) |
decode_reuse |
99.7 |
— |
— |
— |
| SZSE(109 B) |
decode_borrowed |
49.5 |
16.9 |
37.0 |
Zig |
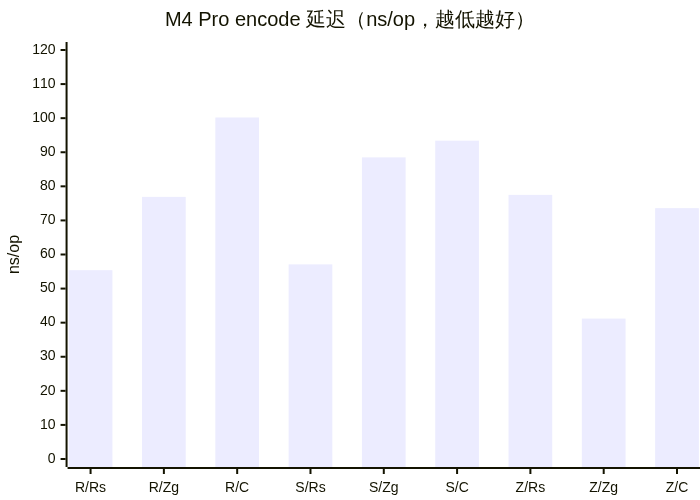
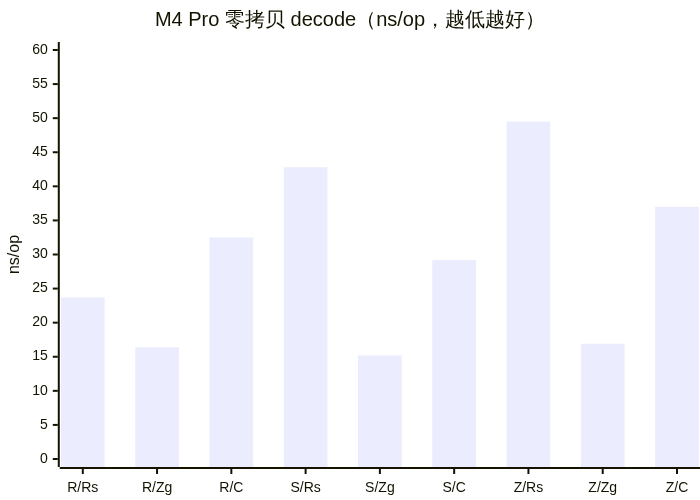
本地 encode 结果最能体现本轮 Rust 优化带来的排名变化。图中协议缩写为 R(Risk)、S(SSE)、Z(SZSE),语言缩写为 Rs(Rust)、Zg(Zig)和 C:
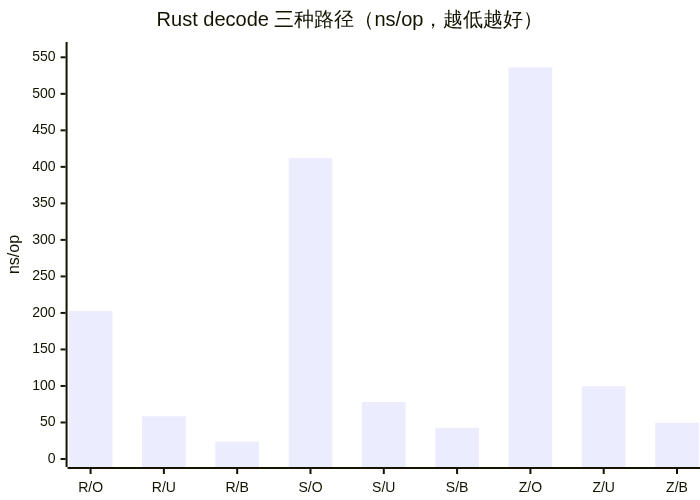
Rust 三种 decode 路径的差异直接说明了分配与复制的成本。横轴中的 O、U、B 分别表示 owned、reuse、borrowed:
把内存语义统一为借用输入后,Rust 与 Zig/C 的差距显著缩小:
GitHub Actions 实测
以下数据来自最新一次 GitHub Actions 运行,覆盖 Rust、Zig 和 C 的同一套 codec 微基准。所有实现都采用统一的方法论:10k 轮预热、10 批次 × 100k 操作/批次,最终报告最快一批的 ns/op。GitHub-hosted runner 是共享 VM,因此低于约 20% 的差异应视为噪声,不宜当成稳定的语言排序结论。
| Library |
Case |
Frame bytes |
Rust ns/op |
Zig ns/op |
C ns/op |
Zig vs Rust |
C vs Rust |
| sse |
encode |
125 |
84.6 |
164.8 |
220.1 |
0.51x |
0.38x |
| sse |
decode_owned |
125 |
331.9 |
— |
— |
— |
— |
| sse |
decode_reuse |
125 |
171.1 |
— |
— |
— |
— |
| sse |
decode_borrowed |
125 |
96.4 |
43.8 |
90.4 |
2.20x |
1.07x |
| szse |
encode |
109 |
155.6 |
84.3 |
180.7 |
1.85x |
0.86x |
| szse |
decode_owned |
109 |
494.8 |
— |
— |
— |
— |
| szse |
decode_reuse |
109 |
231.8 |
— |
— |
— |
— |
| szse |
decode_borrowed |
109 |
115.9 |
45.4 |
109.4 |
2.55x |
1.06x |
| risk |
encode |
123 |
110.7 |
170.7 |
219.8 |
0.65x |
0.50x |
| risk |
decode_owned |
123 |
191.4 |
— |
— |
— |
— |
| risk |
decode_reuse |
123 |
109.9 |
— |
— |
— |
— |
| risk |
decode_borrowed |
123 |
57.8 |
47.6 |
82.1 |
1.21x |
0.70x |
从这组结果看,encode 仍然是最容易受实现细节和代码布局影响的路径:Rust 在 Risk 和 SSE 上领先,Zig 在 SZSE 上领先;而在零拷贝 decode(decode_borrowed)上,Zig 与 Rust 的差距明显收敛,说明关键变量已经从“owned String 分配成本”转向更底层的读取、边界检查和字符串处理实现。GitHub runner 作为共享环境,单次批次的 15%~20% 以内波动更像噪声,而不是稳定的性能趋势。
07 如何理解这些数字?
第一,Rust 定长字符串 fast path 与 encode/decode 内联优化改变了 encode 排名:在本地 Mac 和现有 GitHub Actions 基线上,Risk、SSE 的 encode 都由 Rust 取得最低 ns/op;SZSE encode 仍由 Zig 领先。
第二,在不改变 owned 数据模型的前提下,decode_into 复用字符串容量,把 Risk、SSE、SZSE decode 分别从 202.5、412.0、536.1 ns/op 降到 58.6、78.0、99.7 ns/op,约快 3.5×、5.3×、5.4×。它适合对象池、固定 worker 或重复解析同类消息的场景。
第三,Rust decode_borrowed 进一步把三组结果降到 23.7、42.8、49.5 ns/op。Risk 已快于 C;SSE 与 SZSE 分别约为 C 的 1.47×、1.34×。Zig 在三组零拷贝 decode 中仍最低,但与最初用 owned Rust 对比时相比,差距已经从“分配策略差异”收敛到 reader、边界检查、UTF-8 校验和代码布局等实现细节。这个结果说明的是当前实现策略的代价,不是脱离上下文的语言排名。
最后,这是一组 codec 微基准,不包含网络 I/O、业务校验、日志和线程调度。它适合观察代码生成与运行时的趋势,但端到端系统仍应使用真实流量、报文分布和延迟分位数进行验证。本地 Mac 与 GitHub runner 的绝对值也不应横向比较。
08 不只是生成:还要验证跨语言一致性
性能之外,协议编译器更重要的指标是正确性。C 与 Zig 生成器都覆盖基础数值、浮点数、动态与定长字符串、repeat、嵌套对象、match、@lengthOf、padding 和 checksum 等 PacketDSL 能力,并生成 round-trip 测试。
围绕 SSE、SZSE 和 Risk 协议,项目还建立了对应的 C/Zig 仓库与互操作验证:
- Zig:
fin-proto-sse-bin-zig、fin-proto-szse-bin-zig、fin-proto-risk-bin-zig
- C:
fin-proto-sse-bin-c、fin-proto-szse-bin-c、fin-proto-risk-bin-c
其中包括 round-trip、golden frame 和与 Rust 实现的字节级对比。它们共同守住了最关键的边界:无论调用方使用哪种语言,相同协议数据都必须得到一致的 wire bytes。
09 写在最后
C 与 Zig 支持让 fin-protoc 从应用层语言进一步走向低层系统开发,但项目的核心没有改变:
协议只定义一次,所有语言实现都从同一个事实来源生成。
如果你的系统同时包含 Java 网关、Rust 服务、Go 测试工具、Wireshark 分析脚本,以及 C 或 Zig 的低延迟组件,现在可以让它们共享同一份 PacketDSL。协议变更不再意味着复制八遍编解码逻辑,而是重新生成、运行跨语言测试,然后把一致的实现交付到每个平台。
如果你也在做协议多语言生成或低延迟编解码实践,欢迎到云栈社区交流;fin-protoc 也欢迎提交 issue、试用 C/Zig 生成器,或者用自己的真实协议和负载复现 benchmark。
 发表于 昨天 20:12
|
查看: 12|
回复: 0
 /1


