本文讨论上交所流式二进制协议 v0.57 与深交所 Binary 交易数据接口规范 Ver1.29 的 C11 实现,重点是协议建模、消息分派、内存所有权、长度与校验和处理,以及如何验证实现与既有 Rust 版本逐字节兼容。
协议代码由 fin-protoc 根据 PacketDSL 生成;本文只在必要处说明这一来源,不展开代码生成器本身。
01 项目与代码
| 组件 |
GitHub 仓库 |
| 上交所流式二进制协议 v0.57 |
fin-proto-sse-bin-c |
| 深交所 Binary 交易数据接口规范 Ver1.29 |
fin-proto-szse-bin-c |
| C11 二进制编解码运行时 |
fin-proto-runtime-bin-c |
| 协议编译器 |
fin-protoc |
C 版本的目标不是把文档里的字段机械地翻译成结构体,而是建立一组明确的边界:TCP 字节流怎样组成完整帧、消息类型怎样映射到具体 Body、哪些数据借用输入缓冲区、哪些数据需要释放,以及编码结果如何证明与其他语言一致。
02 先理解线上帧
沪深两套协议都采用大端字节序,也都可以抽象为“头部 + 变长 Body + 校验和”,但头部字段和消息分派复杂度不同。
| 协议 |
固定头部 |
Body 分派 |
帧尾 |
| SSE v0.57 |
MsgType u32 + MsgSeqNum u64 + MsgBodyLen u32 |
14 种 Body |
Checksum u32,SSE_BIN |
| SZSE Ver1.29 |
MsgType u32 + BodyLength u32 |
77 个 MsgType 键映射到 14 种 Body |
Checksum i32,SZSE_BIN |

这里的“流式”描述的是协议运行在连续的 TCP 字节流 上,不等于 codec 可以直接接受任意网络分片。应用层仍应先完成组帧:读取固定头部、解析 Body 长度、等待完整帧,再把连续字节交给解码器。
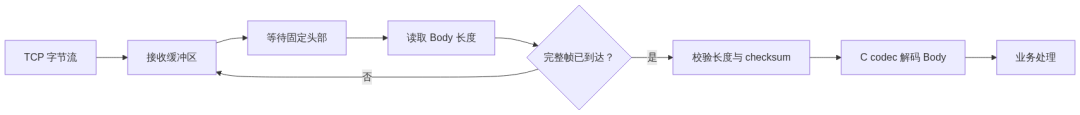
当前协议库负责完整帧内的字段编解码;TCP 粘包、拆包、最大帧长限制和连接级序列号策略属于上层传输适配器。把这条边界说清楚,比在 codec 里暗中维护网络状态更容易测试和复用。
03 最难的不是字段,而是两级消息分派
上交所根消息按 MsgType 直接选择 14 种 Body。深交所更复杂:根消息的 77 个 MsgType 键先归并为 14 种 Body,其中 NewOrder、ExecutionConfirm 和 ExecutionReport 还要根据三字节 ApplID 选择业务扩展体。协议定义中共有 54 个 Extend* 类型。
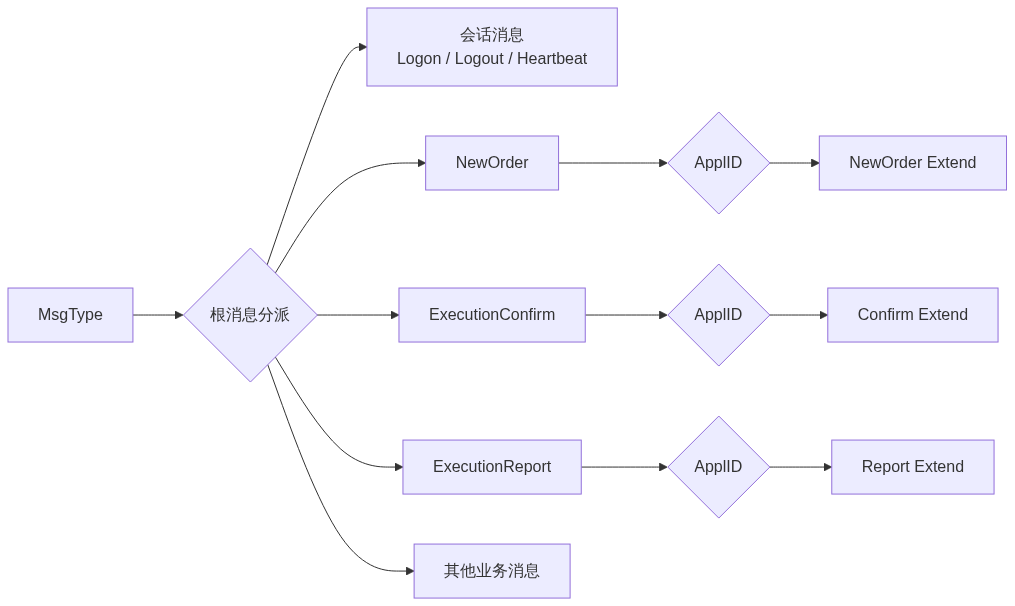
用 kind + union 表达 C 中的变体类型
C 没有原生 tagged union,所以实现使用一个判别枚举和一个 union。下面是上交所根消息的简化形式:
typedef enum {
    SSE_BINARY_BODY_NONE = 0,
    SSE_BINARY_BODY_HEARTBEAT,
    SSE_BINARY_BODY_LOGON,
    SSE_BINARY_BODY_NEW_ORDER_SINGLE,
    SSE_BINARY_BODY_ORDER_CANCEL,
    /* ... */
} sse_binary_body_kind;

typedef struct sse_binary_sse_binary {
    uint32_t msg_type;
    uint64_t msg_seq_num;
    uint32_t msg_body_len;
    sse_binary_body_kind body_tag;
    union {
        sse_binary_heartbeat heartbeat;
        sse_binary_logon logon;
        sse_binary_new_order_single new_order_single;
        sse_binary_order_cancel order_cancel;
        /* ... */
    } body;
    uint32_t checksum;
} sse_binary_sse_binary;
编码看 body_tag,解码看线上 msg_type。两者职责不同:
- 编码时,调用方必须构造一致的
msg_type、body_tag 与 union 成员。
- 解码时,库根据
msg_type 设置 body_tag,再进入对应的子消息 decoder。
- 未知
msg_type 立即返回 false,不会把未知字节误解释成某个结构体。
深交所的第二级 ApplID 分派使用相同模型:kind 枚举表示当前扩展体,union 保存对应的 Extend* 结构。多值键会合并为同一分支,避免复制相同的解码逻辑。这里的 ApplID、扩展体 kind 和 union 成员同样是独立字段;encoder 不会从 union 反推或校验线上 key,编码前必须由调用方保证三者一致。
04 运行时设计:小而明确
运行时只提供几类基础能力:
- 可增长的
fc_buffer,负责编码和原地回填;
- 只读游标
fc_reader,负责边界检查和大端/小端标量读取;
- 定长字符串、动态字符串和 repeat 列表;
- CRC16、CRC32、SSE_BIN、SZSE_BIN 校验和;
fc_string 形式的借用字符串。
它只依赖 C 标准库,没有全局注册表,也没有隐藏线程状态。字节序保存在 buffer/reader 中,因此生成的消息函数不需要为每个整数再提供 _be、_le 两套 API。
字符串零拷贝:借用而不是复制
定长 char[N] 和动态字符串在解码后都表示为:
typedef struct fc_string {
    const char *data;
    size_t len;
} fc_string;
data 直接指向输入帧。解码定长字符串时,reader 先取得对应字节区间,再根据协议配置去掉左侧或右侧填充;整个过程不复制 payload。fc_string 也不是 NUL 结尾字符串,传给传统 C API 前必须结合 len 处理。
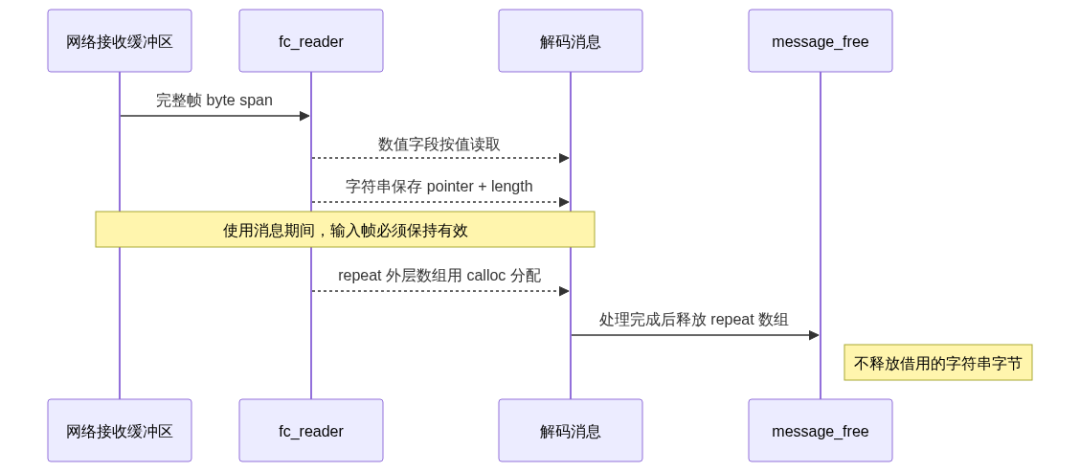
这个设计适合“收包 → 解码 → 处理 → 释放帧”的网关热路径。如果消息要进入异步队列或长期缓存,调用方应复制所需字段,不能只保存 fc_string。
repeat 是唯一需要动态分配的解码结构
标量和字符串都不分配;repeat 需要一个外层数组。例如 ExecRptSync 会先读取 u16 数量,再 calloc 对应数量的子结构。每个消息都提供对称的 <message>_free:
void sse_binary_exec_rpt_sync_free(sse_binary_exec_rpt_sync *self) {
    for (uint32_t i = 0; i < self->sub_exec_rpt_sync_count; i++) {
        sse_binary_sub_exec_rpt_sync_free(&self->sub_exec_rpt_sync[i]);
    }
    free(self->sub_exec_rpt_sync);
    self->sub_exec_rpt_sync = NULL;
    self->sub_exec_rpt_sync_count = 0;
}
解码函数开头会把输出结构清零;根消息又会在进入子 decoder 前设置 body_tag。因此即使某个字段中途失败,调用方仍可以对根消息调用 *_free,清理已经建立的 repeat 数组。这个约定把 C 中常见的“部分初始化对象”变成了可管理状态。
05 长度回填与校验和
编码一帧时,Body 长度只有写完 Body 才知道。实现采用“预留 → 编码 → 回填 → 计算校验和”的顺序:
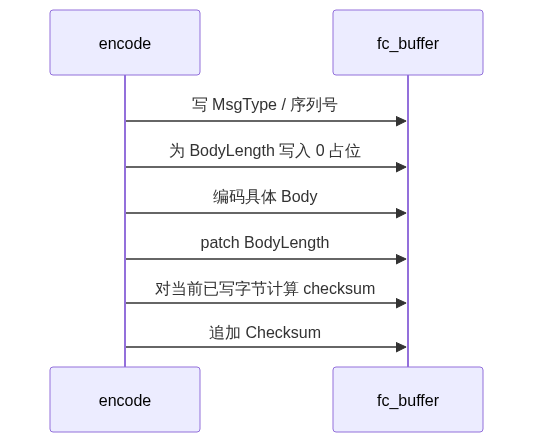
SSE_BIN 对校验和字段之前的字节求和并折叠到低 8 位,结果以 u32 写入;SZSE_BIN 对字节求和后按 256 取余,以 i32 写入。校验和类型与算法在消息定义中固定,不在运行时按字符串查表。
根 encoder 的 checksum 输入是 buf->data[0..buf->len],所以一个完整帧必须从空 buffer 开始。复用已分配容量时先调用 fc_buffer_reset;批量发送多帧时,应分别编码每个完整帧,再拼接到传输缓冲区。若直接在未 reset 的同一个 fc_buffer 中连续追加,后一帧的 checksum 会错误地覆盖前面已经写入的字节。
需要特别说明:当前 decoder 读取 BodyLength 和 Checksum,但不会自动重算并拒绝不匹配的帧,也不会用 BodyLength 创建受限子 reader。 因此生产接入层应在调用消息 decoder 前后完成:
- 最大帧长和完整帧边界检查;
- Body 实际消费长度与头部长度的一致性检查;
- repeat count 的业务上限,以及 count 与剩余 Body 字节是否相容;
- checksum 重算与比较。
这是当前 API 的明确边界,不应把“编码时会生成 checksum”误解为“解码时已经验证 checksum”。
06 FIN-PROTOC 在这里扮演什么角色
沪深协议的字段数量和分派分支都很大,手工维护 C、Rust、Zig 三套实现很容易发生漂移。项目因此用 PacketDSL 保存协议结构,再由 fin-protoc 生成 C11 消息代码。
# 上交所
fin-protoc -f proto/sse_bin_v0.57.pdsl -C src/

# 深交所
fin-protoc -f proto/szse_bin_v1.29.pdsl -C src/
生成器解决的是重复劳动和一致性问题;协议 framing、运行时内存模型、输入限制与互操作测试仍然是实现设计的一部分,不能交给“生成”两个字带过。
07 正确性:从字段 round trip 到跨语言 wire bytes
验证分为三层:
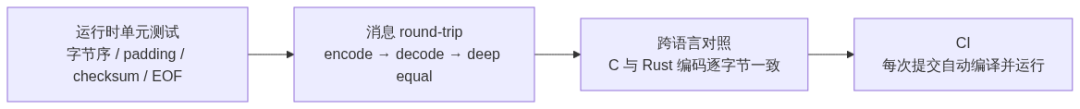
- 运行时测试覆盖大小端标量、定长填充、动态字符串、repeat、短输入和已知 checksum 向量。
- 每个消息都有生成的 round-trip 测试,
tests.c 自带 main,无需额外测试框架。
- 上交所 Logon 等用例与 Rust 实现比较十六进制输出,要求包含长度和 checksum 在内的整帧完全一致。
- 协议仓库在 CI 中重新编译并运行测试,防止生成代码、运行时和协议定义脱节。
round-trip 只能证明“自己编码的内容能被自己读回”;跨语言字节对照才是防止共同偏差的关键。生产环境还应补充交易所样例帧或抓包 golden files。
08 集成与使用
C 运行时可以直接以源码方式加入 Makefile、CMake 或 Bazel。协议库只需要运行时头文件和源文件:
RUNTIME ?= ../fin-proto-runtime-bin-c

$(CC) $(CFLAGS) \
  -I$(RUNTIME)/include -Isrc \
  src/*.c $(RUNTIME)/src/*.c app.c
解码一条已经完成组帧和校验的上交所消息:
#include "root.h"

int handle_frame(const uint8_t *frame, size_t frame_len) {
    fc_reader reader;
    fc_reader_init(&reader, frame, frame_len, 0); /* 0 = 大端 */

    sse_binary_sse_binary msg;
    if (!sse_binary_sse_binary_decode(&reader, &msg)) {
        sse_binary_sse_binary_free(&msg);
        return -1;
    }

    if (msg.body_tag == SSE_BINARY_BODY_LOGON) {
        fc_string sender = msg.body.logon.sender_comp_id;
        /* sender.data 借用 frame,长度是 sender.len */
    }

    sse_binary_sse_binary_free(&msg);
    return 0;
}
free 只清理 repeat 等由 decoder 分配的结构;输入 frame 的所有权始终属于调用方。
09 性能应怎样解读
在仓库的同口径微基准中,C 的无 repeat 消息解码会让字符串借用输入帧。与构造 owned String 的 Rust 路径相比,它避免了分配和复制;与新增的 Rust borrowed decode 相比,双方才具有更接近的内存语义。这比较的是当前内存语义和实现路径,不是脱离上下文的语言排名。
完整的本地 Mac 与 GitHub Actions 数据、工具链版本和测试方法见《fin-protoc 现在支持 C 与 Zig》。实际系统还应测量网络 I/O、业务校验、队列、日志和延迟分位数。
10 当前实现边界
- codec 接收完整帧,不负责 TCP 粘包与拆包。
- decoder 当前不自动验证 checksum,也不强制 BodyLength 与实际消费字节一致。
fc_string 借用输入缓冲区,不是 NUL 结尾,也不能超过输入帧寿命。- repeat 数量来自线上数据;当前 runtime 会先按 count 分配数组,再逐项读取。接入层必须限制 count,并检查它与剩余 Body 字节相容;只限制整帧长度并不充分。
- encoder 不会从 union 推导或校验 key;调用方必须保证
MsgType、body_tag、union 成员,以及深交所消息中的 ApplID、扩展体 kind、扩展 union 成员一致。
- 每个完整帧应从 reset 后的
fc_buffer 开始编码,再按需拼接到传输缓冲区。
11 结语
用 C11 实现沪深流式二进制协议,核心并不在于写出多少个结构体,而在于把协议边界变成稳定的工程约定:传输层负责完整帧与校验,codec 负责字段和变体,字符串借用输入帧,repeat 由对称的 free 管理,跨语言测试负责证明 wire bytes 一致。
这套设计保留了 C 的可移植 ABI 和低依赖优势,同时把最容易出错的字段排列与分派关系交给同一份协议定义维护。若要接入或复现,可以从 fin-proto-sse-bin-c 和 fin-proto-szse-bin-c 开始。如果你也在做类似的高性能二进制协议实现,欢迎来云栈社区一起讨论。
 发表于 昨天 20:14
|
查看: 11|
回复: 0
 /1


