给网页加一个「朗读」按钮,通常要三样东西:一个云服务的密钥、一段能联网的网络、一张按字符计费的账单。想自己部署,就要显卡、显存和几个 G 的权重。这篇讲的项目把这三样全砍了:8200 万参数,装完就能跑,还能在浏览器里用 wasm 跑完不联网。它凭什么这么小,代价又藏在哪儿。
先说一个很具体的场景。
你做了个小工具,文章列表,想给每篇加一个「听全文」。需求提出来,三条路摆在面前。
第一条是调云服务。注册、拿密钥、写请求、按字符付费。断网就哑,密钥泄露要换,月底看到账单才知道有人拿你的接口刷了几百万字。
第二条是自己部署。下权重,装 CUDA,拉一个推理服务,租一台带显卡的机器。为了一个「朗读」按钮养一台 GPU,怎么算都不划算。
第三条是找一个能在浏览器里跑完的模型。不用服务器、不用密钥、不用联网,页面打开就能出声。
这条路过去基本走不通。语音合成是个吃算力的活,能出声的模型动辄几亿到几十亿参数,塞进浏览器就是让用户先下一个几百兆的包。
这篇要讲的 Kokoro,是少有的真能走通第三条路的项目。
它的体量是 8200 万参数,输出 24kHz 单声道,模型权重是 Apache 2.0,商用不用打招呼。作者在模型卡里写了一组更刺眼的数字:训练一共烧了 1000 小时 A100 80G,按当时市价合 约 1000 美元。
一千美元。这个数字比「8200 万参数」更能说明问题:它不是把一个大模型硬压小的,它是换了一条路走。
装起来是这样的:
from kokoro import KPipeline

pipe = KPipeline(lang_code='a')          # a = 美式英语
for gs, ps, audio in pipe("Hello there.", voice='af_heart'):
    print(ps)                             # 音素
    # audio 是 24000 Hz 的 float 数组
在浏览器里则是另一套:kokoro-js 把模型转成 ONNX,配合 transformers.js 跑。量化版有 q8 和 q4 两档,后端可以选 wasm 或 WebGPU。也就是说同一份权重,既能在一个 Python 进程里跑,也能在一台没装任何东西的笔记本上,靠浏览器跑完。
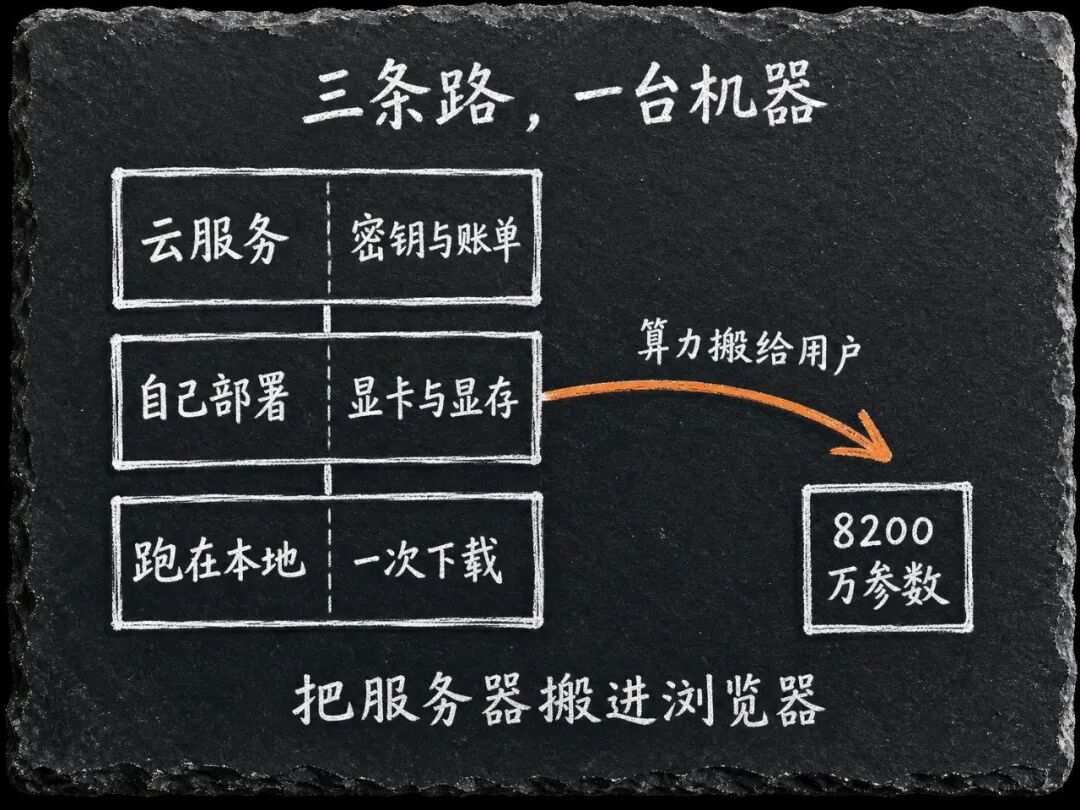
三条路的差别不在便宜多少,在「谁承担算力」。云服务让服务商承担,自己部署让自己承担,而这个模型想让用户自己的浏览器承担。
一、整条流水线是四段,但代码里的顺序是倒着的
要理解它为什么能这么小,得先看清它由几块拼成。
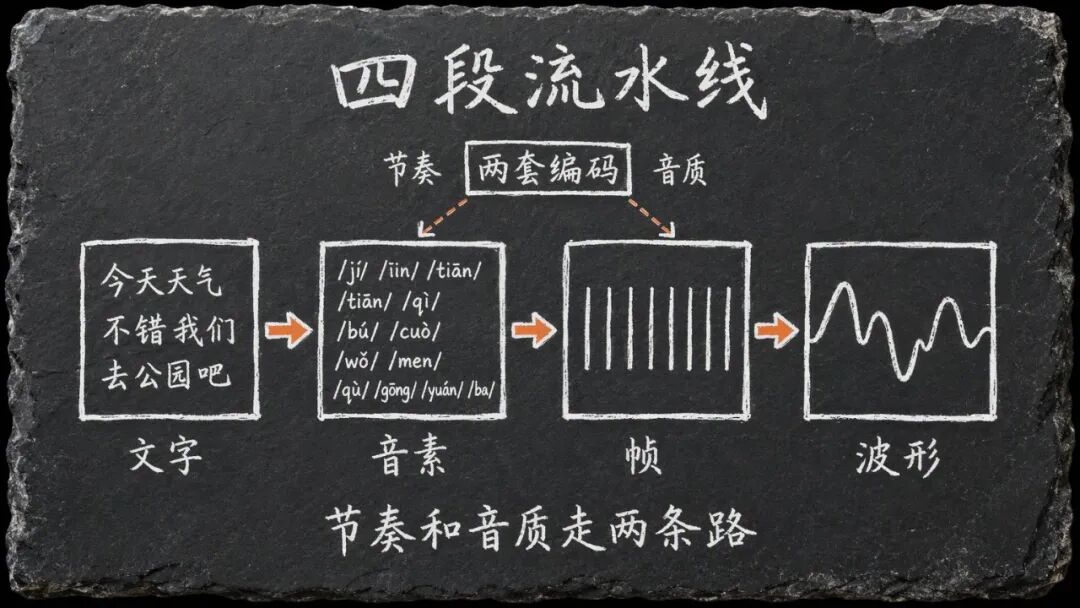
从一句话到一个 wav,中间有四段:
文字变成音素。 把「thought」变成 /θɔːt/。这一段做的是查词典、处理例外、把拼写不规则的东西读对。
音素变成时长。 每个音素占多长时间,哪里停顿,哪里拖长。
时长变成帧。 把「音素级」的信息铺开成「帧级」:一个音素占几帧,就复制几份。
帧变成波形。 最后一步才是真正出声的活儿。
绝大多数介绍文章会告诉你「这四段分别是某某模块」。但真正有意思的是代码里的调用顺序:它跟这四段正好相反。
打开 KModel.forward_with_tokens,前几行是 BERT,接着 bert_encoder,然后立刻就是时长预测:
bert_dur = self.bert(input_ids, attention_mask=(~text_mask).int())
d_en = self.bert_encoder(bert_dur).transpose(-1, -2)
s = ref_s[:, 128:]
d = self.predictor.text_encoder(d_en, s, input_lengths, text_mask)
x, _ = self.predictor.lstm(d)
duration = self.predictor.duration_proj(x)
duration = torch.sigmoid(duration).sum(axis=-1) / speed
pred_dur = torch.round(duration).clamp(min=1).long().squeeze()
注意 self.text_encoder(...)——模型里那个专门编码文本的模块——要到十几行之后才出现。
也就是说:算时长用的不是「文本编码器」的输出,是 BERT 的隐状态。
模型里有两套文本编码。一套是 BERT(CustomAlbert,12 层,768 维隐层),它的输出喂给韵律预测器,负责「这句话该怎么读」;另一套是 TextEncoder(几层卷积加一个双向 LSTM),它的输出喂给解码器,负责「这句话该是什么音色」。
一套管节奏,一套管音质,各干各的。这个分工不是 Kokoro 发明的,是从 StyleTTS 2 继承下来的,但它解释了很多后面会遇到的现象。
二、它砍掉的第一个部件:扩散
StyleTTS 2 原版里,有一段专门负责「这句话用什么语气读」。
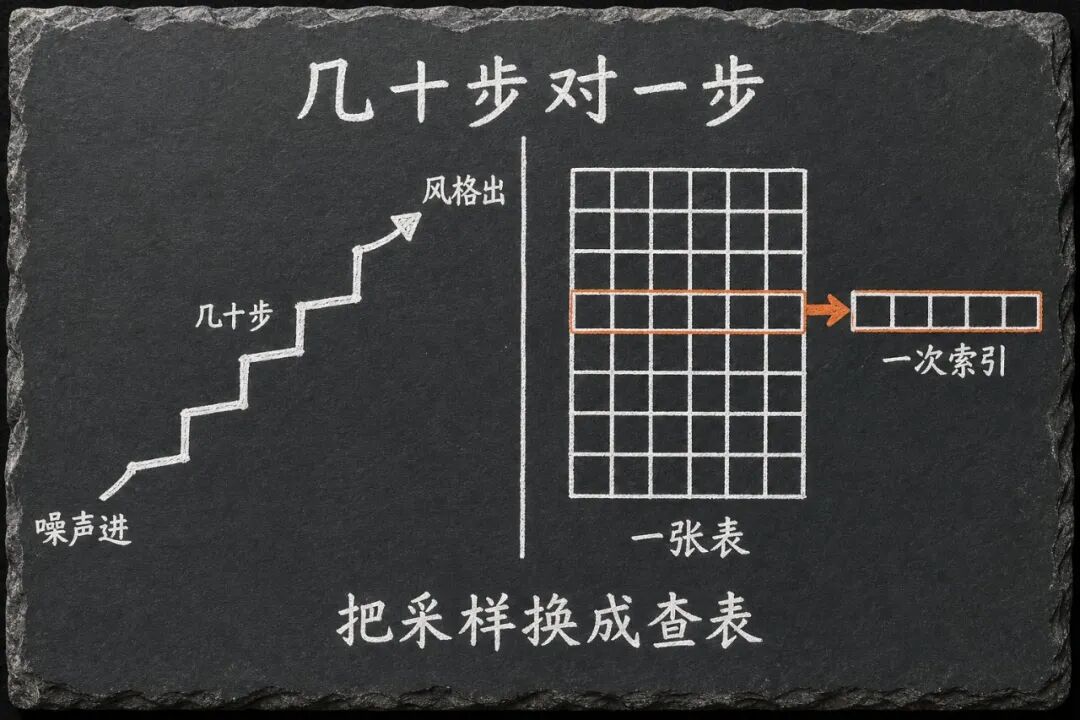
做法是从一团高斯噪声开始,反复去噪,几十步之后得到一个 256 维的向量。这个向量决定了整句话的音色、语速、情绪起伏。这套东西叫风格扩散(style diffusion),效果很好,代价也很直接:每生成一句话,就要多跑几十次前向。
Kokoro 把这一整段删了。
模型卡上写得很干脆,一行字:Decoder only: no diffusion, no encoder release。只放解码器,没有扩散,也没有放编码器。
删掉之后,那 256 维的风格向量从哪来?
从一张表里查。
推理时那一行代码是这个样子:
def infer(model, ps, pack, speed=1):
    return model(ps, pack[len(ps) - 1], speed, return_output=True)
ps 是音素串,pack 是音色包。取的是 pack[len(ps) - 1]——按这句话的音素个数,去查表里的第几个槽位。
这就不是「采样」了,是「索引」。一步到位,没有迭代,没有随机性。
这一步替换,是整篇文章的钥匙。后面所有的「为什么这么小」「为什么这么快」「为什么它做不了某些事」,都能从这里推出来。
先说说它顺手丢掉了什么。
扩散那一套存在的理由是:一句话该怎么读,本来就没有唯一答案。同一句「今天下雨」,可以是随口的,可以是无奈的,可以是念给机器的。扩散从不同的噪声出发,每次落在不同的语气上——这种不确定性,恰恰是「像人」的来源。人说话,同一句话两次也不会一模一样。
删掉扩散之后,这份不确定性也一起没了。同一句话、同一个音色、同一个速度,跑两遍出来的波形几乎完全一致,唯一的差别来自谐波源那点随机初始相位。
对做产品的人是好事:输出稳定,能缓存,能复现 bug,能拿两段音频做逐字节对比。对想「让机器读得像个人」的人是损失:它不会给你惊喜,也不会给你那一丝自然的口误和犹豫。
这就是交易的第一笔账。后面还有好几笔。
三、那张表长什么样
我去把 af_heart.pt 下下来拆开了。它是 523 KB 的一个文件,里面就是一个张量:
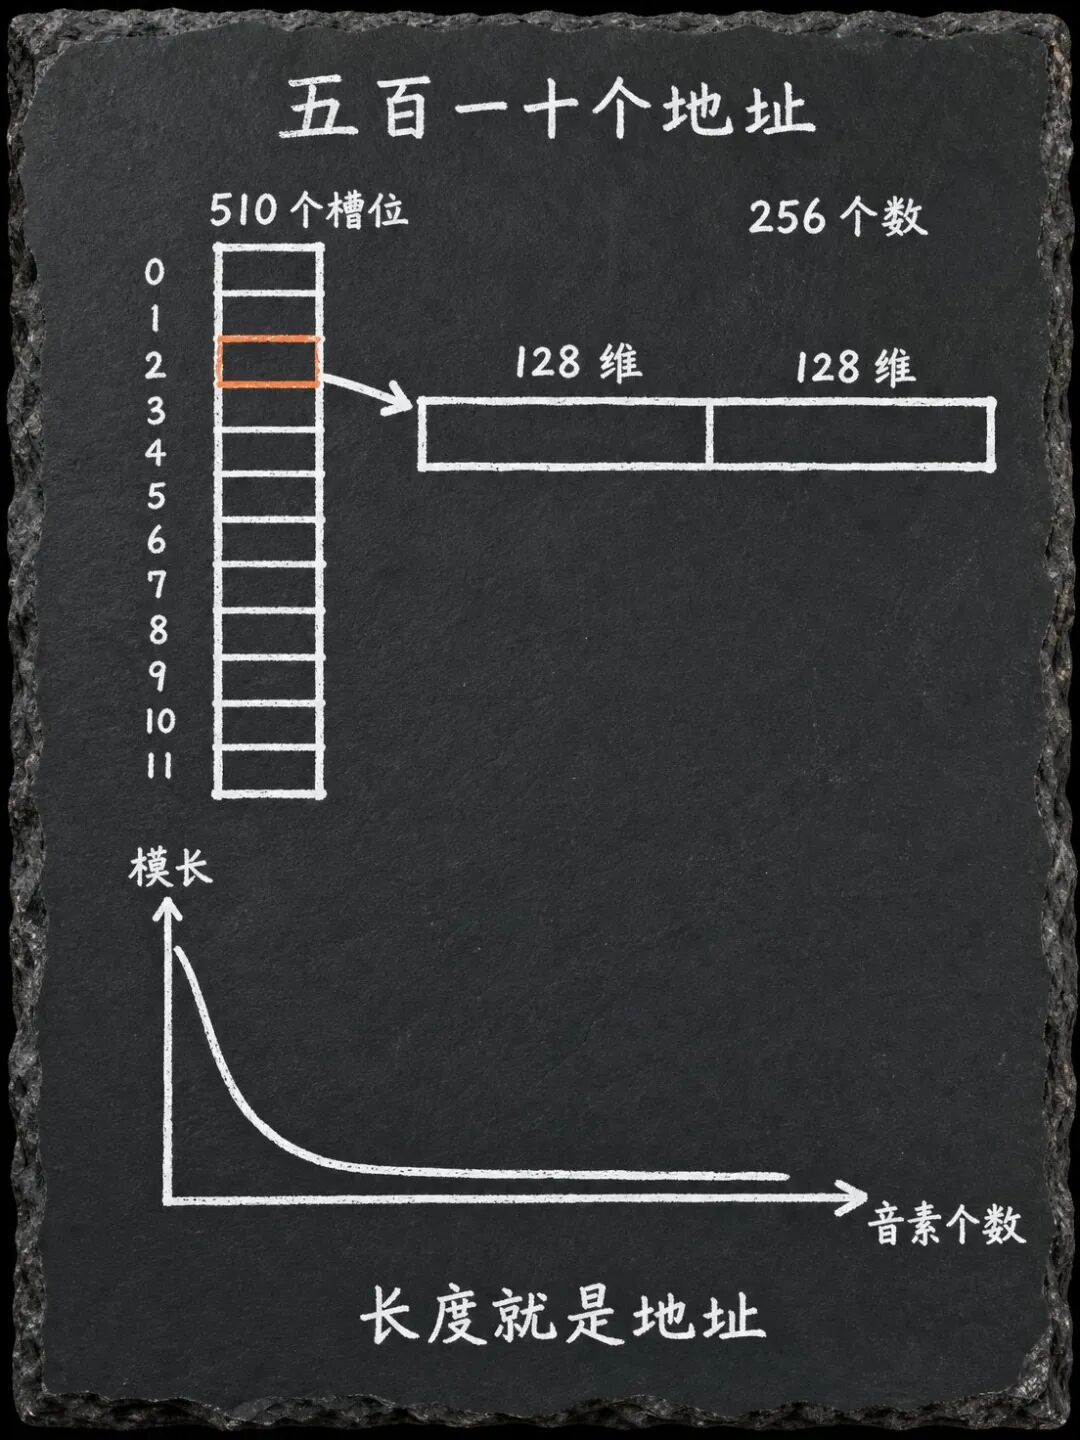
形状是 510 × 1 × 256,float32。
510 个槽位,每个槽位 256 个数。取哪一行,由「这句话有几个音素」决定。
510 这个数不是随便定的。BERT 的位置编码上限是 512(max_position_embeddings),模型在音素串首尾各加一个特殊符号,剩下正好 510。也就是说:510 不是「模型能读多长」的设计选择,是 BERT 的位置表给它划的边界。
现在把这 510 个槽位逐个量一遍,看它们的「长度」(向量的模)随槽位怎么变。结果比我预想的整齐得多:
| 槽位 |
整行模长 |
前 128 维(解码器) |
后 128 维(韵律) |
| 第 0 个(1 个音素) |
7.81 |
2.28 |
7.47 |
| 第 2 个 |
6.23 |
2.03 |
5.89 |
| 第 10 个 |
4.27 |
1.78 |
3.88 |
| 第 50 个 |
2.57 |
1.61 |
2.01 |
| 第 100 个 |
2.28 |
1.59 |
1.63 |
| 第 200 个 |
2.23 |
1.59 |
1.56 |
| 第 509 个(最长) |
2.24 |
1.59 |
1.57 |
三件事一眼能看出来。
第一,相邻槽位几乎一样。 相邻两行的平均绝对差是 0.0007,而单行的数值分布标准差是 0.15——差了两个数量级。换句话说,第 300 行和第 301 行在数值上几乎是同一行。
第二,真正有变化的只有最前面二十来个槽位。 从第 100 个往后,模长稳在 2.24 附近,一直到第 509 个都没有起伏。整张表像一条开头陡降、后面拉平的曲线。
第三,陡降全发生在后半段(韵律那 128 维)。 前 128 维从 2.28 只降到 1.59,降了三成;后 128 维从 7.47 掉到 1.56,差了将近五倍。
所以这张表不是「510 种语气」。它是同一条风格向量在 510 个长度刻度上的采样,而且只在「短句区」有剧烈变化。
这解释了一件本来很玄的事。作者在音色文档里写:大多数音色在 100 到 200 个 token 之间表现最好,句子太短(不到 20 个 token)会明显变弱,太长(超过 400)会「赶」。
「短句弱」是能从数据里看出来的:一句只有几个音素的话,查到的韵律向量模长是 7.47,是长句的四倍多。这个向量被硬塞进韵律预测器,等于给了一个远超正常范围的语调指令。
它是不是一种「补偿」,作者没解释过,我不替他下结论。但至少,当你发现「同一句话改一个词、长度变了一档、语气跟着跳了」,原因就在这里——长度不只是影响输出的长短,它直接换了一行参数。
这张表在整个系统里的地位很特殊:它是唯一可以被替换的零件。
模型权重是死的,8200 万个参数训练完就定了;文本处理在别人家;解码链路是数学。只有音色包是一个独立于权重的文件,换成谁就是谁。
体积也不占地方。af_heart 是 523 KB,54 个音色全下下来也不到 30MB——比一张手机照片大不了多少。所以你完全可以把几个常用的音色包存在自己的目录里,用本地路径直接指过去(voice 参数除了名字,也接受 .pt 路径),不必每次都从网上下。
代价是:想造自己的音色包,得先有编码器。而模型卡明说编码器没放出来。所以这张表里的 54 个槽位是封闭的——你能选,不能加。
四、一条向量,半条嗓子,半条节拍
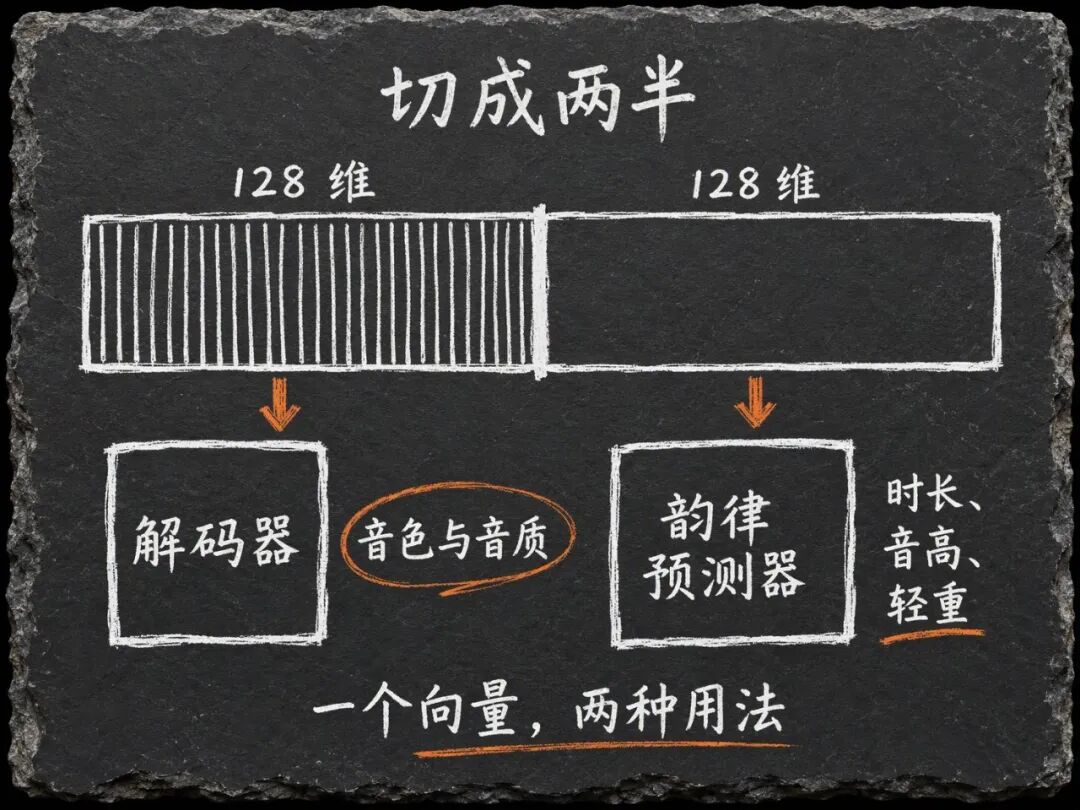
那 256 个数不是一坨。它被切成两半,分别送到两个地方:
- 前 128 维,喂给解码器,管音色和音质;
- 后 128 维,喂给韵律预测器,管时长、音高、轻重。
代码里这两处切得很清楚:ref_s[:, :128] 进解码器,ref_s[:, 128:] 进预测器。
这个切法带出两个很实用的推论。
你没法只要音色、不要语气。 因为它们是同一个向量里切出来的。换一个音色包,换掉的是整套习惯——语速、句尾怎么收、重音放哪,全变。你不可能「用 A 的嗓子、B 的语速」,除非自己动手改表。
混合音色是逐位取平均。 用法上写一个逗号就行:
pipe(text, voice="af_bella,af_jessica")
内部做的是把两个 510×256 的表叠起来,对每个位置求平均。所以混出来的声音不是「像两个人的中间态」,而是「两套嗓子加两套节奏的平均值」——平均值经常落在两个人都不像的地方,听起来有种说不出的怪。
这也说明音色在这儿不是「身份」,是「参数」。它没有「这是谁」的概念,只有「这组数」。
五、每个音素占几帧,谁说了算
音素串进模型之后,第一个要算的是「每个音素占多长时间」。
做法在 ProsodyPredictor 里,很朴素:
duration = self.duration_proj(x)              # 每个音素出 50 个数
duration = torch.sigmoid(duration).sum(-1)    # 过 sigmoid 再求和
pred_dur = torch.round(duration).clamp(min=1)
duration_proj 给每个音素输出 50 个分量,每个分量过一遍 sigmoid 变成 0 到 1 之间的数,然后全部加起来,就是这个音素占的帧数。
不是取最大值,是求和。可以理解成:50 个分量各自代表「再占用一帧的概率」,加起来就是总共要用几帧。所以单个音素最多 50 帧,这是硬上限——想拉一个很长的「啊——」,超过就没了。
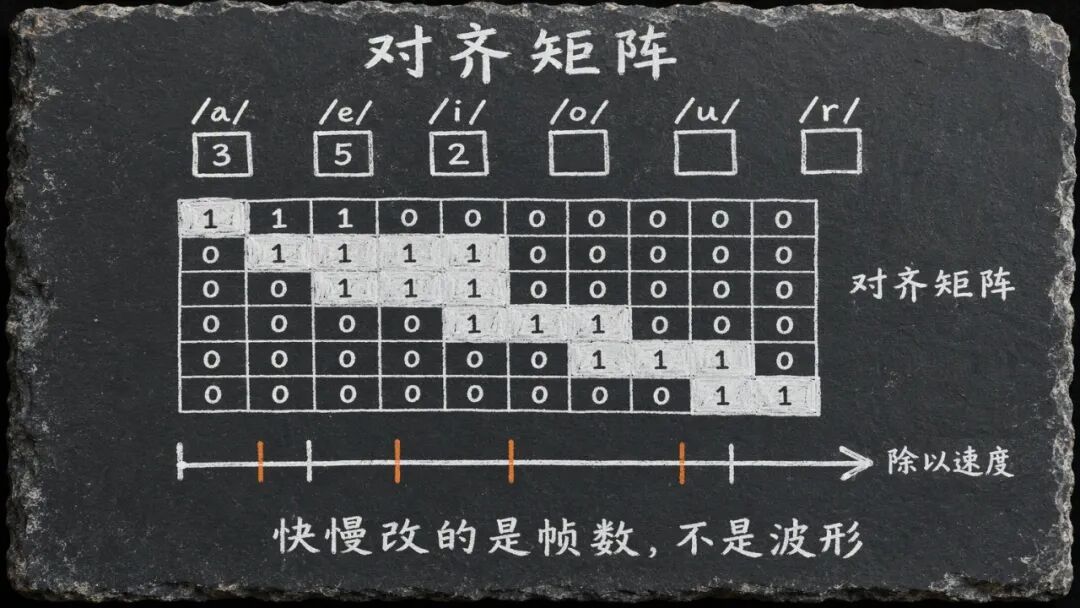
拿到帧数之后,要把「音素级」的隐状态铺成「帧级」。做法是造一个 0/1 的对齐矩阵,一个音素占几帧就在那几列上填 1,然后矩阵乘一下:
indices = torch.repeat_interleave(torch.arange(T), pred_dur)
pred_aln_trg = torch.zeros((T, indices.shape[0]))
pred_aln_trg[indices, torch.arange(indices.shape[0])] = 1
这一步是整个模型里唯一像「排版」的地方:它决定每个字在哪一帧开始、哪一帧结束。
而 speed 参数就插在这一步:
duration = torch.sigmoid(duration).sum(axis=-1) / speed
注意它除的不是波形,是帧数。
这就是为什么调 speed=1.5 只是变快、不变调。很多「变速」工具是把已经录好的波形重采样,采样率一变,音高跟着变,人声就成了花栗鼠。这里改的是「每个音素占几帧」,帧数少了,音高曲线还是那条曲线,只是被压短——所以音高一个都没动。
speed 甚至可以传一个函数,按每段的音素个数返回不同的速度。长段快一点、短段慢一点,用来对冲它「长句赶、短句弱」的毛病。
顺手说个做字幕的人一定会用到的东西。
这个模型把每个音素占几帧算出来了,那「每个字在第几秒」其实已经现成。join_timestamps 就是干这个的:把帧数累加起来,除以一个常数,得到时间戳,直接写到每个词上(start_ts / end_ts)。
那个常数是 80。为什么是 80,代码里给了注释:帧要乘 600 才是 24000 的采样数,等价于帧数除以 40 就是秒数;而这里按「半帧」记账,所以除数变成 80。
半帧记账是为了处理空格。一句话里词与词之间有停顿,这个停顿在时间轴上该分给前一个词还是后一个词?它选的做法是一个空格切成两半:前半截算前一个词的尾巴,后半截算后一个词的开头。这样逐字高亮的时候,光标不会在词与词之间愣住。
还有两处小地方挺真实。开头那个 max(0, pred_dur[0] - 3) 是在扣掉句首特殊符号占的帧,减 3 这个数是试出来的,代码旁边留了一句 TODO: Is -3 an appropriate offset?——作者自己也不确定。另外整段循环前后各跳过一帧,因为首尾各有一个特殊符号,不对应任何实际发音。
一段能用的逐字字幕,靠的就是这种地方。没有这一步,你只能按字数比例估时间,长句短句一律不准,字幕永远慢半拍。
六、音高和轻重,是两条一维曲线
时长定了,接下来定「怎么念」。
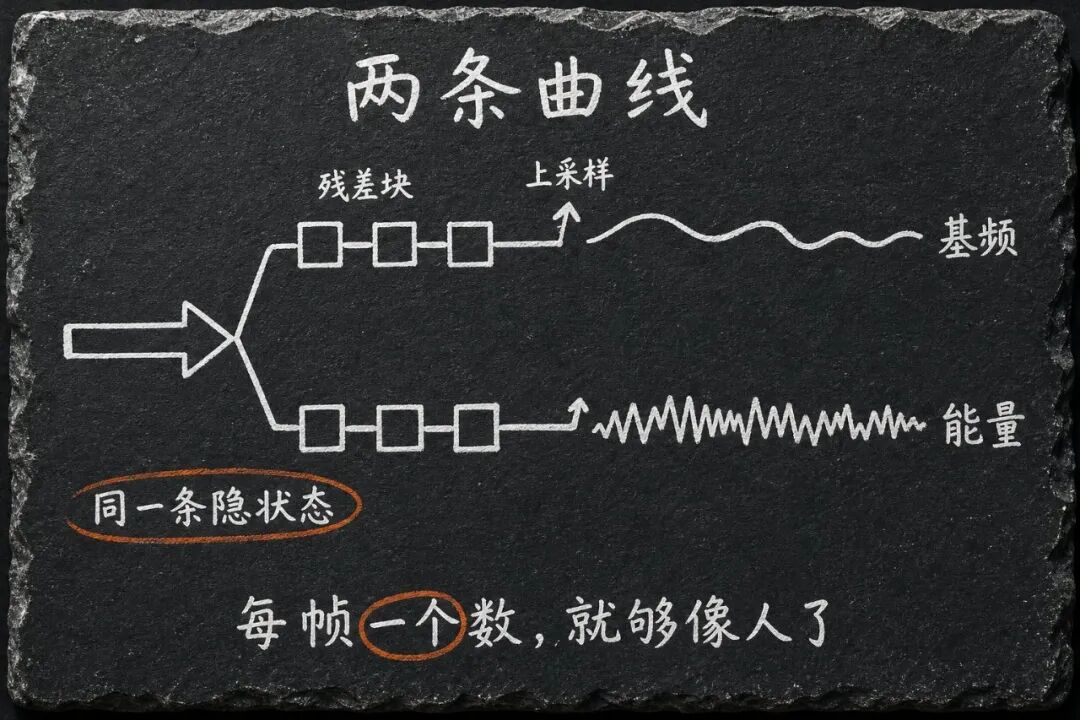
对齐之后的帧级隐状态,同时喂进两条支路,每条三个残差块,中间上采样一次,最后各出一个数:
- 一条出 F0,基频曲线,也就是音高;
- 一条出 N,噪声或者说能量曲线,管气声、轻重、清浊。
两条都是 1 维的——每一帧一个数字。就这么简单。
但人声「像不像人」,一半在这两条线上。同样一句话,F0 曲线平滑就是念稿,起伏大就是有情绪;N 曲线在该出气的地方塌下去,「s」和「z」、「p」和「b」立刻就分开了。
这里有个容易忽略的设计:这两条曲线是预测出来的,不是从音素表里查的。同一个音素,在不同句子里会有不同的 F0 和 N——「好」在句尾会降,「好」在疑问句里会升。这些不需要人写规则,模型自己从数据里学。
七、音高不是算出来的,是喂进去的
这是整套设计里最反直觉的一步。
按直觉,模型应该「学会」怎么产生振动:给它音高,它自己合成一个周期波形。
Kokoro 没这么做。它用一个叫 SineGen 的东西,直接把振动造出来给模型。
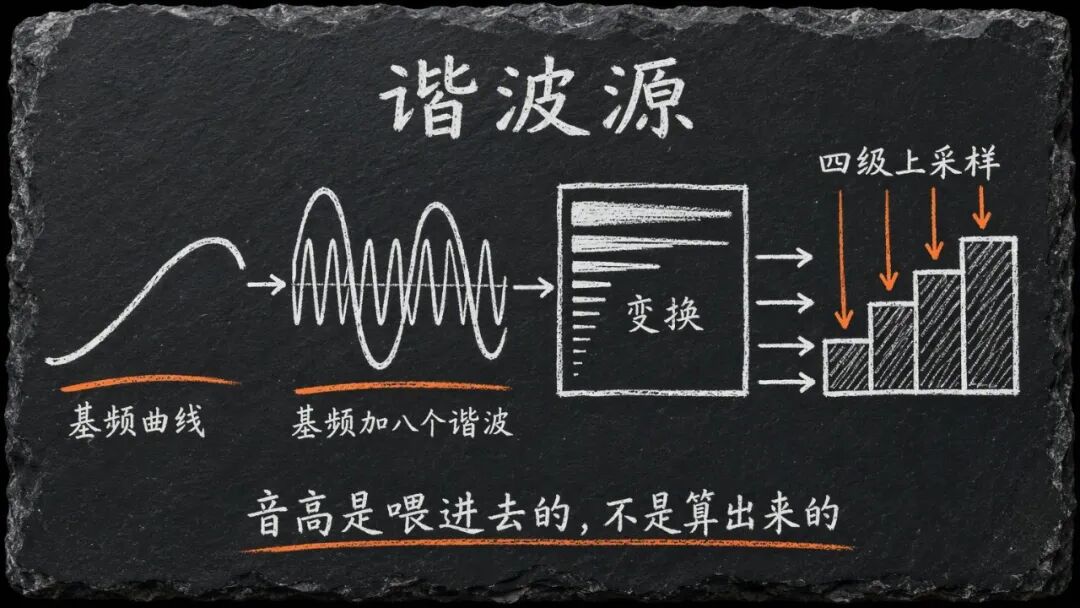
做法是:拿到 F0 曲线,先在时间轴上放大 300 倍,然后按每一帧的频率累加相位,生成一条正弦波;再叠上 8 个谐波(harmonic_num=8),得到一个「梳子」——基频加八倍频,像一把齿距均匀的梳子。
几个细节很妙:
相位用累加,不用 sin(2πft) 直接算。 因为频率是逐帧变的,直接代入公式会在帧边界产生相位跳变,听感上是「咔」的一声。累加能保证波形连续。
初始相位随机,但基频那一路固定为 0。 代码里是 rand_ini[:, 0] = 0。所以同一句话读两遍,谐波的起始相位不同(微观上有差异),但基频的相位永远对齐(音高不会漂)。
F0 低于 10 就给噪声,不给正弦。 这一行是 uv = (f0 > self.voiced_threshold),阈值 10Hz。这就是「有声」和「气声」在源头上的分界——「s」本来就没有基频,给它正弦反而错了。
造出来的梳子,过一遍短时傅里叶变换,变成一张「激励谱」,然后逐级注入每一个上采样层。解码器的每一级都会把这张谱卷一下、加到自己身上。
这个设计的意义在于:模型不需要从零学「怎么产生周期性振动」这件物理上很贵的事。它拿到的是一个已经带好音高的激励,只要学「怎么把这个梳子滤成人声」——后者是滤波,前者是生成,难度差一个量级。
8200 万参数能出声,物理原因在这儿。
八、解码器不是 GAN,是反着做一次傅里叶
最后一步,把帧变成波形。
现在主流的声码器基本是 GAN:一个生成器出波形,一个判别器判断像不像真的,两边对抗着训。HiFi-GAN 就是这么干的。
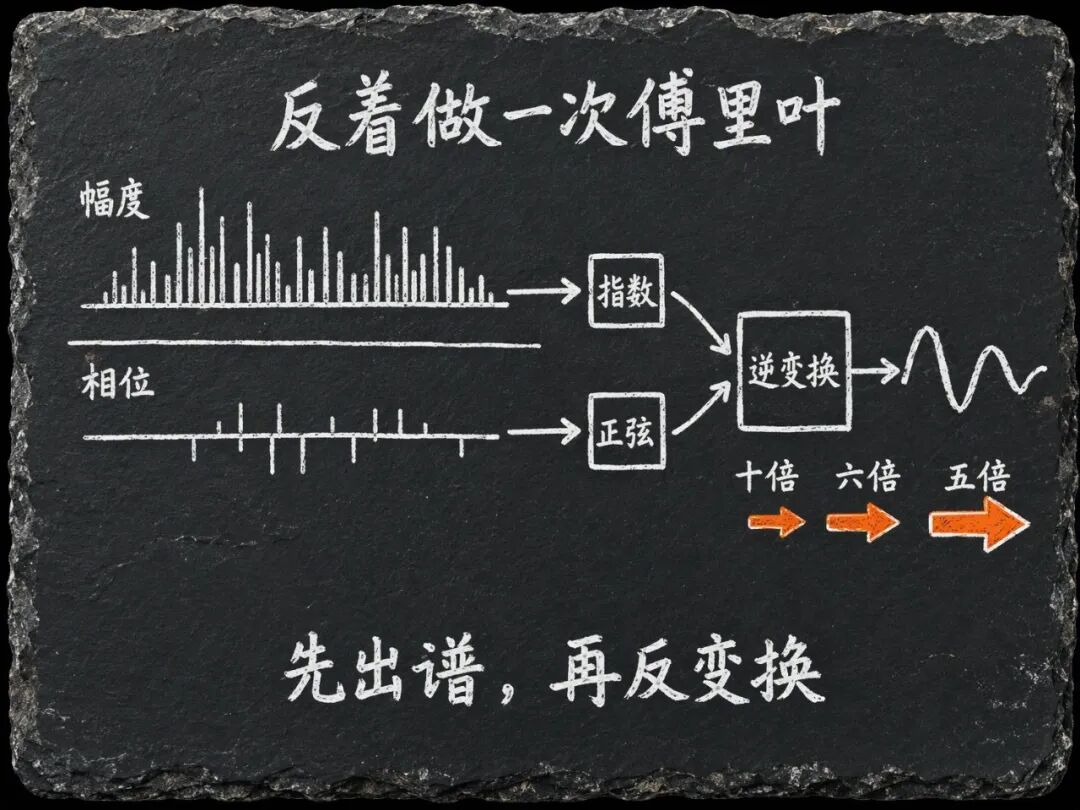
Kokoro 用的不是这个。它用的是 iSTFTNet,思路完全不同:先预测一张频谱,再做逆变换变回波形。
最后一层卷积输出 22 个通道,正好拆成两半:
- 前 11 个是幅度,过一个
exp() 变成正数;
- 后 11 个是相位,过一个
sin()。
为什么是 11?因为傅里叶变换的窗长 n_fft 是 20,单边谱就是 20/2+1 = 11 个频点。窗长 20,跳步 5——这是个非常小的窗,小到不像是给语音用的。
相位那一步值得单独说。正常做法是直接回归相位值,但相位是个角度,本身没有「大小」的概念,网络学起来很别扭。这里的处理是 phase = sin(x):网络输出一个数,取正弦,结果天然落在 -1 到 1 之间,正好是单位圆上的投影。用一个约束把「角度」变成了「正弦值」,网络只需要学「该往哪个方向偏」。
算完这两张图,做一次逆短时傅里叶变换,就把 11 个频点还原成了 5 个采样点。前面还有两段上采样,10 倍和 6 倍。乘起来:10 × 6 × 5 = 300 倍。
窗长 20 这个数字,值得停一下。
常规声码器做频谱,窗长一般 1024 起步,因为要一次看清一整段波形里的周期。这里只有 20 个采样点——短到几乎看不出周期。
原因在于位置:这一步不是从零开始画波形,它已经站在 60 倍上采样的末端了。上一层送过来的东西,时间分辨率已经被拉得很细,相邻两帧之间只隔 5 个采样点。到这一层,谱要回答的问题不再是「一秒里有哪些频率」,而是「这五个采样点之间该怎么连」——问题变小了,窗自然也可以变小。
窗小带来的是算力。一次 20 点的变换,和一次 1024 点的变换,差着两个数量级。一个要跑在浏览器里、要跑在手机上的模型,省的就是这些地方。
为什么不用 GAN?三个理由,都很实际:
GAN 的输出不可控。 判别器说「像」,不代表频谱对。出了问题你只能听,看不到中间发生了什么。而 iSTFT 这条路,中间那两张图(幅度、相位)人是能看的,能画出来、能对比。
GAN 难导出。 判别器只在训练时用,但生成器里的激活函数、归一化层在 ONNX 里经常出岔子。iSTFT 是一条确定性的数学链路,好导。
GAN 会「编」。 判别器逼着生成器补细节,补出来的东西不一定在原始音频里。iSTFT 补不出东西来,它只能还原你给它的谱。
仓库里专门有一个 custom_stft.py,就是为了这件事写的。它用一维卷积手写了一遍 STFT,用转置卷积手写了一遍逆变换,绕开 F.unfold 和复数运算——文件开头的注释写得很直白:为了避免 F.unfold,这样更容易导出到 ONNX。代价是 padding 从 reflect 换成了 replicate,因为 ONNX 不支持动态形状下的 reflect。
一个能进浏览器的模型,是从这些地方一点点抠出来的。
九、510 个音素的天花板,和一套瀑布式断句
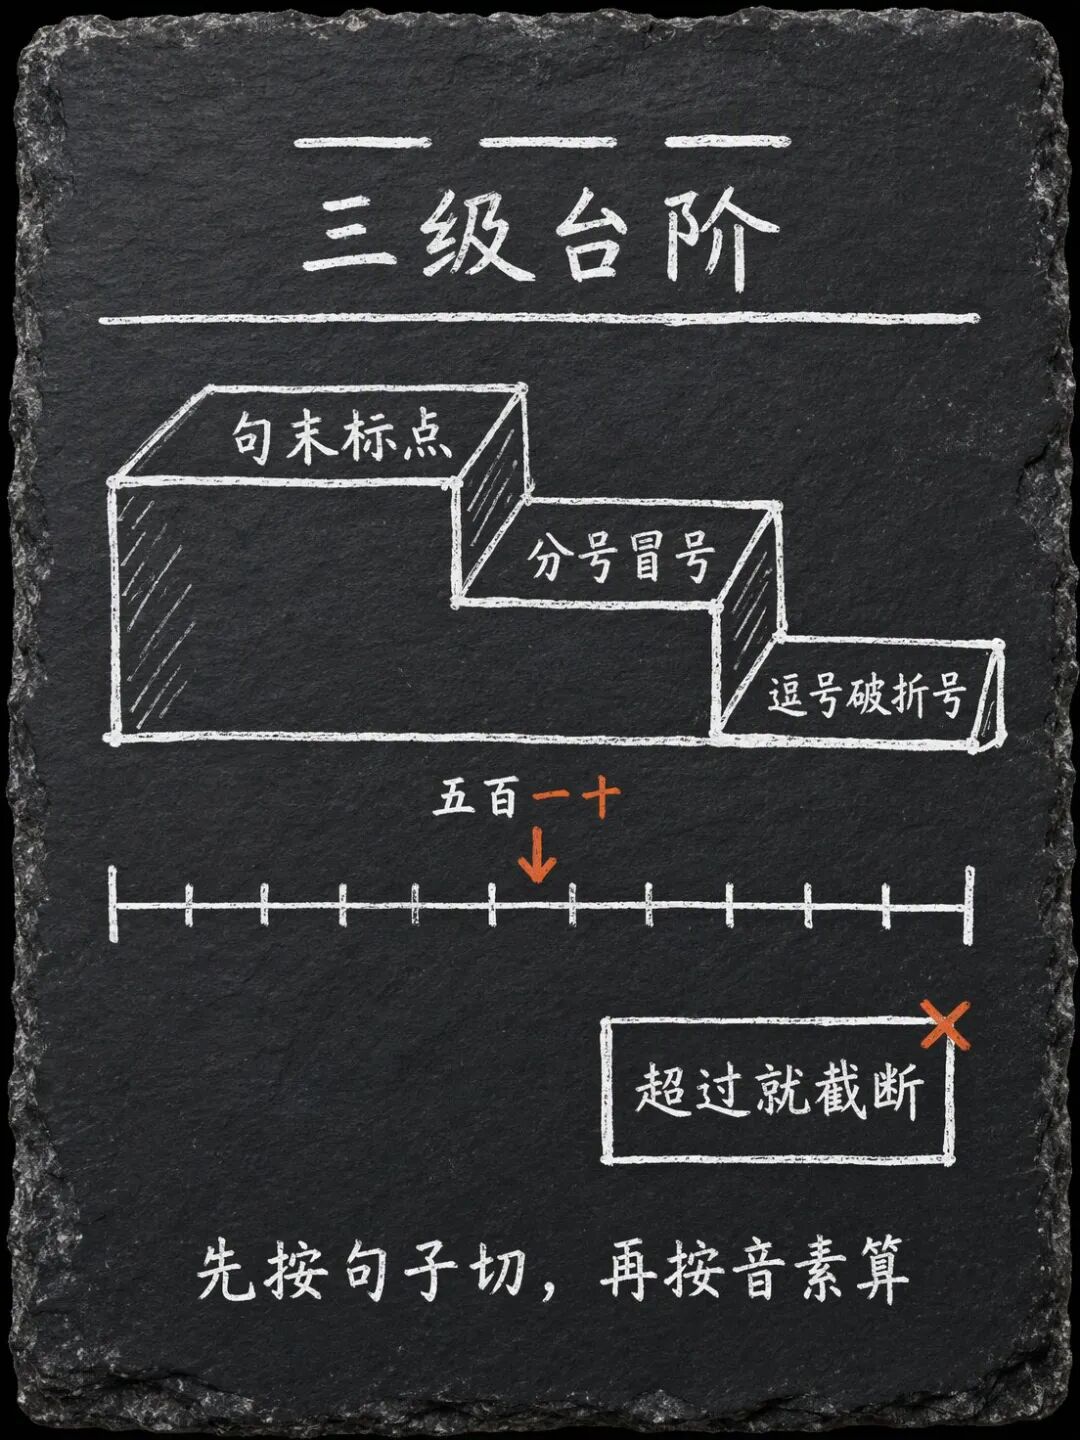
前面说过,510 是 BERT 位置表划的边界。超过会怎样?
日志里会出现一行 warning,然后直接截断。话就没了。
好在这种事很少真的发生,因为在到这一步之前,文本已经被切过一轮了。
切法在一个叫 waterfall_last 的函数里,思路像瀑布分级:
先找句末标点(. ! ? …)。从后往前扫,找到最后一个,试着在那儿切;切完之后剩下的音素数如果不超过 510,就认。
不行就降一级,找分号和冒号(: ;)。
再不行降一级,找逗号和破折号(, —)。
三级都不行,返回整段——也就是放弃治疗,让后面的截断发生。
还有一个更细的保护:切点算完,要看切点后面那个符号是不是右引号或右括号。如果是,切点往后挪一格——别把收尾的引号和它引的那句话拆开。
这三种标点构成一条瀑布,是有道理的。句末断开,听感上是一句话结束;从句断开,是半句话喘口气;逗号断开,是词中间撕开。宁可让一句话短一点,也不要在一口气中间切。
中文走的却是另一条路。代码里对非英语语种的处理是:先按句号问号感叹号切成句子,再按 400 个字符的容量拼块,最后才算音素。两条路用的尺子不一样——英文按音素切,中文按字符切。
所以你在中文长文上遇到「句子读到一半断了」,原因不一定是 510,可能只是撞上了那个 400 字符的块边界,而且块的末尾不一定落在句号上。
十、从文字到音素那一段,不在这个仓库里
写到这里要泼一盆冷水:这个仓库只做「音素到波形」。
把文字变成音素的那一段,在另一个项目里,叫 misaki。
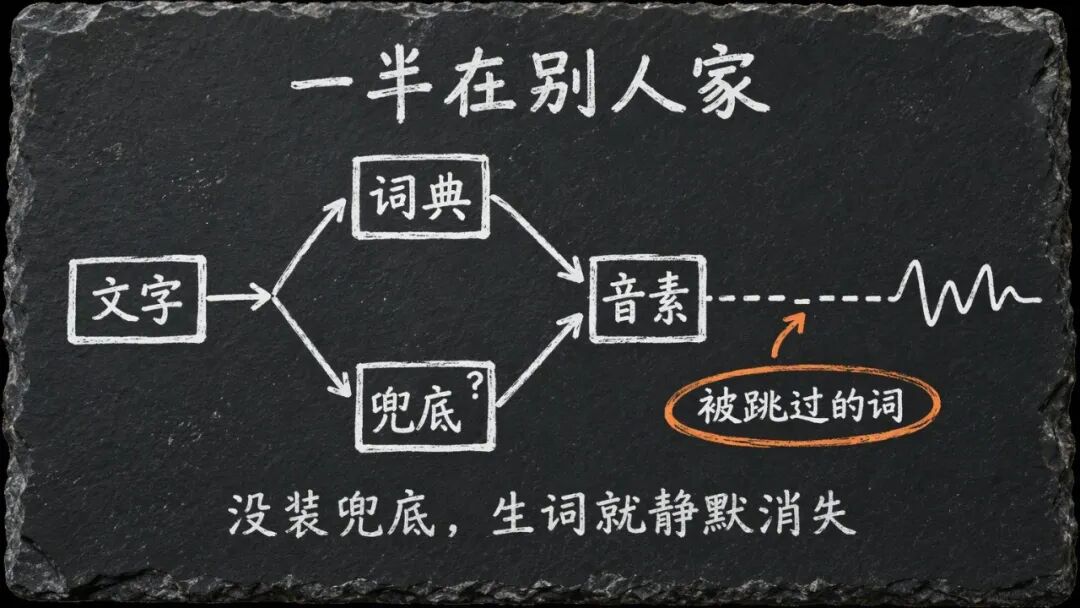
英文的处理是:先查词典(常见词的读音直接查),查不到的生词交给 espeak-ng 兜底。espeak 是个老牌的规则合成器,读音不算好听,但覆盖面广,专门处理「没见过的东西」。
问题出在这一行:
self.g2p = en.G2P(trf=trf, british=..., fallback=fallback, unk='')
unk=''——未知音素,给空字符串。
空字符串的意思不是「报错」,是「当它不存在」。如果你的机器上没装 espeak-ng,初始化时只会打一行不痛不痒的 warning(「EspeakFallback not Enabled: OOD words will be skipped」),然后所有生词在合成时被静默跳过。
不抛异常,不中断,音频照常生成。只是那句话里少了几个词。
这是整条链上最阴的一个坑:输出是合法的,内容是错的。 你听到的是一句语法通顺、但丢了主语的话,而且没有任何报错提示你。
非英语语种的情况更直接。西班牙语、法语、印地语、意大利语、葡萄牙语这五种,直接用 espeak 的音素,代码里明写了一句「分句逻辑还没实现,长文本可能被截断,除非你自己按换行切开」。
中文和日文是例外,走 misaki 的专门实现,要另外装:pip install misaki[zh]、misaki[ja]。
所以这个项目的边界很清楚:它把「怎么把音素念得好听」做到了 8200 万参数能做的极限,但「怎么把字读对」这件事,一半在别人家,一半在你的环境配置里。
装完之后第一件事,不是调参数,是确认 espeak-ng 真的装上了。
十一、它把音色的底牌摊在桌上
大部分语音项目的音色列表是这样的:十几个名字,几段试听,你听着挑。
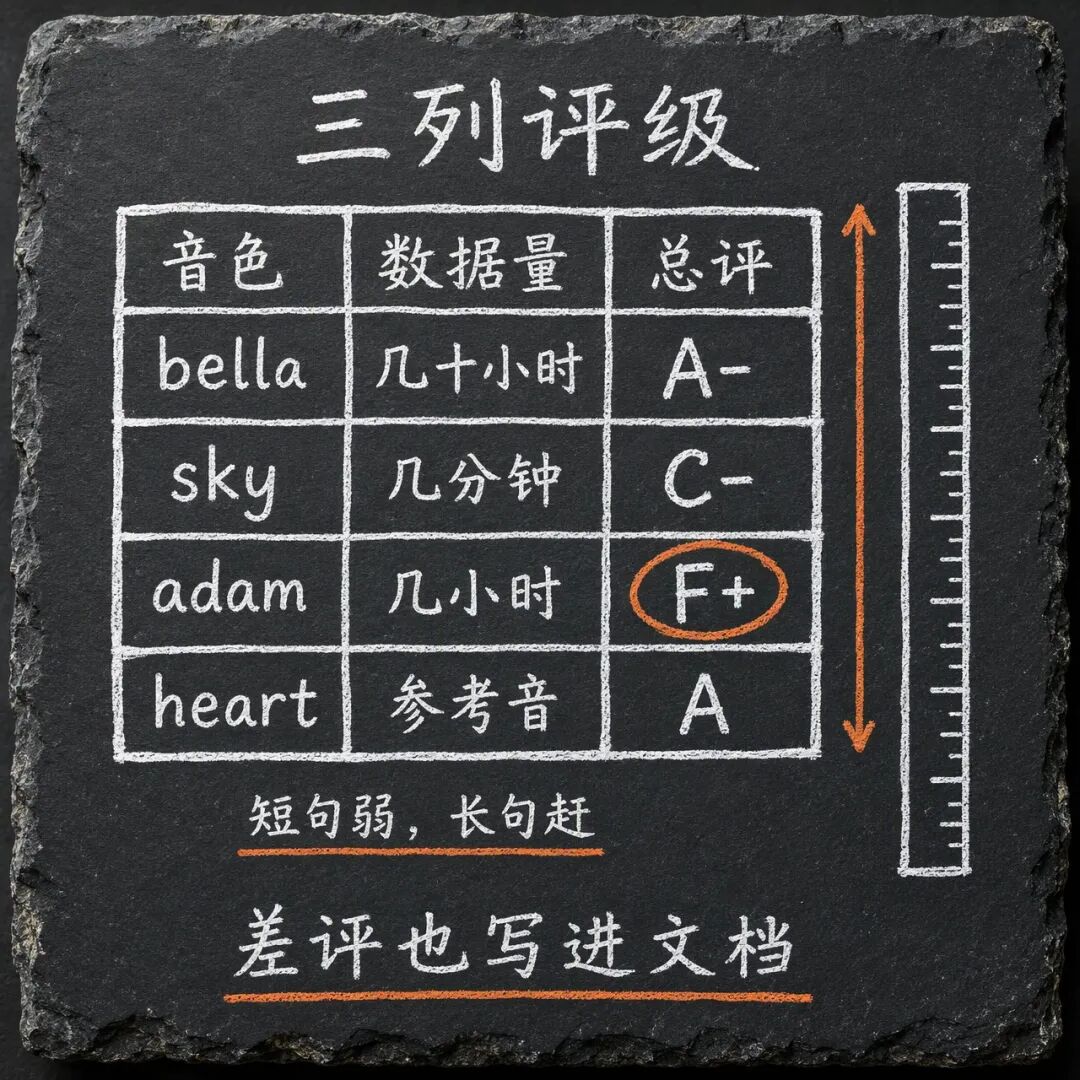
Kokoro 的音色文档是一张表,每个音色三列:
参考音质量(训练用的那段音频本身有多干净)、训练时长(这个音色见过多少音频)、总评。
三个真实的行,能看出这套评级有多不留情面:
| 音色 |
参考音质量 |
训练时长 |
总评 |
| af_bella |
A |
几十小时 |
A- |
| af_sky |
B |
几分钟 |
C- |
| am_adam |
D |
几小时 |
F+ |
af_sky 只见过几分钟的音频,总评掉到 C-。am_adam 的参考音质量评为 D(意思是那段音频本身就不干净),就算有几小时数据,总评也是 F+。
命名规则也写明了:a 是美式英语、b 是英式、f 女声、m 男声。所以 af_heart 是美式英语女声、代号 heart。
v1.0 一共 8 种语言、54 个音色。其中总评为 A 的只有一个——af_heart,作者自己的参考音。
这套表的价值不在于「告诉你哪个好听」,而在于它把「为什么这个声音不好听」变成了可查的因果。
一个音色发闷、拖沓、偶尔糊字,你不必猜是模型的问题还是数据的问题——翻到表里,看它的训练时长是不是只有几分钟。是,那就是数据不够,怪不着架构。
文档里还写了一条很具体的经验值:大多数音色在 100 到 200 个 token 之间最好。低于 20 会弱,高于 400 会赶。这句话基本就是一本使用手册——短句别单发,攒几句一起念;长段别硬塞,切开再拼。前面讲 speed 能传函数,也是为了这件事。
另一个容易踩的地方是音色和语言的搭配。KPipeline(lang_code='a') 是英语管道,如果你把中文音色(zf_ 开头)喂给它,代码不报错,只打一行 warning:语言不匹配。然后它照样合成,用英文的音素去配中文的音色向量——出来的东西既不是中文也不是英文,是一串谁也不认识的音节。
极少有项目愿意这么写。多数只放几段精心挑过的 demo,剩下的交给运气。把差评也写进文档,是一种很少见的自信:它知道自己的上限在哪儿,而且那个上限不是「模型不够大」。
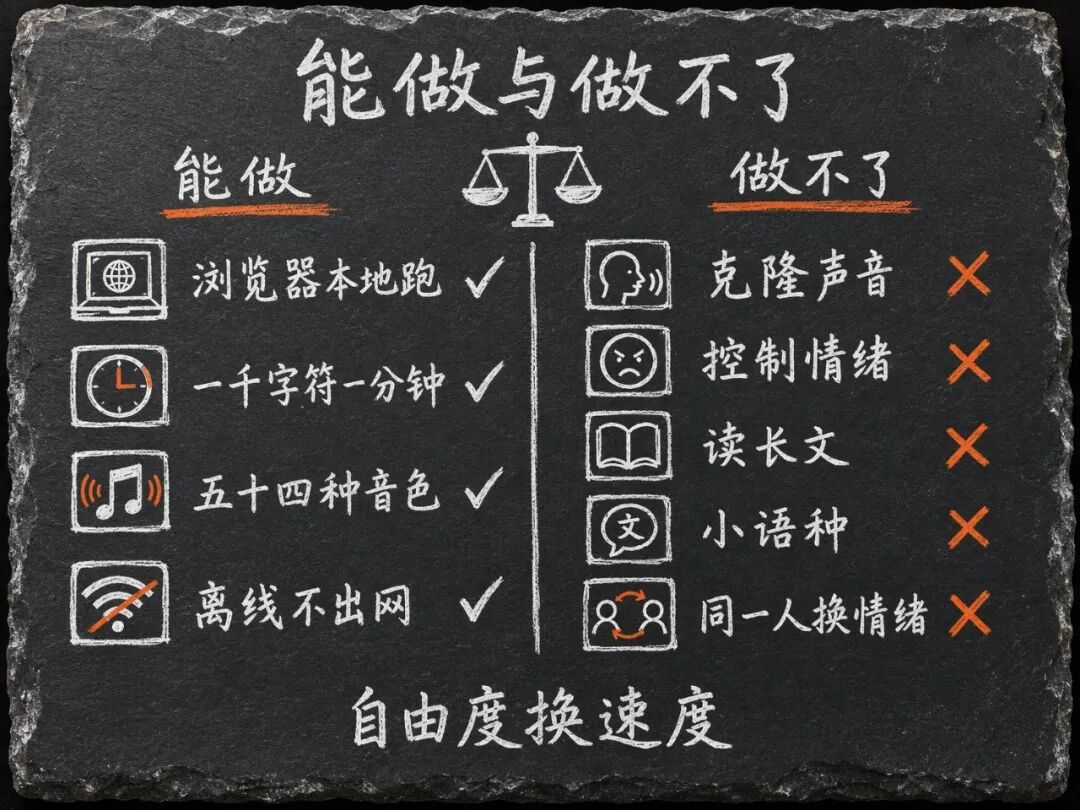
十二、它做不了什么
把上面的机制合起来看,有几件事是它从设计上就做不了的。
不能克隆声音。 模型卡写的是 「no encoder release」——编码器没放出来,仓库里也只有推理代码。想拿一段录音生成自己的音色包,这条路是断的:没有编码器,你没法把一段音频变成那 256 个数。
不能控情绪。 情绪不在参数里。你想让同一句话读得高兴一点、愤怒一点,没有对应的开关。能做的是换一个音色,或者改标点、改措辞——让文本本身带情绪,模型跟着念。
不能读长文。 510 个音素是硬墙,长文必须自己切。切得不好,句子会在不该断的地方断。
小语种很薄。 法语只有一个音色。印地语、意大利语、葡萄牙语各只有两三个。数据少的地方,读错和读糊都是常态。
做不到「同一个人、不同情绪」。 因为表是固定的:一个音色就是一张 510×256 的表,一行就是一行。它没有「情绪维度」这个轴。
这些不是「待优化的点」,是这套设计的必然结果。把「生成」换成「查表」,换来的是速度和体积,付出的就是自由度——表里没有的,它给不出来。
反过来,它适合的地方也很明确。
界面里的提示音和朗读按钮。 用户点一下「听全文」,两秒钟出声,不用连服务器,不用等队列。这条路上,稳定和快比「像人」重要。
离线的设备和内网系统。 一台没有显卡的机器,或者一个不允许出网的场景。模型几百兆、CPU 能跑、不需要任何外部依赖(除了装一下 espeak),这种组合在几年前做不出来。
原型和 demo。 想验证「这个产品要不要有语音」,不必先谈一个云服务合同,一个下午就能接完。
无障碍朗读。 新闻、公告、说明书这类内容,语调平一点反而好,不需要情绪。
它不适合的也很明确:有声书、播客、任何「听三十分钟不出戏」的场合。长文必切,切了就断气;音色固定,听久了会腻;情绪没有旋钮,全靠文本自己带。
一句话概括:它更适合「读给你听」,不适合「讲给你听」。
结语
回头看这个项目做的事,其实只有一句话:把「生成」换成了「查表」。
风格向量本来是采样出来的,改成查;音高本来是合成出来的,改成喂;波形本来是 GAN 编出来的,改成反变换算出来。每一步替换,都放弃了一点自由度,换回来一点确定性和一点体积。
这不是 Kokoro 一个项目的选择,是这一代小模型的通用打法。LoRA 是查表,RAG 是查表,KV cache 也是查表——把一个需要现场算的东西,提前算好存起来,用的时候按地址取。
大模型的赌法是「参数够多,什么都能学会」;小模型的赌法是「有些东西本来就不该学,存下来就行」。
两种赌法都能赢,只是赢在不同的地方。
一千美元训一个能进浏览器的语音模型,这个价格本身就在说一件事:语音合成这件事,早就过了「必须很大」的阶段。剩下的问题是,你愿不愿意接受表里没有的那些东西,它给不了。这类小模型工程化的话题,云栈社区上也有不少同好在讨论。
—— 尧哥
参考
- 项目地址:
https://github.com/hexgrad/kokoro — Apache-2.0,推理库与命令行工具
- 模型权重与音色表:
https://huggingface.co/hexgrad/Kokoro-82M — 权重、配置、音色评级与多语言示例
- 文本转音素:
https://github.com/hexgrad/misaki — 英文词典、espeak 兜底、中文与日文实现
- 架构来源:
https://github.com/yl4579/StyleTTS2 — StyleTTS 2 原版,含风格扩散与编码器
 发表于 前天 23:20
|
查看: 28|
回复: 0
 /1


