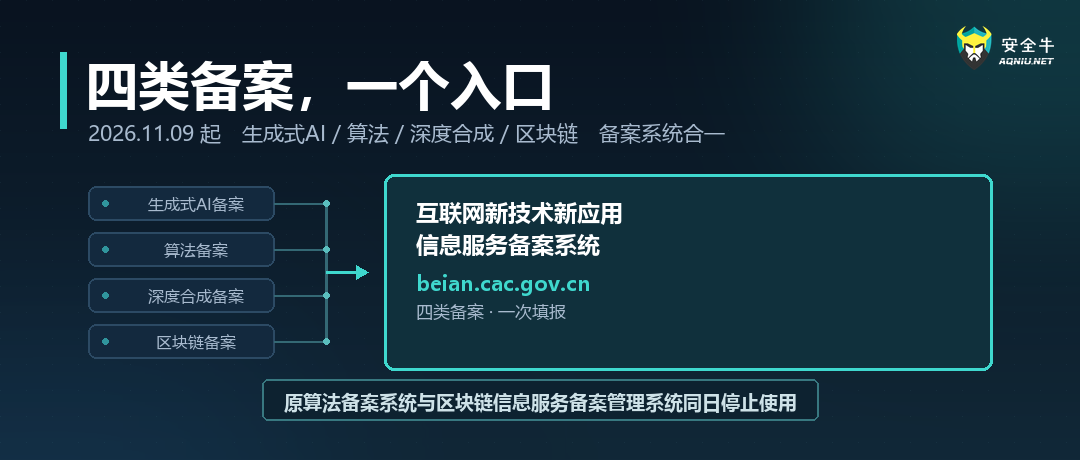
11月9日,国家网信办“互联网新技术新应用信息服务备案系统”正式上线,生成式人工智能、算法、深度合成、区块链四类备案合并到了同一个入口。原“互联网信息服务算法备案系统”和“区块链信息服务备案管理系统”同日起停止服务。
表面上看这是一次系统升级,但对已上线或准备上线 AI 功能的企业来说,实质是一次合规台账的重建。过去分散在不同系统里的义务,如今被放在了同一张表上。这次 行业动态 的调整,对不少开发者和企业而言,意味着更严格的统一监管。对于多数企业来说,真正要厘清的无非是这三件事:自己在不在表内、存量要不要重办、调用别人的模型是否也构成了自己的义务。
一、变了什么:不是搬家,是合并台账
新系统的地址是 beian.cac.gov.cn,可在一体化平台上办理四类新技术新应用的备案。从技术角度看,这只是填报入口的合并;但从监管逻辑上看,意义截然不同。过去按技术形态分头管理——生成式 AI 一套、算法一套、区块链一套;现在按主体统一归集,一家企业涉及哪几类新技术,同一本账上便一目了然。
“只做传统业务”的公司之所以同样被波及,原因正在于此:只要产品里带有推荐算法、深度合成功能,或者接入了大模型的对话入口,就已经处于这张表的管理范围内。
从业务形态来看可以分成四类:电商平台的商品推荐与个性化分发,内容平台的信息流排序与 AI 生成素材,企业软件的智能客服与知识库问答,以及手机应用里的 AI 写作与图片处理。这些行业虽不同,但共同点是产品中早已用上了上述技术,而团队通常不把自己视为 AI 企业。
规模可参考:截至 2026 年 8 月 31 日,累计已有 1112 款生成式人工智能服务完成备案,731 款生成式人工智能应用或功能完成登记;仅 7 月至 8 月,就新增备案 124 款(含 7 款手机端侧服务)、新增登记 133 款。这组数字表明,备案已从少数头部企业的动作演变为一项常态事项。常态之后,备案不再是加分项,而是底线;监管机构也拿到了可以持续比对的数据源。
二、三个必须立即处理的实操问题
其一:存量是否需要重走流程?
无需重走。但必须做一件事——核对公示信息与实际是否一致。系统更换后,对外公示的信息(模型名称、备案号或上线编号)仍是法定义务,而这部分内容容易在版本迭代中被改错或遗漏。
其二:公示写在哪里,写什么?
按照公告要求,已上线的生成式人工智能应用或功能,应当在显著位置或产品详情页面公示所使用已备案或登记服务的情况,注明模型名称、备案号或上线编号。
“显著位置”并无统一格式。一个可用的判断标准是:用户无需点开三层菜单就能看到。常见的做法是在“关于我们”“设置—隐私与合规”“产品详情页”之中选择其一固定展示,并在版本发布检查表里加上一条核对项。
其三:通过 API 调用他人模型的应用如何处理?
这是最容易遗漏的一类。通过 API 接口或其他方式直接调用已备案模型能力的应用或功能,由地方网信办负责开展登记。
从义务归属看,这里涉及两个主体,各担一项:自研模型并对外提供服务的,履行备案,在国家网信办完成;在已备案模型之上构建应用或功能的,履行登记,由地方网信办开展。前者由模型方办理,后者由应用方办理。两项程序的前提一致:所提供服务具有舆论属性或社会动员能力。
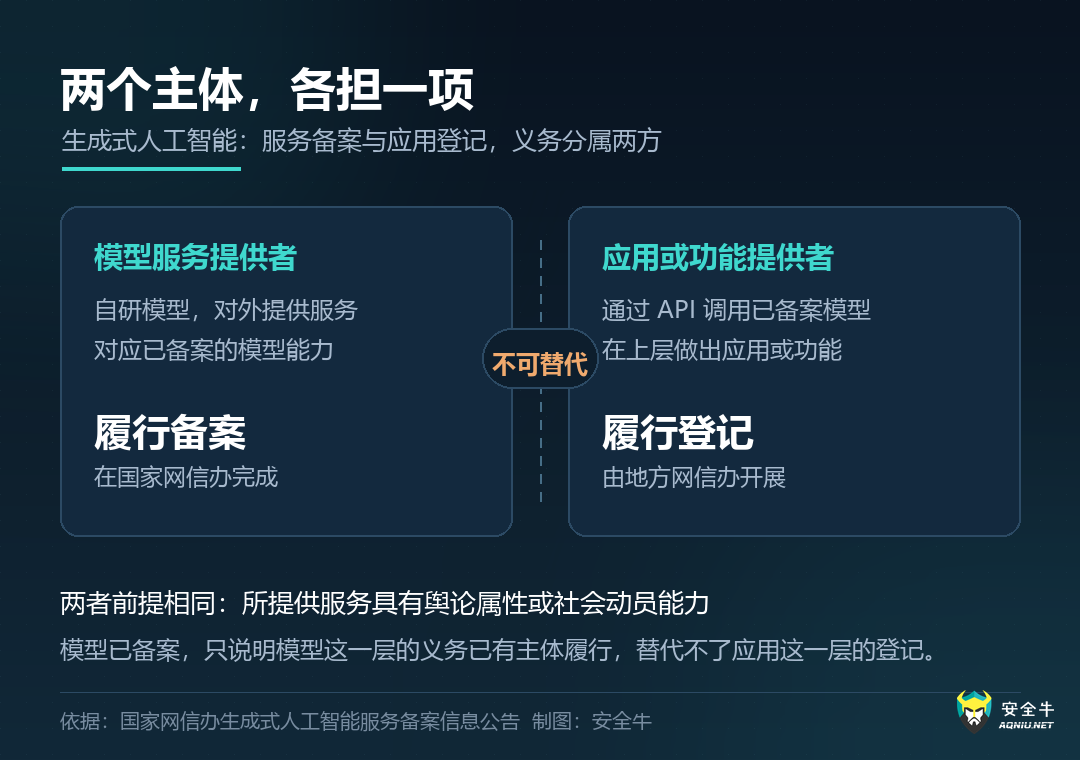
常见的误区是:既然用了已备案的 大模型,自己是不是就无需再处理了?这个理解并不成立。模型已备案,只意味着模型这一层的义务已有主体来履行,替代不了应用这一层的登记义务。
三、企业自查清单(建议截图保存)
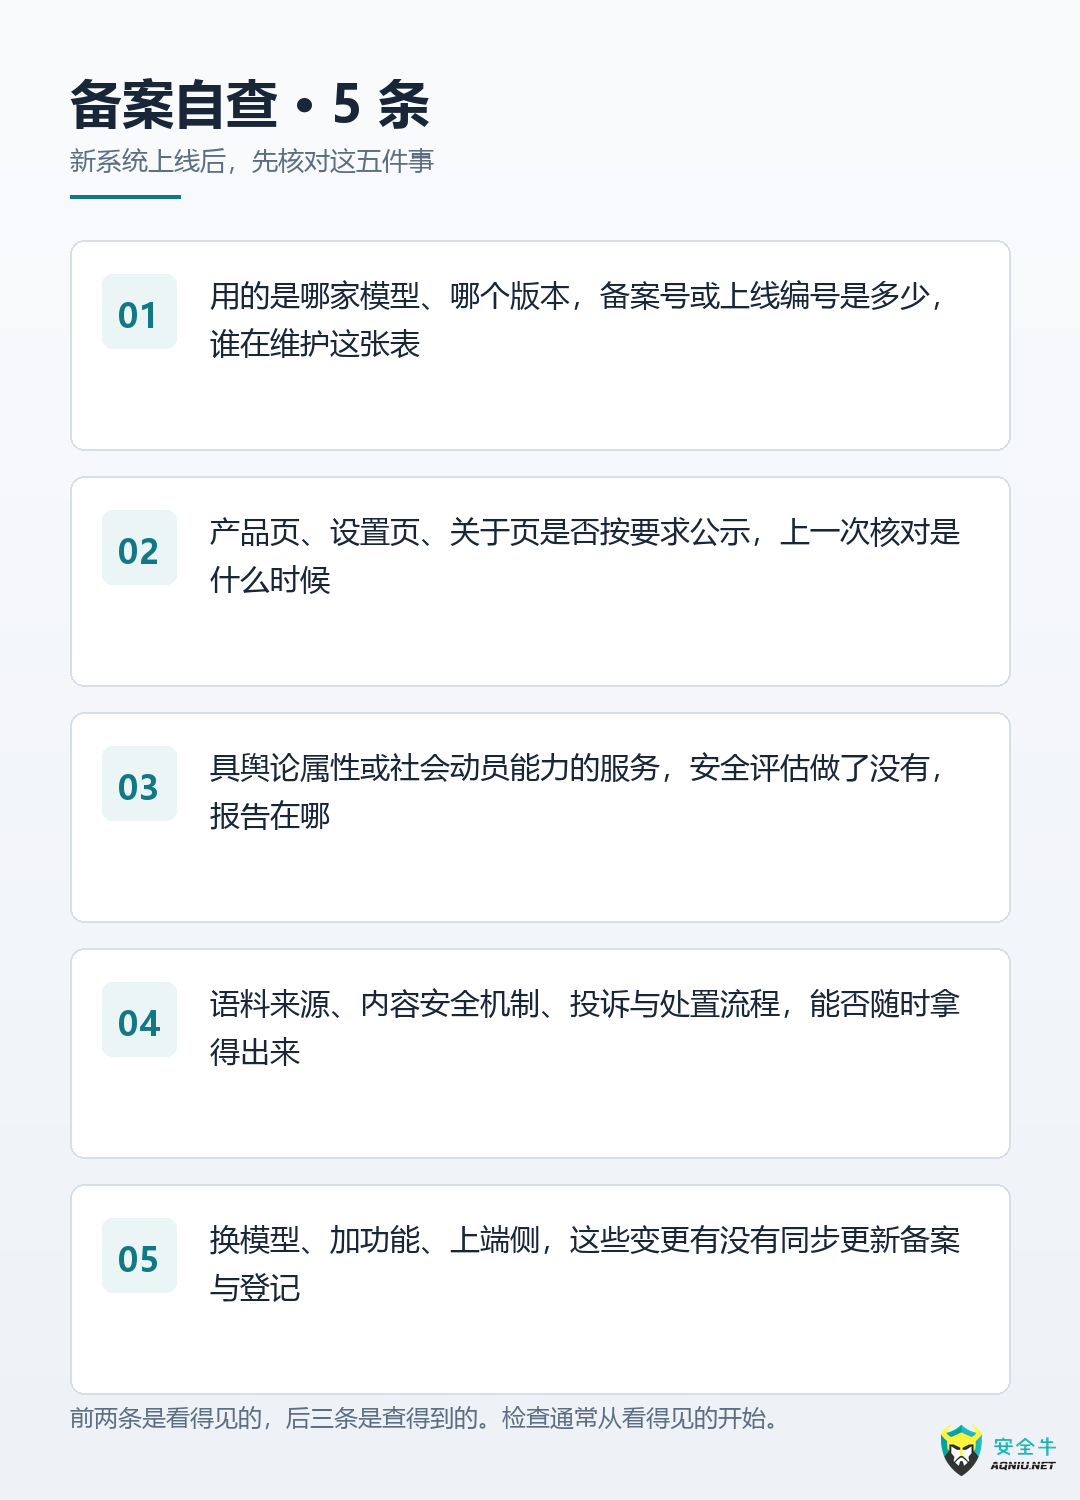
- 当前使用的是哪家模型、哪个版本,备案号或上线编号是多少,由谁来维护这张表?
- 产品页、设置页、关于页是否已按公告要求公示?上一次核对是在什么时候?
- 服务若具有舆论属性或社会动员能力,安全评估是否已经完成、报告存放在哪里?
- 语料来源、内容安全机制、投诉与处置流程,能否做到随时调阅?
- 更换模型、增加功能、上线端侧——这些变更是否同步更新了备案与登记?
这五条中,前两条属于“可见项”,后三条属于“可查项”。检查通常会从可见项入手。
四、一个容易被误读的问题:备案不是免责单
备案解决的是“主体是谁、使用了什么”的识别问题,并不解决“服务是否安全”的责任问题。
2026 年 4 月,中央网信办部署开展了“清朗·整治AI应用乱象”专项行动,重点之一便是未按规定履行大模型备案登记义务、安全审核能力不足等问题。据公开报道,此后已有企业因提供 生成式AI 服务未按规定开展安全评估,被属地网信办责令改正、对责任人从严处理并予以警告。
这个案例的关键在于:处罚指向的并非“未备案”,而是“未开展安全评估”。备案是准入动作,安全评估是能力证明,两者处于同一条责任链上。
结语:从“有没有”到“符不符”
此次合并并没有新增义务。四类备案的要求原本就写在各自的规章里,变的是履行情况如今变得可见。
对于认真做产品的团队而言,这反而是一种利好:需要维护的东西虽然多了一层,但规则却变得清晰可预期——交什么、何时交、交错了会有怎样的后果。靠信息不对称取巧的空间正在收窄。
与其被动等待被点名,不如主动把这份记录先建起来。工作量不大,难的是指定一个负责人,并且每月核对一次。
把这次合并放回今年的监管序列里,它的位置会更加清晰。
10 月 1 日起施行的公安部 176 号令,把“新技术新应用备案情况”列入了十一项检查内容,并对单位和责任人同时设罚;11 月 6 日,工信部对预置智能体的终端提出了唯一身份码、升级事前报备、分发环节声明同意三项要求;地方层面,重庆的数据安全条例按数据类型把日志留存划成六个月至三年三档。检查、终端、证据三个环节,做的其实是同一件事:一项 AI 能力上线之后,必须能够指回一个可负责的主体。
归集是把这种追溯变成日常的前提。分散在四个系统里的申报各自成立;放入一张表之后,它们之间才产生关联。
真正的变化在于比对。过去各系统分头受理、各自留档,申报口径不一致很少被翻出来;归集之后,一致性本身就成了可核查项——算法备案里写的用途,与生成式 AI 备案里写的场景,对不上便是新的暴露面。
由此可以得出的判断是:下一阶段的检查切入点,会从“有没有备案”转向“备案与实际是否相符”。验证方式也很直接——看后续公开通报里,有没有出现因备案信息与实际不符而被处置的案例。
对企业来说,这项工作的性质也已改变:不再只是上线前交一次材料,而是在换模型、加功能、上端侧这些节点上维护同一份记录。这份记录平时不产出业绩,但出事时是能拿出来自证清白的关键凭证。
 发表于 昨天 18:14
|
查看: 2|
回复: 0
 /1


