2016 年,一本蓝色封面的书闯进了整个技术行业,把“运维”从地下机房拉进了工程学科的殿堂。
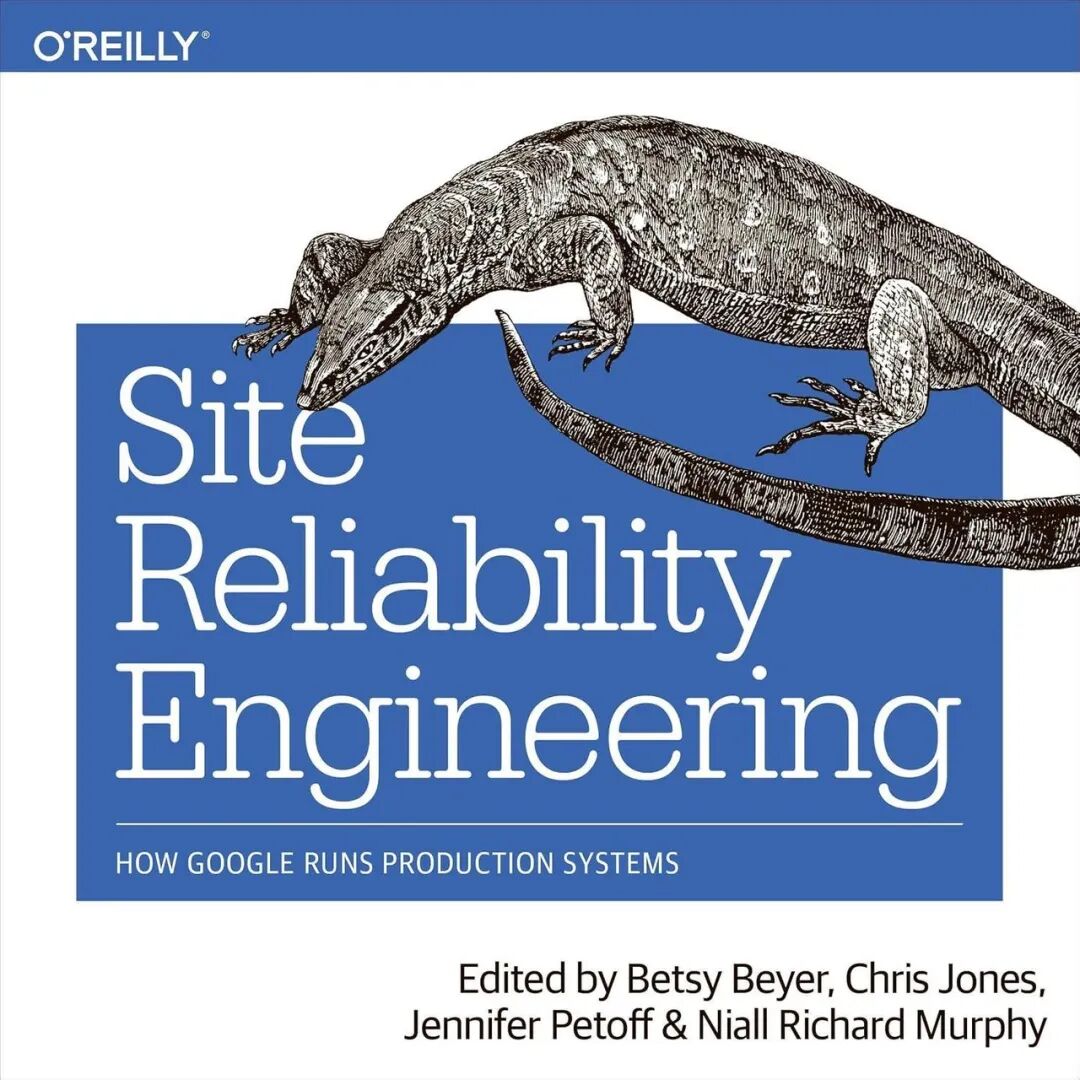
在这本书出现之前,运维在大多数组织里是成本中心。他们是被凌晨告警叫醒的人,是开发团队眼中“拖慢发布速度的那帮人”,靠师傅带徒弟、口口相传和个人英雄主义,在机房里临场发挥。系统出了故障,默认的解法只有三样:加人、加班、加流程。
第一版《SRE》做的第一件事,就是用冷峻的工程语言宣告传统运维时代的终结。它给全行业抛出一个难以反驳的等式:SRE 就是用软件工程师的标准来设计运维团队。
书中把日常运维(Ops)工作的时间硬性封顶在 50%,其余时间必须投入工程工作。这背后的判断是:运维本质上是软件工程问题,不该靠加人来扛故障,而应该靠写代码来消灭故障。从这本书出版起,SRE 不再只是谷歌内部的岗位名称,而成了一门新学科的名字。它推动这一岗位在全球普及,也重塑了无数科技公司的组织架构和招聘标准。
这本书不只是让 SRE 走向更广泛的技术行业,还给整个行业提供了一套通用的“工程语言”和黄金法则。 此前,DevOps 运动已经喊了七年“要协作、要自动化、要拥抱失败”,却像一面插在散沙上的旗帜。它说“要协作”,没说凌晨三点告警响了谁来看。它说“要拥抱失败”,也没说失败到什么频率才算正常。
第一版《SRE》给这套哲学浇上了钢筋混凝土。微软官方文档后来用一句话概括两者的关系:“SRE 类实现 DevOps 接口。”更重要的是,书中把谷歌多年积累的 SLI、SLO、错误预算、toil 管理和无责事后复盘等工程实践系统化地介绍给外界,让不同组织在讨论系统可靠性时,有了相对统一的概念和方法。
以错误预算为例。它纠正了“追求 100% 绝对稳定”的执念,用数字量化了系统稳定性与业务迭代速度之间的博弈,化解了开发与运维之间长达数十年的矛盾。如今在任何一家公司的可靠性评审会上,你听到的那句“这个季度的错误预算还剩多少”,源头都在这本书里。这本书不只是被阅读,还被翻译、拆解、贩卖和模仿。
书出版几个月后,作者之一 Niall 在都柏林办公室被一家咨询公司的六个人堵住。他们拿着文件夹,花了一个小时逐条盘问书中的细节,打算把这些内容包装成咨询服务卖给客户。Forrester 还发表了一篇文章,题为《SRE 一书中可以立即应用到你组织的 19 个要点》。一本谷歌内部手册,不到一年就成了全球咨询业的商品目录。所谓“黄金法则”,在现实中就是这个意思:别人拿它来赚钱、照抄、当标准。
这本书还直接推动了云原生与 DevOps 生态的爆发。 它出版时,恰逢整个行业的基础设施大迁移。企业的数字业务规模急剧扩张,IT 从“地下室里的事情”变成业务的关键组成部分,系统停机开始实实在在地烧钱。Kubernetes 在 2015 年发布 1.0,CNCF 同年成立,云原生运动正在寻找自己的方法论。
《SRE》给了这场运动一套可执行的可靠性框架:平台工程、可观测性、SLO 驱动的发布决策。这些后来云原生生态里的核心议题,都能在书里找到最初的表述。
DevOps、云原生和 SRE 并不是三个孤立的故事,更像同一场运动的三层。DevOps 提供文化,云原生提供基础设施,SRE 提供在这些基础设施上把可靠性当工程问题来管理的操作手册。少了这本手册,云原生的爆发会缺一根关键的承重梁。
所以说,第一版不只是一本书,而是现代互联网运维的“开山之作”和“范式转移之作”。
但十年后,这本书被它的作者们亲手推翻了。
谷歌为什么要重写《SRE》,而不是修订
今年 10 月,谷歌发布了该书的第二版,这一版是重写,不是修订。作者团队明确表示,第一版已经过时。原因远不止“技术栈更新”。第一版默认的那个世界,是工程师亲手写代码、亲手调试基础设施、在故障现场凭肌肉记忆做判断的世界。这个世界正被两股力量同时侵蚀。
第一股力量是基础设施与平台工程的全面重构。 第一版描述的是“每个团队自己搭建、运行基础设施”的时代。十年后,大量运维工作已下沉到平台层,内部开发者平台接管了资源供给(provisioning)、部署和可观测性配置。
- 静态仪表盘和手动查日志,被 OpenTelemetry 和分布式追踪取代。根因定位从“人肉 grep”变成系统自动推送。
- 第一版教的“写脚本消灭 Toil”,变成了声明式基础设施和自愈系统。故障发生后,系统自己拉回正常状态,不必等人醒来敲命令。
SRE 不再亲手碰这些东西,而是成了平台的使用者和设计者。
第二股力量是 AI 的双向重塑。 谷歌官方把 SRE 与 AI 的关系拆成两个方向。
“为 AI 做 SRE”: AI 系统本身给可靠性工程带来了新的挑战,包括大规模 GPU 和 TPU 集群的可靠性、网络拓扑的复杂性、非确定性输出的监控,以及模型训练和微调管道的稳定运行。
模型输出的可靠性尤其棘手。传统 Web 服务出现 5xx 错误,通常会被监控系统发现,并可能计入错误预算。但一个“自信地给出错误答案”的模型,即使服务运行正常,也可能损害用户信任。
“用 AI 做 SRE”: AI 也开始参与生产系统的故障诊断和处理,而且已经走出了概念验证阶段。Google SRE 团队已经在用 Gemini CLI 处理真实故障。在一段模拟故障的演示里,Agent 自动拉取告警详情、做因果分析、关联时序数据、推荐缓解方案,SRE 只需输入一句“SGTM(听起来不错),执行重启”,就能触发相应操作。
Komodor 的 CTO 说得更直白:大约 30% 的案例,Agent 可以独立解决,人类只会收到一条 FYI 通知。TechTarget 的报道还描绘了一个“理想场景”:凌晨三点,Agent 发现异常、测试修复、灰度发布,第二天早上人类醒来,看到一条“昨晚避免了一次事故”的通知。
这就是第二版重写的理由:SRE 赖以存在的两个底层假设,同时崩塌了。
第一版教的那些黄金法则,包括 SLO、错误预算和消灭 toil,都建立在“系统行为可度量、可预测、可由人工工程化控制”的前提上。但现在,对传统系统,SRE 不再亲手操作。对 AI 系统,代码根本不按确定性规则运行。
AI 更像黑箱里的同事:有时能力超神,有时胡说八道,而你必须在生产环境里和它共事,还要保证用户不遭殃。Niall 在播客里说过一句话:“LLM 会产生幻觉,准确率是 99.9% 还是 99.5%,后果天差地别。”这句话指向的是,SRE 赖以存在的“确定性”正在被抽走。
谷歌在第二版里反复强调:技术变了,文化没变,无责复盘和心理安全感依然是根基。但真正致命的问题是:当你的日常变成审核 AI 的提案,当 30% 的故障判断被机器接管,你对系统的“体感”从哪里来?
第一版 SRE 文化的核心,是“你亲手碰过、被凌晨三点的告警烧过,所以你真懂系统”。错误预算之所以有分量,是因为按下“停止发布”的人曾在故障中感受过切肤之痛。如今,这个根基正在被抽走。
播客里 Christof 的发言值得留意。他说第一版忠实地体现了副标题“谷歌如何运行生产系统”,但没有说清楚,这只是一种做法。第二版引入了 Spotify、Microsoft、Etsy、Disney 和 Waymo 的视角,展示它们如何采用 SRE、哪些做法有效、哪些无效。
这个转向本身就是一个信号:SRE 正在从“谷歌怎么做”,变成“在你的环境里,AI 介入之后,你还能抓住什么不变的东西”。
如果你在运维、平台工程,或任何需要对生产系统可靠性负责的岗位上,不妨听听这期播客。这段对话没有给出 AI 时代的答案,作者们自己也在担心,十年后这本书会不会显得荒唐。第二版如实呈现了一道正在发生的断裂:一本终结了传统运维时代、定义了行业语言、托住了云原生爆发的书,被作者们亲手宣告需要重写,而重写的理由,恰恰是他们自己还无法完全看清的东西。
Betsy 在播客里说,想成为 SRE 的人,她的建议仍然是“从第一版开始”。如果你想知道,DevOps 和云原生走到 2026 年之后,当 AI 开始接管操作、平台工程把 SRE 从机房里拽出来,那套让运维变成工程学科的东西还剩下什么,第二版和这期对话是目前的起点。
以下为访谈内容,InfoQ 在不改变原意的前提下做了编辑整理。
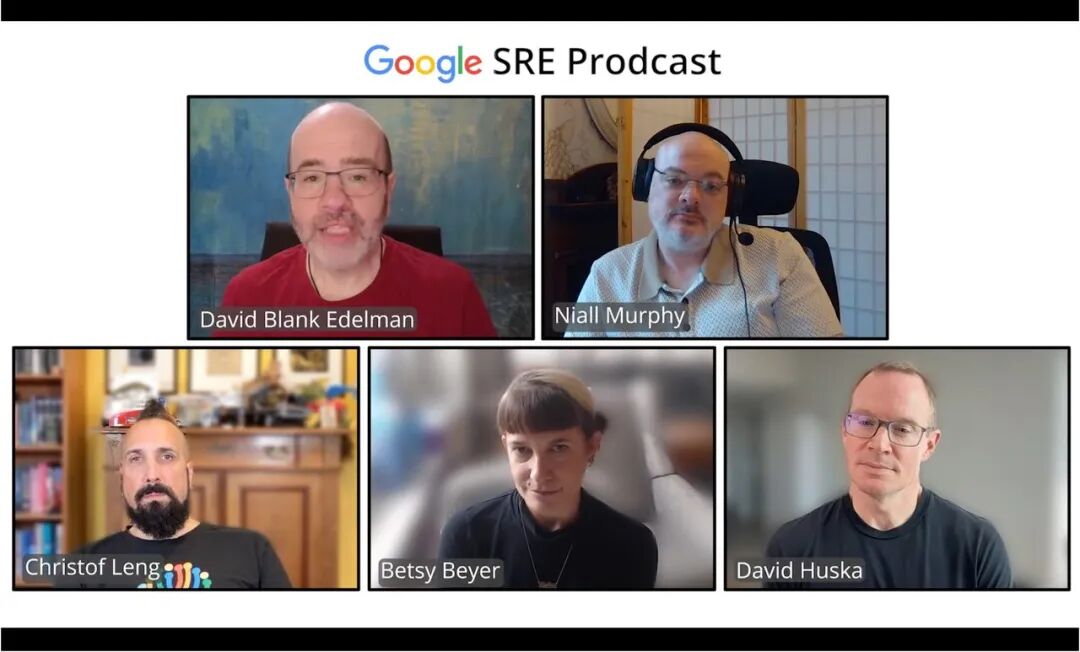
1. 从人工救火到工程化运维,Google 如何改变了 SRE?
David Blank-Edelman: 大家好,欢迎收听 Prodcast。我是今天的客座主持人 David Blank-Edelman。今天我们要聊一部在这个领域具有开创性意义的著作。参加讨论的人可能不太愿意承认,但《SRE》这本书确实推动了整个领域的发展,也让更多人认识了 SRE。
我们还有一个令人兴奋的消息:今天会重点讨论即将问世的第二版。我想先从这本书的起点聊起。Niall,当初怎么会想到写这样一本书?聊到第二版时,我还想再问你这个问题,听听你当时有哪些不同的考虑。
Niall Richard Murphy: 第一版的想法在正式立项前几年就出现了。随着 Google 内部 SRE 实践不断发展,工程师们意识到,这套知识和工作方法已经复杂到值得系统整理成书。经过大约一年半到两年的编写,第一版于 2016 年出版。
David Blank-Edelman: Christof,你认为第一版为什么会受到如此广泛的欢迎?这本书提供了什么价值,让这么多人从中受益?
Christof Leng: 我认为这与当时的时代背景有很大关系。那段时间,很多公司的数字化业务都在快速扩张。IT 系统不再只是发生在地下机房里的事,而是逐渐成为企业运营的关键组成部分。人们开始意识到,系统一旦宕机,就会真正影响业务。
于是大家需要弄清楚几个问题:系统规模越来越大,我们该怎么办?各种系统相互交互带来的复杂性,我们该怎么办?又该如何以可持续的方式管理这些系统?很多公司开始尝试书中的实践方法,结果表明,它确实在不少公司里起了作用。
David Blank-Edelman: 我想,读者从这本书里看到的不只是 Google 的经验,也看到了自己的处境。这个问题值得探讨:这本书解释了 Google 是如何成功的,但其中的方法似乎也适用于其他公司。
你们写这本书时,是否已经意识到 Google 的经验也能在其他组织中发挥作用?其他公司又是如何借鉴这些经验的?你们当时观察到了什么?
Christof Leng: 我认为第一版确实有一些内容带着很强的 Google 色彩。在我看来,真正成功引入 SRE 的公司,并没有完全照搬 Google 的做法,而是根据自身情况做了调整。每个组织的文化和需求都不同,不可能与 Google 一模一样,这其实是好事。书中的许多原则具有普遍适用性,其他公司完全可以结合自身情况加以应用。
2. Google 的最佳实践,为什么到了其他公司就失灵了?
David Blank-Edelman: David,你先来说说?
David Huska: 我在 Google Cloud SRE 团队工作时,主要负责帮助一些大型客户把系统迁移到 Google Cloud(GCP),第一版 SRE 书恰好在那时出版。当时云计算已经出现了一段时间,而且越来越普及。在与客户合作的过程中,我们逐渐意识到一个问题:这些企业往往拥有规模庞大、运行多年的老旧系统,而系统原有的可靠性问题,并不会因为迁移到云上就自动消失。
第一版出版时,SRE 的理念和实践开始受到广泛关注。很多公司想效仿 Google,认为既然 Google 这么做,自己也该照着做。但正如 Christof 刚才所说,由于种种原因,直接照搬往往行不通。
接下来的几年,我们与这些大型企业开展了大量合作,也积累了不少经验。这些合作有时像技术咨询,有时又像是在给客户做情绪疏导,因为我们经常要回答一个问题:“为什么这套方法在我们这里行不通?”
与此同时,这些经历也不断印证了 SRE 的许多基本判断。有些问题几乎像物理定律一样,无论在哪家公司,都会遇到类似的挑战。客户也非常想知道 Google 是如何应对这些挑战的。毕竟,Google 一直被视为可靠性工程领域的典范,他们希望借鉴这些经验。其中不少方法确实有效,直到今天仍然适用。
不过,走进其他企业,观察这些方法在不同环境下的效果,也让我们有了许多新的认识。这些企业拥有非常优秀的工程师,也十分了解自己的业务,但 Google 的方法并不总能与他们的实际情况完全匹配。客户的反馈促使我们重新审视这些实践:哪些经验具有普遍性,哪些做法需要根据具体环境调整?这些问题后来也成了我们总结经验、完善方法的重要方向。
Niall Richard Murphy: 我补充一下。第一版出版几个月后的一次经历,让我第一次意识到这本书或许也适用于 Google 之外的企业。
当时我在 Google 都柏林办公室工作,前台突然通知我,说有人来找。我有些意外,因为事先没约任何人。下楼后才发现,来访的是一家咨询公司的六名员工。我把他们带进会议室,几个人随即拿出文件夹,里面有大量列着问题要点的资料。接下来一个小时,他们围绕书中的内容向我提了许多非常细致的问题。直到谈话快结束,我才恍然大悟:原来他们想深入了解书中的各种细节,再把这些经验作为咨询服务提供给自己的客户。
当然,十年后的我已经没有当时那么天真了。但那次经历确实让我意识到,这些咨询公司可能会把 SRE 的方法带给更多企业,涉及不同的行业,以及对技术有不同需求的组织。又过了一段时间,我逐渐意识到,SRE 正在走向主流。
当然,Google 与其他企业之间存在许多差异,比如组织规模、可用资源,包括资金和 CPU 等计算资源。这些差异很容易让人觉得,Google 的经验未必适用于其他公司。但咨询公司认为,书中有大量方法可以直接应用到其他组织。
我记得 Forrester 发表过一篇文章,标题大致是《SRE 一书中可以立即应用于企业的 19 条经验》。看到这样的文章,我更加确信,这本书对 Google 之外的企业同样有价值。初创公司可能是一种比较特殊的组织类型,我理解这种看法,在一定程度上也认同。但对大多数企业及其日常工作来说,书中确实有许多值得借鉴的方法。
事实上,这也是我当初想写第一版的原因之一。在此之前,我长期处于开发与运维严格分离的传统工作模式中。我整个职业生涯大约 75% 的时间在做运维,另外 25% 在做开发。但我逐渐意识到,开发和运维并不一定要这样分开。
而 Google 特别擅长的一件事,就是从第一性原理出发重新审视问题,探索不同于传统做法的解决方案。
3. 从自建基础设施到平台工程,哪些经典实践已经不适用了?
David Blank-Edelman: David,我想接着你刚才的话再问一个问题,正好也聊聊即将出版的第二版。经过这么多年的实践和反思,现在回头看第一版,你们觉得有哪些地方当初理解得不够准确,或处理得不够完善?又有哪些内容,是你们希望在第二版中补充或修正的?
毕竟人都会犯错,至少我自己是这样。而 SRE 一直强调从失败中学习,所以我很好奇,你们从第一版里吸取了哪些经验?如果能挥动魔杖回到过去,重新审视第一版,哪些地方会让你们觉得“第二版必须补上这个缺口”,或者“这里要纠正一下之前的说法”?
David Huska: 我认为,第一版的很多观点在当时是成立的,也符合我们的写作定位,也就是介绍 Google 如何运行生产系统。只是这些年技术和实践发生了变化,书中的部分内容逐渐过时了。
十年前,我们强调 SRE 文化,以及开发团队自行构建和运行基础设施的工作模式。如今,很多原本由开发人员承担的基础设施工作,已经下沉到平台层,由统一的平台提供支持。这并不意味着当年的做法是错的。那确实是 Google 当时运行系统的方式,效果也很好。只是后来我们发现,许多公司读了第一版之后,也开始模仿 Google 的做法。
所以我换个角度回答:第一版推动了哪些实践,而现在回头看,我们希望 Google 之外的公司当初能采用不同的方法?这样的例子确实有一些。比如,十年前的环境相对简单,我们有充足的闲置计算资源,可以采用 N+1 冗余配置,故障时利用预留的计算能力完成切换。当时我们使用的虚拟机环境也相对统一,并在此基础上推动了 Borg、Kubernetes 等技术的发展。我很高兴当时选择了这条路线,但今天的技术环境已经不同了。
平均故障恢复时间(Mean Time to Resolution,MTTR)也是一个例子。过去这是一项非常实用的指标,数据分布大致呈钟形曲线,所以我们一直用它衡量故障恢复情况。但如今这项指标已经不如过去重要。类似的变化还有很多。
不过在我看来,第二版最重要的进步,是我们认识到 Google 并不是唯一能成功实践 SRE 的公司。其他组织同样积累了丰富的经验,也探索出许多行之有效的解决方案。因此我们努力把这些经验纳入第二版:邀请其他公司的工程师亲自介绍他们的实践,也分享 Google 如何借鉴这些经验,以及我们自己的工作方式发生了哪些变化。同时,第二版也开始面向第一版未能充分覆盖的其他读者群体。
Betsy Beyer: 我们后来意识到,第一版遗漏了一项非常重要的内容。当时我们已经习惯了 Google 的企业文化,默认人员管理、团队协作以及无责文化(Blamelessness)等都是理所当然的。但实际上,这些恰恰是成功推行 SRE 的必要基础。
因此,第二版用了更多篇幅讨论社会技术系统(Sociotechnical Systems)层面的问题。与某个数据库表之类的技术细节相比,这些内容更不容易过时,长期参考价值也更高。
David Blank-Edelman: 根据我的经验,出第二版时通常不可能无限增加篇幅,要加入新内容,就得删掉一部分旧内容。刚才 David 提到了平台工程,Betsy 也谈到了组织和文化。那么,为了给这些新内容腾地方,第二版具体删掉了什么?
David Huska: 第一版包含大量技术细节,比如负载均衡、分布式 Cron 等,这些内容在当时很有价值。但如今,其中大部分技术已经商品化。即使尚未商品化的部分,借助 LLM 等代码生成工具,实现起来也比过去容易得多,成本也大幅下降。因此我们讨论过,是否还有必要保留这些内容。
最终,我们决定把更多篇幅留给第一版中相对欠缺的组织文化内容,比如团队成员如何协作、人与人之间如何互动,以及如何证明自己工作的价值。
借用作家 David Foster Wallace 的比喻,这些东西就像我们生活其中的水。因为早已习以为常,我们反而很难意识到它们的存在,也就没有在第一版中充分介绍。有些内容我们当时已经意识到了,甚至写成了章节,但受篇幅等因素限制,最终还是删掉了。所以第二版减少了大量具体的技术细节,转而增加了更多关于组织、人员协作和文化的讨论。
Christof Leng: 第一版很好地体现了它的副标题“Google 如何运行生产系统”,但没有明确告诉读者,这只是实践 SRE 的一种方式,并不是唯一的方法。
因此,第二版引入了更多来自其他公司的实践经验,包括 Spotify、Microsoft、Etsy、Disney 和 Waymo。这些公司都有各自的 SRE 实践方法和发展历程,可以分享它们如何引入 SRE、哪些做法成功、又遇到了哪些问题。我认为这些经验对准备引入 SRE 的企业很有参考价值。毕竟,如果只看 Google 如今成熟的实践体系,而不了解它是如何一步步发展起来的,就很难判断哪些方法适合自己的组织。
Betsy Beyer: 我想特别强调第二版的一个重要特点,它与我们刚才讨论的保留、删除和更新哪些内容直接相关:第二版《SRE》是完全重新编写的,并不是在第一版基础上简单修改和增删。
举个例子,第一版有一章专门讨论“简单性”(Simplicity)。简单性依然是 SRE 的一项基本原则,我们现在仍然认同它,那一章直到今天仍然非常有价值。
因此,我们实际上把第二版看成第一版的补充,而不是替代品。我们还在第二版前言里,为不同类型的读者提供了阅读建议,当然前提是有人愿意认真读前言。其中,对于希望成为 SRE 工程师的读者,我们的建议很明确:先从第一版读起。
4. 连 SLO 都开始讨论弱点了,Google 的可靠性标准变了吗?
David Blank-Edelman: 我还想知道,第二版有没有提出一些与第一版截然不同、甚至有些“离经叛道”的观点?比如,你们会不会说:“SLI 和 SLO 过去确实不错,但现在已经没那么重要了。”或者说:“可靠性当然很好,不过现在我想跟你们谈谈韧性(Resilience)。”
David Huska: 讨论 SLO 和错误预算时,确实经常涉及教条与异端之争。这两个概念可能是第一版中影响最广的内容,也是我们与云客户合作时被问得最多的话题。
在 Google,我们把 SLO 和错误预算当作一种协调决策的机制。系统运行出问题时,它们能帮助团队判断何时该暂停发布、集中精力改善可靠性,何时可以继续推出新功能。如果所有人事先就这套机制达成共识,即使出现故障,团队也能按既定方案做决策。这套方法至今仍有指导意义。
但在实际应用中,我们发现一些企业认为这套机制限制了他们自主权衡风险的空间。毕竟每个组织的业务情况不同,需要自行决定能承担多大的风险。因此,他们更倾向于借鉴其中的原则,而不是完全照搬 Google 的做法。
后来我们发现,不只是 GCP 客户,许多读者也逐渐形成了类似的认识:只要组织内部信息足够透明,能充分理解自身的业务风险,就可以根据实际情况决定如何使用 SLO 和错误预算,而不必严格遵循某一套固定规则。
不过,第一版中有一项核心原则始终没变:SLO 的价值在于帮助团队了解用户的真实体验,以及用户真正关心什么。Niall 在第二版中很好地强调了这一点。编写第二版时,大家对 SLO 提出了各种不同的意见,最后由 Niall 负责把这些观点整合成一套连贯的表述,他完成得非常出色。
正如 Betsy 刚才提到的,有些基本原则不会改变。至于如何根据 SLO 制定错误预算、何时暂停发布等具体做法,则存在不同的观点和取舍,也更容易引发教条与异端之争。我们自己的看法也在不断调整,这些变化很大程度上来自外界的反馈,以及其他组织在实践中积累的经验。
Niall Richard Murphy: 我认为,第二版中关于 SLO 的章节有一个很独特的地方:它专门包含一个讨论“SLO 的弱点”的小节。更广泛地说,第二版在很多章节中都更充分地考虑了各种权衡,所以我们在描述如何采用某种方法时,讨论也更细致、更有层次。
当然,谈这本书,还必须说说大家最喜欢的两个元音字母。第二版有一章讨论 AI for SRE,还有一章讨论 SRE for AI。这是两个截然不同的主题,我就先说到这里。
David Blank-Edelman: 太好了,我们最后肯定会继续聊这个话题。不过在那之前,我想先来一轮快速问答。
5. 从自动化到组织文化,今天的 SRE 更需要关注什么?
David Blank-Edelman: 从 Christof 开始吧。除了你自己写的章节,你最喜欢、最推荐读者阅读的是哪一章?最好用一两句话说说值得关注的原因。
Christof Leng: 对我个人来说,是关于 SRE 文化背景的那一章。它提供了很多背景知识,帮助读者理解在 SRE 领域怎样才能成功,以及为什么有时你还没开始处理任何技术问题,就可能已经彻底失败。
我认为这一点经常被忽视。如果你完全忽略文化层面,很可能遇到大量麻烦,甚至根本不明白问题为什么会出现。所以我觉得有必要深入讨论这个主题,并把它放在全书非常靠前的位置。
David Blank-Edelman: 非常好。Betsy,轮到你了。这个问题对你可能有点难,因为你几乎参与了所有章节。即使选不出最喜欢的一章,至少能推荐一章吧?
Betsy Beyer: 当然可以。我个人非常喜欢“自动化与工具”(Automation and Tooling)这一章。它最大的优点,是提供了一套循序渐进的实践方法,从最基础的步骤开始,逐步深入。无论读者目前处于什么阶段,都能找到适合自己的起点。
此外,这一章还用了很长的篇幅讨论琐务(Toil)。这是 SRE 工作中非常重要的问题,书中不仅深入分析了琐务,还讨论了其中许多值得注意的细节,内容相当全面。
David Blank-Edelman: 非常好。David,你会怎么选?
David Huska: 我想我刚才已经回答过了。如果要推荐一章自己没参与编写的内容,我会选“平台工程”(Platform Engineering)。这一章很好地展现了 SRE 从第一版到第二版的演变:我们当初提出了哪些建议,如今 Google 内部如何实践,以及我们现在会向其他企业提出什么建议。它也很好地把软件工程与站点可靠性工程结合起来,体现了我们一直以来的初衷。
更重要的是,这一章说明 SRE 的基本原则并没有改变,改变的是我们解决问题的方式。这也是贯穿第二版的一个主题。随着技术工具、系统规模和商业环境不断变化,我们需要调整这些原则在实际工作中的应用方式,而不是抛弃原则本身。
如果可以再推荐一章,我想介绍自己参与编写的“有价值的可靠性”(Valuable Reliability)。这一章体现了第二版的一种新思路:我们需要认识到,SRE 归根结底是一项业务职能,而不只是一门工程技术。SRE 的重要价值之一,是帮助企业在业务规模扩大的同时,避免运营成本以相同比例增长,使企业能够持续经营和发展。但我们很容易只关注其中的技术问题,而忽略它对业务的实际价值。
“有价值的可靠性”讨论的正是这个问题。如果企业只是因为 SRE 流行而投入资源,却始终把它视为运营成本,而不是竞争优势,那么到了下一轮预算审议,或需要重新评估投入时,SRE 项目就可能面临被削减的风险。相反,如果组织内部充分理解 SRE 的价值,明确为什么要投入可靠性建设,就能在此基础上形成共识。这也是我非常喜欢这一章的原因,它体现了第二版新增的一个重要视角。
6. 当 AI 开始管理生产系统,SRE 如何应对不确定性?
David Blank-Edelman: 最后,我们来聊聊那些即将统治人类的机器人吧。
关于 AI,我有很多问题。最让我好奇的是,你们是如何在这本书里讨论 AI 的?以我的经验,写 AI 就像用会逐渐消失的墨水写字,刚写下的内容转眼就可能过时,因为技术发展实在太快了。
如今几乎每位 SRE 都在思考 AI 会带来哪些变化。但对一本纸质书来说,你们该写些什么,才能让这些内容在出版后仍有参考价值,而不是读者刚拿到书,里面的观点就已经过时?你们是怎么解决这个问题的?
Betsy Beyer: 我们通过“Tipping Point”(转折点)这一章,回应了 AI 将如何影响 SRE 这个职业的问题。围绕这个问题,目前存在大量焦虑和不确定性。我不能说我们已经明确回答了 AI 会给 SRE 带来什么变化,但书中确实提出了一些很有参考价值的预测。
David Huska: 有些事情我们还是能确定的。作为 SRE,我们已有多年运行机器学习系统的经验,现在也开始负责 AI 系统的运行。因此对其中一些问题,我们可以从基本原则出发讨论,这至少给了我们一个相对可靠的基础。
不过,你提到的确实是写这本书时最让我头疼的问题。第一版已经出版十年,而 AI 技术几乎每周都在变化。我们究竟该写什么,才能保证十年后再回头看,这些内容不会显得荒谬?为此我们反复讨论了很久。
最终,我们决定回到第一性原理,重点讨论那些已经被验证、确定成立的原则,以及为什么在 AI 时代这些原则依然适用。
我同意 Betsy 的看法:考虑到 AI 技术变化如此之快,我们最终还是出色地完成了这项工作。至于具体采用了什么方法,先留一点悬念,读了书就知道了。总的来说,这是个很大的挑战,但我对最终呈现的内容非常满意。
Niall Richard Murphy: 我先提醒大家注意一点。相比今天参加讨论的其他人,我在日常工作中可能接触了更多 AI 领域的最新进展。比如,METR 有一张广为流传的图表,常被用来衡量 AI 系统能完成多复杂的任务。从图中可以看到,AI 的能力正在快速提升。这也让我有些担心,我们现在写下的内容,可能今天就已经过时了,更不用说等到正式出版、读者真正拿到书的时候。
为此,我们团队反复讨论和修改,仔细斟酌该从哪些角度来写。最终,我们延续了第一版的思路,尽量围绕具有长期价值的基本原则展开,而不是介绍某项具体技术或某个特定版本,比如 HTML5 入门教程之类的内容。后者很容易随着技术发展而过时。
但要准确评价 AI 在 SRE、软件工程等领域究竟能发挥多大作用,还有一个难题。除了技术迭代太快,更重要的是大语言模型本身存在一些固有局限。它们可能产生幻觉、编造信息,也容易受干扰而偏离任务。从某些方面看,AI 的认知能力甚至超过人类,但在另一些方面,它又可能是一个远远无法满足要求的协作伙伴。
如何应对这种能力上的不稳定,是我们必须解决的问题,尤其是在生产环境中。一项任务的准确率是 99.9% 还是 99.5%,看似只差一点,结果却可能截然不同。我们也尝试在书中提出一些应对这些问题的指导原则。
最后我想做一个预测:今年结束之前,全球每一位 SRE 都需要对 AI 建立足够深入、基于实际了解的认识,即使他们还没有亲自用过 AI 工具。到这个十年结束之前,我们则必须学会如何有效控制这些系统。
Christof Leng: AI 正在非常迅速地改变我们的行业。但科技行业一直都在变化,这正是它令人兴奋的原因。所以,对科技领域的任何主题来说,其实都不存在绝对合适的出书时间。但这不意味着我们就不该讨论这些事情。
我认为真正重要的是写下一本书,与读者交流,然后大家一起学习。我们在书中重点做的一件事,就是努力找到那些我们已经确认正确的核心原则。现在每个人都在尝试弄清楚,该如何在生产环境中使用 AI。没人知道两年、五年或十年之后,这件事会变成什么样。
但这本书有一部分内容,专门讨论如何安全地在生产环境中采用 AI:一步一步引入 AI,在这个过程中逐渐建立信心,同时尽可能降低风险。我认为这是一种非常符合 SRE 思维方式的做法。
David Blank-Edelman: 我希望在第二次讨论里,我们还能继续深入这些话题。我个人特别感兴趣的一个问题是:这么多年来我一直在运维领域工作,我们基本上都是在用具有确定性的系统,获得确定性的结果。但现在,我们突然拥有了一种本身并不倾向于产生确定性结果的工具。我很期待能继续讨论这个问题。
好了,今天的讨论先到这里。感谢各位参加这场分为上下两部分的讨论中的第一部分。接下来的节目里,有些嘉宾会再次回来,也会有新的嘉宾加入。非常感谢大家今天分享有关即将出版的第二版《SRE》的讨论。
播客链接: https://t.co/nkzVrTfQG0
 发表于 1 小时前
|
查看: 7|
回复: 0
 /1


