上篇把环境接好了,AI 能读工程,也能自己敲编译命令。这篇继续聊嵌入式 AI 编程的提示词。
同一句“帮我写个 SPI”,有人拿到的代码烧进去就能跑,有人拿到一堆寄存器乱炖,编译先报三个错。
差别常常不在模型,而在你给它的硬件信息够不够。
下面拆四件事:硬件上下文写什么、任务怎么拆、约束怎么写、怎么验收。末尾留了一份能直接抄的模板。
数字都来自公开论文,出处我都标在下面,方便你自己去核。自己那点经验放在判断里,不往数字里掺。
01 同一句话,两种代码
嵌入式代码天生绑定硬件。同一颗芯片,换个封装、换个晶振、换个库版本,初始化代码就变了。纯软件里那种“写个排序,拿来就能用”的通用件,在嵌入式里几乎不存在。
AI 不是不会写 SPI,它是不知道你的 SPI。
你没告诉它芯片型号,它就按训练数据里见得多的那颗写。没说晶振频率,默认给你 72MHz 外部晶振。你说了 SPI1,它不知道片选接在哪个脚,也不知道从机最高能跑多少时钟。
出来的代码看着挺整齐,寄存器名字也全对。
上板不响。
代码本身挑不出错。它只是替你猜了那颗芯片,猜的是市场上最常见的一颗。你的板子要是 25MHz 晶振,或者干脆用内部时钟,编译照样能过,板子一声不吭。
02 先看两个公开测试
不讲感觉,摆数据。
EmbedBench 是 ICSE 2026 的一篇论文(arXiv:2506.11003),专考大模型干嵌入式。126 道题,9 类元器件,3 块开发平台,10 个主流模型。
同一个模型 DeepSeek-R1,干的活一样,给的信息从少到多,结果是这样。
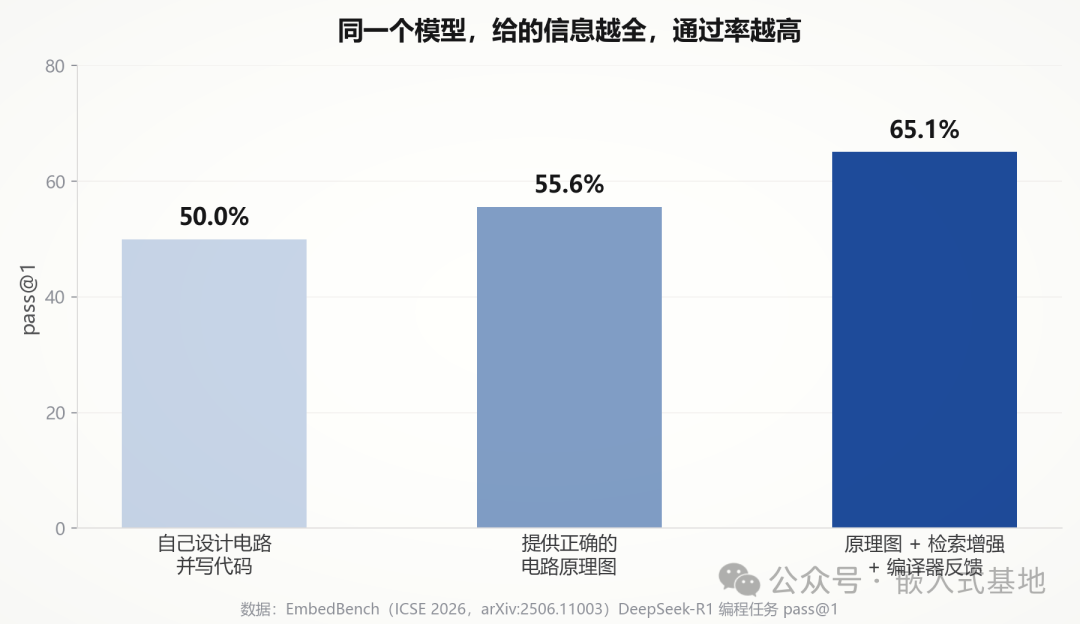
▲ 同一个模型,信息从少给到多,通过率跟着涨(EmbedBench,arXiv:2506.11003)
自己设计电路自己写,只有 50.0%;给一张正确的原理图是 55.6%;检索增强和编译器反馈都接上,才到 65.1%。
从 50 到 65,涨了 15 个百分点,这中间模型一行没换。
另一组数据更说明问题。同一套电路设计,往树莓派 Pico(MicroPython)搬,通过率能到 73.8%。往 ESP-IDF 搬,工业上真在用的那套框架,只有 29.4%。
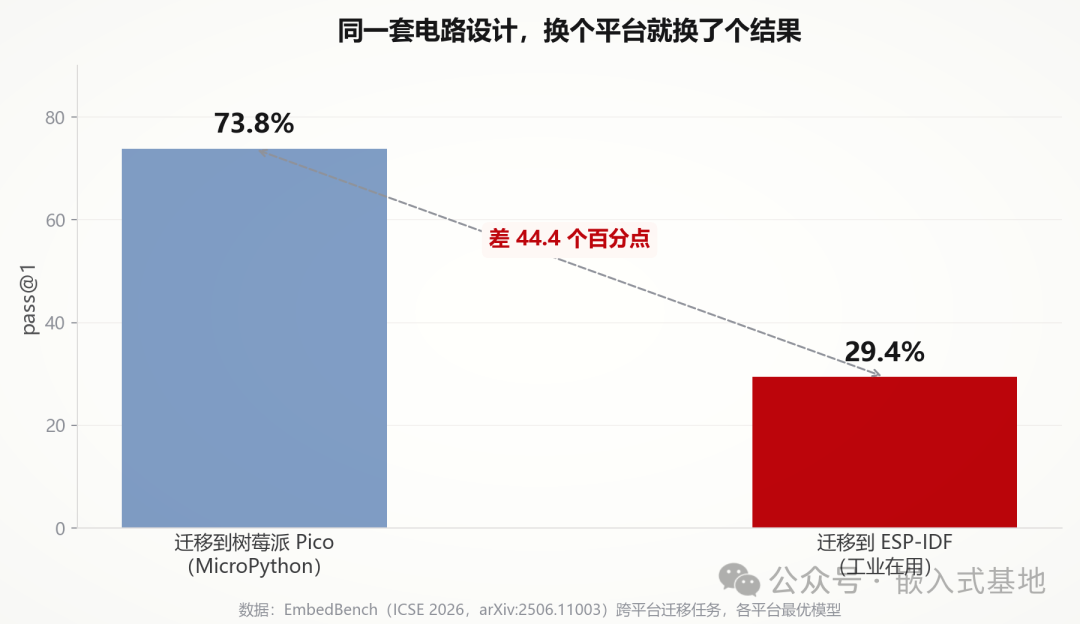
▲ 同一套设计,换个平台差出 44.4 个百分点(EmbedBench 跨平台迁移任务)
44 个百分点。换个更强的模型,提升通常没这么大。而“帮我写个 SPI”这句话里,芯片、时钟、引脚、从机,一个都没提。
再补一个结论。SkillsBench(arXiv:2602.12670)测了 86 个任务、11 个领域、7308 条轨迹,注入精选过的结构化技能之后,平均通过率涨 16.2 个百分点。
这份基准还有个结果:让模型自己生成技能,基本没有增益。它造不出自己缺的那部分程序性知识,那部分只能人来补。
关键约束挑出来就够了。手册不用整个贴进去,贴多了反而把重点稀释掉。
03 硬件上下文六件套
我一般填六项。
芯片和封装先写清:型号、内核、Flash 和 RAM 大小,有没有硬件浮点单元。FPU 这件事影响不小,决定后面能不能放心用 float,也决定它给你的算法要不要配一份定点版本。
接着是时钟:外部晶振频率、PLL 怎么倍频、系统主频、各条总线的分频。这项最少被写,也最容易出事。
然后是引脚。哪个外设接哪几个脚,复用功能选哪个,片选由谁控制。
总线参数也别漏。模式、速率、位序、地址宽度。SPI 屏写模式 0 还是模式 3,差别是点亮和花屏。
软件栈。HAL 还是 LL 还是直接写寄存器,库版本多少,编译器和 IDE 是哪个版本。同叫“HAL 库”,隔几个版本函数签名就能变。
剩下的这一项是禁区。
哪些文件不能动,哪些时序不能改,哪些中断优先级早就有约定。这几条 AI 判断不了,它看不到你的原理图,也看不到你们团队以前为这事吵过什么。
前五项猜错了,代价通常是一堆编译错误,改回来也快。禁区这条猜错,多半要上板才发现。
这六项建议单独存成一个文件放进工程。Claude Code 认 CLAUDE.md,Codex 认 AGENTS.md,Cursor 也有自己的规则文件。上一篇写过这四个模块怎么压到最短。缺哪项你自己补,我不敢说这六条对每颗片子都够用。
04 拆小任务:一次只让它干一件事
上下文给全了,任务还是可能写砸。
“帮我把 SPI 屏点亮”,这一句里塞了配 SPI、配 GPIO、写屏的初始化序列、跑通刷屏逻辑四件事。一把梭写出来,你还是得从头查起。
我一般拆成四步,一步一验收。
一上来只配 SPI1,给出初始化函数,同时说明读哪个寄存器能确认配置生效。
然后往从机写一个字节,用逻辑分析仪该看到什么波形,让它写清楚。
再往后加 DMA 或者中断,缓冲区和数据长度怎么约,一并讲。
到这一步,才接业务层的刷屏代码。
每一步都要它说清怎么验证。
CodePromptEval 这个数据集(IEEE TSE 2025,arXiv:2412.20545)收了 7072 条提示词,是 221 个任务和 32 种技巧的全因子组合。给函数签名、给 few-shot 示例,能稳定提升功能正确性。
但五种技巧全堆上去,不一定更好,还可能带进代码坏味道。
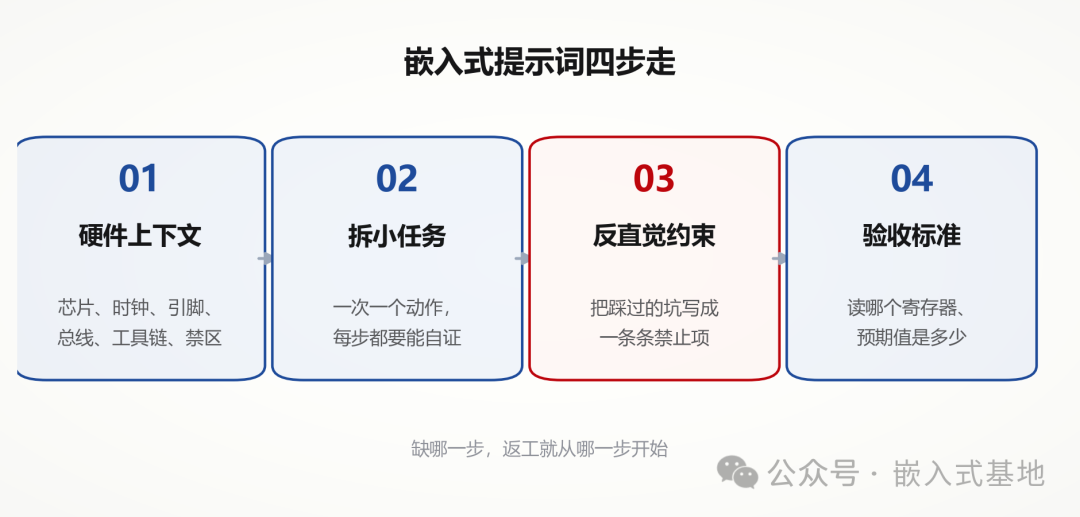
▲ 四步走,缺哪一步返工就从哪一步开始(自绘)
05 反直觉约束:把它默认会犯的错写成禁止项
还有些事,AI 默认的写法就是错的,它自己不觉得。
arXiv:2604.07192 这篇做了 6 轮实验,11 个模型,16 个任务,830 多次调用。测出来的东西跟直觉不太一样。约束能不能被遵守,跟它怎么写、怎么排版关系不大,跟约束本身说什么关系最大。
常规约束,模型基本照做,满足率在 99% 以上。反直觉的那类掉 9 个百分点。更麻烦的是它还会高估自己,你问它守没守约束,它说守了。
所以这栏只能我自己填,没有现成的一套能抄。我把它拆成两类写。
一类是硬件事实,用陈述句摆在最前面:这颗片子本来就没有硬件 FIFO,片选也得自己拉,硬件 NSS 是指望不上的;时钟树已经定死了,外设时钟要手动使能。
另一类是行为约束,用祈使句写死:中断里不放带延时的函数;初始化里不加打印,那时候串口还没配好;驱动里不动态申请内存。
还有一条我总忘,所以放在末尾:进低功耗之前,先把没跑完的外设传输处理掉。约束还要写得更具体,“注意时序”这种说法等于没写,等于什么都没约束。
这套只对裸机、或者跑在 RTOS 应用层的时候成立。Bootloader 那类场景另说。
06 一份可以直接抄的提示词模板
这就是合起来的样子,括号里换成你自己的。
# 项目
- 芯片:STM32F103C8T6,Cortex-M3,无硬件FPU
- 时钟:外部晶振8MHz,PLL×9,SYSCLK 72MHz

# 本次任务(只做这一步)
- 只写SPI1初始化,不写屏幕逻辑

# 接线
- SPI1:PA5 SCK,PA6 MISO,PA7 MOSI
- 片选:PA4,软件控制

# 从机
- ST7789,SPI最大时钟15MHz,模式0,MSB先行

# 约束(逐条遵守)
- 时钟树按现有配置,不要改
- 片选必须软件拉低,禁止用硬件NSS
- 中断里不加延时函数
- 只改 Core/Src/spi.c 与 Core/Inc/spi.h

# 输出要求
- 给出完整函数,标注关键寄存器位的作用
- 说明怎么验证:读回哪个寄存器、预期值是多少
模板不长,麻烦的是把括号里填对。那几个参数只能你自己从手册和原理图上抄,抄错一个它就顺着错的往下写。
07 验收:AI 给的代码怎么算过关
还有一个坑,是把“编译通过”当成“能用”。
有研究分析过 265 条真实交互记录(arXiv:2606.19644)。里面有一条可以直接用,我照着改成了自己的写法。提示词的具体性和上下文,跟能不能生成可落地的代码关系最强。
“验证线索”则是代码最终被采纳的首要预测因子。翻译成人话,让它把验证方法写出来,比你多要它一百行代码值钱。
我自己是这么过一遍的。先逐行核对寄存器,配置类的代码,值对不对,翻一遍手册就行,五分钟的事。然后盯时序敏感的那几段,上电顺序、片选时序、复位时序,这几段我不过夜,当天看,上板出问题的多半就在这几段,这类毛病在台架上还复现不了,只能盯着真板子。都过完了,才上板跑一遍。
前两步都过了也可能不响。编译通过不等于能上板,这句上篇说过,这里再说一次。
数据来源:EmbedBench(ICSE 2026,arXiv:2506.11003)、SkillsBench(arXiv:2602.12670)、CodePromptEval(IEEE TSE 2025,arXiv:2412.20545)、约束编码实验(arXiv:2604.07192)、提示词与 PR 产出的关联研究(arXiv:2606.19644)。这些都是公开第三方素材,不是我个人实测。六件套、约束的两类写法、验收顺序和模板,是我自己的经验。
08 下期预告
下篇讲手册。几百页的 Datasheet 和 Reference Manual,怎么切、怎么问、怎么防它把寄存器地址背错,会附一套我常用的切分方式。
这个“嵌入式 × AI 编程”系列还会继续更新。如果你也在折腾嵌入式与 AI 的配合,欢迎来 云栈社区 一起交流。
 发表于 7 天前
|
查看: 0|
回复: 0


