上篇把提示词拆成四块:硬件上下文、任务、约束、验收。还差一块没讲——AI读数据手册这件事。
寄存器配置里那些数,地址、位定义、复位值、时序参数,AI记不住,也不该让它记。靠的是查,不是背。
这篇讲三件事:手册怎么切、问题怎么问、答案怎么验。末尾留了一份能直接抄的提问模板。
01 它理解错,是因为它在猜
大模型干活的时候,没有"查"这个动作。它只会一个动作:猜下一个词该是什么。
寄存器地址它见过就见过,没见过就按最像的编一个。编出来的东西有个特点——长得特别像真的。
地址格式对,位域宽度对,连保留位那几个 bit 该怎么写都对,一眼看不出毛病。
麻烦在于这类错误不报错。编译能过,链接能过,烧进去外设就是不动。
手册里的内容属于强事实,地址差一位,中间没有任何提示。
分个类会好办些。外设是干什么的、章节怎么组织、某段时序为什么这么设计,这类问题问它挺合适,答偏了也不致命。但寄存器地址、位定义、复位值、时序参数这四样,必须给原文,一个字都不能靠它回忆。
两本手册的分工也先分清楚。参考手册写寄存器和外设行为,数据手册写电气参数、引脚定义和封装。要查寄存器就翻参考手册,拿数据手册去问位定义,多半问不出东西。
还有个常见的误会:把整本 PDF 丢进对话框,以为它就读过了。装得下和用得上之间,还差着检索这一步。窗口装得下,不等于它用得上。
02 三组公开数据
先看一篇叫 Lost in the Middle 的研究(TACL 2024,arXiv:2307.03172)。结论是:相关信息放在输入的开头或结尾,模型表现最好;放在中间,模型效果明显下降。换成专门的长上下文模型也一样。
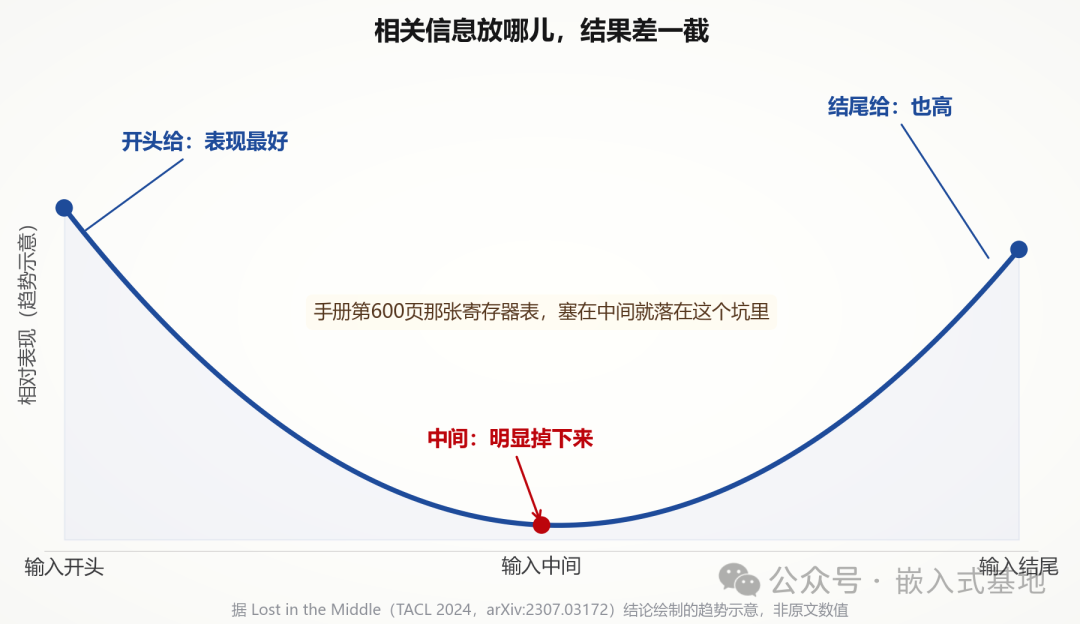
▲ 信息位置与表现的关系,据 TACL 2024 结论绘制的趋势示意,非原文具体数值
换成我们的场景。手册第 600 页那张寄存器表,你把它塞进上下文正中间,正好落在它最不看的地方。
再看一份技术报告。Chroma 在 2025 年 7 月测了 18 个模型,跑了 19 万 4 千多次调用。结论有点反直觉:输入越长,表现持续往下走,还不是均匀地走。
哪怕任务简单到只是复述一个词,长度一上去,一样掉。
报告里还有个对比实验。同一批问题,塞进完整输入平均十一万三千个 token,聚焦成小片段只有三百个 token。
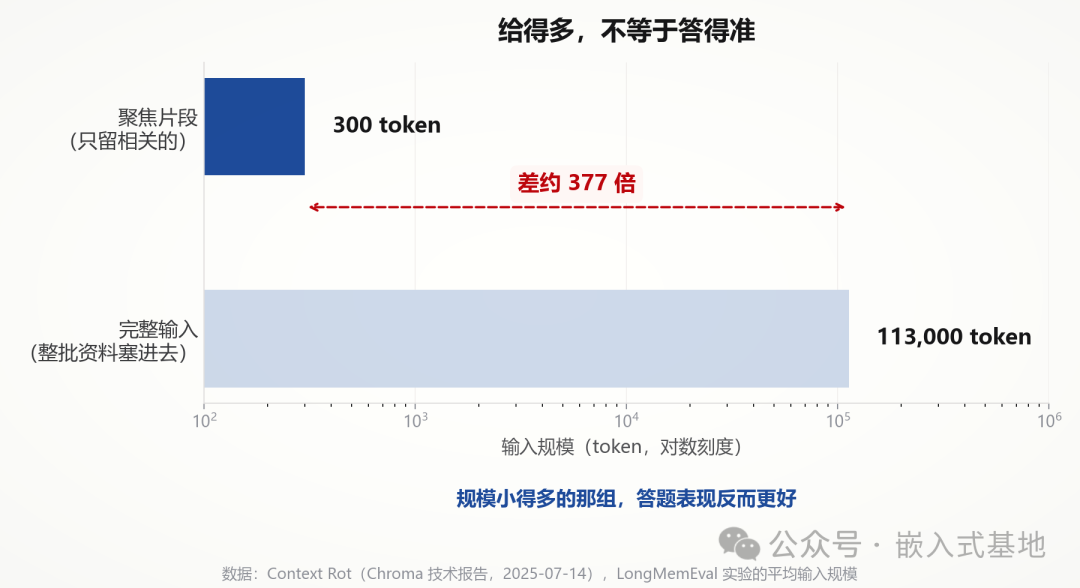
▲ 输入规模差三百七十多倍,聚焦那组表现更好(Chroma,2025-07)
这三份材料说的是同一件事。模型的注意力有限,输入越长,摊到每一段上的越少。给得多,不等于答得准。
所以我现在的顺序是反的:先想清楚要问什么,再去找那一小段,而不是先把料全倒进去。
03 千页手册,切成能用的片
先说体量。STM32F103 的参考手册 RM0008,Rev 9 那一版是 995 页,配套的数据手册 DS5319 薄得多,只有八十来页。
千页文档,你要找的东西可能就三行。
所以别整本喂,需要将手册切开。
按外设切是最省事的一种方法。SPI 一个文件,USART 一个文件,GPIO 一个文件。要写 SPI,就只给 SPI 那片,旁边的 ADC 章节一个字都不带。
先切哪几个?按这周要开展的工作来。如果当前需要调 SPI,就先切 SPI 那片,别的等用到再说。一次把十二个外设全切完,多半是白干。
一个文件别超过两三千字——太长了它照样在里面找不到,太短又缺上下文。一个外设的寄存器表加说明,差不多就是这个量级。
每一片得带上前置信息。这个外设挂在哪条总线上、时钟使能位在第几号、复位值是多少。手册把这些散在别的章节,切的时候要一起搬过来,不然它会去猜时钟。
寄存器表整张留。表头、位域、保留位、读写属性,一列都不能少。少一列,它不会报错,会自己补一个看起来合理的值。
页码留着,后面要靠它回查。
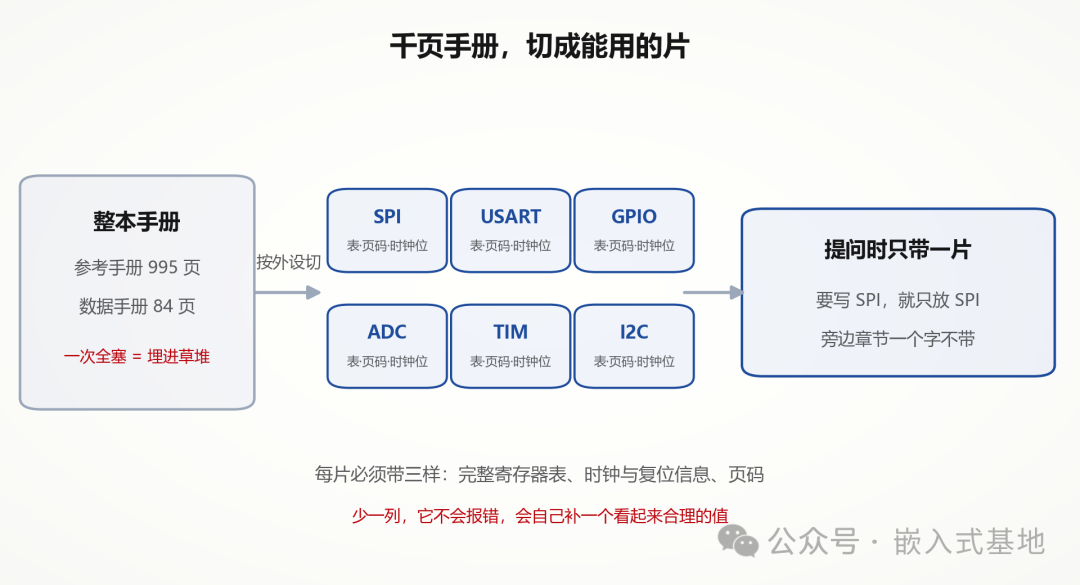
▲ 按外设切、带前置信息、整表保留、留页码(自绘)
04 切的时候最容易漏的几样
切一刀容易,切干净难。下面这几样我漏过不止一次。
跨页的表格会被切断。一张寄存器表横跨两页很常见,只按页边界切,后半张就丢了。我的做法是先找表格边界,再按边界切文件,页边界只当参考。
表头要重复贴。表格切到第二页之后表头就没了,剩一堆数值,它分不清哪列是位号、哪列是复位值。
前置信息散在别的章节。时钟使能位常在 RCC 那章,复用功能在 GPIO 的复用表里,中断号在向量表里。这几样得一起搬进 SPI 那片。
脚注别删。表下面那行小字常写着"仅在某种模式下有效",删了就是给自己挖坑。
切完先自测一条。随便挑一个位,翻回去看手册是不是这么写的。切错了这一步就能看出来,比在代码里发现早得多。
文件名带上出处。像 spi_rm0008_p750-762.md 这样,回头核对的时候一眼就知道该翻哪页。
切好的片段放工程里一个 docs/manual 目录,按外设命名。项目规则文件(CLAUDE.md、AGENTS.md 这类)里只写索引,讲清哪个外设看哪个文件,不要把正文粘进去。规则文件每次对话都要读一遍,塞满了反而挤掉真正要紧的那几条约束。
这套切法不是每个型号都好使。有些厂商的手册结构乱,一个外设的说明散在三四章,切起来很费劲。那种情况我一般只切当前要用的那部分,用完就扔。
05 一句话抽完整张表,现在还不现实
有个基准能说明现在的水平。ExtractBench(arXiv:2602.12247,KDD 2026)用 35 份真实 PDF、一万两千多个字段做评测,测的是从 PDF 里抽结构化数据。
结论是前沿模型在企业真实 schema 上仍然不可靠,字段一多性能就急剧下降。其中一个三百六十九字段的表格,所有被测模型的有效输出都是零。
三百六十九字段是什么概念?一颗中低端 MCU,外设寄存器表加起来差不多就是这个量级。
放到我们这边就是:别指望一句话把整张寄存器表抽成 CSV。一次一个外设,一次一张表,抽完自己核。
顺带说个相关结论。长上下文和检索增强哪个更好,Google 和密歇根大学做过一轮对比(EMNLP 2024)。资源给足的时候,长上下文平均略好;但六成三的查询,两种方式结果完全一样。他们提的混合做法,在效果相当的前提下省下约六成五的 token。
所以全塞进去这件事,性价比不高。
06 让它交出出处
防编造最有效的一招,是要求它回抄原文。不是概括,是把手册里那句话原样抄出来,后面附上页码。
抄不出原文的,基本就是自己编的。
这一步别省。
还有一句必须写进提示词:手册里没写的,直接说没写,不许推测。这句不能省,模型的默认倾向是给一个答案,不是承认不知道。
再狠一点,让它标出改的是第几位。比如"把 SPI1 的 CR1 第 6 位从 0 改成 1",这种话它编不出来,必须真去看表。
核对的时候有个省事的办法。让它在回答里带上原文,你只扫那几句原文,跟手册对得上就放行,不用逐字读它给的分析。这一步花的时间,比它编一次错代码再调半天短得多。
07 一份能直接抄的提问模板
前面几条合起来就是这样,方括号里换成你自己的。
# 手册片段
[粘贴 SPI 章节的寄存器表,含表头、脚注与页码]

# 芯片
STM32F103C8T6,外部晶振8MHz,SYSCLK 72MHz

# 本次只回答一个问题
SPI1 的波特率怎么设

# 输出要求
- 先回抄手册里相关的原文句子,标出页码
- 再给配置步骤,每一步写明改的是哪个寄存器的哪一位
- 手册里没写清楚的,直接说没写,不要推测
- 这次不要给完整初始化代码
这份模板管的是怎么问。剩下的工作是切手册、核页码,这部分工作量无法省掉。
问到一半它回你"片段里没有",先别急着改问法。多半是这片技术文档提供的资料不够,把缺的那段补进去再问一遍。硬要它答,它不会承认不会,会给你编一段看着像的,你还得多花一道工夫去识破。
文中的数据都有出处。长上下文那部分来自 Lost in the Middle(TACL 2024,arXiv:2307.03172),上下文腐化那组数来自 Chroma 在 2025 年 7 月发的技术报告。检索增强与长上下文的对比出自 EMNLP 2024,表格抽取的基准是 ExtractBench(KDD 2026,arXiv:2602.12247),手册页数取自 RM0008 Rev 9 和配套的 DS5319。都不是本号实测。切分方式、提问模板和验收做法是我自己的经验,仅供参考。封面配图由 AI 技术生成。
如果你也在折腾 AI 辅助嵌入式开发,欢迎来云栈社区一起交流。
 发表于 7 天前
|
查看: 0|
回复: 0


