摘要
ElasticSearch 的搜索逻辑并不复杂,但如果只是停留在“会用”的层面,很多诡异现象会让人摸不着头脑。这篇文章从整体到细节拆解一遍底层工作原理,重点回答三个问题:
- 为什么
foo-bar* 匹配不到 foo-bar ?
- 为什么增加更多文档后,索引(Index)反而会被压缩?
- 为什么 ElasticSearch 这么吃内存?
版本
文中示例基于 elasticsearch-2.2.0。
图解 ElasticSearch
云上的集群
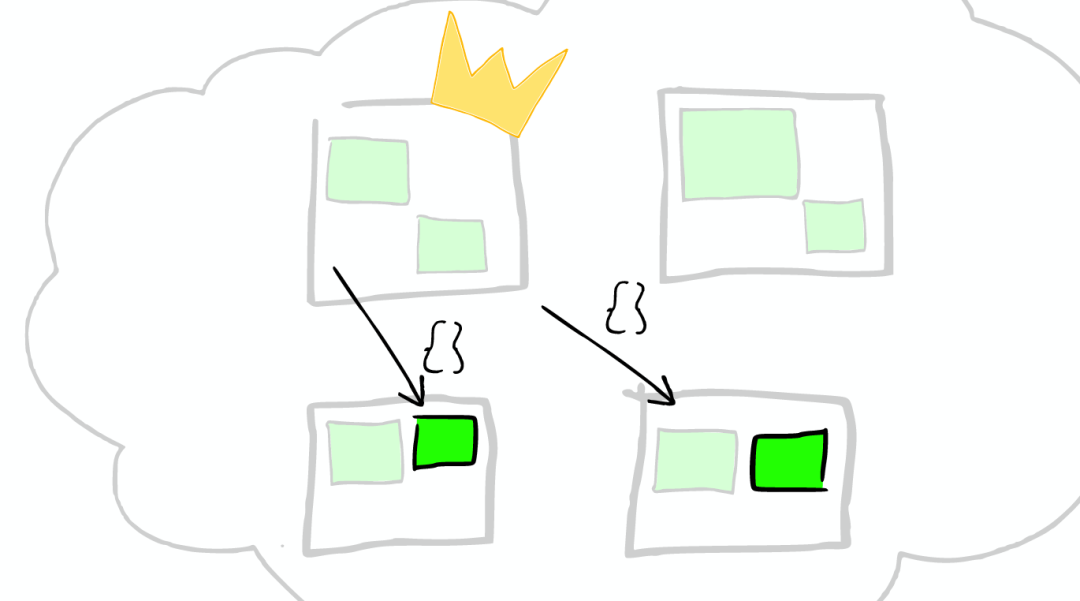
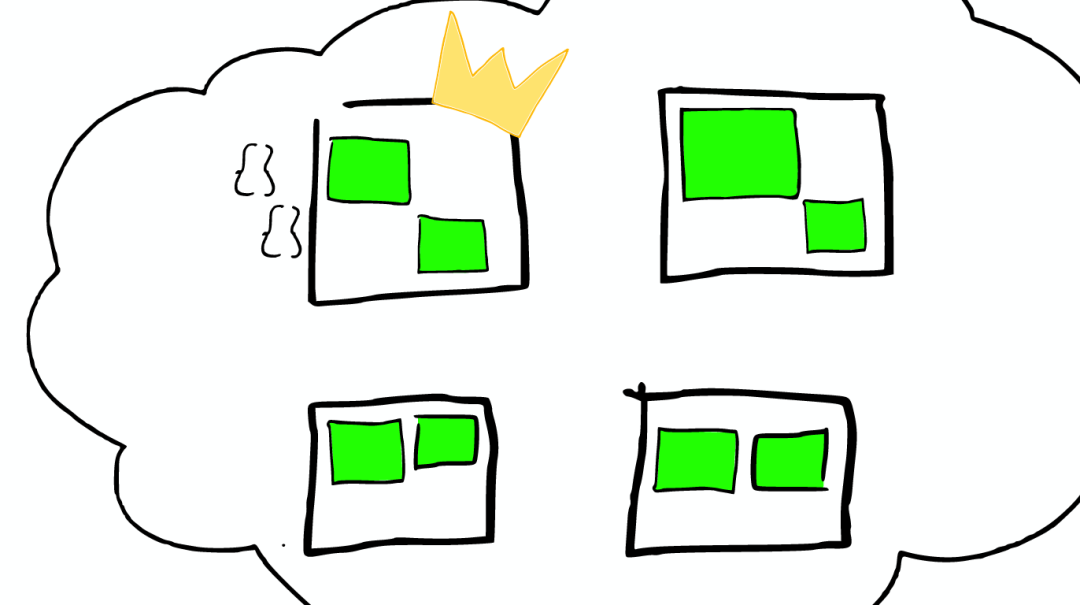
先看一个典型的 ElasticSearch 集群。一个 集群 通常由若干节点组成,这些节点可能分布在不同的物理机上。云朵形状的外壳代表集群的抽象边界,里面的白色方块就是一台台节点。
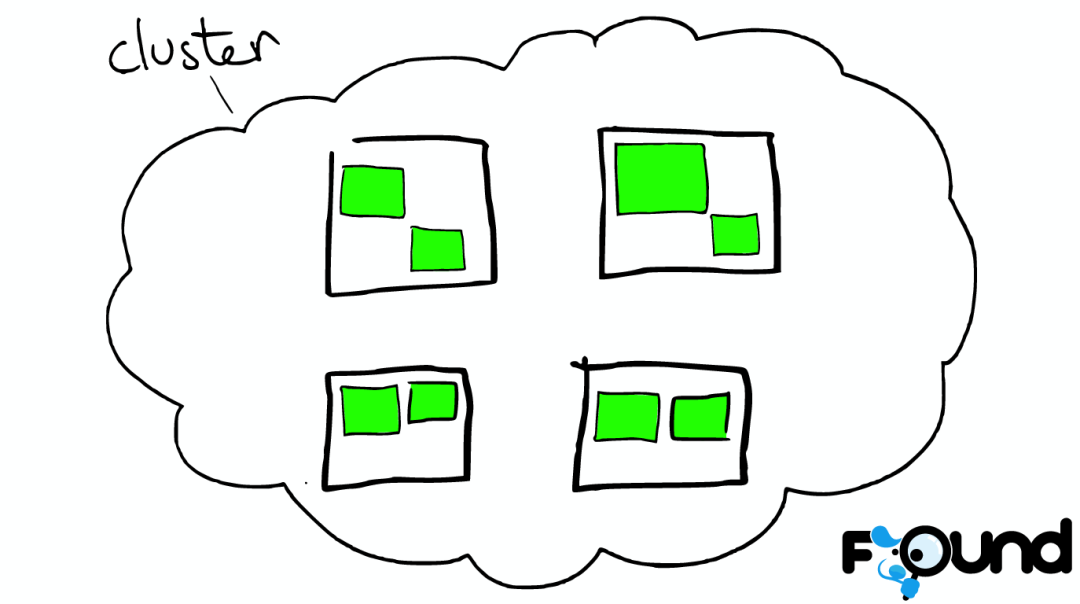
集群里的盒子
云朵里的每一个白色正方形盒子代表一个节点——Node。
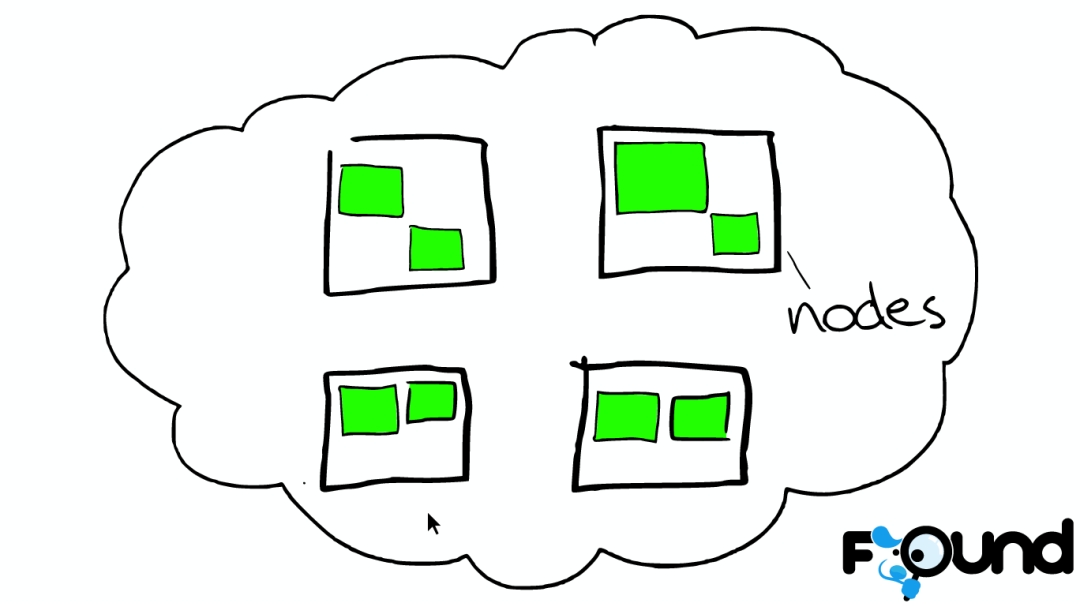
节点之间
在一个或多个节点之间,这些绿色小方块组合在一起,就形成了一个 ElasticSearch 索引。
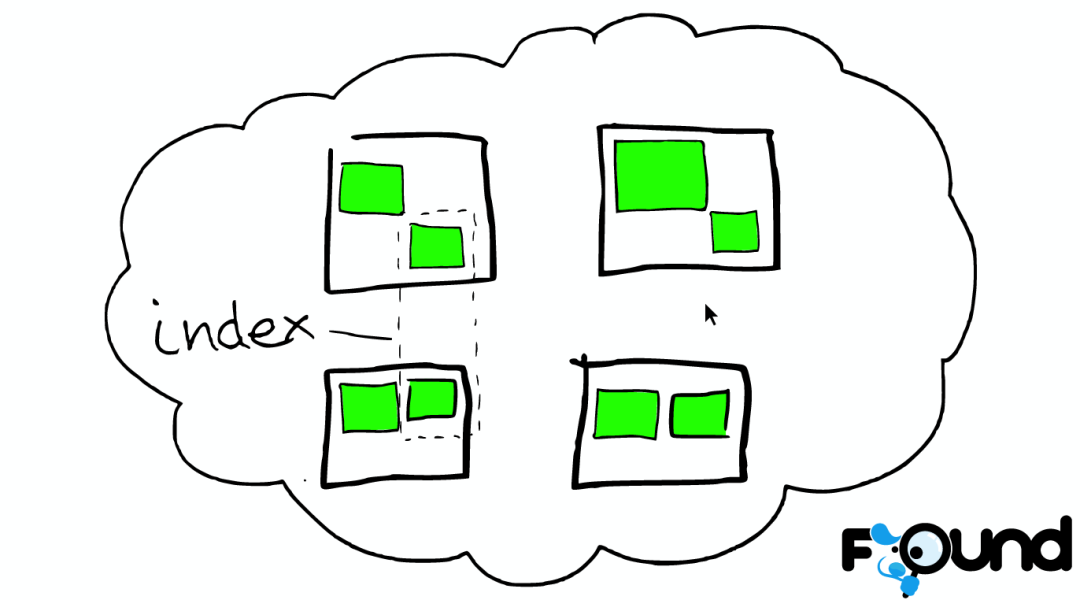
索引里的小方块
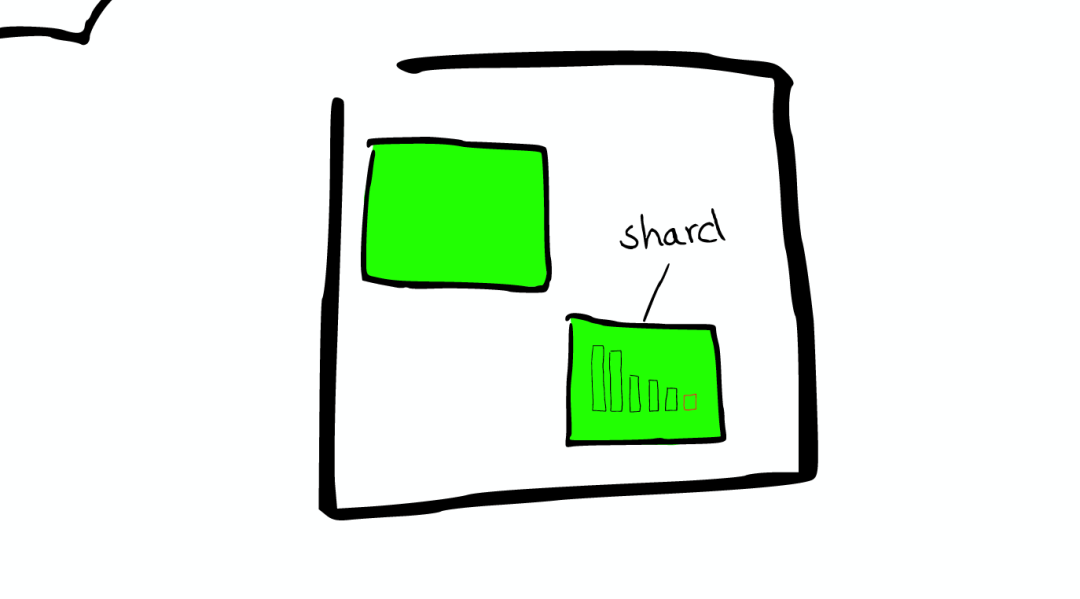
分布在不同节点上的绿色小方块,在索引内部被称为分片——Shard。
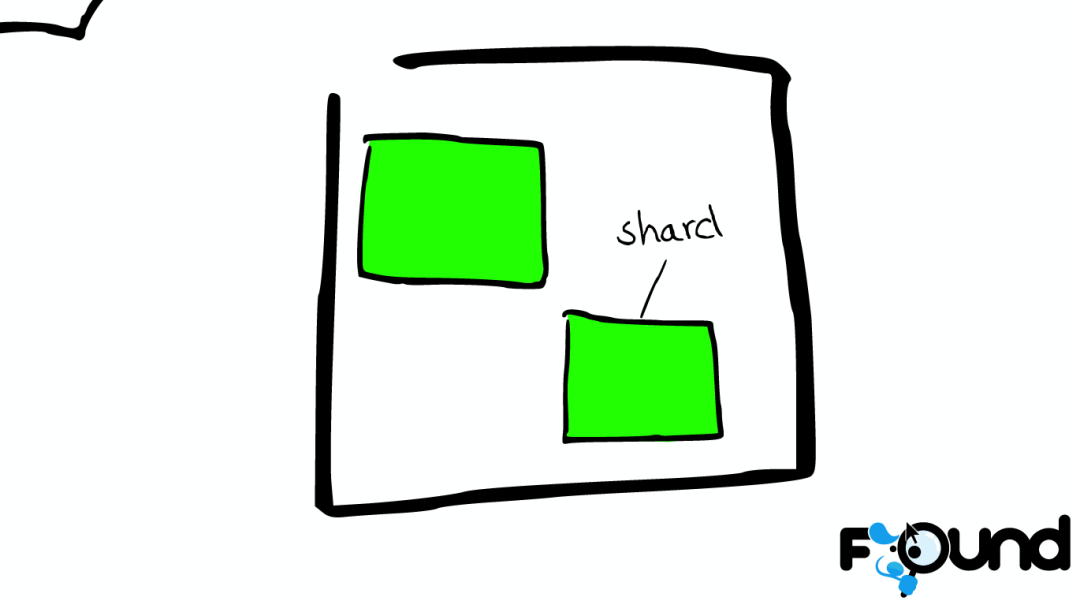
Shard = Lucene Index
一个 ElasticSearch 的 Shard 本质上就是一个 Lucene Index。
Lucene 本身是一个全文检索库,ElasticSearch 是构建在其之上的封装。接下来的内容,大部分都是在讲 ElasticSearch 如何基于 Lucene 完成搜索。
图解 Lucene
Mini 索引——segment
在 Lucene 内部,有大量的小 segment,可以把它们理解为 Lucene 内部的 mini-index。
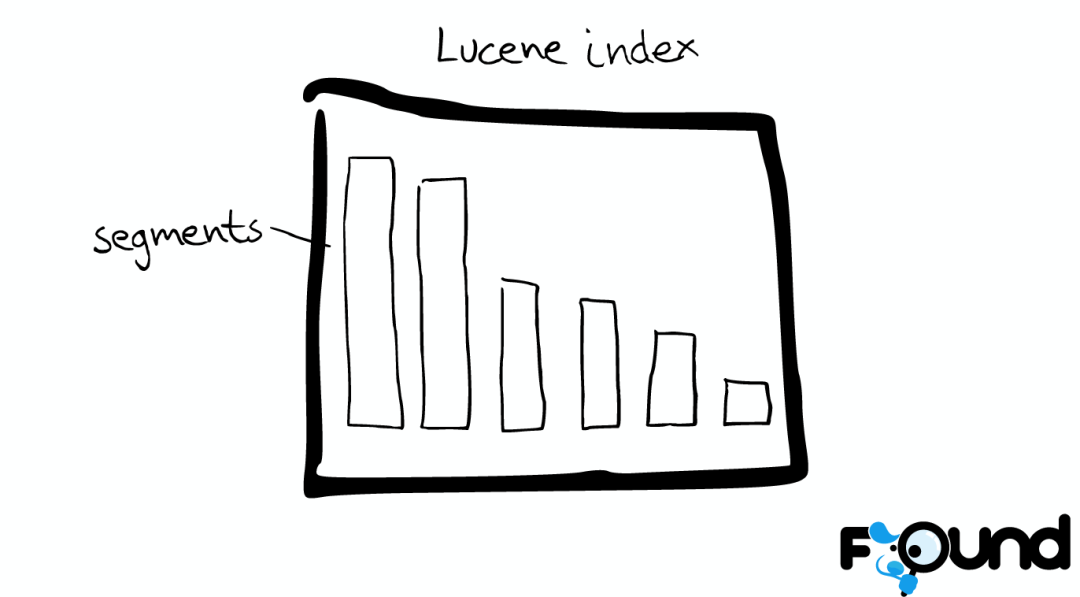
Segment 内部
每个 segment 内藏着多种数据结构:
- Inverted Index(倒排索引)
- Stored Fields(字段存储)
- Document Values(文档值)
- Cache(缓存)
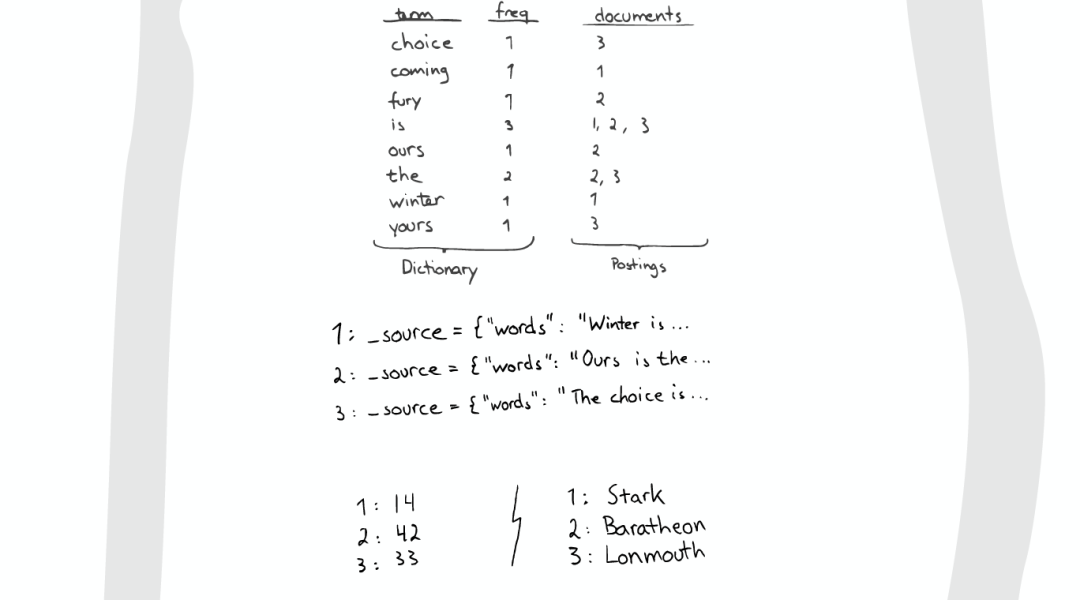
最最重要的 Inverted Index
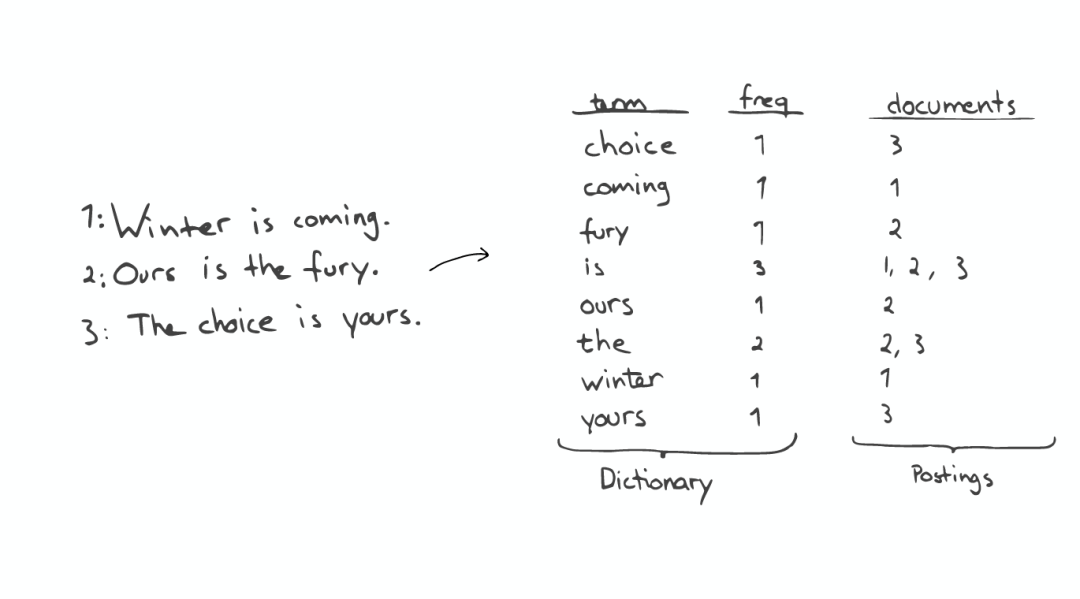
倒排索引由两部分组成:
- 一个有序的数据字典 Dictionary,记录 Term 及其词频。
- 与 Term 对应的 Postings,记录该词出现在哪些文档中。
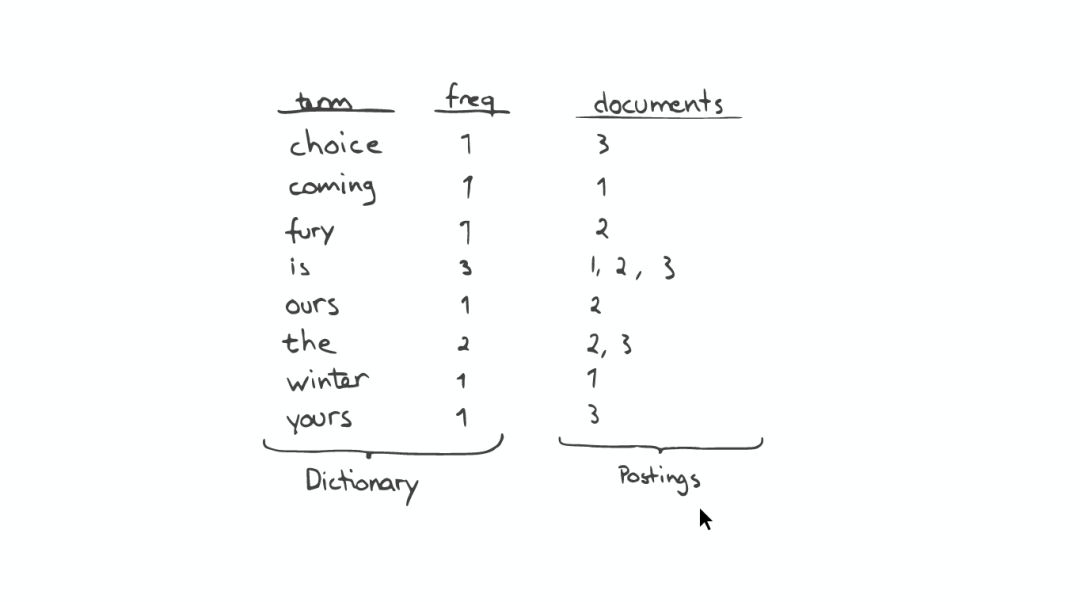
搜索时,先把查询内容拆解成 Term,再到字典里定位这些 Term,从而快速找到包含相关词的文档。
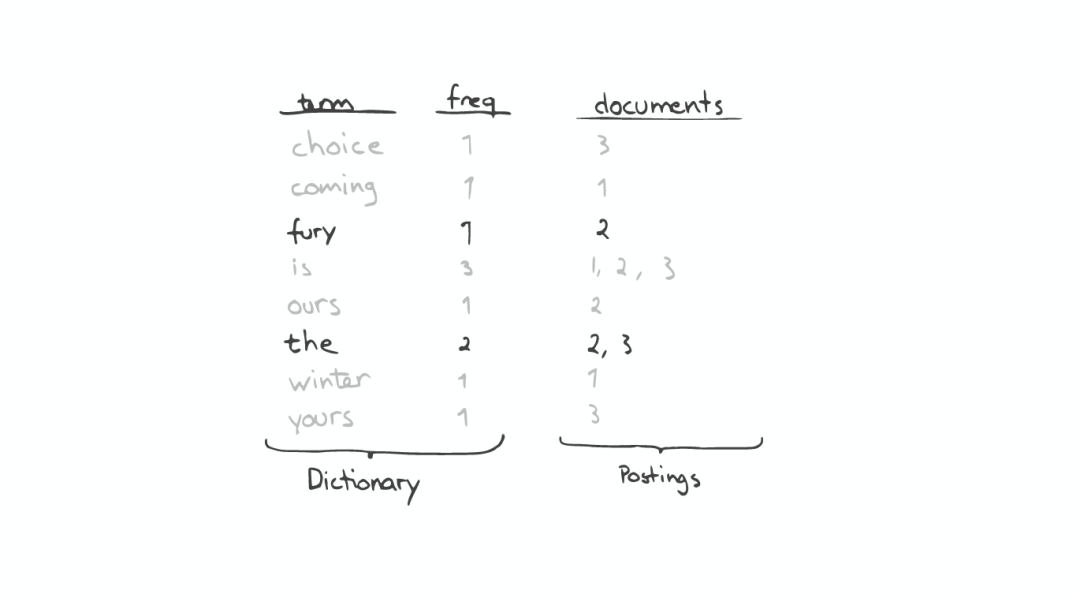
查询 “the fury”
假设我们要查 the fury,系统会拆成两个 Term,分别查询它们对应的 Postings,再取交集,得到同时包含这两个词的文档。
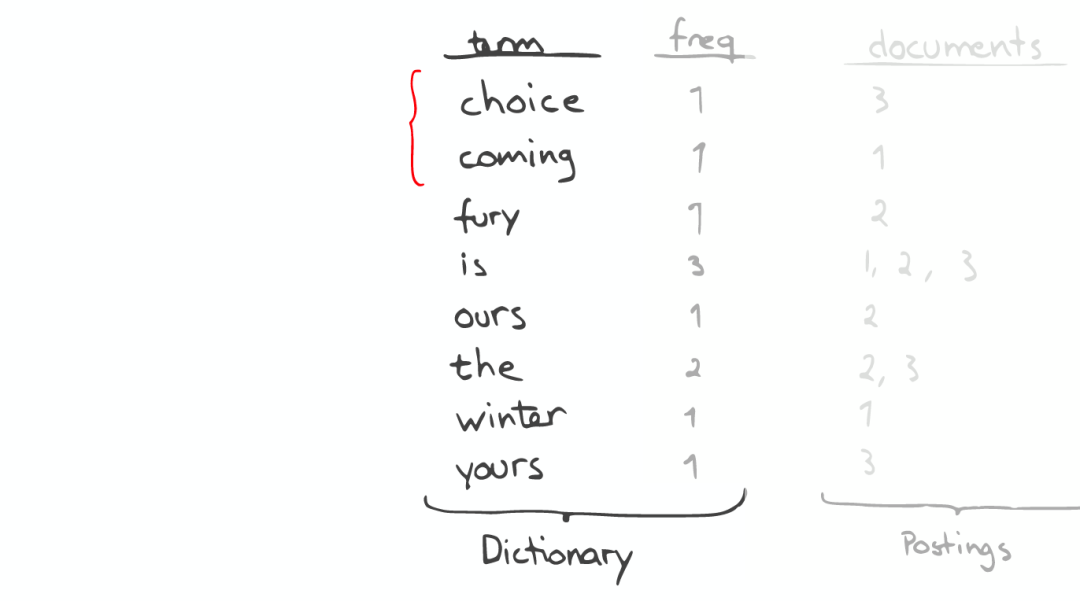
自动补全(AutoCompletion-Prefix)
想查找以字母 c 开头的词,可以先对字典做二分查找,就能快速定位到 choice、coming 这类 Term。
昂贵的查找
但如果想查找所有包含 our 的单词,就没有捷径了。系统只能遍历整个 Inverted Index,成本非常高。
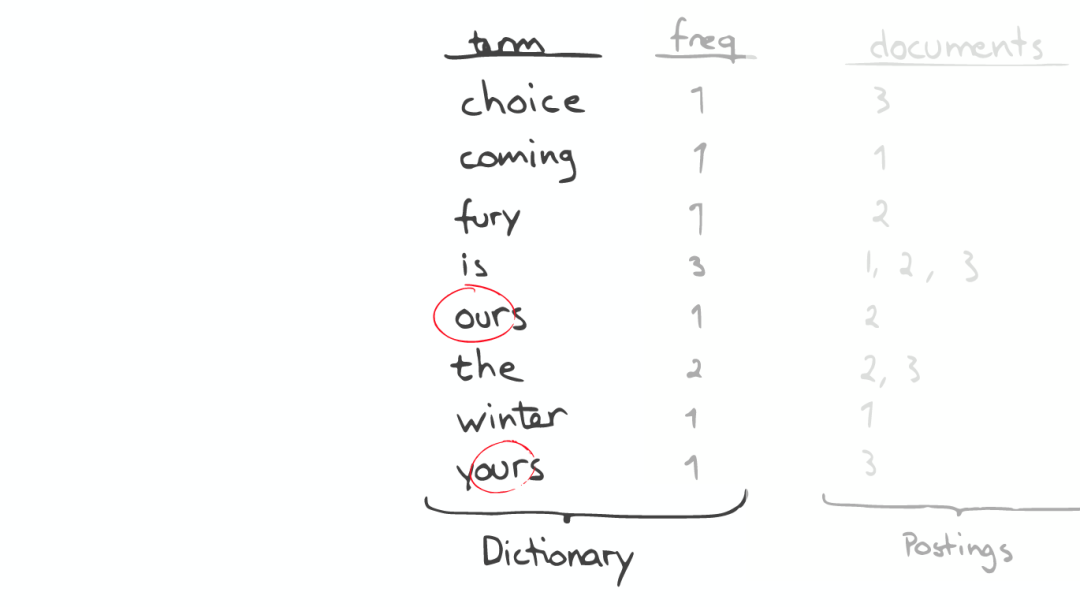
此时优化的关键,就变成了如何生成更合适的 Term。
问题的转化
针对这类问题,有几种常见的处理方式:
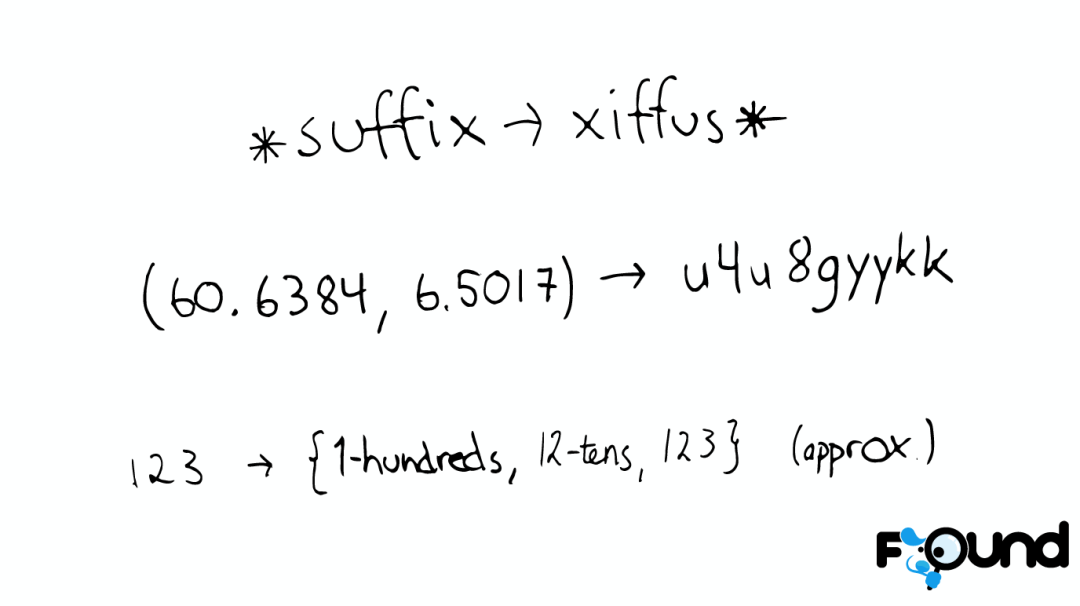
*suffix → xiffus*:如果以后缀为搜索条件,可以做 Term 逆向处理。(60.6384, 6.5017) → u4u8gyykk:地理位置信息可以转成 Geo Hash。123 → {1-hundreds, 12-tens, 123}:简单的数字可以生成多种形式的 Term。
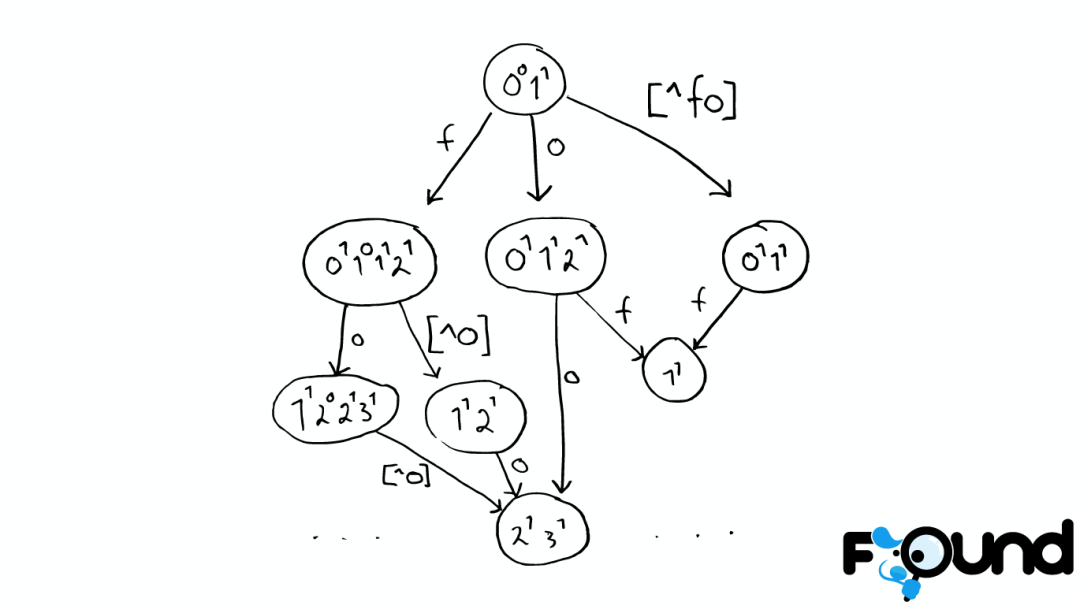
解决拼写错误
用一个 Python 库把单词生成一棵包含错误拼写信息的树形状态机,很多拼写错误就能被自动纠错。
Stored Field 字段查找
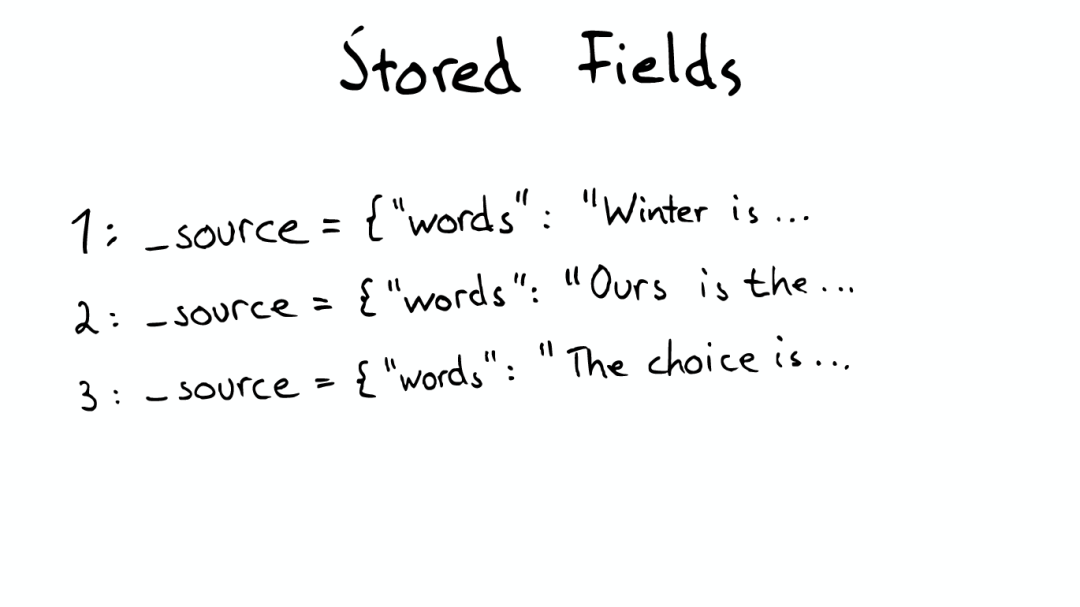
当需要按标题内容查找文档时,倒排索引并不擅长。Lucene 提供了另一种数据结构:Stored Fields。本质就是一个简单的 key-value 存储。默认情况下,ElasticSearch 会保存整个文档的 JSON source。
Document Values 为了排序、聚合
排序、聚合、facet 这类操作,如果借助倒排索引去做,往往需要读取大量不相关的信息。
所以又有了 Document Values。它本质上是一种列式存储,专门为同类型数据的排序和聚合做了优化。
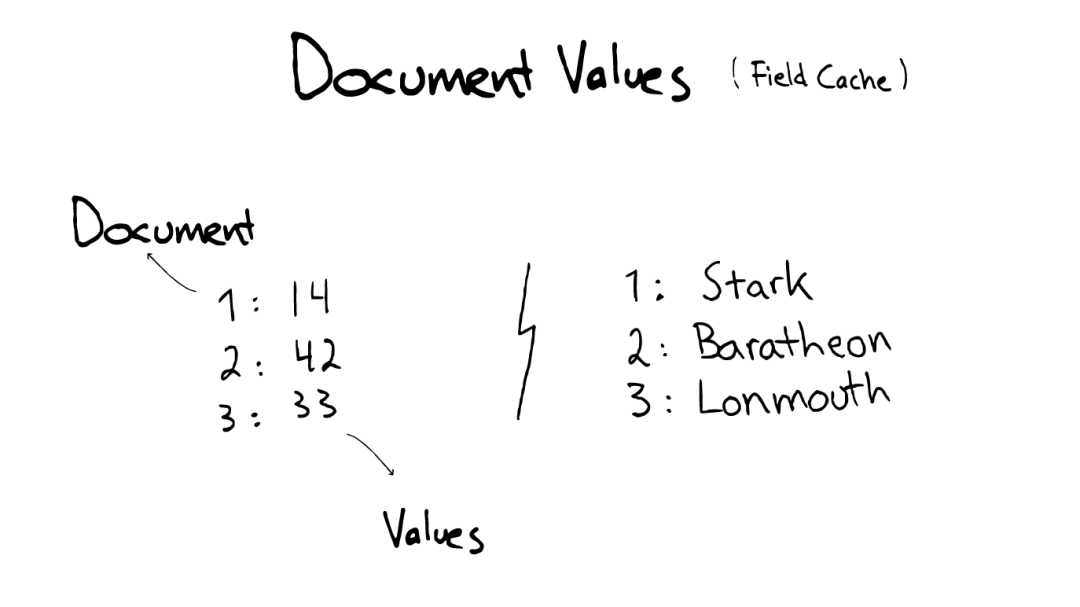
为了提高效率,ElasticSearch 可以把某个 Document Value 整体读进内存再做操作。访问速度快了,代价是内存占用随之上升——这也是它吃内存的一个重要原因。
总的来说,Inverted Index、Stored Fields、Document Values 以及它们的缓存,都蜷在 segment 内部。
搜索发生时
拿到一次搜索请求后,Lucene 会搜索所有 segment,把每个 segment 的返回结果汇总、合并,最后呈现给客户端。
Lucene 的几个特性让这个过程变得很关键:
- Segments 是不可变的(immutable)
- Delete?删除发生时,Lucene 只是把文档标记成删除状态,原文件不会移动,也不会被真正擦除。
- Update?更新本质上就是“先删除,再重新索引(Re-index)”。
- 随处可见的压缩
- Lucene 极擅长压缩数据,几乎所有教科书里提到的压缩方式,在 Lucene 里都能看到。
- 缓存所有的所有
- Lucene 还会缓存大量信息,这直接抬高了查询效率。
缓存的故事
每当 ElasticSearch 索引一条文档,都会为它建立缓存,并每秒刷新一次。刷新之后,这些文档就能被搜到。
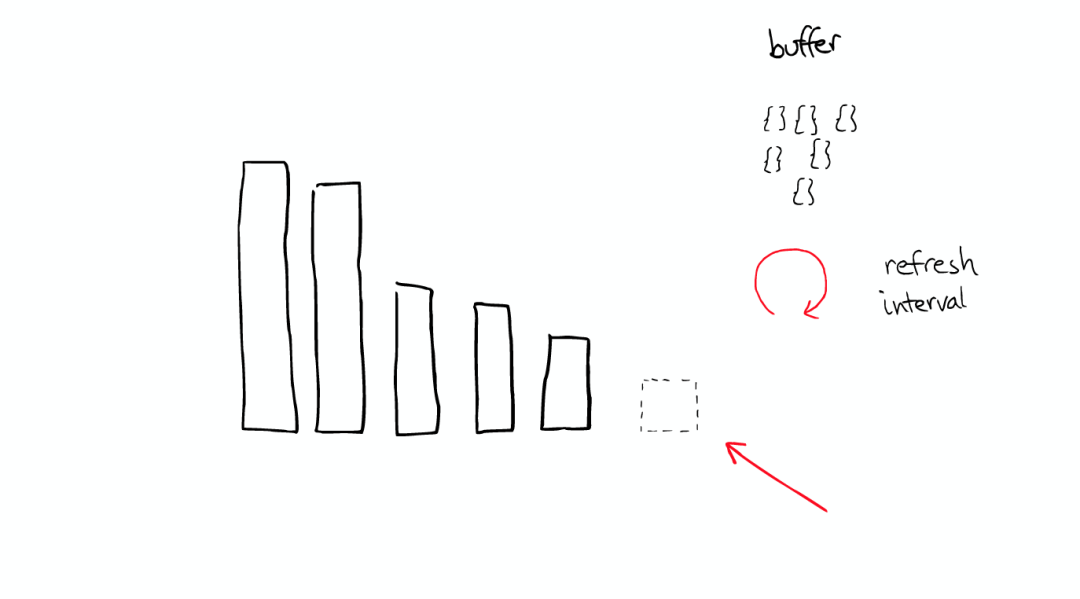
随着时间推移,segment 会越来越多。
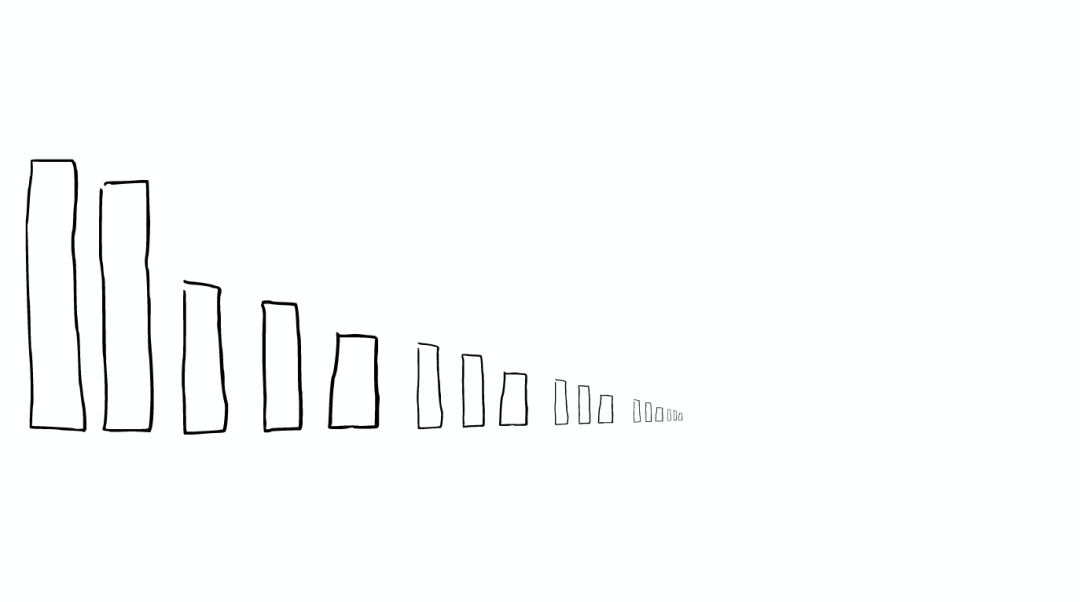
所以 ElasticSearch 会定期合并这些 segment,合并过程中被替换的旧 segment 最终会被删除。
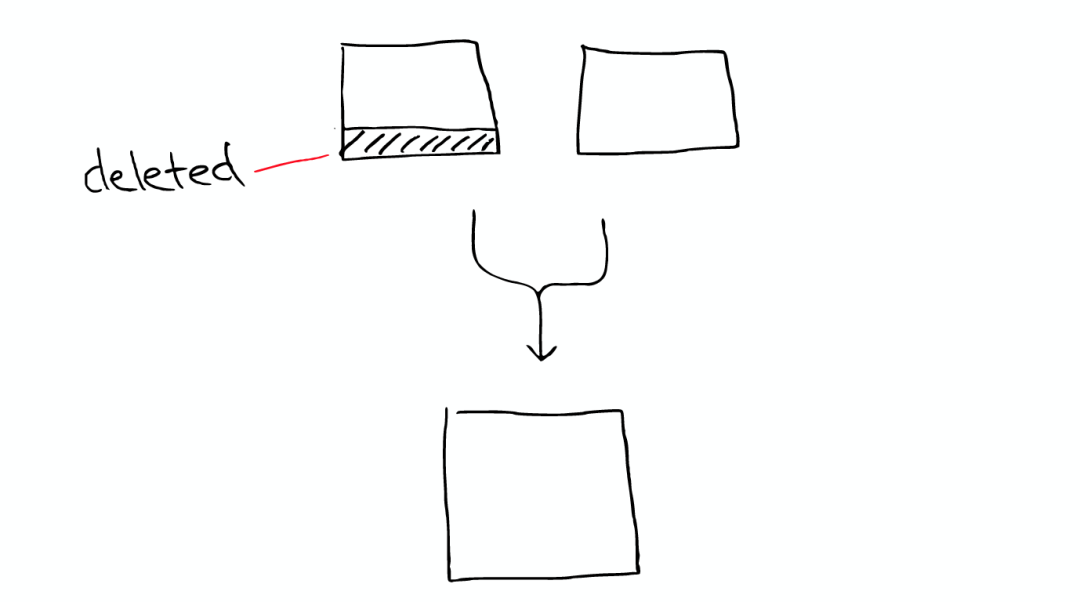
这也是为什么增加更多文档,反而可能让索引占用磁盘空间变小——触发 merge 后,Lucene 会重新组织数据,压缩自然就来了。
举个栗子
假设有两个 segment 准备合并:
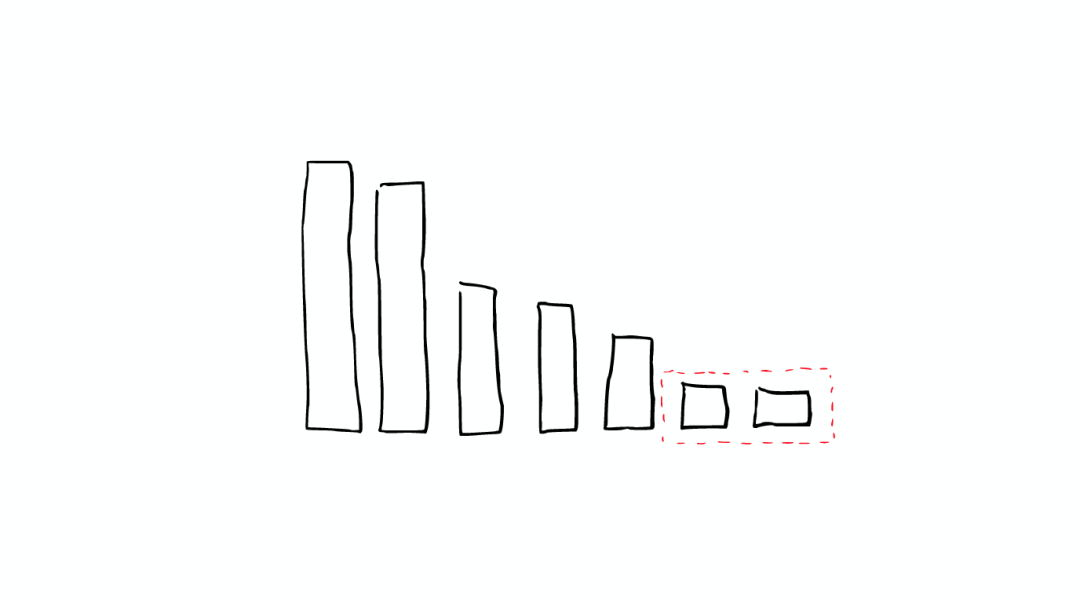
合并后,旧的两个 segment 被删除,新 segment 诞生:
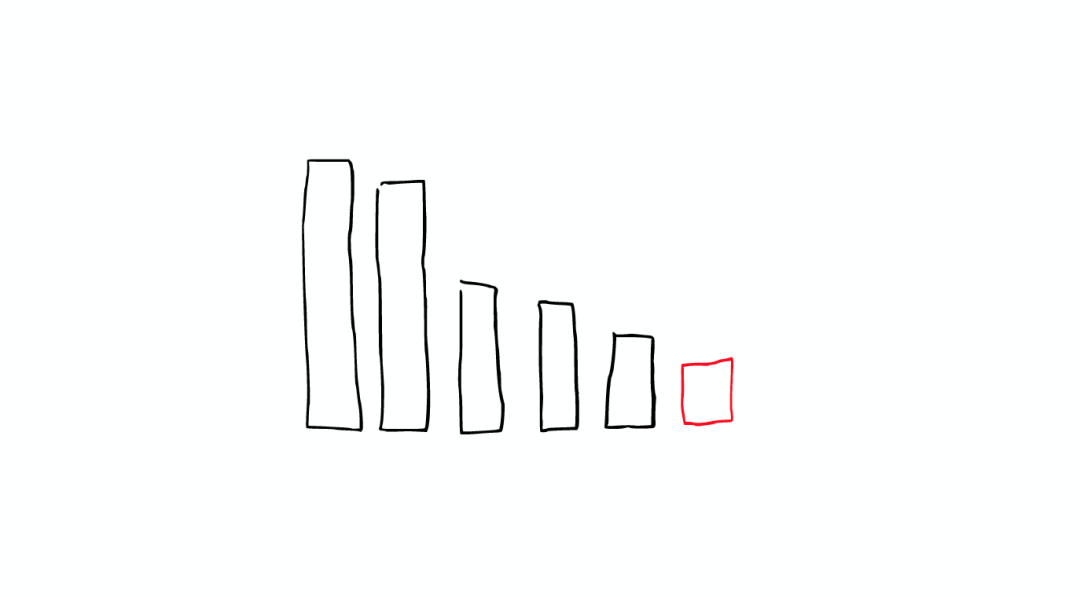
这个新 segment 在缓存中处于 cold 状态,但大多数 segment 仍然保持 warm 状态,缓存没有整体失效。
以上过程经常发生在 Lucene Index 内部。
在 Shard 中搜索
ElasticSearch 在 Shard 中的搜索过程,与 Lucene Segment 中的逻辑类似。
区别在于:Shard 可能分布在不同 Node 上,搜索和返回结果时,所有信息都要跨越网络传输。
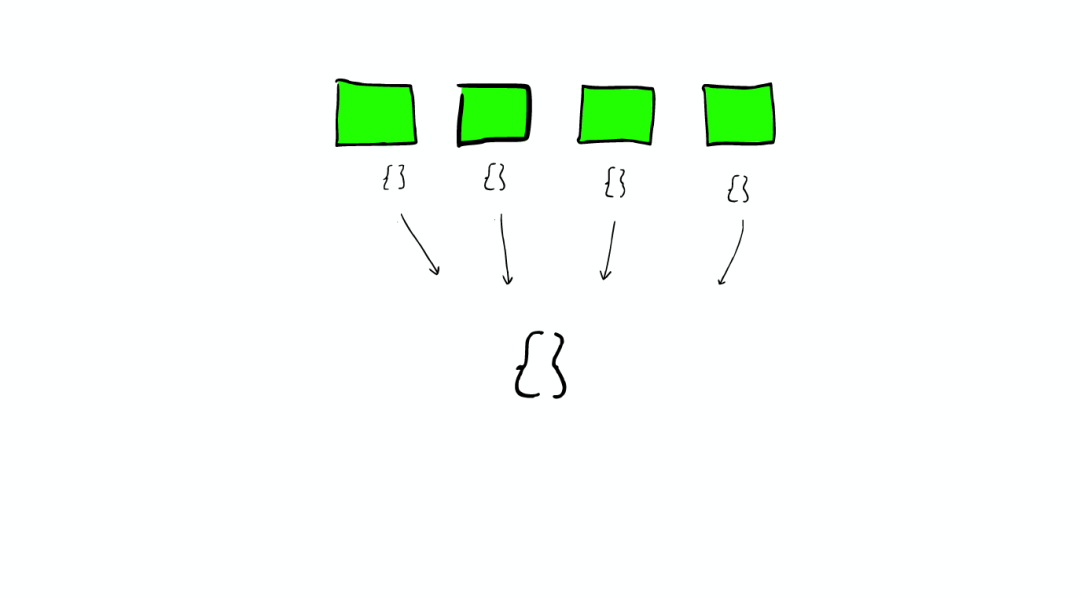
需要记住一个基本事实:
1 次搜索查找 2 个 shard,相当于对这 2 个 shard 各搜索 1 次。
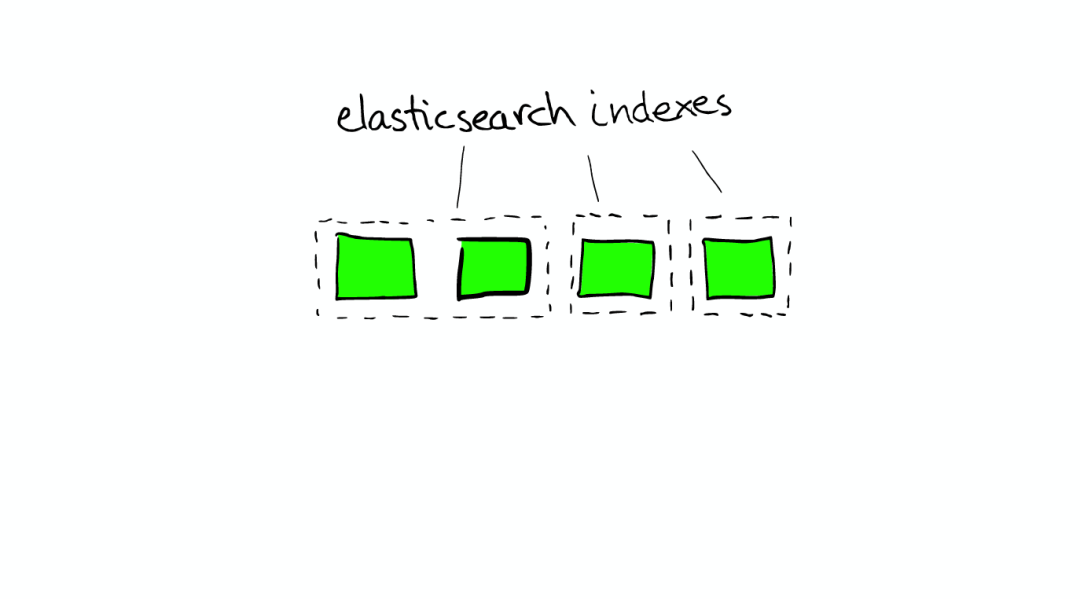
对于日志文件的处理
要搜索某天产生的日志,最好按时间戳对日志进行分块、建索引。这样既大幅提升搜索效率,删除旧数据也只需要删除对应索引。
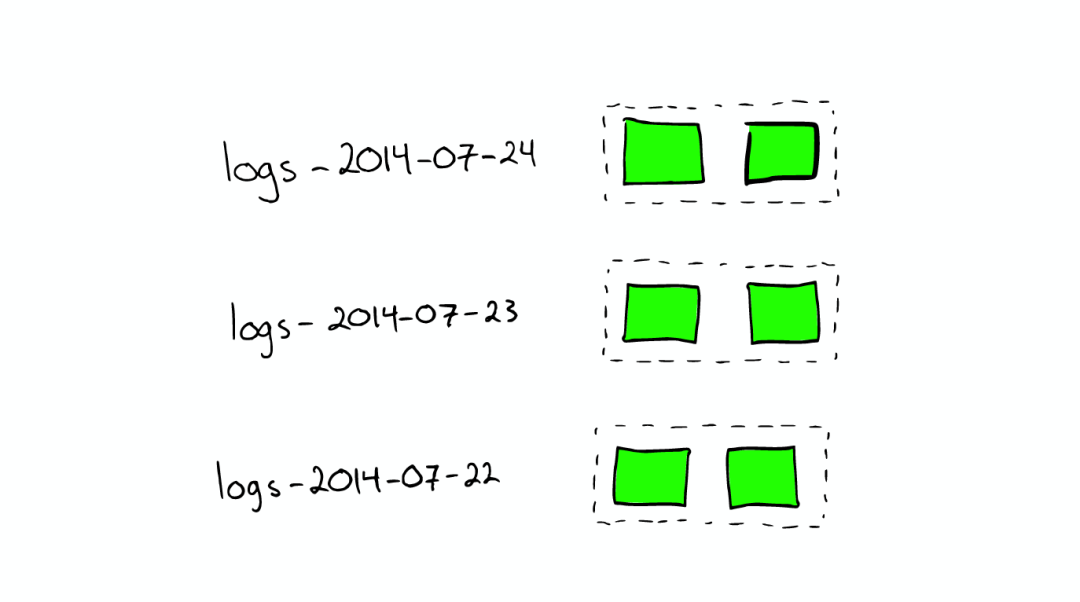
上面这个例子中,每个 index 有两个 shards。
如何 Scale
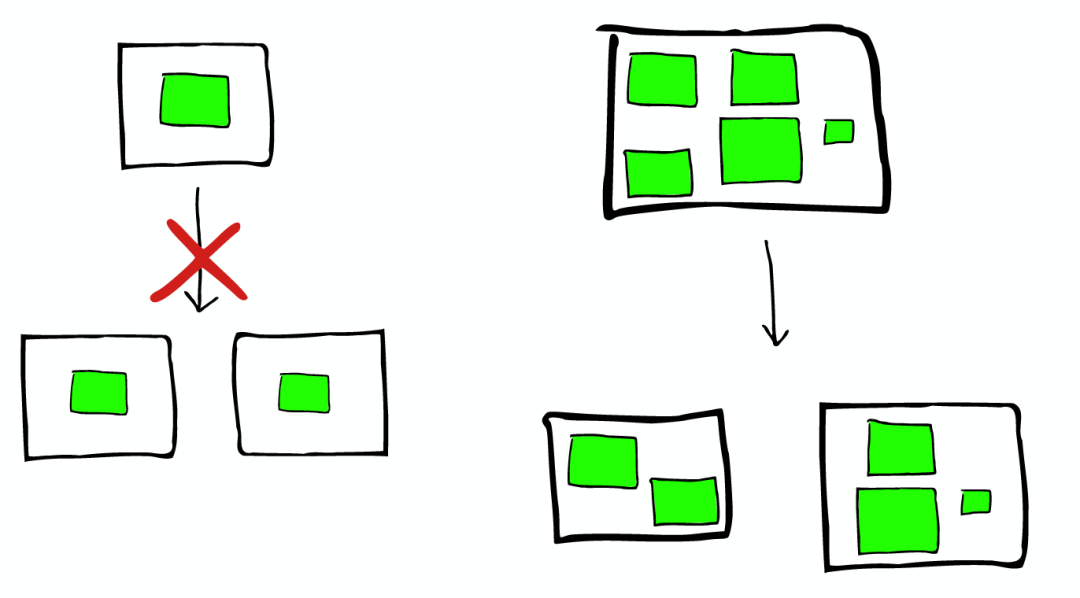
Shard 不会再被进一步拆分,但可以在节点之间迁移。所以当集群节点压力增大时,我们可以考虑引入新节点。但这通常要求对所有数据重新索引——这是没人喜欢的大动作。因此在刚开始设计时,就应该在“节点数量”与“未来扩容”之间做好权衡。
节点分配与 Shard 优化
- 对承载更重要数据的节点,分配更好的机器。
- 确保每个 Shard 都有副本(replica)。
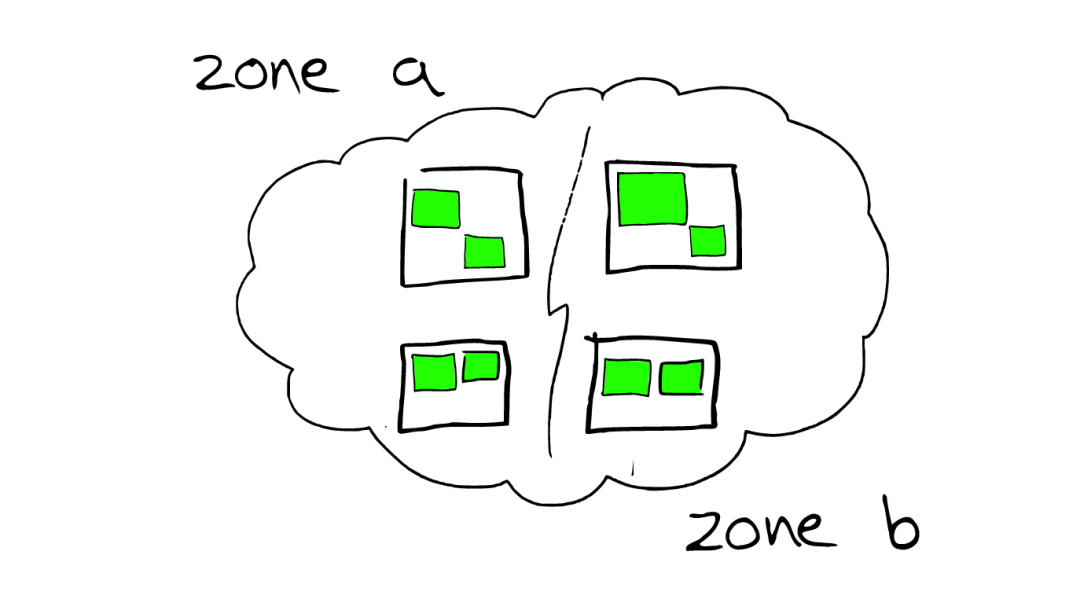
路由 Routing
每个节点都保存一份路由表。无论请求打到哪个节点,ElasticSearch 都能根据路由表把它转发到正确分片所在的节点去处理。
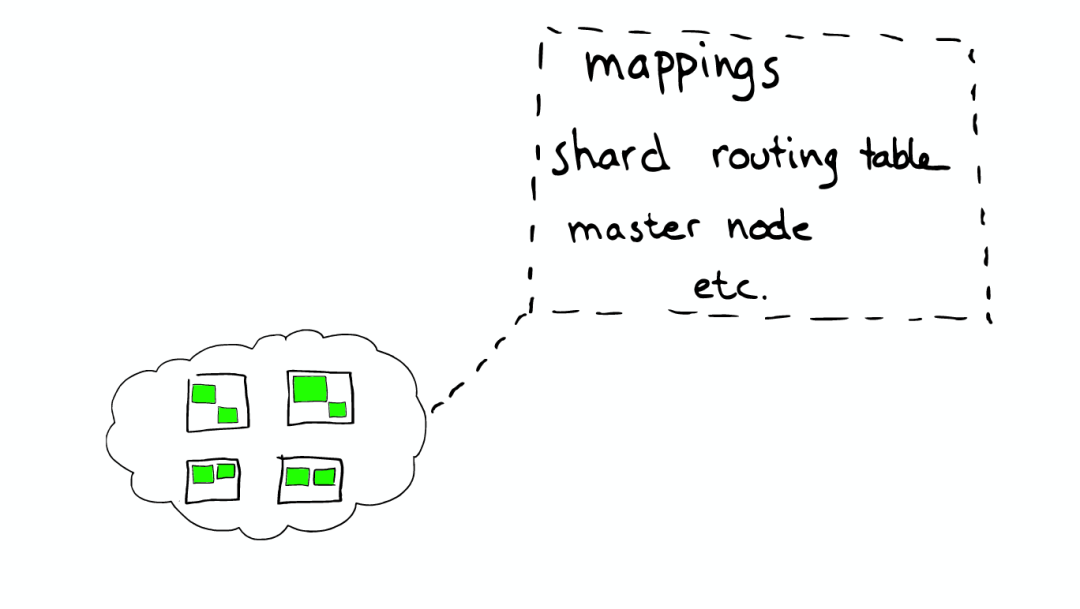
一个真实的请求
下面看一次真实查询请求的完整示例。
Query
Query 的类型是 filtered,请求里同时带了一个 multi_match 的查询。
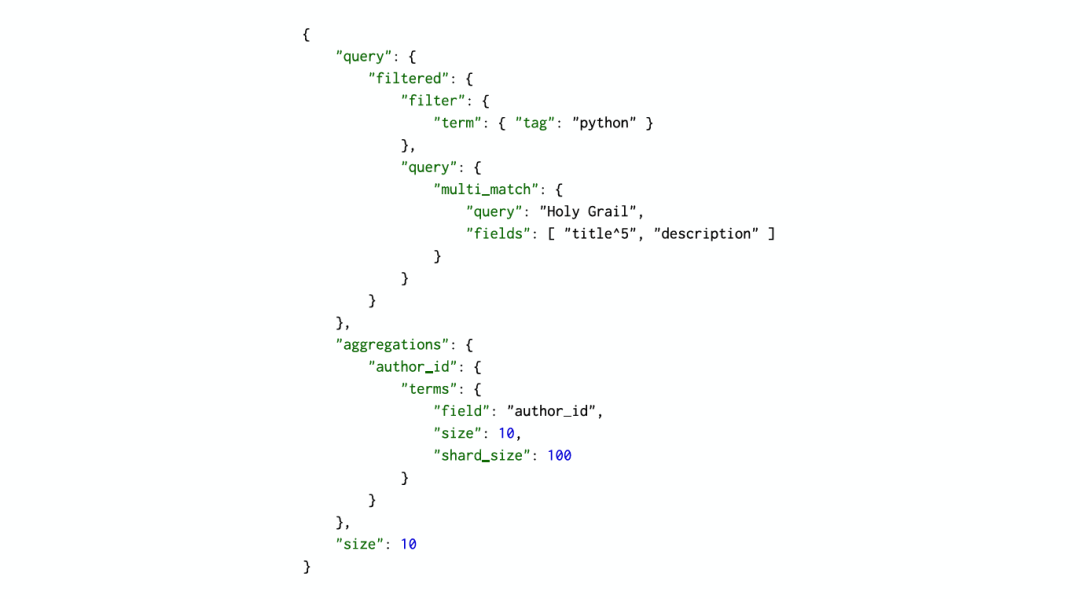
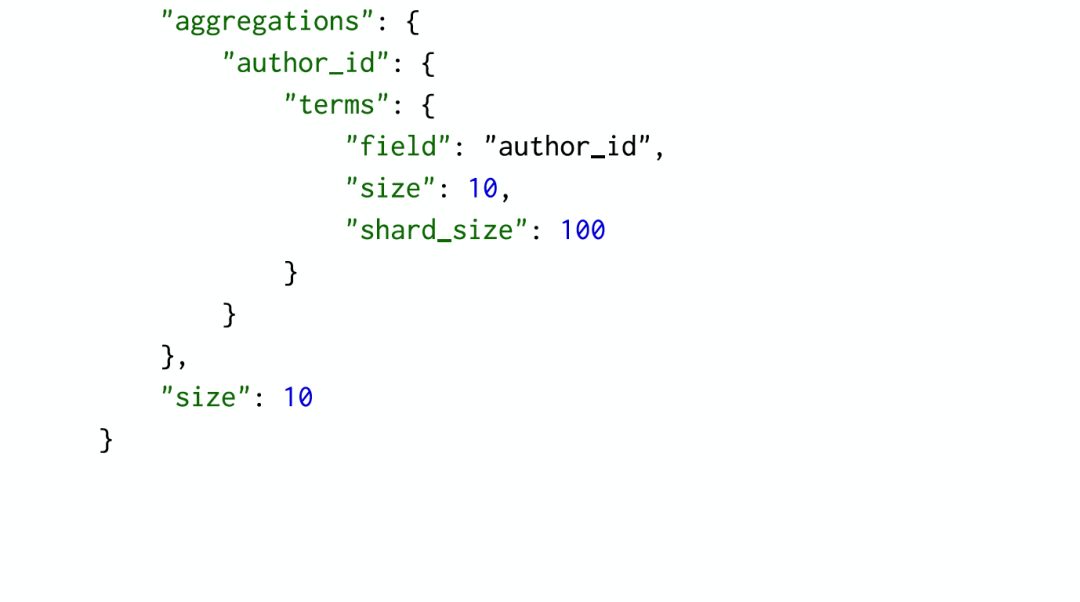
Aggregation
按作者进行聚合,拿到 top10 hits 的作者信息。
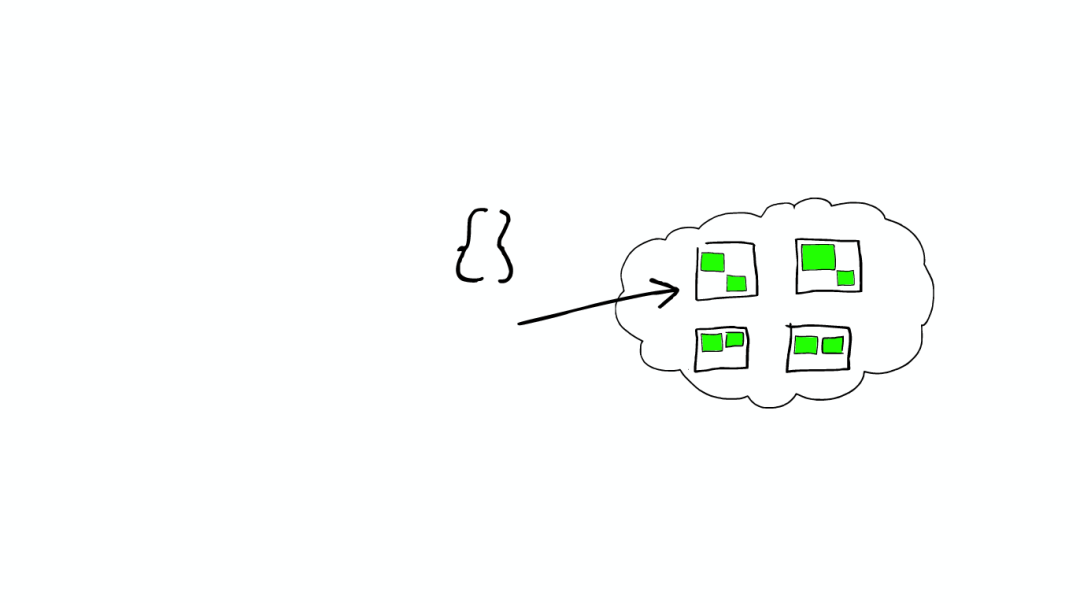
请求分发
这个请求可能落到集群里的任意一个节点。
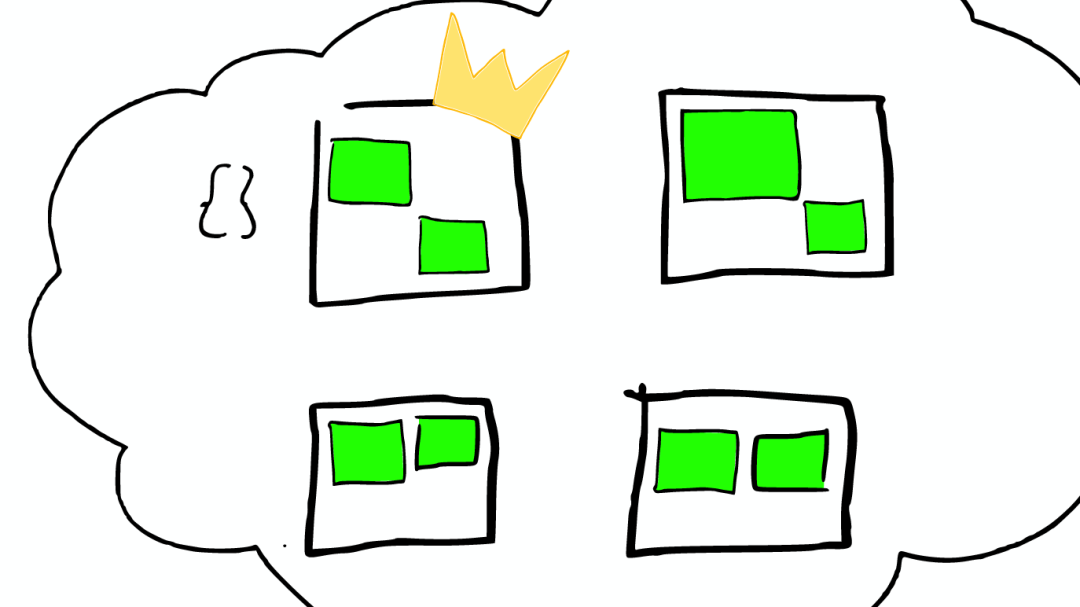
上帝节点
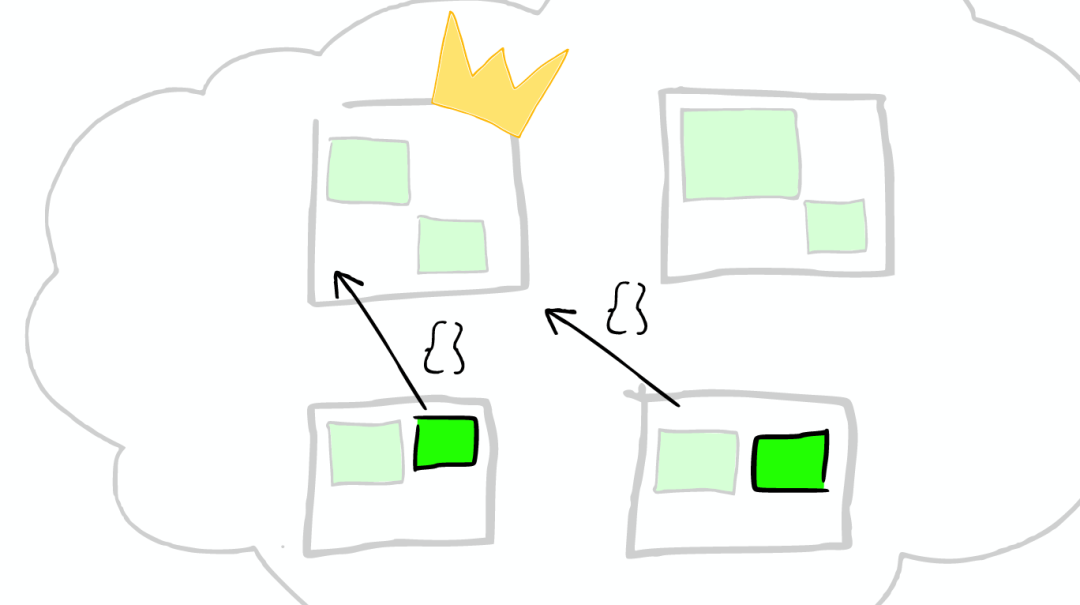
接收到请求的节点会晋升为这次请求的协调者(Coordinator),它需要决定:
- 根据索引信息,请求会被路由到哪个核心节点。
- 哪个副本可用。
- 以及其他协调事务。
路由
协调者根据请求内容完成路由。
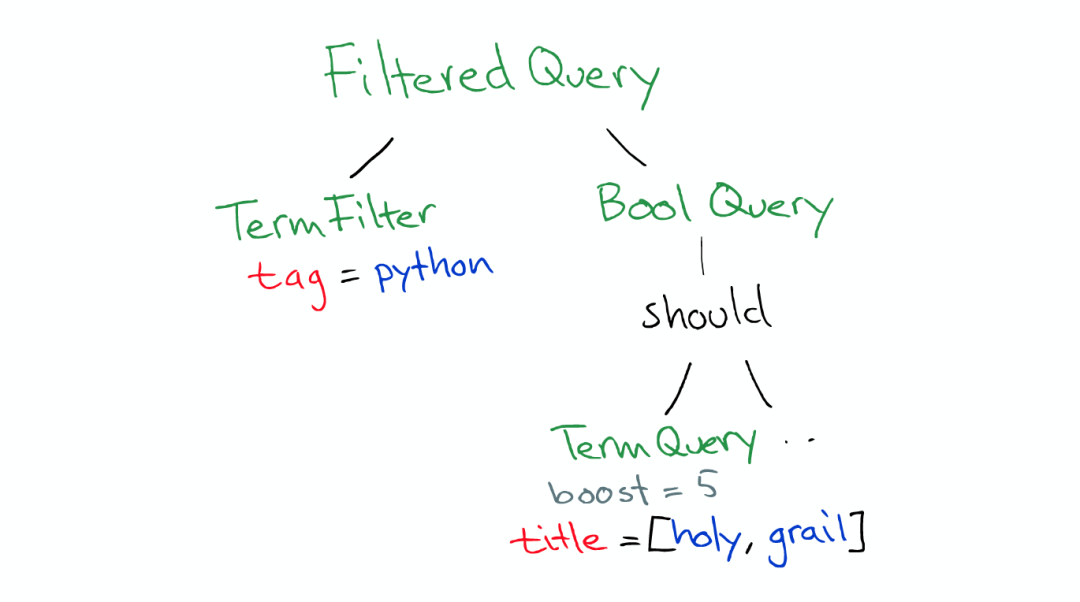
在真实搜索之前
ElasticSearch 会先把 Query 转换成 Lucene Query。
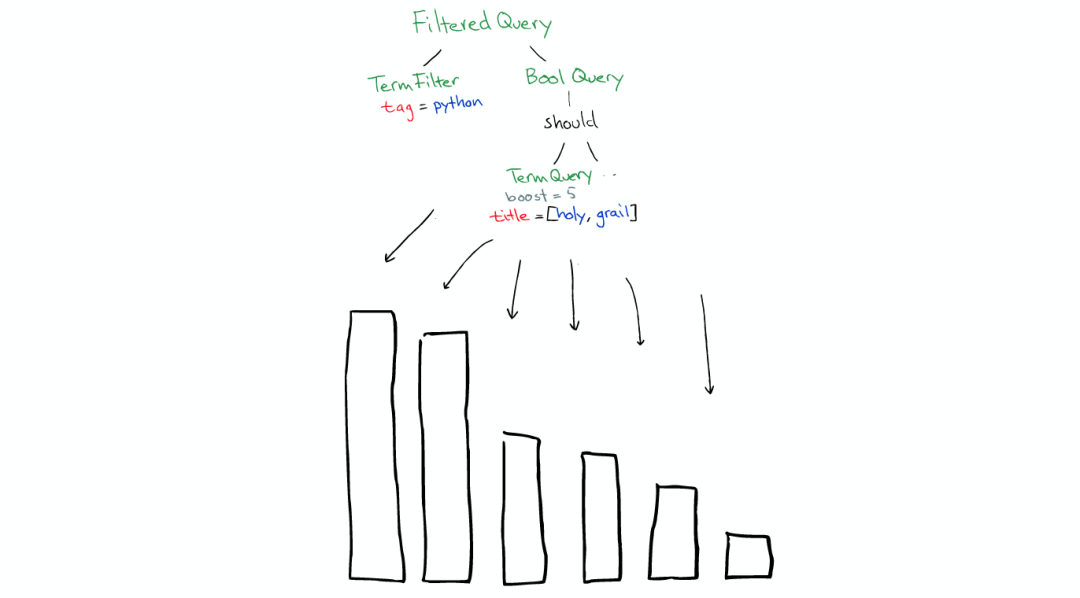
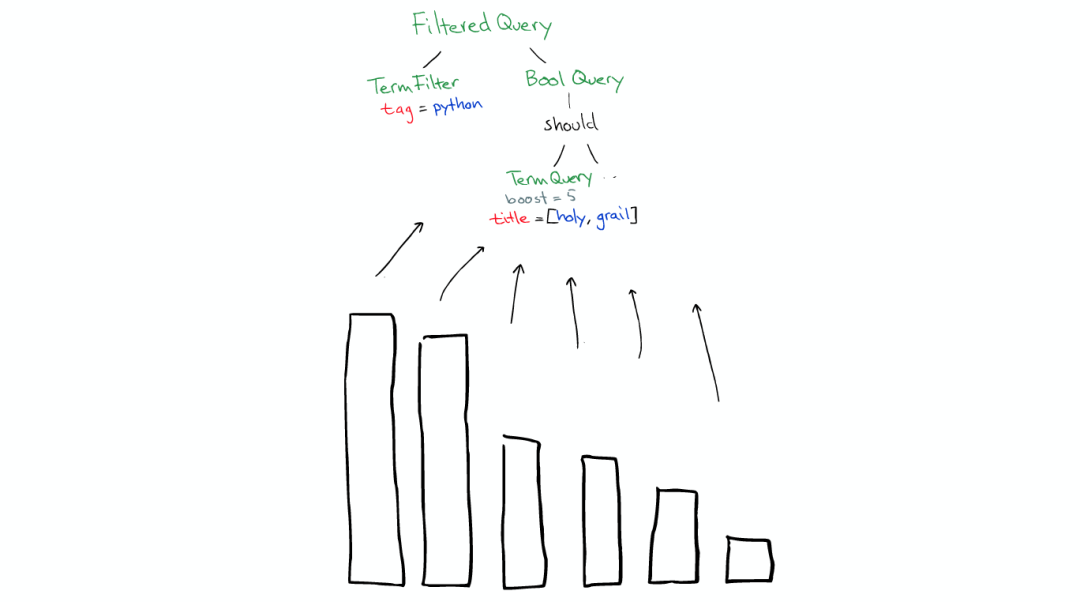
然后这份 Lucene Query 会在所有 segment 上执行计算。
Filter 条件本身也有缓存。
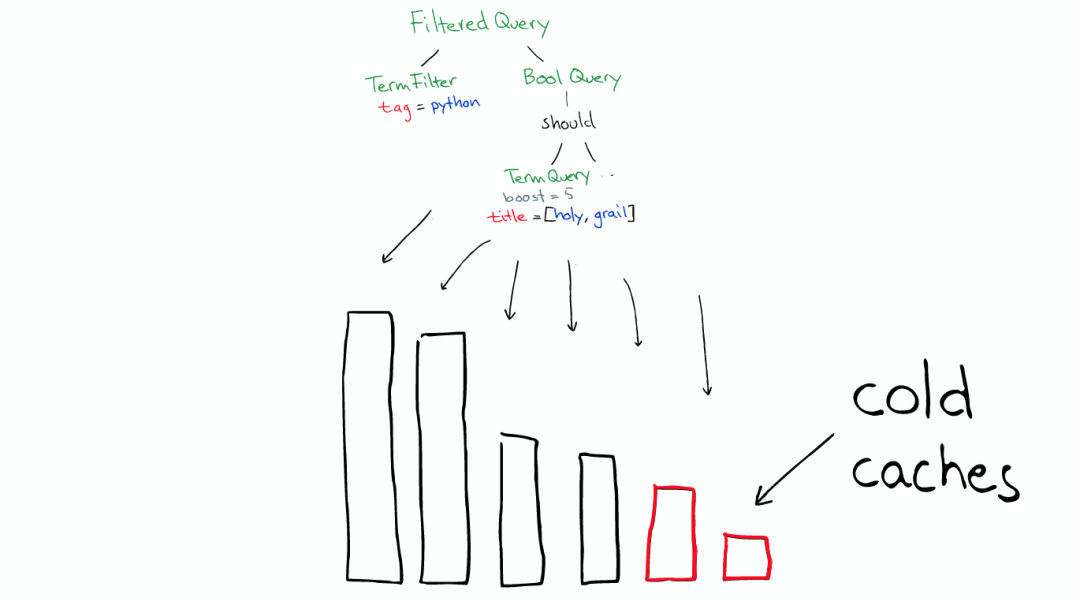
不过 query 不会被缓存。重复执行相同 Query 时,如果在意性能,应用自己需要做缓存。
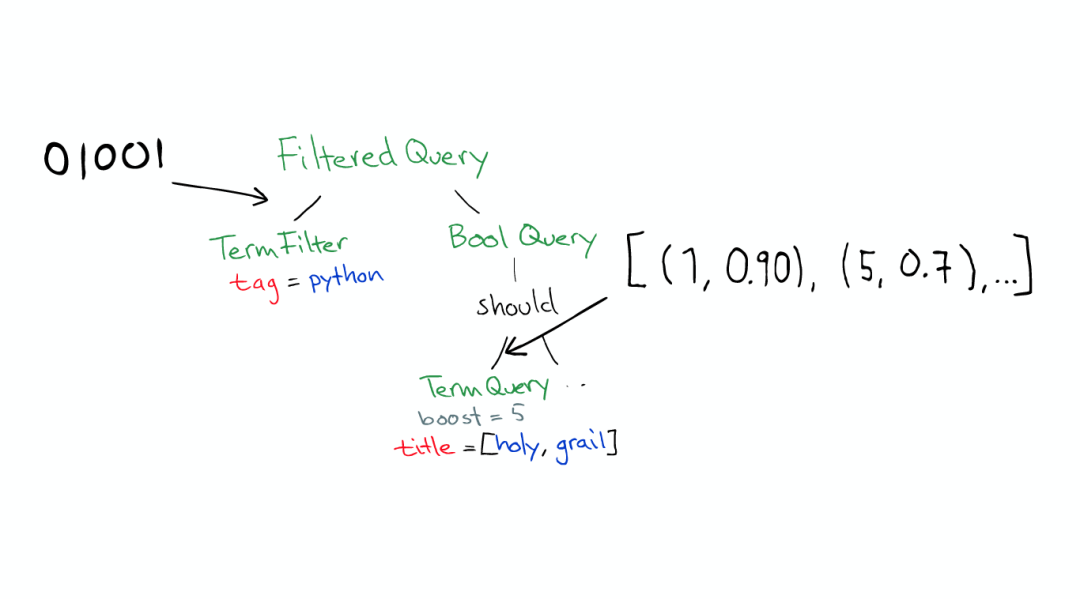
因此可以总结一条实用原则:
- filters 在任何时候都可以用。
- query 只有在需要 score 的时候才用。
返回
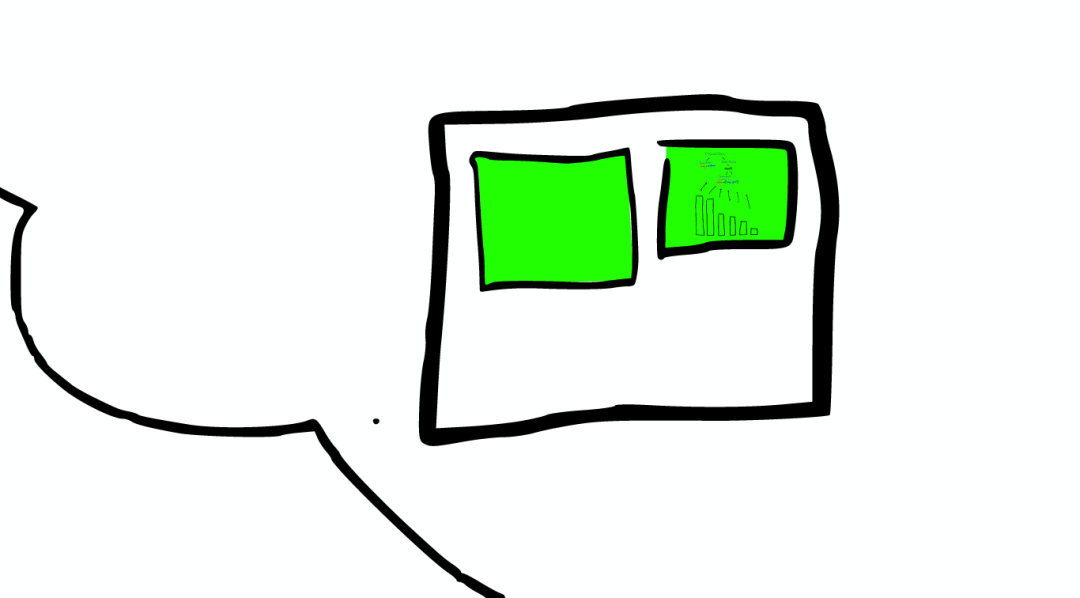
搜索结束后,结果会沿原路径逐层向上返回。
参考来源:www.cnblogs.com/richaaaard/p/5226334.html
如果你在 ElasticSearch 或其他中间件的学习与实践中遇到了棘手问题,欢迎来 云栈社区 和开发者们一起交流排查。
 发表于 2026-10-2 22:59:52
|
查看: 137|
回复: 0
 /1


