KeyDB 是从 Redis fork 出来的分支项目。众所周知,Redis 是单线程的 KV 内存存储系统,而 KeyDB 在 100% 兼容 Redis API 的前提下,将底层模型改造成多线程架构。
在云栈社区,常有同学讨论 Redis 遇到性能瓶颈时的替代路线,KeyDB 就是一个值得细看的选项。本文会围绕它的线程模型、链接管理、锁机制以及 Active-Replica 特性逐一展开。
项目地址:https://github.com/EQ-Alpha/KeyDB
线程模型
KeyDB 将 Redis 原来的主线程拆成了主线程和 worker 线程。每个 worker 线程本质上都是 IO 线程,负责监听端口、accept 请求、读取数据以及解析协议,如下图所示:
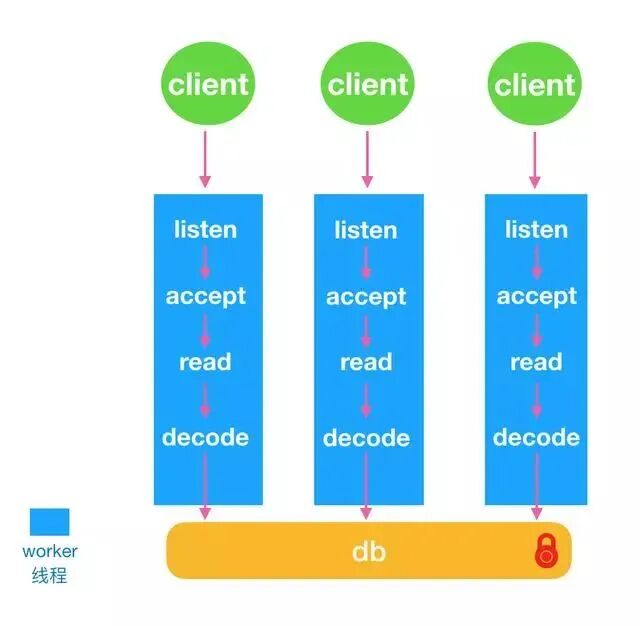
KeyDB 使用了 SO_REUSEPORT 特性,多个线程可以绑定监听同一个端口。每个 worker 线程都做了 CPU 绑核,读取数据时同样借助 SO_INCOMING_CPU 特性,指定 CPU 来接收数据。
解析协议之后,每个线程都会去操作内存中的数据,通过一把全局锁来控制多线程对内存数据的并发访问。
主线程其实也是一个 worker 线程,除了包含 worker 线程的工作内容之外,还承担了只有主线程才能完成的任务。在 worker 线程数组中,下标为 0 的就是主线程。主线程的核心工作是实现 serverCron,主要包括:
- 处理统计
- 客户端链接管理
- DB 数据的 resize 和 reshard
- 处理 AOF
- Replication 主备同步
- Cluster 模式下的任务
链接管理
在 Redis 中,所有链接管理都集中在一个线程中完成。而 KeyDB 的设计里,每个 worker 线程负责一组链接,所有链接都插入到本线程的链接列表中统一维护。链接的产生、工作、销毁必须发生在同一个线程中。为此,每个链接新增了一个字段:
int iel; /* the event loop index we're registered with */
用来标识该链接由哪个线程接管。
KeyDB 维护了三个关键的数据结构来管理链接:
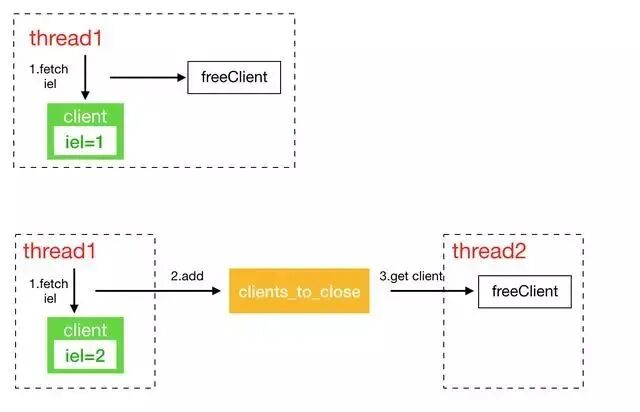
clients_pending_write:线程专属的链表,维护同步给客户端发送数据的队列clients_pending_asyncwrite:线程专属的链表,维护异步给客户端发送数据的队列clients_to_close:全局链表,维护需要异步关闭的客户端链接
为什么同步和异步要拆成两个队列?主要是因为 Redis 存在一些联动 API,比如 pub/sub。pub 之后需要给 sub 的客户端推送消息,但 pub 执行的线程和 sub 客户端所在的线程很可能不是同一个。为了应对这种跨线程场景,KeyDB 把需要发给非本线程客户端的数据放到了异步队列中。
同步发送的逻辑相对简单,全部在本线程内完成。下面这张图说明了向客户端同步发送数据的完整流程:
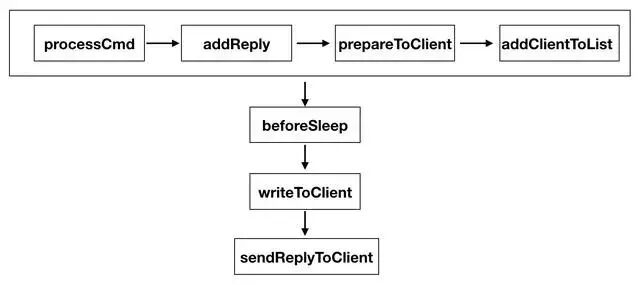
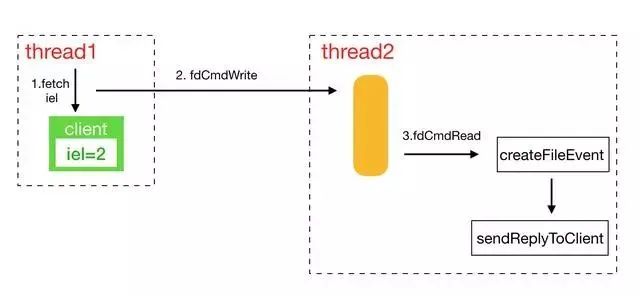
正如前面所说,一个链接的创建、接收数据、发送数据、释放链接都必须在同一个线程内执行。异步发送则涉及两个线程之间的交互,KeyDB 通过管道在两个线程之间传递消息。
当本地线程需要异步发送数据时,会先检查 client 是否属于本地线程;如果不在本地,就获取 client 专属的线程 ID,然后向对应线程的管道发送 AE_ASYNC_OP::CreateFileEvent 操作,要求添加写 socket 事件。专属线程在处理管道消息时,会把对应的请求挂到写事件中,如下图所示:
Redis 中有些关闭客户端的请求并非完全在链接所在线程执行,所以这里还维护了一个全局的异步关闭链表:
锁机制
KeyDB 实现了一套类似 spinlock 的锁机制,称之为 fastlock。
fastlock 的主要数据结构如下:
int fdCmdWrite; //写管道
int fdCmdRead; //读管道
它使用原子操作 __atomic_load_2、__atomic_fetch_add、__atomic_compare_exchange,通过比较 m_active 与 m_avail 来判断能否获取锁。
fastlock 提供了两种获取锁的方式:
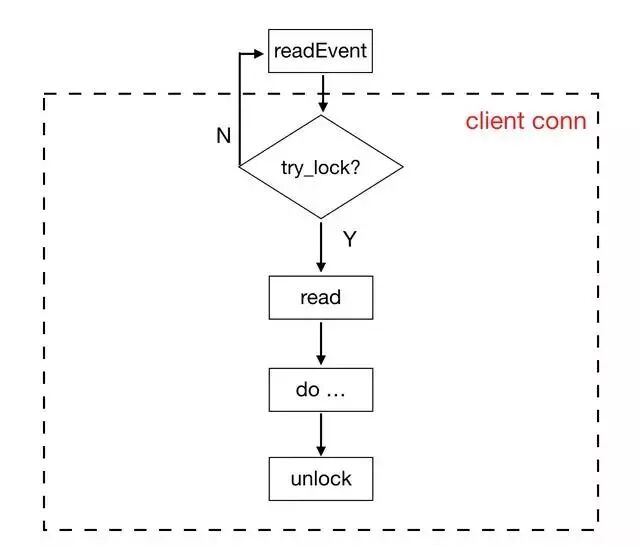
try_lock:一次获取失败就直接返回lock:忙等,每 1024 * 1024 次忙等之后调用 sched_yield 主动让出 CPU,挪到当前 CPU 任务队列末尾等待执行
KeyDB 将 try_lock 和事件机制结合起来,从而避免忙等消耗。每个客户端都有一个专属的 lock,在读取客户端数据之前会先尝试加锁;如果失败就退出。因为数据还没被读取,下个 epoll_wait 处理事件循环时可以再次尝试,逻辑如下图所示:
Active-Replica
KeyDB 实现了多活机制:每个 replica 都可以设置成可写(非只读),replica 之间互相同步数据。主要特性包括:
- 每个 replica 有一个 uuid 标志,用来去除环形复制
- 新增 rreplay API,将增量命令打包成 rreplay 命令并带上本地的 uuid
- key 和 value 加上时间戳版本号作为冲突校验:如果本地已有的 key 时间戳版本号大于同步过来的数据,则新写入失败。时间戳版本号的生成方式是——当前时间戳向左移 20 位,再加上后 44 位的自增值
 发表于 昨天 22:55
|
查看: 2|
回复: 0


