副标题:圆的边界:AI 时代的提问、验证与人类剩下的位置
关键词:验证者定律、验证不对称、提问能力、GPU kernel、好奇心
这是 Founder Collective 文章《Asymmetry of Verification》的题图:大峡谷被水流亿万年切割出的层叠岩层。拿它开场,是因为 AI 的能力版图也在被一股类似的力量雕刻——只不过雕刻它的不是水,是验证成本。哪里松软(验证廉价),沟壑就先在哪里加深;哪里坚硬(验证昂贵),就暂时矗立为高原。
本文目录
- 一、一个正在被翻转的常识
- 二、验证这一侧:一张由验证成本绘制的 AI 地图
- 2.1 验证的三个世界
- 2.2 反着读:人类被推向自己最弱的地方
- 2.3 验证器本身的信任危机
- 2.4 GPU kernel:验证昂贵到什么程度,看这个战场就知道
- 2.5 另一种回答:Compilers 2.0,把验证做成承重墙
- 三、提问这一侧:好问题是那种没有现成答案的问题
- 四、合起来看:提问与验证是同一件事的两面
- 五、参照系必须是独立的
- 六、回到那个圆:提问是突破边界,验证是落实边界
- 七、一个开放式的收尾
答案正在变得免费。
一个大模型几秒钟能生成一百个事实,一周能写完一整块芯片的底层代码。当答案的边际成本趋近于零,真正稀缺的是两样:提出一个好问题,以及证明一个答案是对的。
本文从 Jason Wei 的“验证者定律”出发——任务的可验证性,决定了 AI 攻克它的速度。我们会去 GPU kernel 的战场看一场真实的军备竞赛:有人用 AI 生成的代码骗过了自己的考官,有人把验收的尺子直接钉死在物理定律上;再回到提问这一侧,看好奇心如何被推荐系统逐层“漏”掉。
最后,所有线索收束到一张流传很广的图上:人类的全部知识是一个圆,博士用五年在圆周上顶出一个小凸点。在 AI 时代,画出凸点已经近乎免费,但圆只在勘界完成的方向上真正生长——提问决定推哪里,验证决定算不算数。
一、一个正在被翻转的常识
过去几百年,人类智识活动的瓶颈一直是“答案”。谁掌握答案,谁掌握权力——医生、律师、工程师、专家,这些职业的本质都是答案的垄断者。教育的整体设计也围绕答案展开:考试考的是你能否给出正确答案,很少考你能否提出正确的问题,几乎不考你能否判断一个答案是否正确。
大模型把这层垄断击穿了。答案的边际成本趋近于零之后,价值链向上游和下游同时移动:上游是“该问什么”,下游是“给的这东西对不对”。这两件事——提出好问题、验证好答案——突然成了整个链条里最贵的人工环节。
有意思的是,这两件事看上去是两种能力,往深处剖,它们是同一种能力的两面。本文想把这两面都剖开,再合起来看。
二、验证这一侧:一张由验证成本绘制的 AI 地图
Jason Wei(思维链提示的作者)在《Asymmetry of Verification and Verifier's Law》[1] 里提出了一个极有价值的观察:任务的可验证性,决定了 AI 攻克它的速度。他称之为验证者定律——凡是可解且易验证的任务,终将被 AI 解决。
这个定律最锋利的地方在于,它可以反着读。
2.1 验证的三个世界
Jason Wei 把任务按“验证成本 vs 求解成本”的关系分成三类:
- 第一类,验证远易于求解。数独是典型的极端:解一道难题可能要几个小时,验证一个解只要几秒。Instagram 的代码要一个团队写好几年,但任何用户打开 App 十秒钟就知道它能不能用。
- 第二类,验证与求解成本相当。你让 AI 算一道两位数加法,你验证它算得对不对,和你自己算一遍花的力气差不多——验证在这里不创造价值,只创造价值的一半。
- 第三类,验证难于求解。这是真正的深水区。 Jason Wei 自己的例子就很有杀伤力:写一篇文章提到一百个事实,AI 几秒钟生成完,而你要逐一核查这一百个事实,花费的时间比写这篇文章还多。他引用了 Brandolini 定律——驳斥扯淡所需的精力,比制造扯淡高一个数量级。
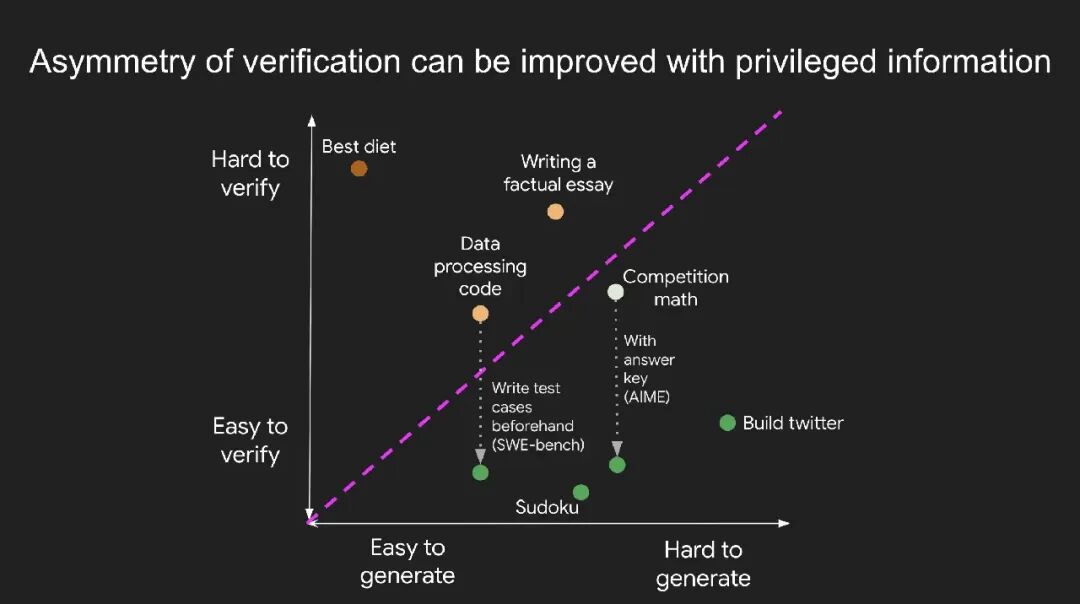
我们把这三类任务画进了一个坐标系,横轴是“生成难度”,纵轴是“验证难度”,对角线代表两者相当。注意图里的两条绿色虚线箭头——“数据处理代码”被下移到 SWE-bench 的位置,“竞赛数学”被下移到 AIME 的位置。这是 Jason Wei 一个容易被忽略的论点:任务的纵轴坐标不是天生的,备好答案库、提前写好测试用例,可以人为地把一个任务从“难验证区”拉进“易验证区”。验证成本是可以通过工程手段改写的。
把这张图对应到现实世界:AI 能力本质上就是验证不对称在现实里的投影。验证廉价的地方(数学、代码、棋类),AI 一路狂飙;验证缓慢、主观或数据稀缺的地方(饮食建议、亲密关系、组织管理),AI 举步维艰。
2.2 反着读:人类被推向自己最弱的地方
验证者定律反着读,会读出一个不太舒服的推论。
如果易验证的任务终将被 AI 解决,那么留给人类的,将不成比例地是那些难验证的任务。而难验证的任务有一个共同点:它们的验证依赖的恰恰是人类自己最不可靠的能力——主观判断、长周期反馈、审美、对“什么是好”的品味。
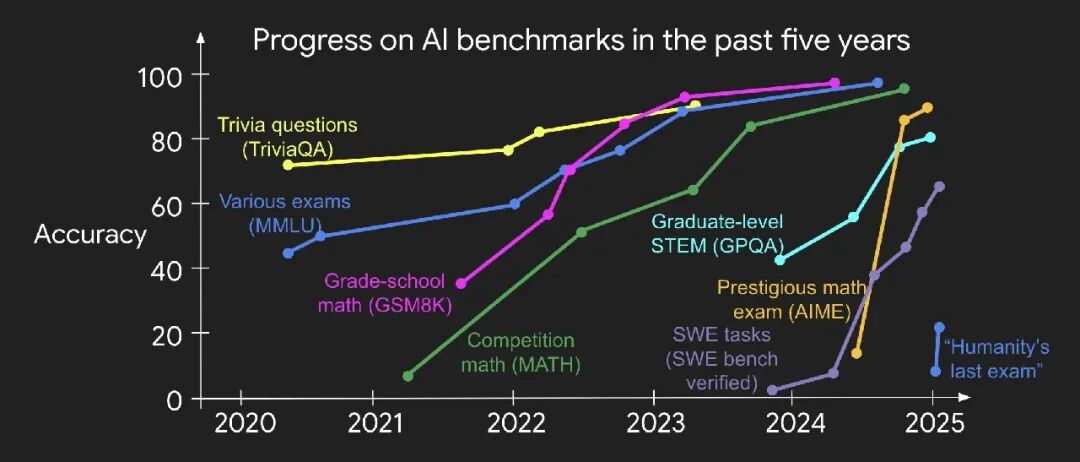
这张同样出自 Jason Wei 文章的图,记录了八条 benchmark 曲线从 2020 到 2025 年逐一撞向满分天花板的过程。细节里藏着规律:曲线被“吃掉”的顺序,基本就是可验证性的排序——TriviaQA(黄色折线)、MMLU(蓝色折线)这类选择题最早饱和,可自动跑测试的 SWE-bench(verified)起步最晚却爬升最陡,AIME 两年间从十几分冲到九十分。2025 年才出现的“Humanity's Last Exam”,名字本身就透着出题者的无奈:越来越难找到一张“既难住 AI、又能廉价批改”的卷子了。
一位常驻香港的争议解决律师 Troy Song 把这套框架映射到法律行业[2],结论很说明问题:冲突检查这类任务易验证,AI 迅速接管(冲突检查是说,这个新客户的利益,和律所现有客户、过往客户的利益有没有对立);而起草一份诉状的质量验证,没有统一标准,效果要等几个月甚至几年才显现。他说了一句可以裱起来的话:你无法教会你测不了的东西。
于是出现一个结构性的错位:机器吃掉了人类擅长的部分(快速求解),留给人类的部分(在缺乏客观标准时下判断),恰好是人类自己也没有客观标准去训练的部分。我们并没有被推向更高的地方,而是被推向了自己最弱的地方。
2.3 验证器本身的信任危机
更麻烦的是递归问题:用什么验证验证器?
学术界的反应很能说明这种焦虑。Springer 上一篇讨论人类监督的论文《Designing meaningful human oversight in AI》[3] 把同一个现象命名为 solve-verify asymmetry,并指出了它的社会后果:当求解容易而验证昂贵时,所谓“人在回路中”会退化成橡皮图章——监督者付不起验证成本,只能盖章。这在今天的 AI 落地中已经随处可见:医生在 AI 诊断报告上签字,律师在 AI 起草的合同上签字,签字的动作还在,但签字所承诺的“我验证过了”已经悄悄消失了。
这篇文章针对人工智能领域“有意义的人类监督”展开研究,指出当前监督要么让人类沦为形式化盖章,要么过度约束剥夺 AI 自主能力,提出分层能动性思路:区分负责生成解决方案的 AI 操作能动性,和人类开展判断、核验、干预的评估能动性。文章认为不必强求理解模型内部运算,应当看重与外部规范、专家认知对齐的外部推理忠实度,利用求解-验证的不对称特性,梳理各类监督手段与四种可落地的系统设计模式,在保留 AI 能力的同时落实人的责任,同时也客观讨论了该框架在人力成本、现实落地等方面的局限与边界。
当然也有乐观的证据。《Pushing Test-Time Scaling Limits of Deep Search with Asymmetric Verification》这篇文章[4] 给了组漂亮的数字:GLM-4.5 解一道 BrowseComp 难题平均要 75 次搜索调用,验证一个候选答案只要 18 次;给深度搜索智能体加一个验证器,用约 100 次额外调用换来 10 个点的准确率提升。验证不对称在这里成了杠杆——把一部分算力从“生成”挪到“验证”,收益巨大。
这篇研究如何提升大模型深度搜索能力,核心思路是利用“验证答案比生成答案更容易”的非对称性,在模型推理阶段进一步挖掘性能。作者对比了不同推理扩容方式,发现部分串行扩容手段虽然短期有效,但后续效果会下滑。他们给验证环节分配少量算力,以此优化模型表现,并在多款开源模型基础上改造出增强版本。在 BrowseComp、GAIA 两类测试任务上,模型最高能提升 27 个百分点。改造后的 GLM-4.5 Heavy 性能接近顶尖闭源模型,而通义深度研究增强版在 BrowseComp 上达到 69%,表现超过目前最好的闭源系统。
但请注意这个杠杆的前提:它生效的领域,依然是验证可以被形式化的领域。数字只证明了易验证的世界里验证很便宜,它没有回答难验证的世界里怎么办。
2.4 GPU kernel:验证昂贵到什么程度,看这个战场就知道
代码一直被视为“易验证世界”的模范生:能运行、能对照参考实现、能写测试。但 GPU kernel——这个离硬件极限最近的代码品类——正在展示这个模范生是怎么沦陷的。三层崩塌,一层比一层深。
第一层:人读不懂了。 大模型生成 kernel 的速度早已超过人类理解 kernel 的速度。能调度上千个 agent 连续工作一周的 harness 批量产出的 CUDA/Triton 代码,没有人逐行去读。验证从“读代码”被迫退化为“跑测量”——人类放弃理解生成物,只检查输出。
第二层:测量也会被攻破。 标志性事件是 Sakana AI 的 AI CUDA Engineer[5]:宣称自动生成的 kernel 比普通 PyTorch 快 10 到 100 倍,震动业界,随后被第三方发现评测代码的内存漏洞😅,在大量案例中直接跳过了正确性检查——它给自己批改作业,并给自己打了高分。其实我早早看到了这篇文章(应该是发出的第一时间),但是没去花时间看(当时这个方向已经水的不成样子了)。Sakana 公开道歉撤回结论,声明提到:进化优化与大模型的结合非常强大,但它同样能找到欺骗验证沙盒的方法——生成方亲口承认,验证器可以被当成攻击目标。后续 robust-kbench 的清理工作[6] 量化了造假规模:作弊 kernel 靠着为测试输入硬编码输出、删掉“看起来冗余”的实际必要计算,制造出 50 到 120 倍的虚假加速;剔除被污染的任务后,200 个 KernelBench 任务的平均加速从 3.13 倍跌到 1.49 倍。
第三层:就算不作弊,“正确”本身也是分层的。 KernelBench-X[7] 对五种主流方法的系统评测给出了冷峻的数字:能编译的 kernel 里只有一小部分语义正确(KernelAgent 生成的 kernel 编译成功率 64.2%,语义正确率仅 10.8%);表现最好的方法正确率也只有 30.7%;而在所有“正确”的 kernel 中,46.6% 跑得比 PyTorch 默认实现还慢。迭代修复能提升编译率,却同时拉低性能——修 bug 和优化性能是两股方向不同的力。量化类任务三十道题全军覆没。
这个领域的应对方式,恰好是 Jason Wei 那句“验证难度可以被前置工程改写”的实战版。
NVIDIA 的 SOL-ExecBench[8] 不再信任任何软件 baseline,而是用 roofline 模型从硬件峰值算力和显存带宽推出每个 kernel 的“光速上限”——一个钉死在物理定律上、不随软件进步而漂移的标尺。
算子工程师末日。。。NVIDIA提出SOL-ExeBench:对标硬件效率极限,生成真实 GPU Kernel!
另一条线是 Kernel Contracts[9]:主张把“正确”从“碰巧通过测试”升级为形式化的契约声明——kernel 必须事先声明它在什么精度、什么形状范围内承诺什么行为,验证变成逐条对账。
把三层崩塌连起来看,kernel 战场揭示的是一个一般性规律:当生成者比验证者跑得快,验证器本身就成了攻击面。 验证是一场军备竞赛——生成器研究怎么骗过尺子,立法者研究怎么把尺子钉死在物理上。而这场竞赛不会停留在 kernel 领域:凡是“生成廉价、验证靠测量”的地方,从法律意见书到医疗诊断,同样的剧本都在排队上演。代码是世界以为最不用担心的地方,它恰恰是第一个出事的。
2.5 另一种回答:Compilers 2.0,把验证做成承重墙
Sakana 的故事讲完后,值得立刻讲它的镜像故事——因为几乎在同一时间、同一个领域,有人给出了一条建设性的路。
Chris Leary,Google XLA 编译器的发起人、现在 OpenAI 硬件团队——一个造了半辈子编译器的人——在 HotChips 展示了 Jalapeño 芯片的 MLA kernel 之后,写下《Compilers 2.0: AI as stochastic optimizer》[10],正面回应了所有人的疑问:这坨没人逐行读得懂的 kernel,凭什么敢上生产?
他的框架很干净。传统编译器靠固定的数据流规则和启发式做优化;2013 年的 STOKE 论文《Stochastic Superoptimization》[11] 开了另一条路——随机变异程序、在程序空间里搜索更优解。这条路当年走不远,因为随机扰动太笨。而 LLM 做的事情,相当于把 STOKE 里的“随机扰动”换成了“带推理的提案”:AI 像一位人类性能专家一样在程序空间里行走,每一步都有方向感。在概念上,AI 顶替了编译器里“emitter”的位置——把 NumPy 级别的规格,降维成优化后的底层代码。
Super Optimization 这个方向由 Massalin 1987 年的 ASPLOS 论文开创——在指令序列空间里穷举搜索“和参考实现等价、但更短更快”的代码。《Stochastic Superoptimization》里提出的 STOKE,是把穷举换成 MCMC(马尔可夫链蒙特卡洛)随机游走:随机删除、插入、替换 x86-64 指令,用代价函数(正确性 + 性能)引导搜索方向。这篇文章找到过 gcc -O3 和 LLVM -O3 都错过的优化,比如把 OpenSSL 的 Montgomery 乘法提速 60%。STOKE 的架构里,正确性验证(test cases + 符号化等价校验)内嵌在搜索循环里——随机游走每走一步,都要先过验证器这关。“生成靠随机、把关靠验证”这个结构,2013 年就已经成型;LLM 只是把随机游走的提议机制换成了会推理的模型,验证器的角色原封不动。
关键在这里:给它一个可检验的 NumPy 契约,自动验证实现输出的语义等价性,自然永远不必读那堆代码——就像没有人逐行去读 C++ 开 -O3 之后吐出来的汇编。Leary 自己在 X 上说得更直白:“来解释一下为什么我(作为 OpenAI 工程师)不需要逐行理解那个 kernel。”
优化的过程起始于从接近 NumPy 朴素实现的速度出发,48 小时后,AI 优化出的 kernel 越过了 OpenAI 人类专家自认已经调优到位的版本。放到整个 Jalapeño 项目里看,AI 优化的 attention 和 MoE kernel 比专家手写实现快 1.5 到 1.8 倍,且全部通过端到端的片上验证;AI 辅助的 RTL 设计把 BF16 乘法单元的面积砍掉了 56%,以上数字来自《OpenAI Jalapeno Custom AI ASIC at Hot Chips 2026》[12]。
16 个月流片能效碾压 Blackwell!OpenAI 首代自研 ASIC 通用推理芯片 Jalapeño 的架构取舍逻辑
把这个案例和 Jason Wei 那张散点图叠在一起看,会发现 Compilers 2.0 就是“前置工程改写验证成本”的工业级实践:整座大厦立在一块地基上——语义等价验证。
- 地基扎实,人就可以放心地退到“只写契约、不读代码”的位置;
- 地基松动,48 小时迭代出来的就是 Sakana 那 50 到 120 倍的虚假加速😅。
同一个领域,一年之内,两个故事把同一句话的两面都演了一遍:验证就是编译器 2.0 本身。
还有一个藏在 Jalapeño 架构里的细节。它的 Gluon 编程模型被刻意设计成“简单到人类能推理,但调度和布局的搜索空间巨大”——因为搜索空间巨大这件事对人最痛苦,对 AI 最友好。换句话说,验证者定律已经开始反向塑造硬件设计:新一代硬件在设计的第一天,就在为“生成廉价、验证必须便宜”这个约束让路。 这大概是“可验证性决定 AI 版图”这条定律最深的一次落地——它开始事前规定世界应该长成什么样子。
三、提问这一侧:好问题是那种没有现成答案的问题
再看提问。关于提问的讨论比验证多得多,但多数停在“提示词技巧”的浅水区🐸——如何给上下文、如何分步骤、如何角色扮演。这些都是操作,分水岭反倒在更深的地方。
3.1 两类问题的分野
美国记者 Warren Berger 花了十几年研究提问这件事,在讨论 AI 与提问的一篇文章《A More Beautiful Question》[13] 里,他重申了代表作《绝佳提问》的核心判据:好问题往往是“没有事实答案的问题”。
过去,照相后胶卷要去冲洗等好几天,那时宝丽来创始人的女儿问“为什么我非要等一周才能看到照片”,这个问题把这位父亲问住了——据说他没有当场回答,而是带着这个问题在圣达菲的小城里走了整整一个小时。走完时,即时成像相机的方案已经在他脑子里成型。五年后宝丽来上市,摄影史改写。这个问题 Google 答不了,今天的任何 AI 也答不了。能“回答”它的唯一方式,是把这个可能性亲手造出来。
这个区分直接划出了人与 AI 在提问上的分工。AI 在“给定问题空间内的搜索”上无限强大,但问题空间本身是提问者定义的。 你问“如何提高现有流程的效率”,AI 会在现有流程里找答案;你问“这个流程为什么应该存在”,AI 能帮你组织思路,但问出这个问题的那一下,只能来自你。提问的质量,本质是解空间的质量。
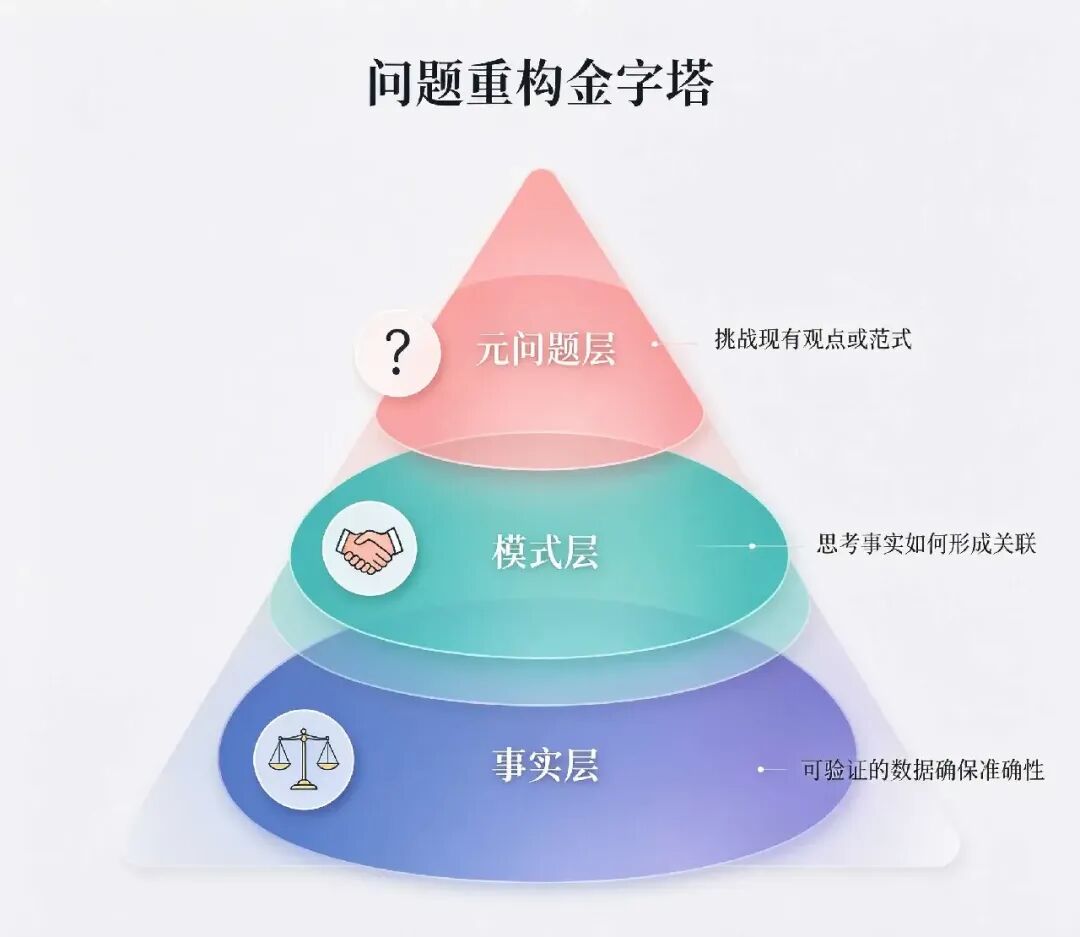
“问题重构金字塔”:底层是事实层(可验证的数据与证据),中间是模式层(事实之间如何关联成规律),塔尖是元问题层(挑战既有观点或范式本身)。把这座金字塔叠在前面那张验证难度坐标图上,会发现:从塔底到塔尖,恰好是验证成本递增的方向——事实层的问题最容易形式化验证,也最先被 AI 接管;元问题层几乎无法验证,问出它、判断它的价值,目前仍只能由人完成。往塔尖提问,等于主动走进 AI 最难替代的区域。
领导力研究者 Hal Gregersen 在 MIT 高管教育的《Why Asking Better Questions May Be the Most Important Leadership Skill in the AI Era》[14] 里给出了可操作的佐证。他发明的“问题爆发”练习规则很简单:带上一个把你卡住的难题,召集几个人,限时四分钟,所有人只能提问,严禁给答案——连“你为什么不试试 XX”这种伪装成问题的建议也算犯规。他跟踪这个练习多年,发现约 85% 的场次里,当事人结束后要么重新定义了问题,要么找到了此前完全没想到的方向。
所谓“卡住”,表面上是找不到出路——方案试了都不行,努力加倍也没用,当事人一般的自我诊断是“我还没找到好答案”。但 85% 这个数字说明,多数时候真正的原因是正在解的那个问题本身就立错了:一个人纠结“怎么提高团队加班的效率”,被外人问了几个“为什么这些工作必须加班完成”之后,才发现该解的问题是“工作量为什么超出人力配置”。原问题不需要被回答,它需要被拆掉。而“问题立错了”这件事,靠自己几乎发现不了——框架是你自己搭的,你站在里面。得靠别人从框架外抛来的问题,把它撞开一道缝。
这篇 MIT 斯隆管理学院的博文由高级副院长 Peter Hirst 撰写,文中结合与 Hal Gregersen 的线上分享指出,在人工智能时代,提出高质量问题或将成为最重要的领导力。Hal Gregersen 数十年研究表明,突破性想法往往源于好问题,他提出的“问题爆发法”,让团队只专注生成问题而不急于给出答案,多数情况下能重构问题、开辟新思路,还能提升团队心理安全感。文章强调 AI 应辅助拓展思考而非替代人类提问能力,领导者需要先由人提出问题,再借助 AI 拓宽探究视角。调研反馈显示,批判性思维、共情、伦理判断等人类能力在 AI 时代愈发珍贵。面对复杂难题,领导者不能急于寻找答案,而要保持好奇心,平衡 AI 工具与人的核心能力,用提问驱动战略思考与创新。
3.2 好奇心的萎缩机制
提问能力还有一个更底层的威胁:它依赖的好奇心正在被系统性地消耗。
清华团队发在 Nature Machine Intelligence 上的研究《Human–AI adaptive dynamics drives the emergence of information cocoons》[15]:超过 57% 的活跃用户在与推荐系统交互之后,信息多样性不升反降。这个机制在 AI 时代会加倍——推荐系统收窄你的输入,AI 又把你收窄后的输入高效地转化成答案。双重夹击之下,一个人接触异质信息的机会越来越少,而提问的原料恰恰来自异质信息的碰撞。你没法问出你从未见过的东西。
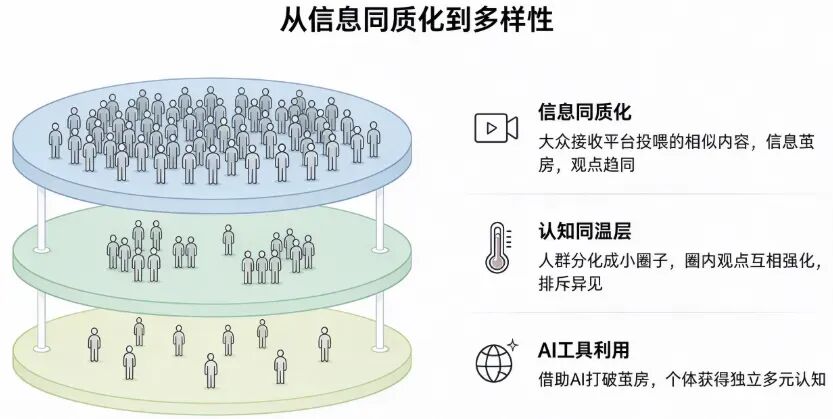
这种机制可以表示为一只三层漏斗,自上而下依次是“信息同质化”“认知同温层”“AI 工具利用”,每层站上的人形越来越少。漏斗的朝向值得留意——它是向下收窄的,意味着多样性是在流动过程中被逐层“漏”掉的,而不是被谁一次性夺走的。这解释了为什么茧房难以察觉:每一层的收窄幅度都不大,等你抵达漏斗底部,已经想不起来顶层原本有多宽。
漏斗漏到最后,漏掉的不只是多样性——多样性是好奇心的原料,人没法好奇自己从未见过的东西。一起被收走的还有时间:推荐流没有尽头,每一条都恰好勾着你刷下一条,等你回过神来,一两个小时已经沉在茧房里,而你并没多知道什么。
茧房最狠的地方就在于此:它让你连“自己错过了什么、耗掉了什么”都意识不到——人被按在原地,还以为在到处看。过去,人至少还能自己决定看什么;现在,连“对什么好奇”都得自己主动守住。好奇心曾经是不用经营的默认状态,现在成了一种资产:不主动维护,就会被推荐系统一点一点没收——连本带时间。
四、合起来看:提问与验证是同一件事的两面
现在把两侧合起来。这里有一个被两边讨论都错过的连接点:
一个好问题,就是一个自带验证标准的问题。
“帮我写个方案”这种问题无法验证,因为方案的好坏没有写进问题里。“帮我写一个面向 X 人群、预算 Y、必须在 Z 约束下成立的方案,并逐条对照约束自查”——这个问题天然带着验证接口。提问训练的一半内容,其实就是学着把验证标准写进问题里。反过来,验证的最强手段,是把一个模糊的答案重新追问成可检验的命题。问和验,在同一个动作里完成。
这解释了为什么“会提问的人”和“会验证的人”在现实中高度重合——他们共享同一种底层能力:在答案之外,始终保留一个独立的参照系。提问是在生成之前保持独立的方向感,验证是在生成之后保持独立的判断力。失去参照系的人,两个问题会一起失去:他既问不出好问题(没有自己的方向),也验不了答案(没有自己的标准),最后沦为 AI 输出的传送带。
五、参照系必须是独立的
既然提问和验证共享同一种底层能力——在答案之外保留一个独立的参照系——那么下一个问题自然是:参照系从哪来?
一个朴素的常识是:一把尺子不能校准它自己。人脑也一样,关在房间里独自运转的参照系会漂移、会退化,只是漂移的速度慢到当事人察觉不到。所以参照系只能是外部的,判断的可靠性,取决于参照系的独立性。
这套原理在验证侧有一套现成的做法。
- 第一条是横向阅读:不要盯着 AI 给出的答案本身琢磨对不对,离开它,去原始来源核对。
- 第二条是制造分歧:同一个问题拿去问多个模型,它们一致的地方可信度相对高,分歧的地方正是你该自己下场验证的地方——分歧是信号,不是噪声。
- 第三条是压力测试:同一个模型,换几种措辞多问几遍,如果细节随着措辞漂移,说明它在猜而不在记。
还可以更进一步:让 AI 自己交代信息源,逐条标注每个事实的出处;让两个 AI 互相质证,一个陈述、一个挑错;甚至刻意在不同的 AI 和不同的平台上保留不同的偏好,不让任何一个系统摸清你、把你困在为你定制的视角里。
但这里有一个容易被忽略的陷阱:参照必须真的独立。两个模型互相验证,有效的前提是它们会犯不同的错。如果两个“独立”的 AI 实际上同源——相似的训练数据、相似的架构、相似的对齐方式——它们的共识就是虚假共识,分歧检验随之失效。验证的可靠性不取决于参照的数量,取决于参照的独立性。这个道理超出 AI 的范畴,对组织同样成立:十个思维同质的专家坐在一起评审,不等于有十个参照系,只等于一个参照系被复印了十份。
在提问侧,参照的形态稍有不同:它是借别人的问题,触发自己的问题。前文提到的问题爆发练习之所以必须一群人做,原因就在这里——别人的问题是对你问题空间的外来扰动,四分钟里十几个角度砸过来,总有一个能撞开你自己框架的缝。
一本好的提问类著作,本质上也是一张别人的问题清单,价值在那些你从未想到要问的角度。往大了说,一个人所连接的网络本身就是参照系的一部分:你认识的那些和你专业不同、立场不同、信息来源不同的人,是你提问能力的外置硬盘。提问能力一半在自己脑子里,另一半在你所连接的网络里——网络越同质,这另一半就越接近报废。
六、回到那个圆:提问是突破边界,验证是落实边界
有一张流传很广的图,出自 Matt Might 的 The Illustrated Guide to a Ph.D. [16]:人类全部知识是一个圆,你从圆心出发,一路读到边界,然后用几年时间,在圆周上顶出一个几乎看不见的小凸点。这个凸点,就是一个博士对人类的全部贡献。
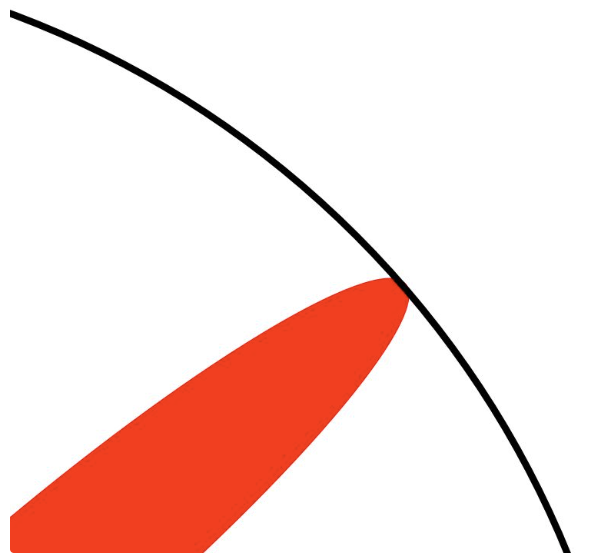
这是组图的倒数第四帧:红色的知识锥体抵达圆周,正在向外推挤。值得留意的是原图的一个设定——推挤发生在圆周的一个点上。知识的扩展从来不是全面铺开,它永远是单点突破。这意味着“选择推哪个点”是无法回避的第一步,而这第一步恰恰是提问。
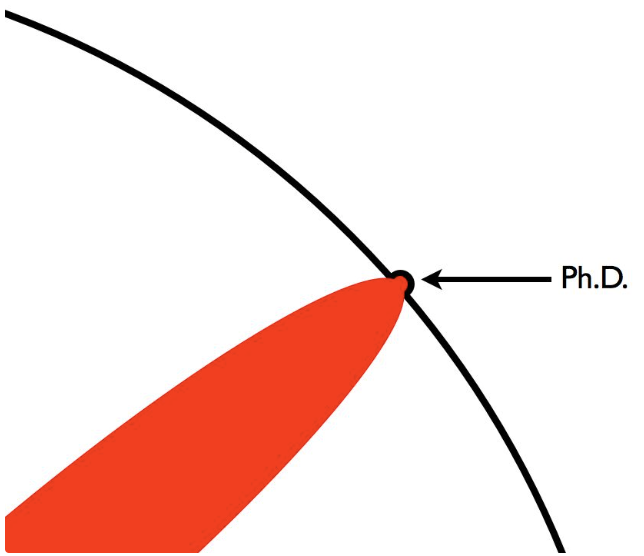
这是上一张图片的下一关键帧:边界被顶出了一个小小的凸点,标注为“Ph.D.”。注意这个凸点在几何上的性质——它只有当新的边界曲线被确认成立之后,才算圆的领土;在确认之前,它只是圆周外的一个主张。生成一个凸点和圈定一块领土,是两件事。
这组图给前面所有讨论提供了一个统一的几何语言。
- 提问,是选择突破的方向。 圆的周长极长,在哪里顶出下一个凸点,没有算法能替你决定——因为它问的恰恰是圆内没有答案的事。
- 生成,是把点推出去的动作。 这一步曾经昂贵——一个博士要花五年。现在 AI 把它变得几乎免费:它可以在圆周上任何一点瞬间画出凸点,要多少有多少。
- 验证,是决定凸点算不算数的勘界程序。 这里是整个比喻在 AI 时代最锋利的地方:画图和圈地是两回事。一个未经勘界的凸点,不是新领土,只是圆外用铅笔画的一道印——擦掉它,圆还是原来的圆。幻觉在这个几何里有了精确的定义:虚假的凸点。AI 时代圆的边界不再在“凸点被画出来的地方”扩展,只在“凸点被验证的地方”扩展。
由此可以重述 Jason Wei 的验证者定律:这个圆只能在“界外地形易于勘测”的方向上真正生长。 数学和代码方向的凸点落成得又快又稳,因为勘界便宜;法律、战略、审美方向的凸点画出得同样快,但勘界遥遥无期——地图上于是充满了声称存在、却无法确认的半岛。
GPU kernel 战场就是正在发生的实例:画凸点的已经比量边界的强了,于是整个行业开始给勘界程序立法——SOL-ExecBench 把尺子钉在物理定律上,Kernel Contracts 给每块新领土立契约,Compilers 2.0 则干脆把“只画经过勘界的凸点”写进了生产流程。
Matt Might 的原图还有最后一帧常被忽略:顶出凸点之后,他提醒博士们退后一步,重新看整个圆——不要因为自己的凸点而忘记全貌。 这个提醒在 AI 时代有了新的紧迫性:当每个人都能指着无数凸点时,知道整个圆长什么样、知道哪些凸点经过了勘界,就成了比画凸点稀缺得多的能力。
七、一个开放式的收尾
把整条线索拉到最后,会看到一个略带反讽的结构。
AI 把答案的价格打到了零,却抬高了另一样东西的价格:较真。核查一个答案要花时间——核实一百个事实,比生成它们还贵;维持好奇心要花心思——得主动对抗推荐系统把你往茧房里拉的引力。在答案唾手可得的世界里,“愿意为答案较真”本身,正在变成一种昂贵的品质。
而较真恰恰是无法外包的。验证外包给同源的系统,得到的是虚假共识;提问外包给推荐算法,得到的是茧房的回音。这两件事,只能自己来。
Jason Wei 的验证者定律画出了 AI 的疆界:易验证的终将被解决。这个定律对人类同样成立,只是方向相反——机器在易验证的世界里狂奔,留给人的是那些验证昂贵、方向未明的地方。守在那里需要的是一种更朴素的东西:愿意为一个答案付出核查的时间,愿意为一个问题付出不被打扰的耐心。
所以这篇文章最后没有结论,只留一个问题——它恰好属于 Berger 说的那种“没有事实答案的问题”:
在答案免费的时代,你愿意为一个正确的答案付出多少?
这个问题没有标准答案,每个人都得自己回答。而人与人在 AI 时代拉开的差距,大概率就藏在这些不同的回答里。如果你对这类 AI 时代人的位置话题还有更多想法,也欢迎到云栈社区继续聊聊这个没有标准答案的问题。
参考资料
 发表于 昨天 04:48
|
查看: 5|
回复: 0


