大模型已经越来越会「看懂」空间:它能判断物体在机械臂哪一侧,也能识别该操作哪个目标、理解任务怎么做。但如果真的把机械臂交给它,问题会变得更具体:该移动多少毫米?当前视角够不够?抓空以后,又该怎么调整?
VA-Bench 测试了 12 个主要多模态模型。表现最好的几组模型,在目标识别与定位(TL)上达到 100%,操作语义理解(MS)也达到 99.6%—100%;但完整任务成功率只有约一半:Qwen3.8-max、Opus-5 和 GPT-5.6-sol 分别为 53.93%、52.86% 和 51.55%。
目标找对了,任务也看懂了,为什么真正动起来以后,还是只有大约一半能成功?对于这些情况来说,模型真的「理解」了空间吗?
这正是 VA-Bench 想测的问题。
空间智能,不能只停在「答对」
很多空间推理 Benchmark 已经能评估深度、距离、三维关系和多视角理解,但通常由评测者提前决定「模型看什么、回答什么」。真正进入机器人环境后,模型还要自己判断当前信息是否足够;如果不够,就决定缺什么、该从哪里继续观察。新的视觉证据补齐后,再把空间判断落到具体动作,并根据执行结果决定是否修正。
因此,真正面向物理行动的空间智能,不应该止步于回答一个已经定义好的空间问题。围绕这一点,研究者提出了 VA-Bench(Vision-Action Benchmark),把空间智能放进一个完整的闭环:
Observe → Reason → Act → Revise,即「观察 → 推理 → 行动 → 修正」。
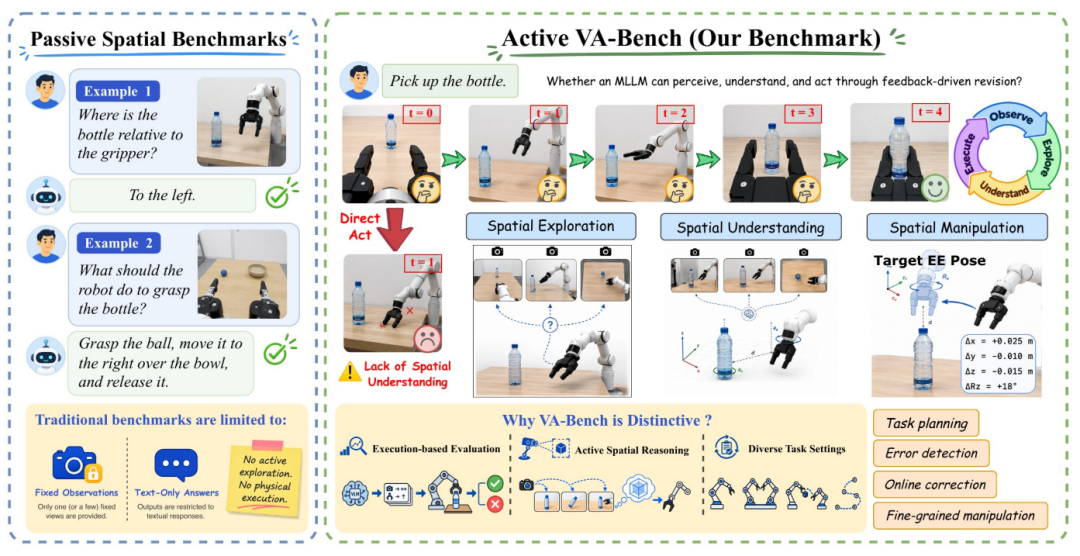
图 1:VA-Bench 与传统空间评测的对比。
VA-Bench 要求模型真正进入机器人与环境的交互过程。测试前,模型观看成功示范视频,理解任务怎么做,但不会获得物体坐标、专家轨迹或精确动作参数;测试中,它可以主动切换视角,但会消耗交互步数,必须在继续观察和开始行动之间做出取舍。
最后,空间判断还必须真正落到动作上。模型需要直接给出具体的移动距离和旋转角度,并决定什么时候打开或闭合夹爪。
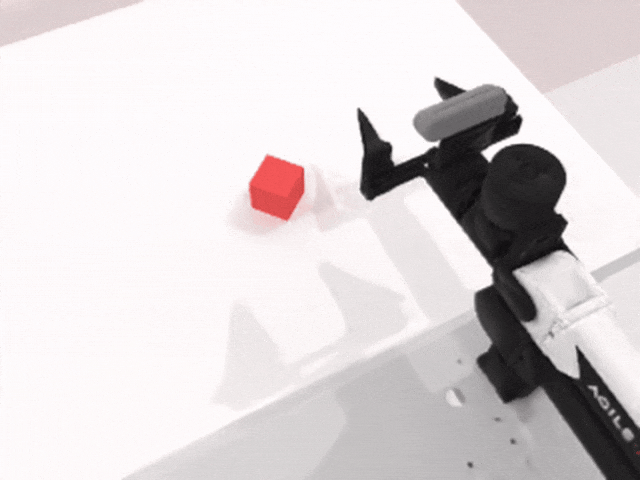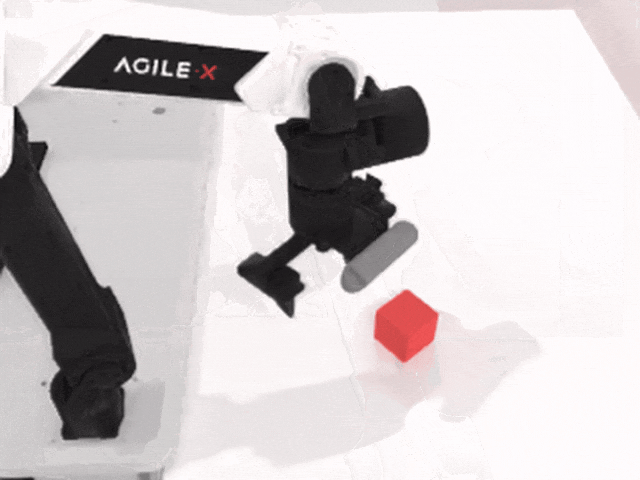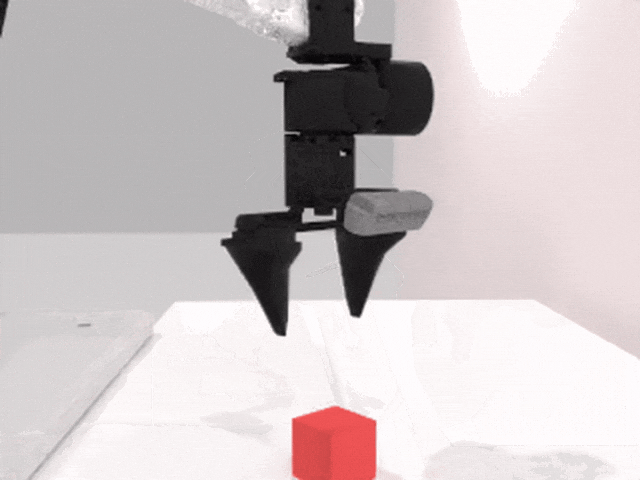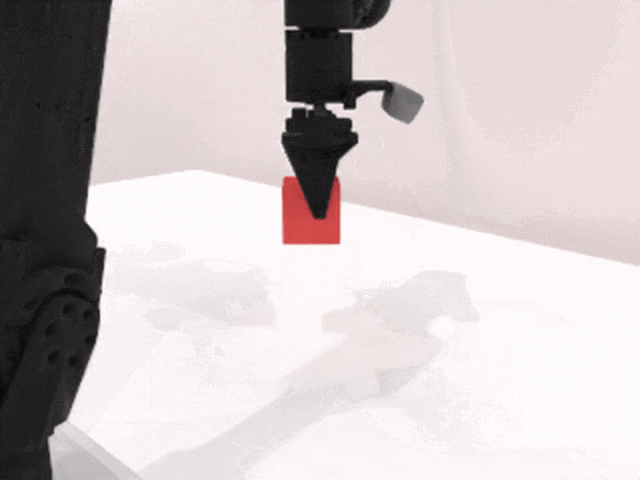
图 2:主动观察与执行过程示例。
14 类任务,280 个基础场景
VA-Bench 包含 14 类机器人操作任务,其中有 11 类单臂任务和 3 类双臂任务,每类 20 个经过物理验证的场景,共 280 个基础场景。
此外还设置了几何迁移和长时序组合测试,进一步追问:换一个空间布局,模型还能重新判断怎么做吗?会做若干独立操作,又是否意味着能够把它们稳定地串成更长的任务?
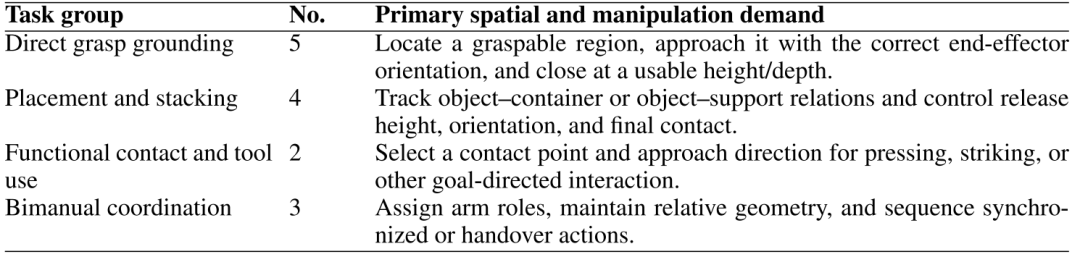
表 1:VA-Bench 基础任务设置。
目标找对了,为什么还是做不对
从整体结果看,表现最好的几组模型完整任务成功率只有约一半,但子任务完成率达到 65.9%—68.6%。这说明很多失败并不是模型完全不知道怎么做,而是已经完成了其中不少步骤,却没能把整个任务稳定做完。
进一步拆解模型的执行过程,当前的困难主要集中在三个环节:从目标识别到精细空间执行、从错误发现到在线修正,以及从单臂操作到双臂协同。
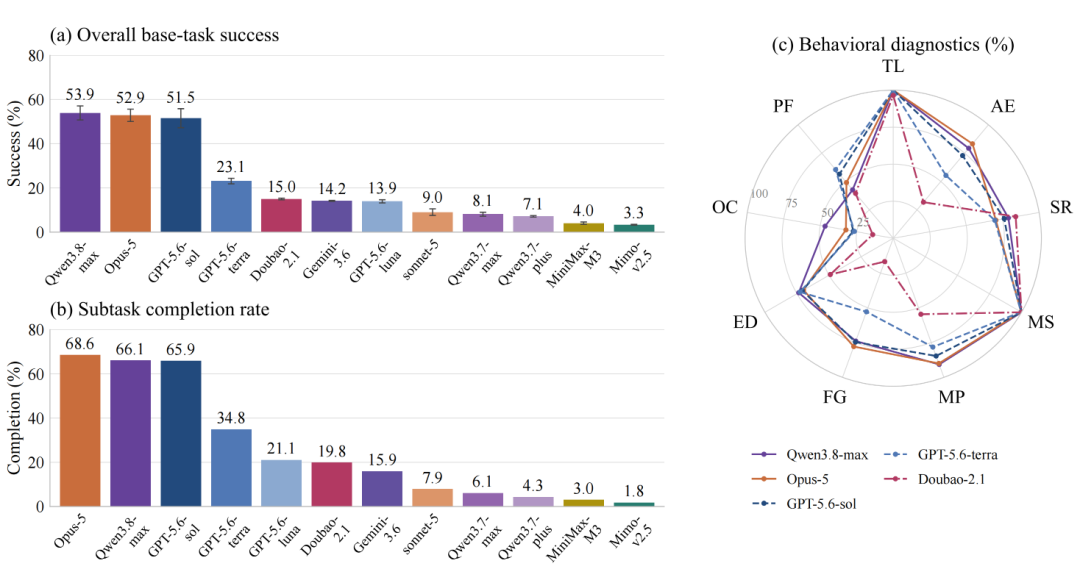
图 3:VA-Bench 的主要实验结果。
找到目标,不等于能精确移动到目标
前三的模型在目标识别与定位(TL)上全部达到 100%,在操作语义理解(MS)上也达到 99.6%—100%。但到了更精细的空间执行阶段,例如接触前的细粒度分析(FG)、与目标之间的空间关系判断(SR)等,成绩开始明显下降。
一个模型完全可能准确找到一个瓶子,却在夹爪还没有下降到合适高度时提前闭合;也可能理解「需要把物体放进容器」,却无法稳定判断物体与容器之间精确的高度、深度和接触位置。
会发现错误,也不等于能及时改回来
Qwen3.8-max、GPT-5.6-sol 和 Opus-5 在错误发现(ED)上的得分分别达到 73.6%、70.8% 和 69.9%,但到了真正的在线修正(OC),三者分别只有 46.7%、27.3% 和 32.4%。模型已经越来越能发现「哪里不对」,但还不擅长把新的观察迅速转化成有效修正。
一只机械臂已经不容易,两只更难
当任务从单臂进一步进入双臂协同时,这种困难又被进一步放大。Qwen3.8-max 在单臂任务上的平均成功率达到 65.61%,但双臂任务只有 11.11%;Opus-5 从 64.09% 降至 11.67%。
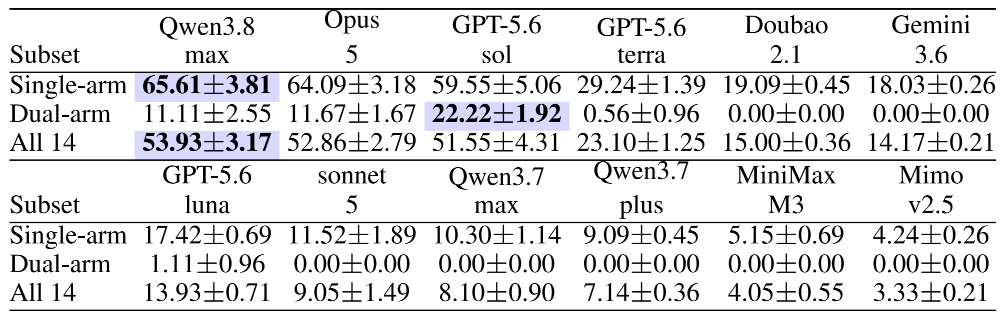
表 2:单臂、双臂及整体任务成功率。
这类任务的难点并不只是「多控制一只机械臂」。模型还需要判断哪只机械臂负责哪个物体、两只机械臂之间应该保持怎样的相对位置,以及不同动作应该按什么顺序衔接。任何一个环节的空间判断出现偏差,都可能让后续动作无法继续。
多给几个视角,就能解决问题吗
如果直接把更多视角一次性提供给模型,是不是就不需要主动观察了?为此,VA-Bench 设置了一组对照实验:一种情况下,模型每次只看到当前视角,但可以根据当前任务需要主动切换观察方向;另一种情况下,模型直接获得 5 个固定视角,但不能继续自主选择新的观察位置。
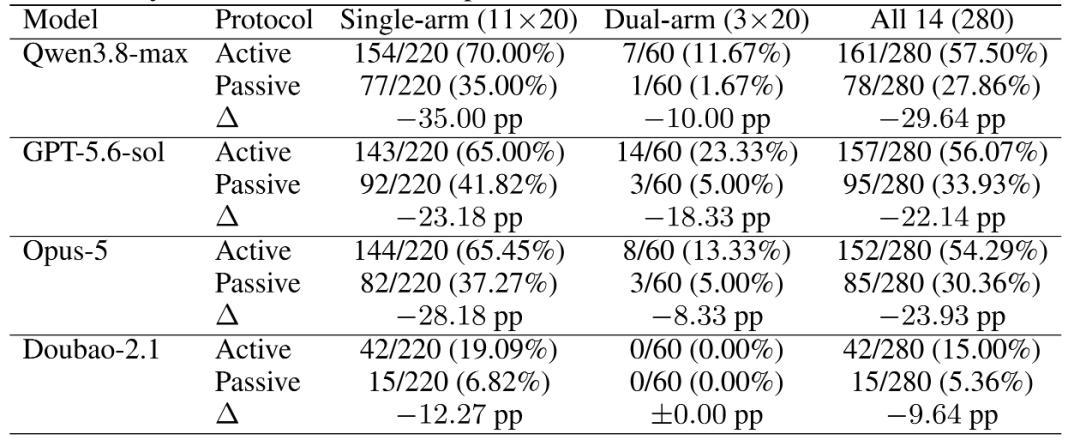
表 3:主动观察与固定五个视角的结果对比。
结果非常一致:4 个模型在失去主动观察能力以后,成功率全部下降。
主动观察真正重要的地方,可能并不是让模型单纯地「多看」,而是让它知道自己还缺什么,以及下一眼应该去哪里找答案。
换个布局、拉长任务,能力还剩多少
几何迁移测试保持任务目标和操作流程不变,只改变物体形状、容器或空间布局。Qwen3.8-max 的成功率从 77.86% 降至 67.86%,GPT-5.6-sol 则从 80.00% 降至 47.86%。
模型知道一种操作怎么完成,并不意味着进入新的空间布局后,还能重新建立正确的空间关系。
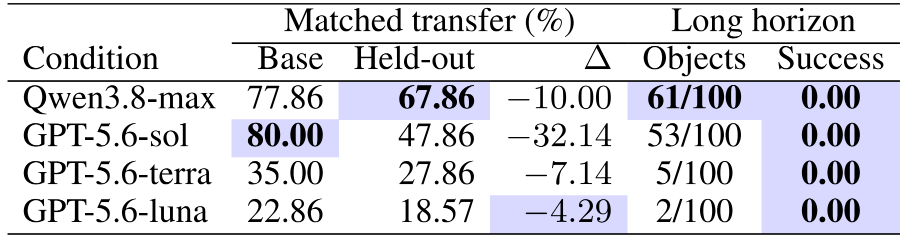
表 4:几何迁移与长时序组合测试结果。
类似的问题在更长的执行过程中被进一步放大。VA-Bench 设置了一个五个物体的长时序组合任务,Qwen3.8-max 最终完成了 61/100 次物体放置,GPT-5.6-sol 完成了 53/100 次。
有的模型能够完成不少中间步骤,但整个任务却没有任何模型完整完成过一次。会做几个独立操作,不代表模型就能在长任务中持续稳定执行。
从「看懂」走向真正的空间智能
VA-Bench 看到的不是简单的「会」或「不会」,而是一系列更具体的能力边界:模型可以找到目标,却未必能精确移动到目标;可以发现错误,却未必能及时修正;可以获得更多画面,却未必知道当前最需要看哪里;可以完成几个独立步骤,却未必能稳定完成更长的任务。
今天的多模态大模型已经越来越会「看懂」物理世界,但从理解到可靠行动之间,仍然存在明显距离。
VA-Bench 想做的,就是把这段距离测出来。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com
 发表于 昨天 22:53
|
查看: 5|
回复: 0


