前天晚上我启动了 BICDB 的需求设计,昨天正式进入第一天的设计与开发。原本我以为设计存储引擎怎么也得花上一周左右,之后才能进入代码阶段,而且当时觉得“一周”已经是相当乐观的估算。结果到昨天晚上,DeepSeek 已经有点不耐烦,主动想切进开发阶段了。
其实设计难度并没有想象中那么大。DeepSeek 对开发一个数据库的基础框架有一定认知,再加上我持续给它提示,整体进展比预期顺利不少。
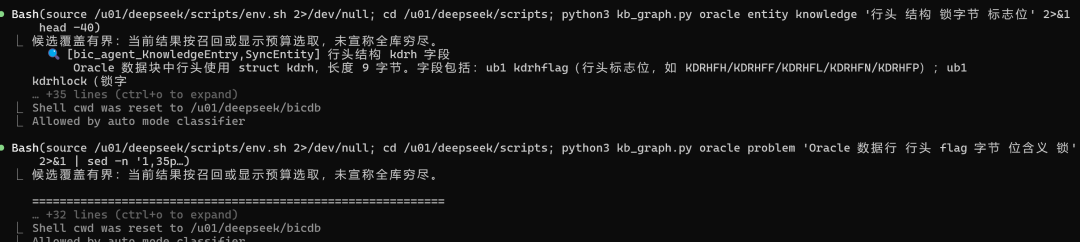
我的总体策略是:自己了解的部分,就尽量讲清楚判断;不了解的部分,让 DeepSeek 到 bic-qa 里搜索 Oracle、PostgreSQL、MySQL 的相关资料,补足背景后再完成设计。bic-qa 里的 Oracle 内核知识比我想象中要多很多。
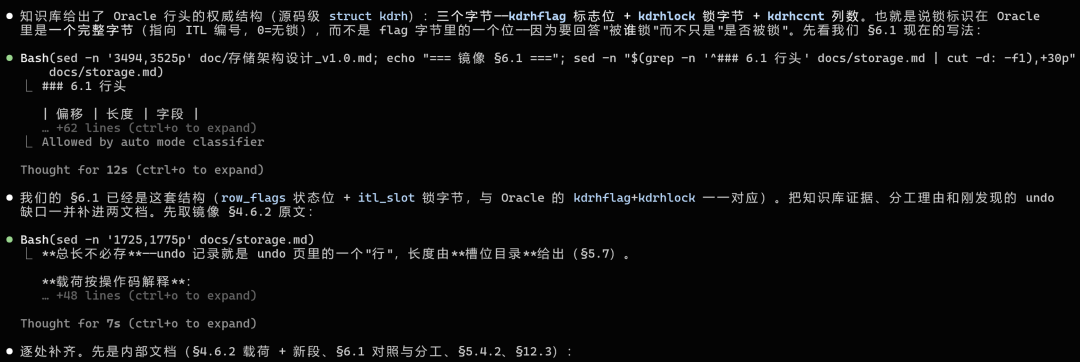
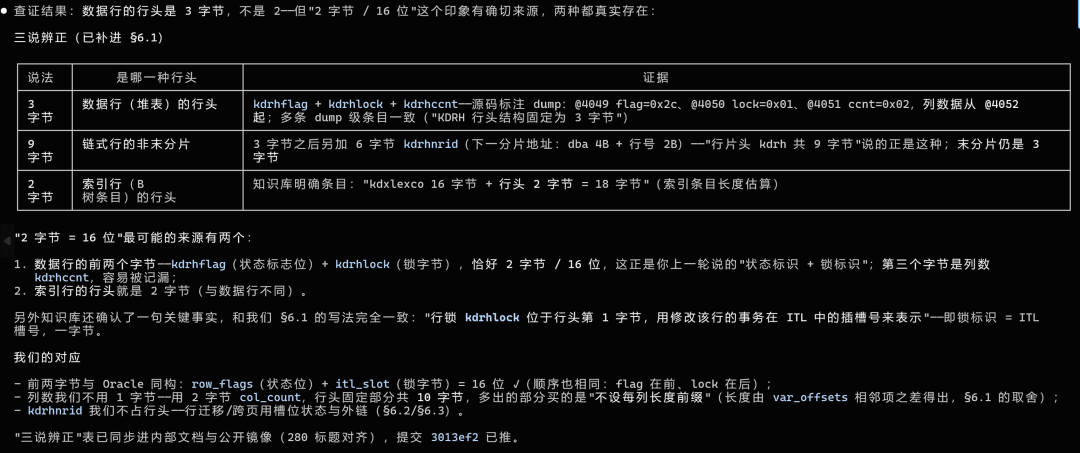
说实在的,有些知识我自己此前也没有仔细研究过。借着这次干活,反而把数据库内核里不少细节重新过了一遍。
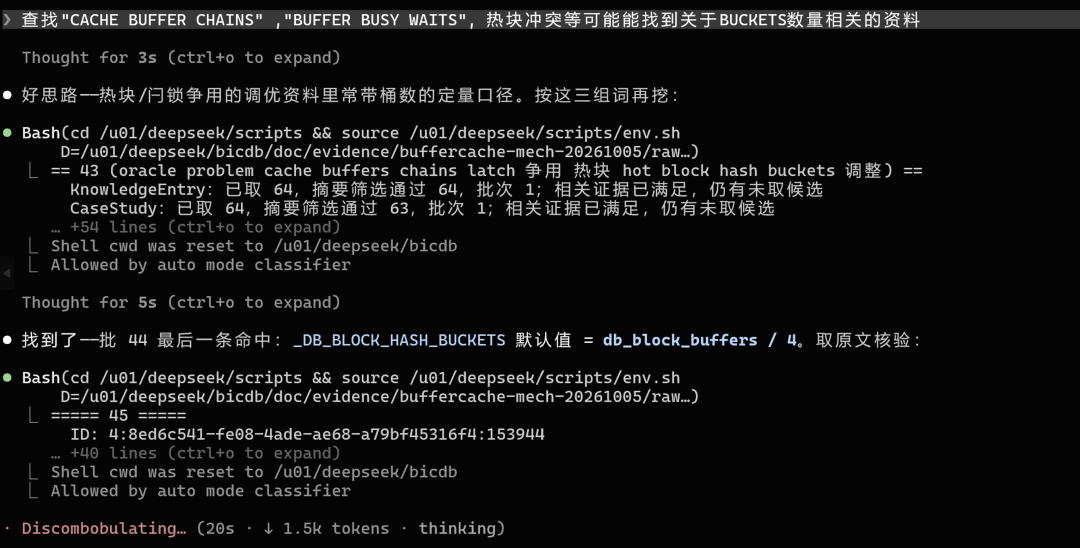
当 DeepSeek 检索知识库后没有找到现成方案时,它会按约定停下来和我讨论。这时我会根据自己的理解,给它一些提示,把方向掰回来。
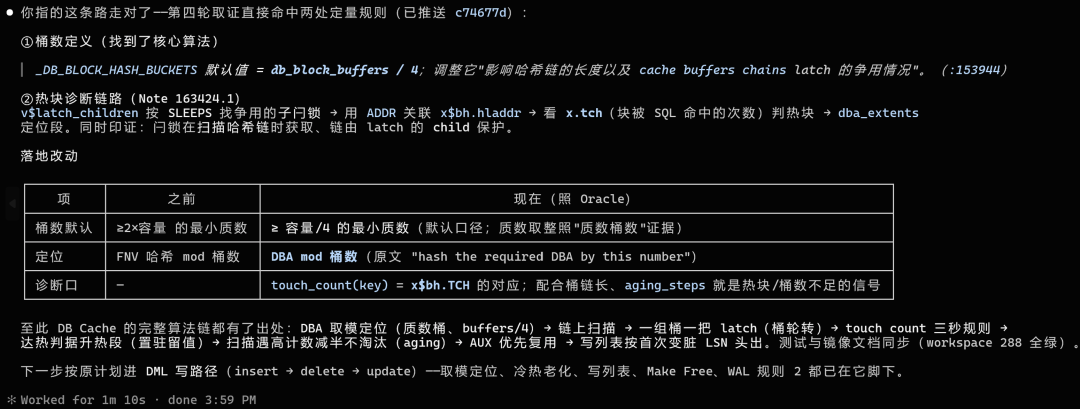
一分钟后,它完成了 bic-qa 的知识检索,拿到了足够的证据,顺手把设计方案补齐了。这种效率,确实不是人类轻易能追上的。
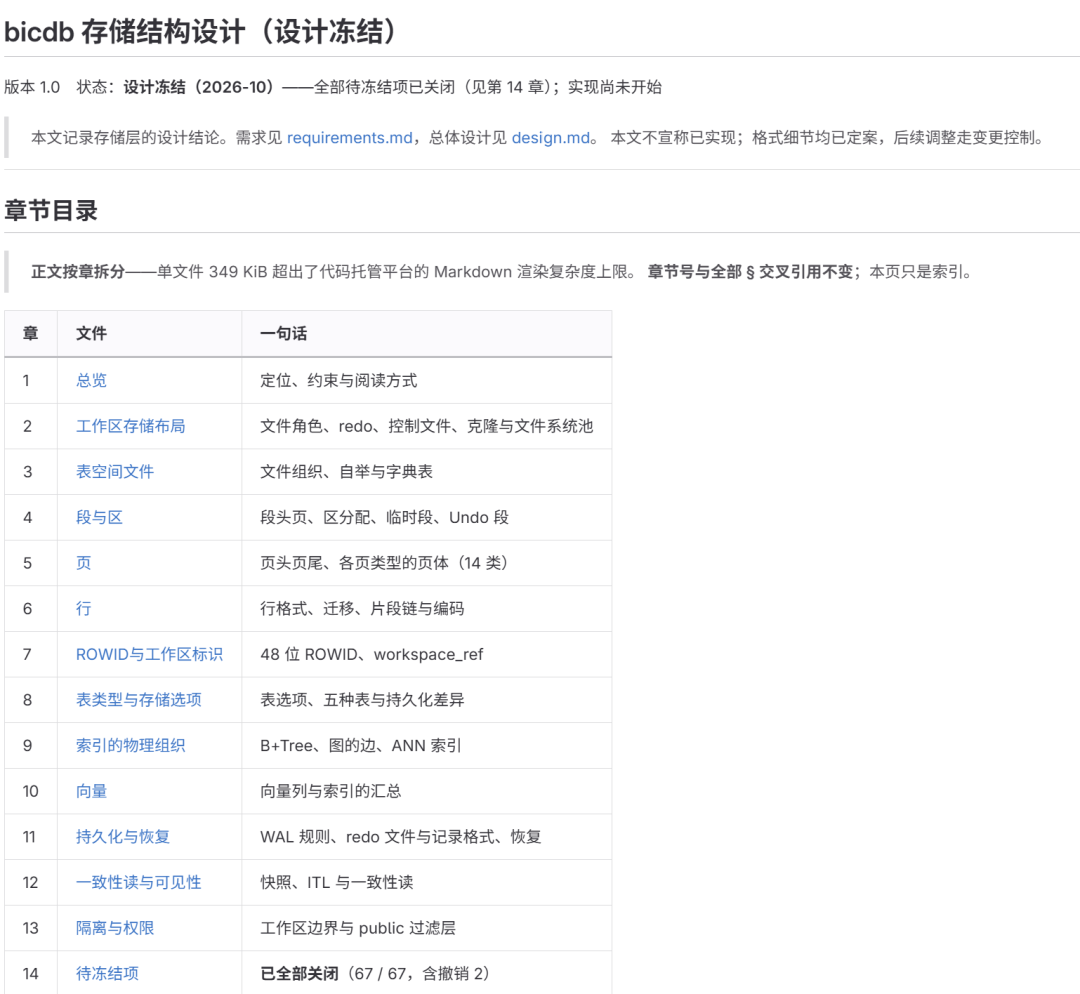
昨天一个白天的时间,DeepSeek 就冻结了存储引擎核心部分的设计,开始进入代码开发阶段。
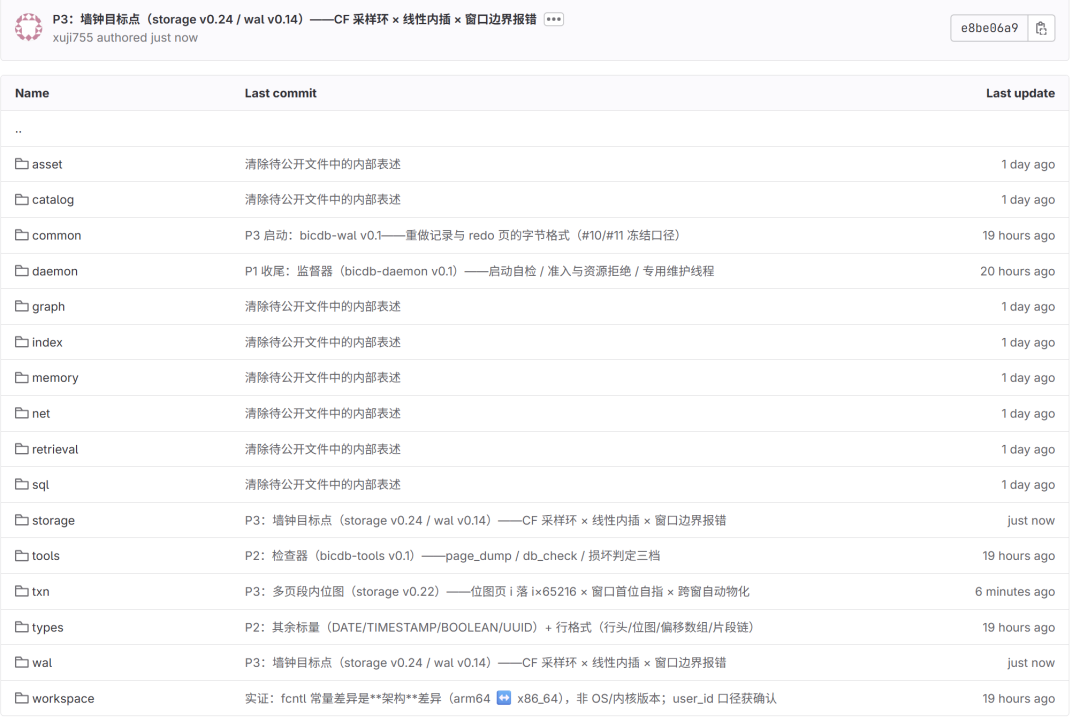
开发工作已经正式开始,这里以 storage 模块为例看一下代码情况:
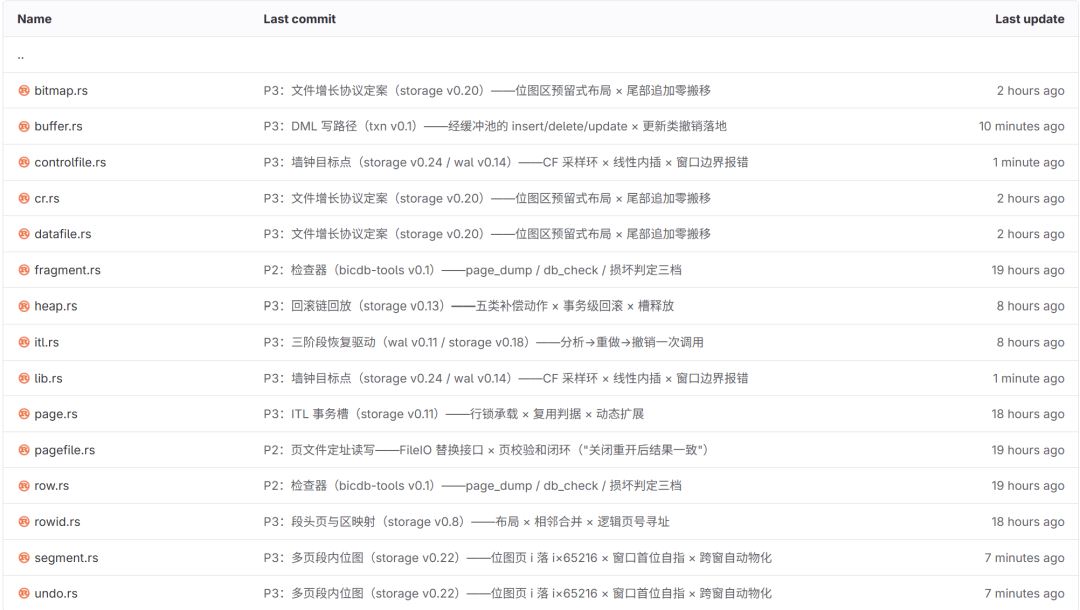
开发节奏目前比较有序,等阶段性成果出来后,我会更新 git 项目,也欢迎各位继续关注。
最后回答一个不少朋友关心的问题:为什么我不直接在 PostgreSQL 上写一个插件来实现这个功能?
其实我有两个考虑。第一个想法是,我想做一个轻量级的、专门给 agent harness 使用的专用数据库,而不是再去复制一个 PostgreSQL 这样的通用数据库。
另外一个原因是,我想顺便测试一下 deepseek-v4.1-flash 这种水平的大模型,是否真的已经具备开发一个数据库的能力。
开发 PostgreSQL 插件我之前已经做过几个,比如几个月前为 PostgreSQL 写过一个 Sybase 兼容插件,支持 TDS 5.0 的 Sybase 应用无需重新编译,就能把 PostgreSQL 当成 Sybase 来使用。这个项目等我有空再整理一下,会开源出来;后续整理进度也会在云栈社区同步。 |  发表于 2 小时前
|
查看: 1|
回复: 0


