导读
实时数据需求高速增长,传统“批流分离”的 Lambda 架构却在成本、一致性与运维复杂度上接连翻车。云器科技解决方案架构师石静猛结合快手、小红书两大万核级集群的生产实践,系统拆解了通用增量计算( GIC )如何以一套引擎、一套标准 SQL 破解“不可能三角”。下面从业务痛点、技术特性、大规模落地验证到实施路径,逐层展开。
01 Lambda 架构下难以调和的代价
当数据量达到千亿级日均规模时,典型的 Lambda 架构(Flink + Spark + Iceberg/Paimon + ClickHouse) 会暴露出三重死穴,而这些痛点因规模扩大被急剧放大。
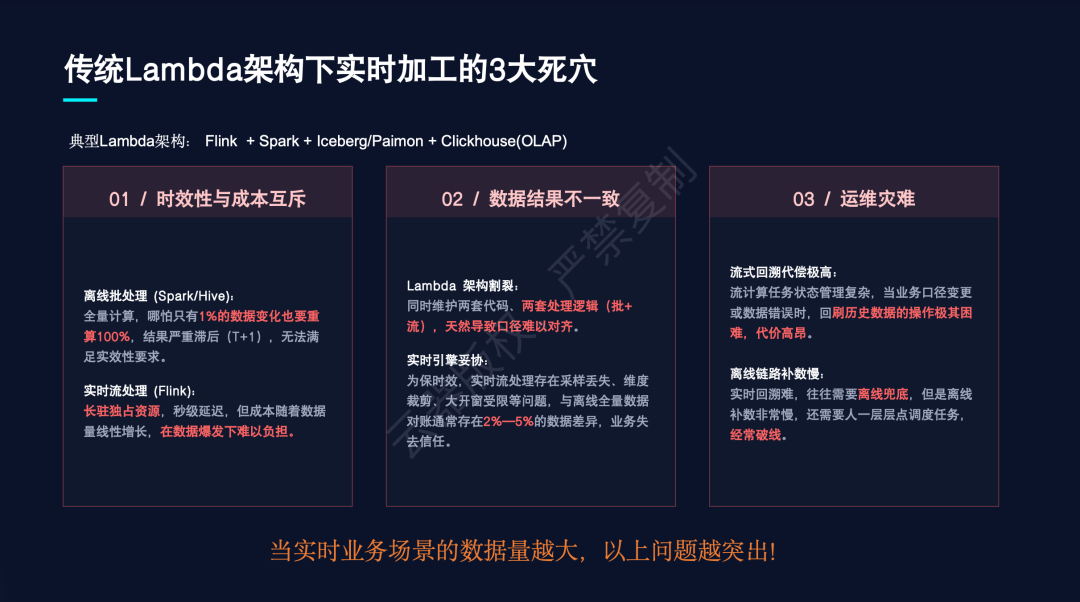
图1|传统 Lambda 架构下实时加工的 3 大死穴
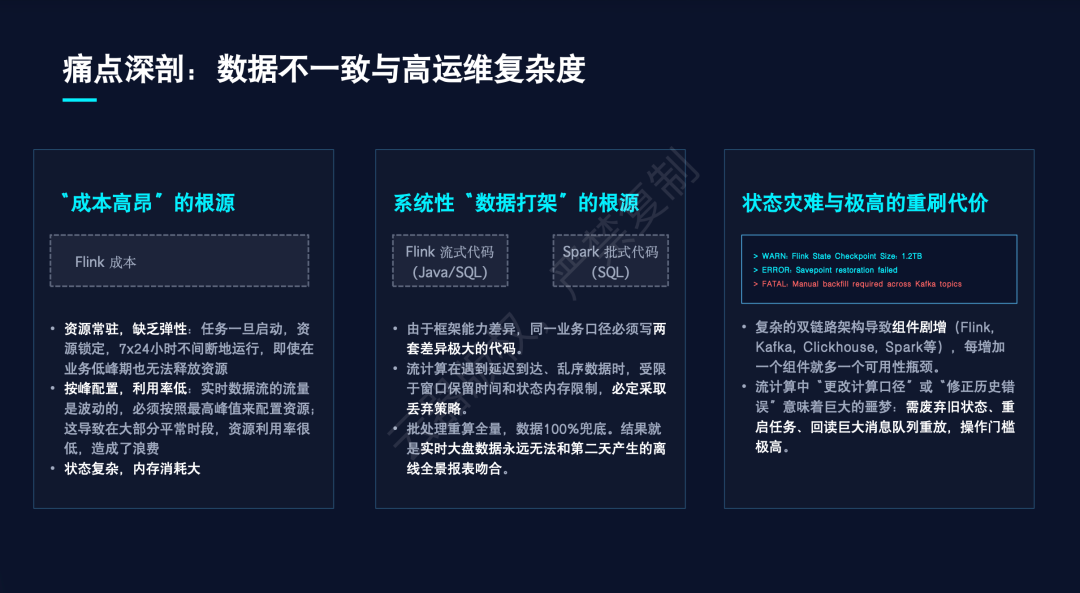
图2|痛点解剖——数据不一致与高运维复杂度的三层根因
第一,时效性与成本严格互斥。 离线批处理的全量计算模型 意味着,即使上游仅有 1% 的数据变化,系统也必须重算 100% 的历史分区,这种计算惯性直接导致了结果的 T+1 滞后。而实时流处理虽然能带来秒级延迟,但其长驻资源与按峰值锁定的计费模式,在流量波动的业务场景下造成了严重的资源闲置与浪费。
第二,数据结果天然打架。 这套架构最致命的隐患在于两套代码、两套语义。实时链路为了保吞吐,往往被迫对数据进行采样、裁剪非核心维度、限制开窗跨度;离线链路则全量兜底、逻辑完备。最终结果就是实时大盘与离线报表永远存在 2%-5% 的对账差异。对于 A/B 实验这类算法场景,一旦误差超过 3%,实验结果即告失效,业务方只能继续等待次日的离线报表,实时投入也就失去了决策意义。
第三,运维的不可控。 流计算状态管理的复杂度随状态大小指数级上升,口径变更或历史数据修正往往意味着废弃状态、重启回放,操作门槛极高。而离线补数链路耗时漫长,人工调度极易触发基线破线。
要打破这个困局,必须寻找一种新的计算范式:它不应在流和批之间做非此即彼的选择,而是能根据业务需求动态调整计算粒度。云器给出的答案是通用增量计算( GIC )。
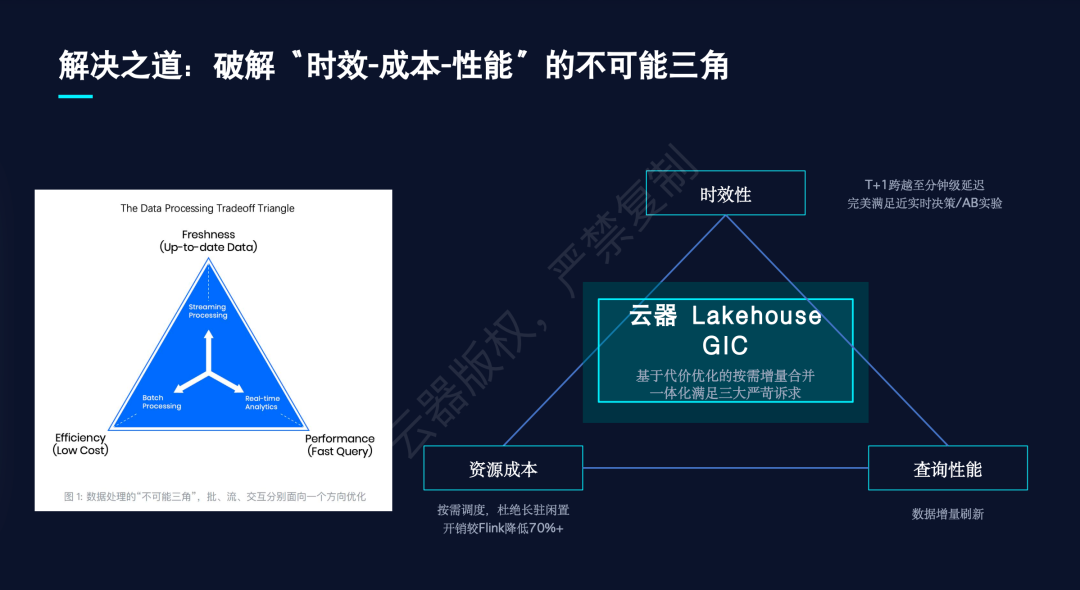
图3|解决之道——破解「时效-成本-性能」的不可能三角
02 GIC 的设计逻辑与技术特性
通用增量计算( GIC )给出的解法并不复杂:核心只有一句话——每次只算该算的数据,每份数据只算一次。但它实现这一目标的方式,涉及从引擎到存储的全链路重构。
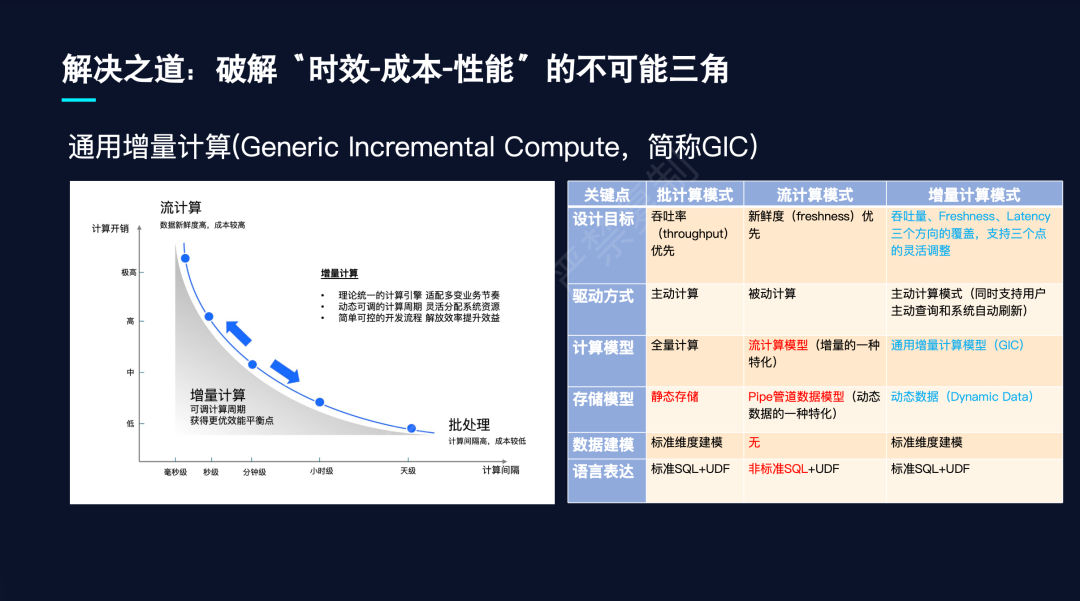
图4|通用增量计算( GIC )与批计算式、流计算式逐项对比
从“被动计算”到“主动合并”。 传统流计算被动等待数据触发计算,而 GIC 采用主动计算模式,同时支持用户主动查询与系统定时刷新。数据模型从静态存储或 Pipe 管道,演进为动态数据( Dynamic Data )。系统会追踪基表的每一次变更( Append/Update/Delete ),并在触发刷新时仅对增量数据进行运算,再与存量合并输出。
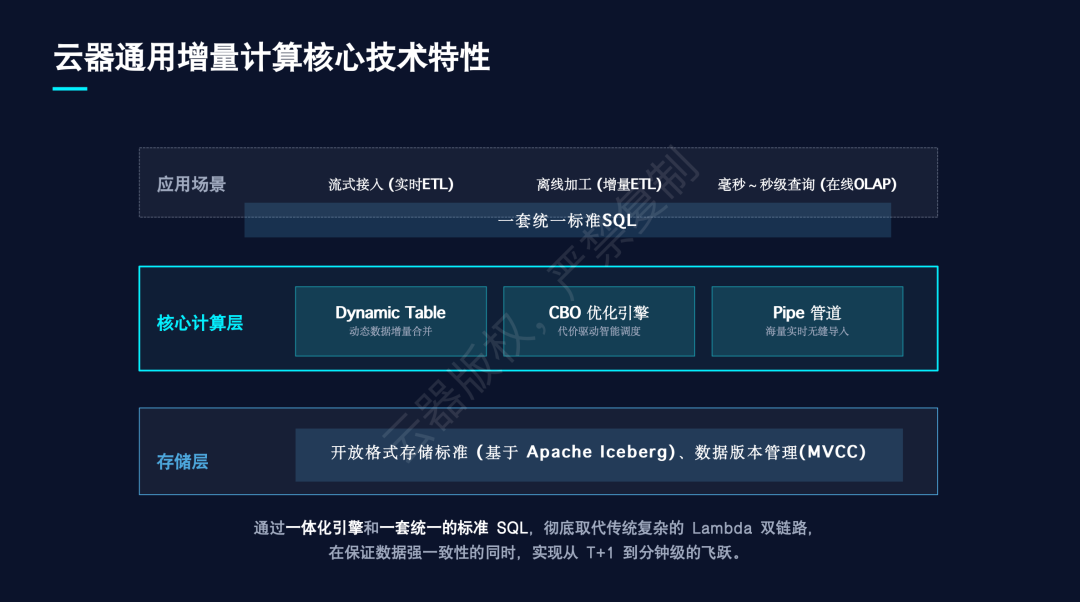
图5|云器通用增量计算核心技术特性——一体化引擎 + 一套标准 SQL
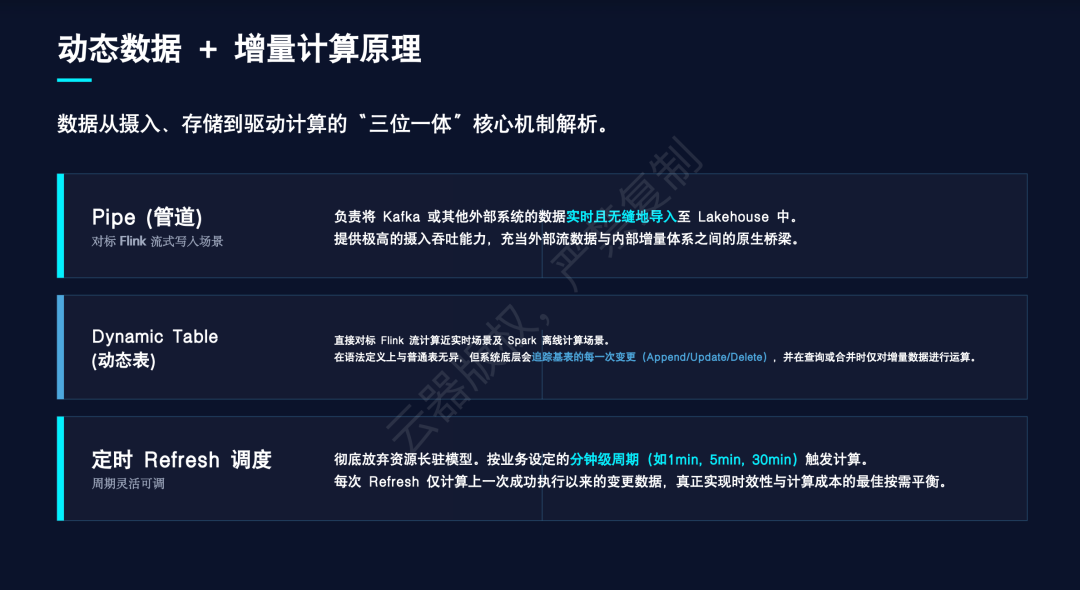
图6|动态数据 + 增量计算原理:Pipe 管道、Dynamic Table 与定时 Refresh 调度
架构的一体化收口。 通过一体化引擎与一套标准 SQL,GIC 直接取代了复杂的 Lambda 双链路。外部数据(如 Kafka )通过 Pipe 管道无缝摄入 Lakehouse,用户只需声明 CREATE DYNAMIC TABLE 并配置 REFRESH EVERY(如 1 分钟、5 分钟),系统便自动按照设定的分钟级周期触发增量计算。这一设计彻底放弃了资源长驻模型,真正实现了时效性与计算成本的按需平衡。
03 落地体验:标准 SQL 的开发手感与开放存储
对一线开发人员而言,GIC 带来的最直观改变在于研发体验。它并不要求开发者学习新的计算模型,而是将复杂性下沉到底层引擎。
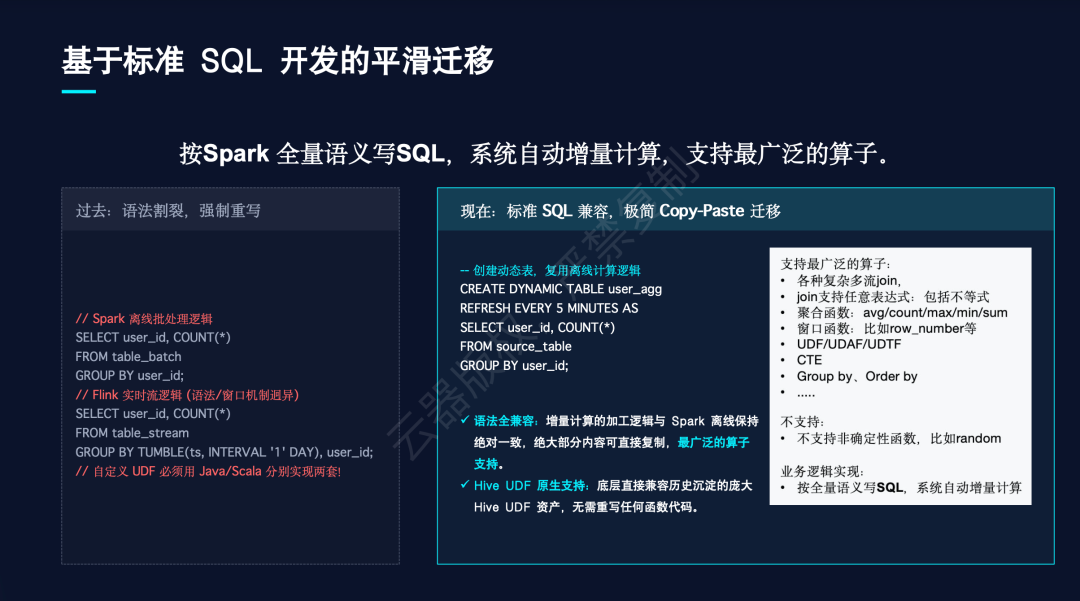
图7|基于标准 SQL 开发的平滑迁移:从强制重写走向 Copy-Paste
全量语义,增量执行。 开发者只需要按照 Spark 离线的全量语义编写 SQL,系统自动进行增量逻辑转换。无论是复杂多流 Join、窗口函数、CTE 还是自定义 UDF/UDAF,绝大部分离线逻辑可直接复制粘贴迁移。唯一的限制是不支持像 random 这类非确定性函数。
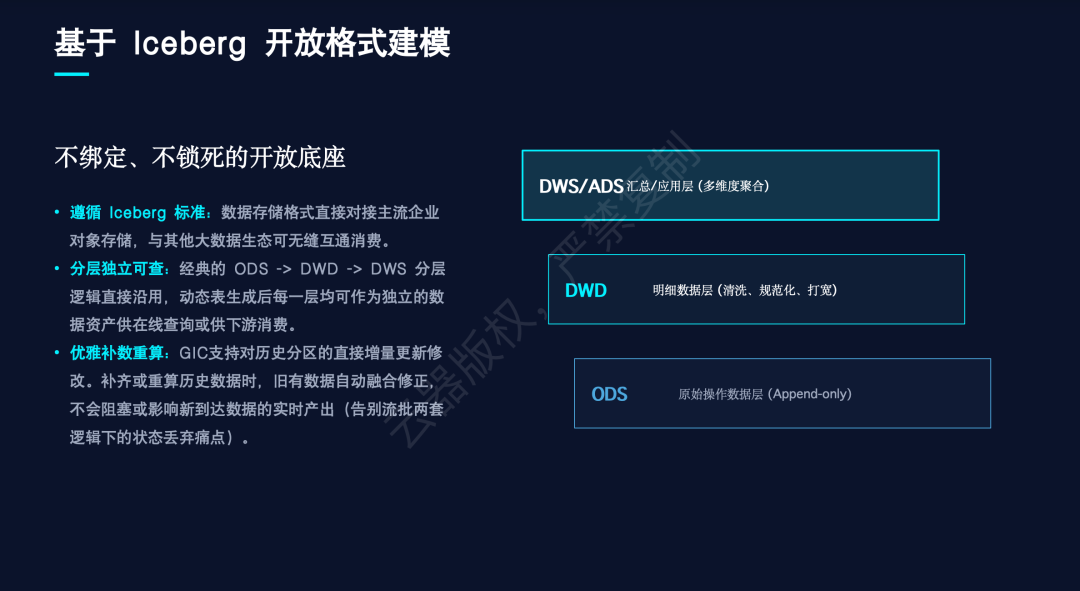
图8|基于 Iceberg 开放格式建模——不绑定、不锁死的开放底座
开放格式与分层建模。 存储底座基于 Apache Iceberg 标准,文件格式为 Parquet,这意味着数据资产并不绑定在单一引擎上,可由其他大数据生态组件直接消费。数仓分层( ODS -> DWD -> DWS )逻辑得以完整保留,每一层均可作为独立资产对外提供查询。更重要的是,GIC 支持对历史分区的直接增量更新,补数或重算时旧数据自动融合修正,且完全不阻塞新数据的实时写入——这彻底告别了流批两套逻辑下的状态丢弃痛点。
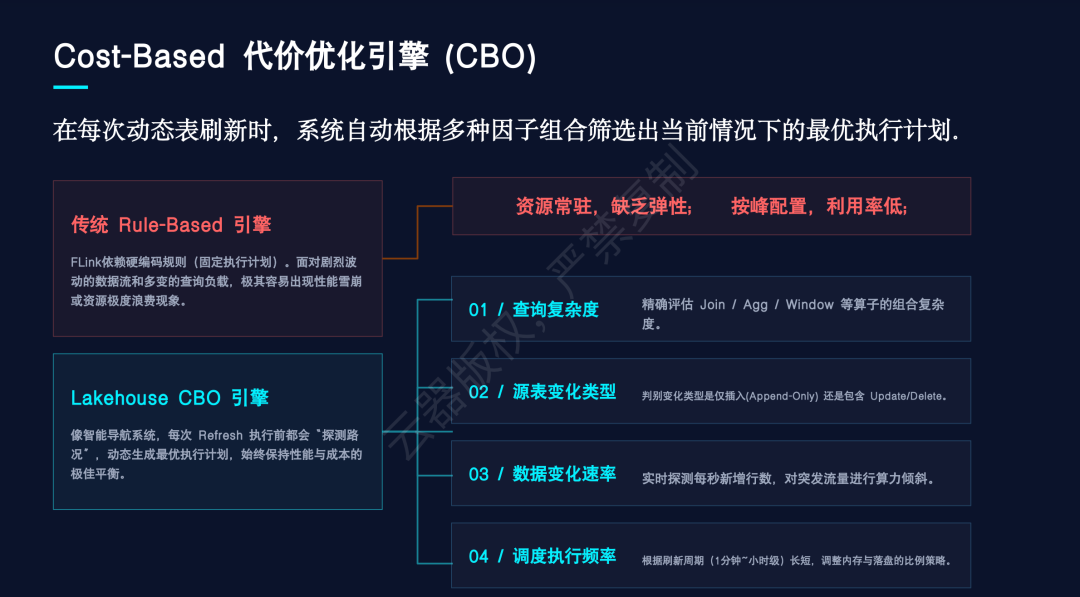
图9|Cost-Based 代价优化引擎( CBO )与传统 Rule-Based 引擎对比
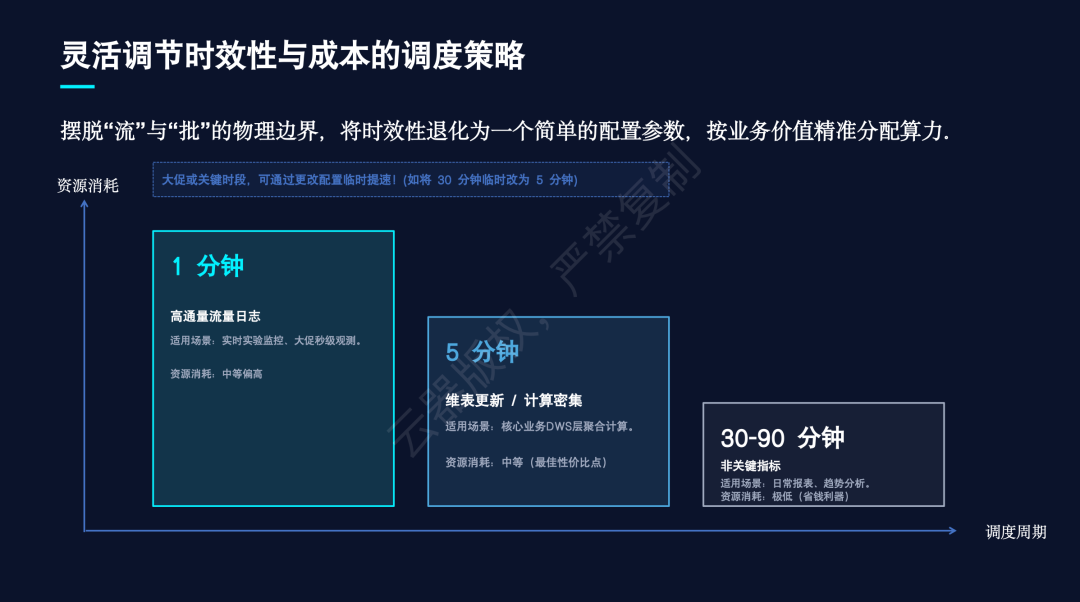
图10|灵活调节时效性与成本的调度策略:1 分钟 / 5 分钟 / 30-90 分钟
按需调节的灵活性。 系统在每次刷新时都会基于代价( Cost-Based )进行动态优化,根据数据变更类型与数据量选择最优执行计划。业务方只需调整调度周期这一个参数,就能在极致实时与极致成本之间平滑游走。
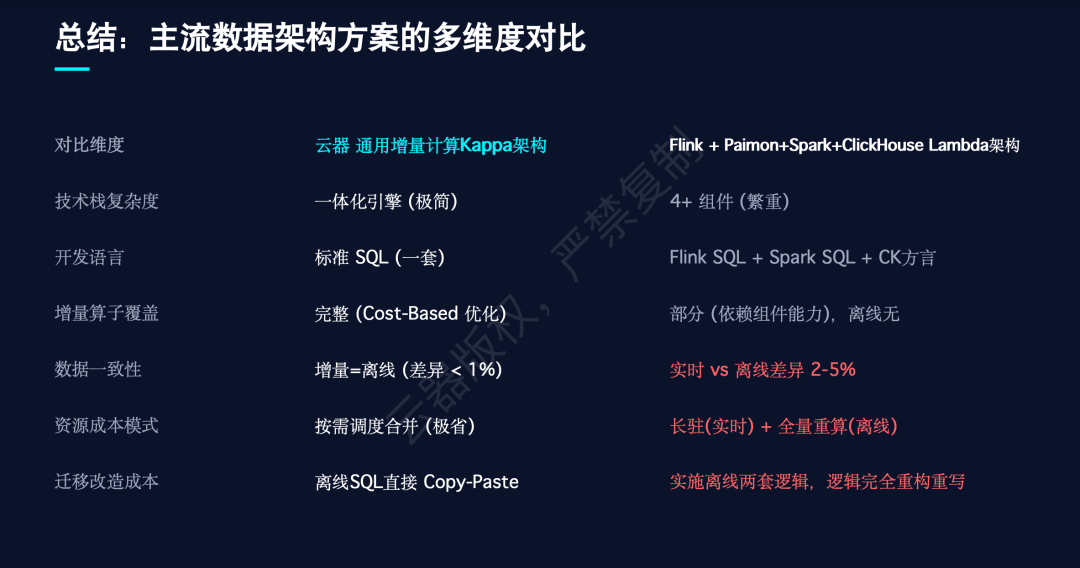
图11|主流数据架构方案多维度对比:Kappa 架构 vs Lambda 架构
相较于传统架构的多组件拼凑,GIC 在技术栈复杂度、开发语言统一性、增量算子覆盖度上均表现出代际优势。
04 快手离线转实时的严苛测试
理论上的优势必须经受住超大规模生产环境的考验。快手数据平台部从线上抽取了日均千亿级数据的真实离线任务,设计了两层验证体系:“能做”(技术可行性)与“做好”(业务收益)。
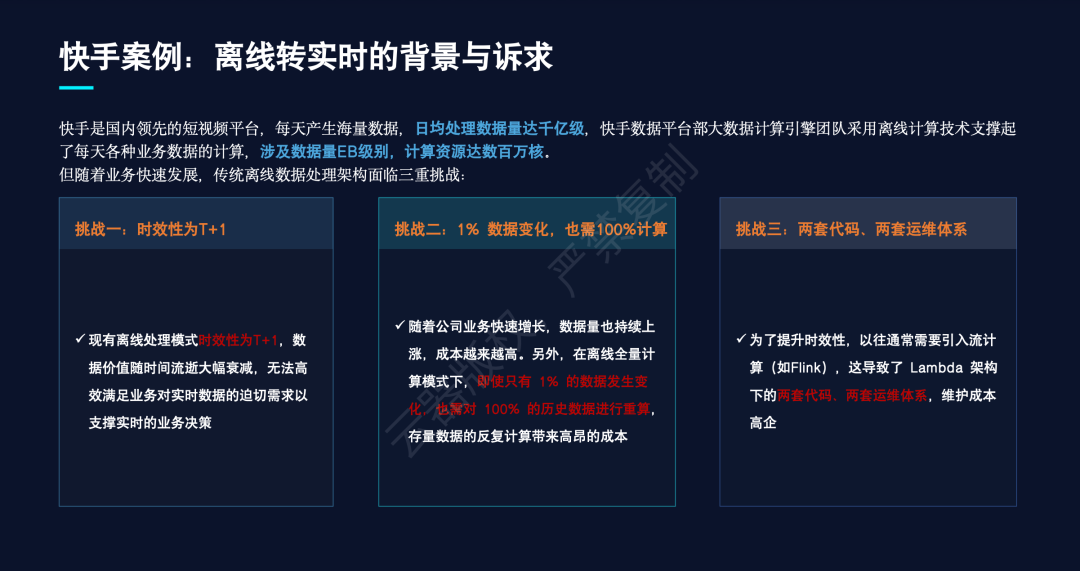
图12|快手案例——离线转实时的背景与三大诉求
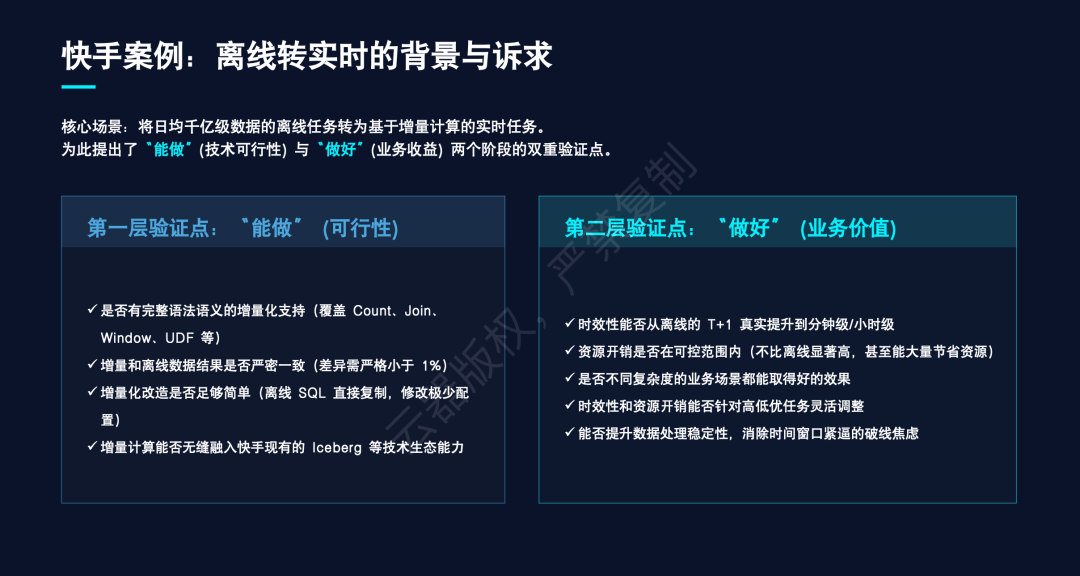
图13|快手案例的两层验证点:「能做」(可行性)与「做好」(业务价值)
在“能做”层面,快手验证了完整语法语义的增量化支持(覆盖 Count、Join、Window、复杂 UDF ),验证了增量结果与离线结果的严密一致性(差异需 < 1%),并确认了离线 SQL 可直接复用,无需重写。在“做好”层面,重点考察时效性是否能从 T+1 跃升至分钟级,以及资源开销是否可控。
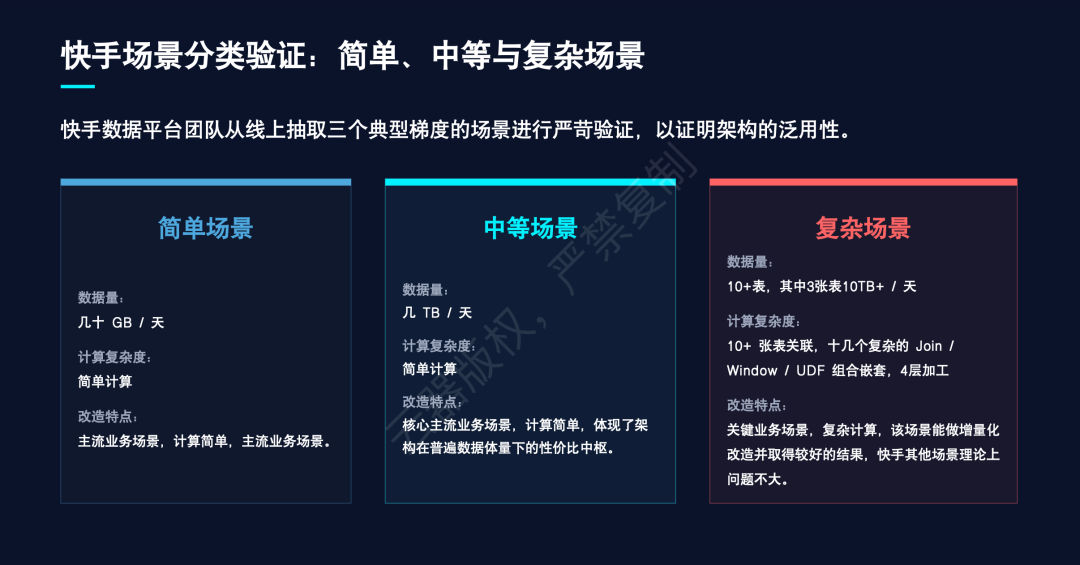
图14|快手场景分类验证——简单、中等与复杂场景的定义
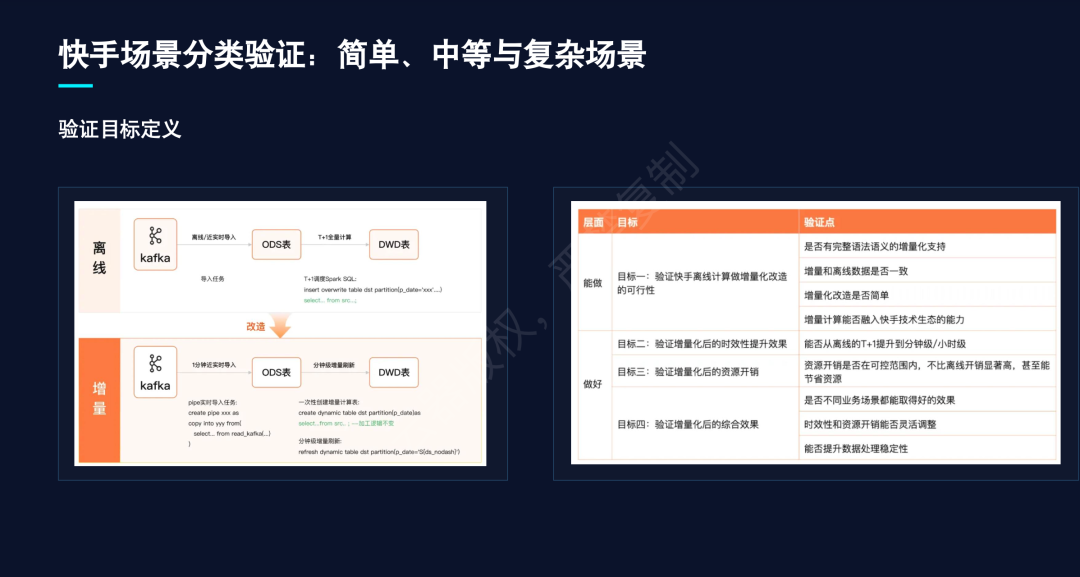
图15|快手场景分类验证——验证目标定义
快手选取了三个梯度场景进行对标:
简单场景(几十 GB/天,计算简单)。时效性从 T+15 分钟提升至 5 分钟,增量计算累计开销仅为离线基准的 1/20。
中等场景(几 TB/天,计算简单)。时效性从 T+1 小时提升至 5 分钟,增量累计开销不到离线的 1/3。
复杂场景(10+ 表关联,涉及 10TB+ 大表、复杂 Join/Window/UDF 嵌套,4 层加工)。时效性从 T+3.5 小时提升至 50 分钟,增量开销基本与离线持平。
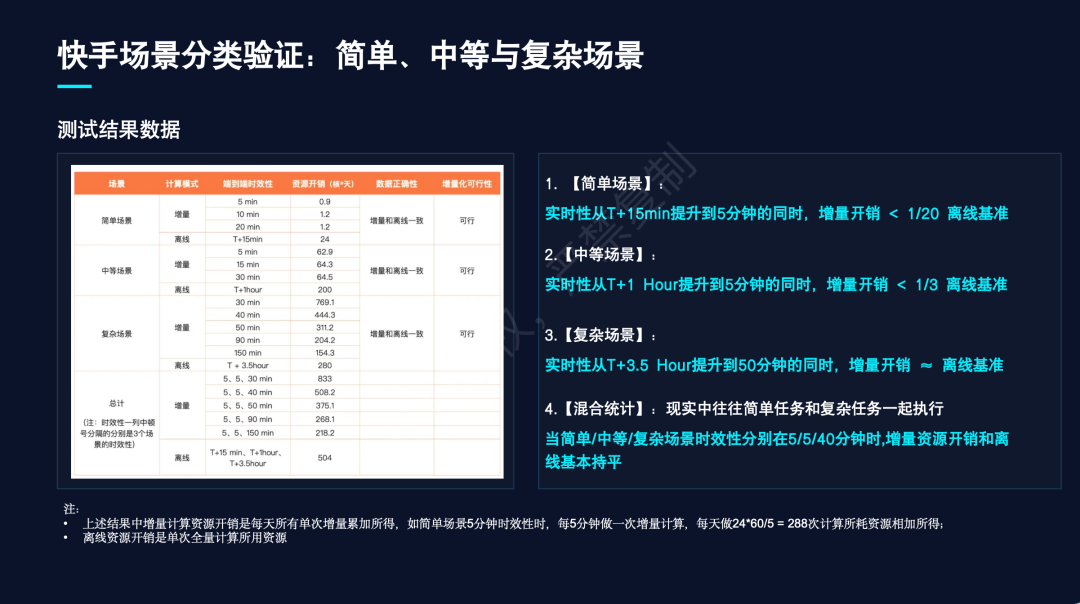
图16|快手场景分类验证——三档场景的测试结果数据
当三个场景混合执行时,简单、中等任务以 5 分钟周期刷新,复杂任务以 40 分钟周期刷新,总增量资源开销与离线基准持平。这意味着,把核心业务从 T+1 提升至近实时的过程中,并没有产生额外的计算成本。
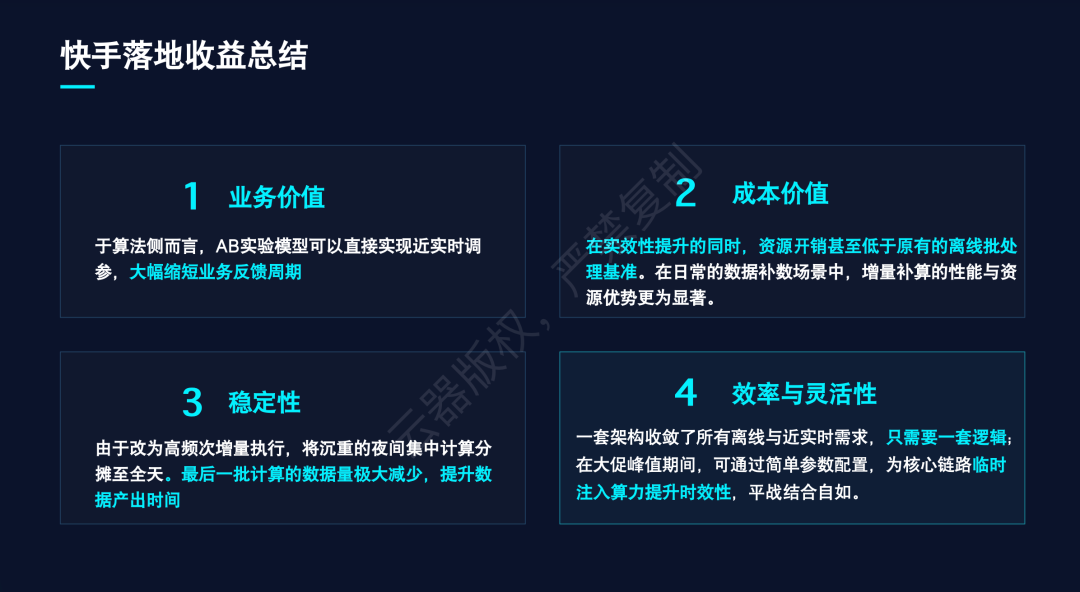
图17|快手落地收益总结——业务价值、成本价值、稳定性、效率与灵活性
快手的最终收益是四重的: 算法 A/B 实验实现近实时调参;时效性提升的同时资源开销低于原离线成本;高频次增量执行将夜间沉重负载分摊至全天,极大缓解了基线破线焦虑;一套架构收敛所有需求,大促时只需调整调度参数即可注入算力。
05 小红书近实时实验指标的架构演进
小红书面临的则是另一类典型困境:其线上千亿级流量日志服务于 A/B 实验场景,原有 Flink + Spark + ClickHouse 的 Lambda 架构中,实时链路为了保时效裁剪了非核心维度,导致与离线数据差异经常大于 5%,业务方无法信任实时数据。此外,大开窗导致的状态膨胀与 Flink 高额成本同样是巨大痛点。
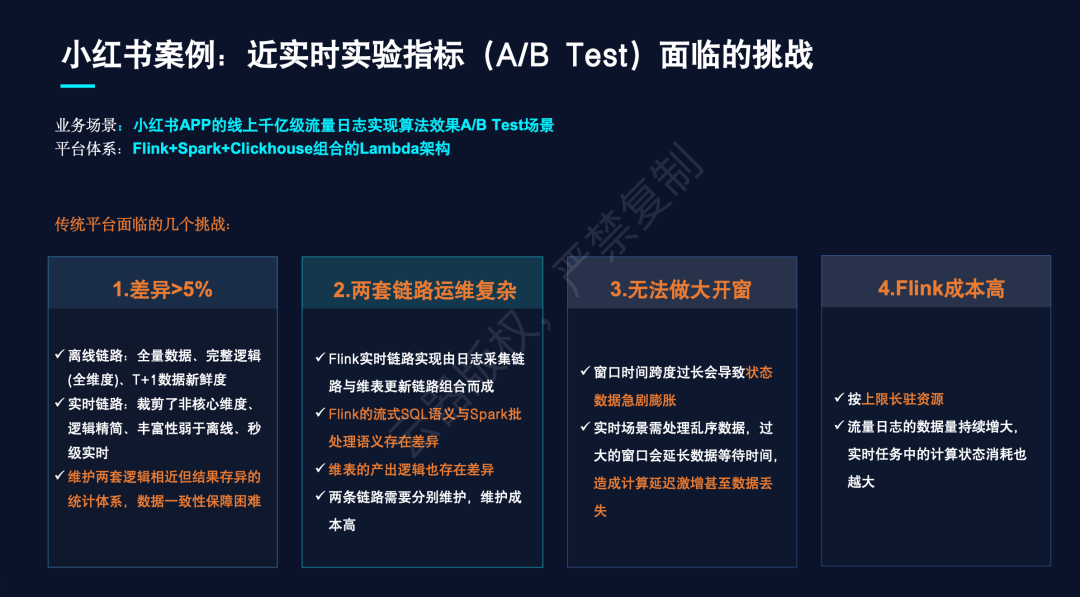
图18|小红书案例——近实时实验指标( A/B Test )面临的四个挑战
小红书最终选择将这套 Lambda 架构整体迁移至基于云器 Lakehouse 的 Kappa 架构。
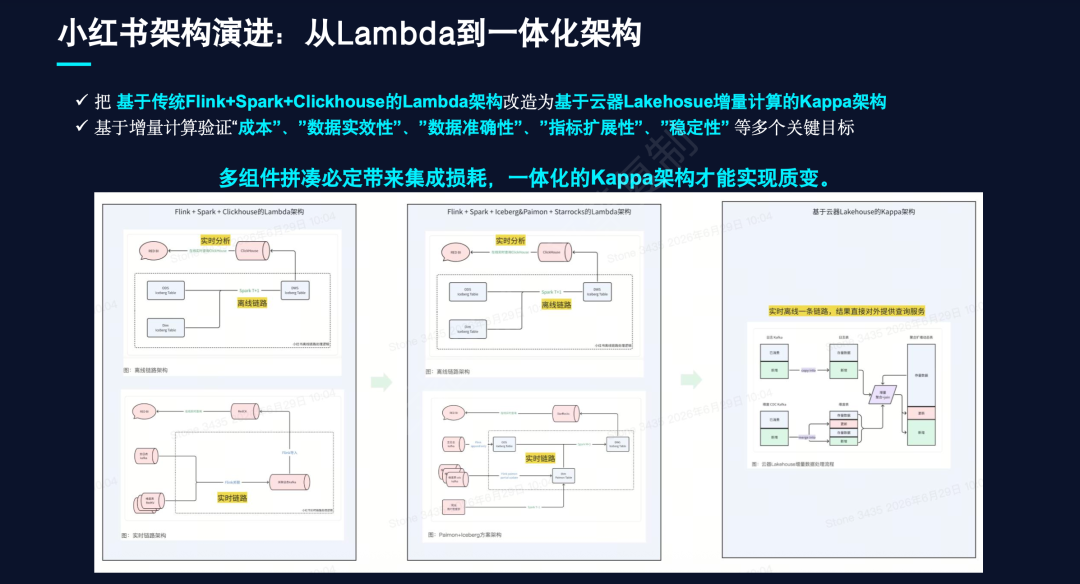
图19|小红书架构演进——从 Lambda 到一体化 Kappa 架构
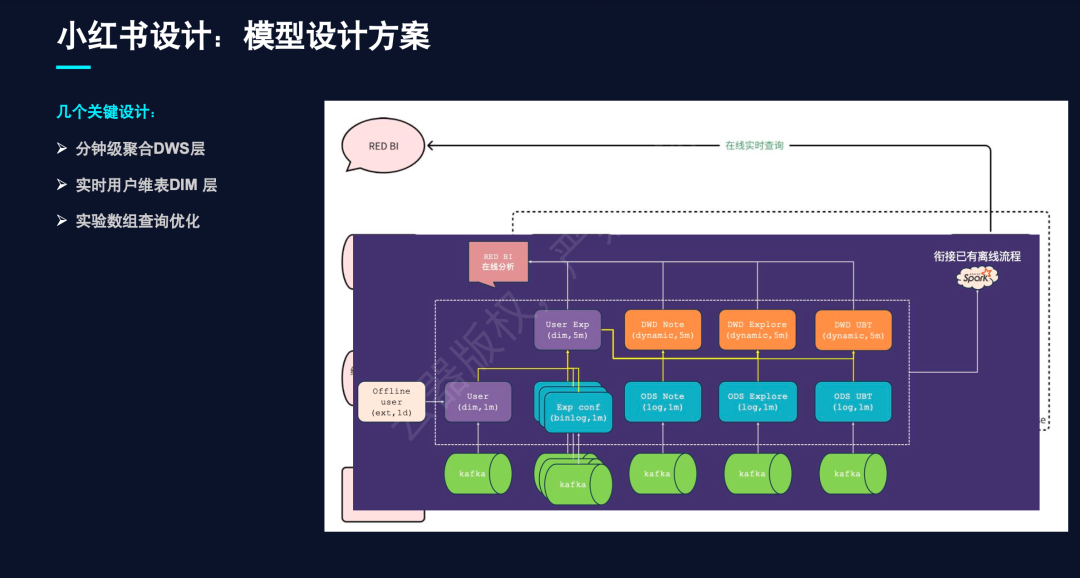
图20|小红书设计——模型设计方案与关键设计点
在增量计算基础之上,关键设计额外包含了三个亮点:
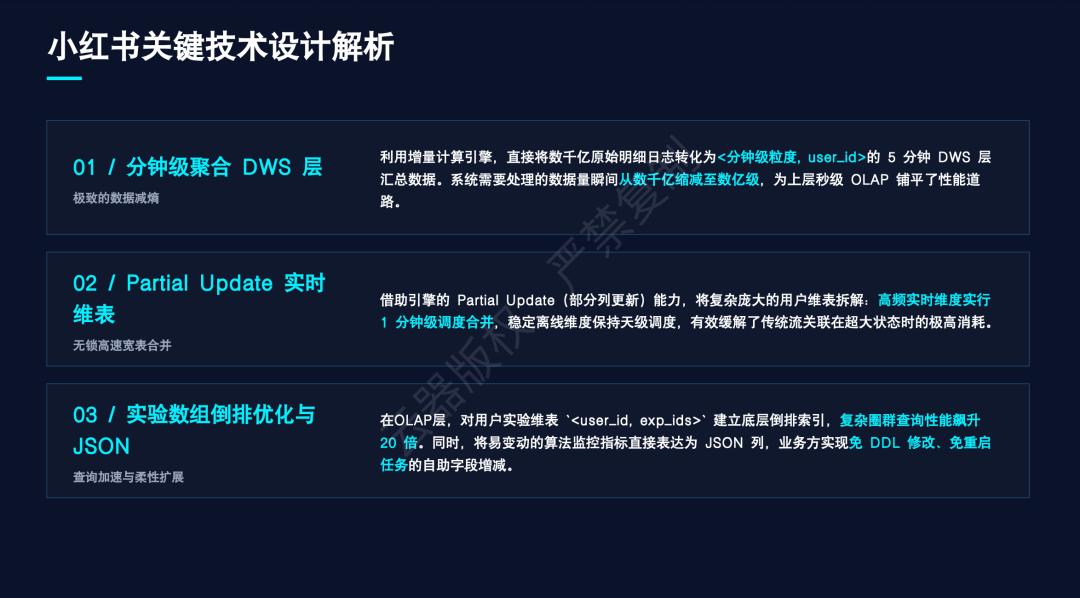
图21|小红书关键技术设计解析——DWS 层、Partial Update 实时维表、数组倒排与 JSON
1. 分钟级聚合 DWS 层。 利用增量计算引擎,直接将数千亿原始明细日志聚合成 5 分钟粒度、带 user_id 的 DWS 层 数据,数据量瞬间缩容至亿级,为上层 OLAP 铺平了性能道路。
2. Partial Update 实时维表。 利用部分列更新能力,将庞大的用户维表拆解为高频实时维度(1 分钟调度)与稳定离线维度(天级调度),极大缓解了传统流关联在超大状态下的内存消耗。
3. 实验数组倒排优化与 JSON 查询加速。 在 OLAP 层对实验维表建立底层 倒排索引,使复杂圈群查询性能飙升 20 倍。同时将易变动的算法监控指标直接表达为 JSON 列,业务方可实现免 DDL、免重启的自助字段增减。
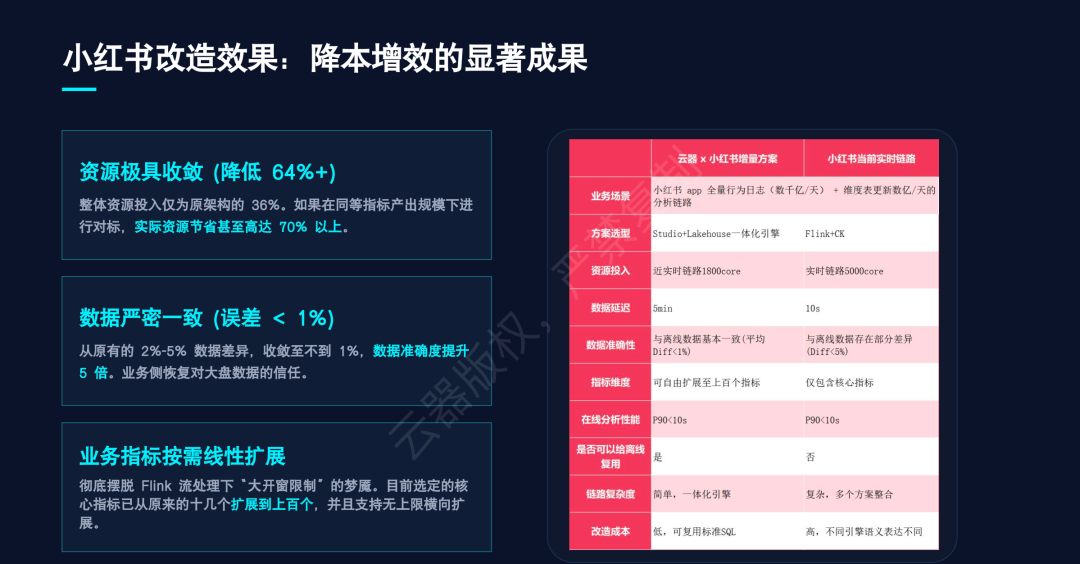
图22|小红书改造效果——降本增效的显著成果
改造效果显著。 资源投入从原实时链路的 5000+ Core 降至 1800 Core(降低 64%+);数据一致性从 2%-5% 的差异收敛至 < 1%;核心指标从十几个扩展到上百个,且无上限横向扩展。整个改造成本极低,全程复用标准 SQL,彻底摆脱了对多种引擎方言的维护负担。
06 从场景甄选到平滑割接
增量计算的落地并非一蹴而就。云器在实践总结中给出了一套可复制的实施路径。
场景优先级划分(P0-P2)。 优先级最高( P0 )的是日志流量与 A/B 实验指标场景,建议采用分钟级( 1-5min )调度,时效性可从 T+1 跃升至分钟级,资源成本硬降 60%+。其次是 P1 场景,如大窗口延迟数据补算与复杂维表高频更新,利用增量精准补算可将重跑耗时从数小时骤降至数分钟。P2 场景则针对日常经营报表,采用宽松调度即可进一步压缩资源。
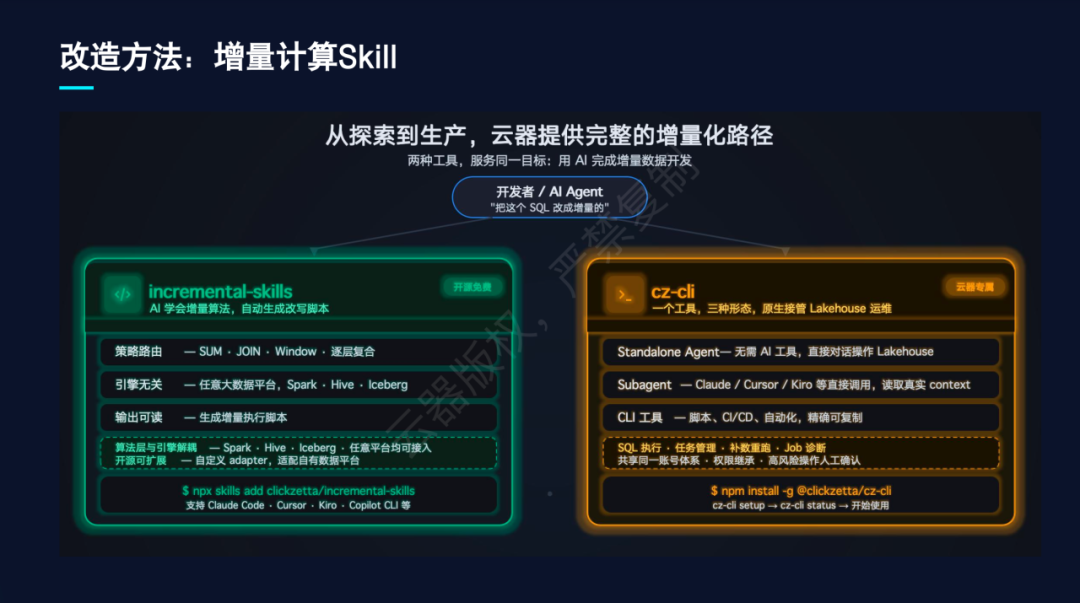
图23|改造方法——增量计算 Skill( incremental-skills 与 cz-cli )
迁移策略与 Skill 辅助。 在迁移方式上,云器提供了结合 AI Agent 的增量计算 Skill,开发者只需输入“把这个 SQL 改成增量的”,系统即可辅助完成转化。在生产切换阶段,建议采用“三步走”原则:精准切入最痛场景 -> 建立增量 vs 离线的自动对账机制(确保差异 < 1%)-> 渐进式双跑流量切换。待老链路与 GIC 旁路并行稳定数周、覆盖完整业务波峰波谷周期后,再执行零感知割接。
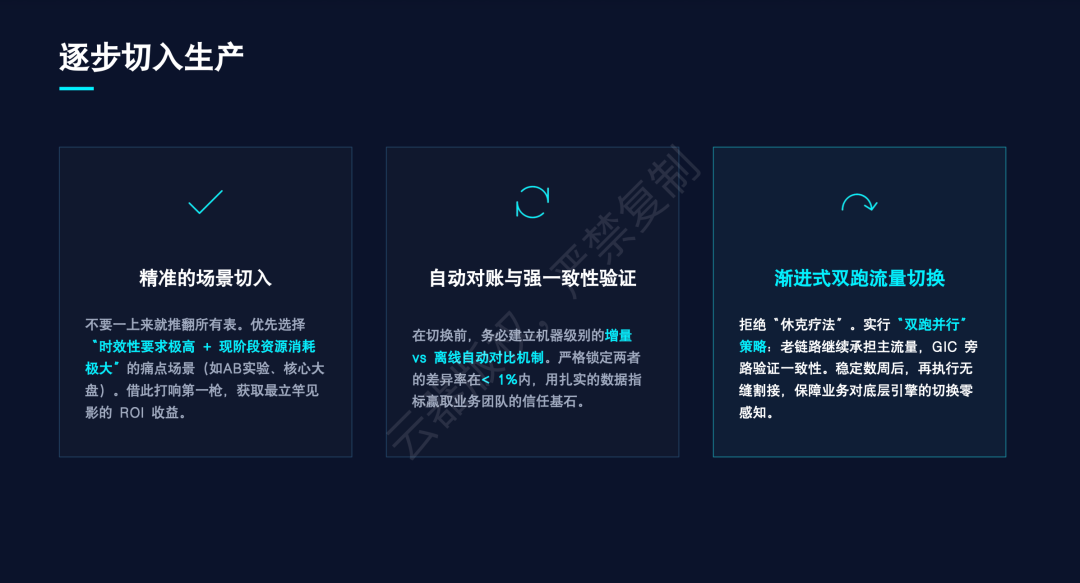
图24|逐步切入生产——精准场景切入、自动对账验证、渐进式双跑切换
07 云器 Lakehouse GIC 价值总结
回顾快手与小红书的实战过程,增量计算带来的价值并非边际改善,而是架构层级的代际跃升。
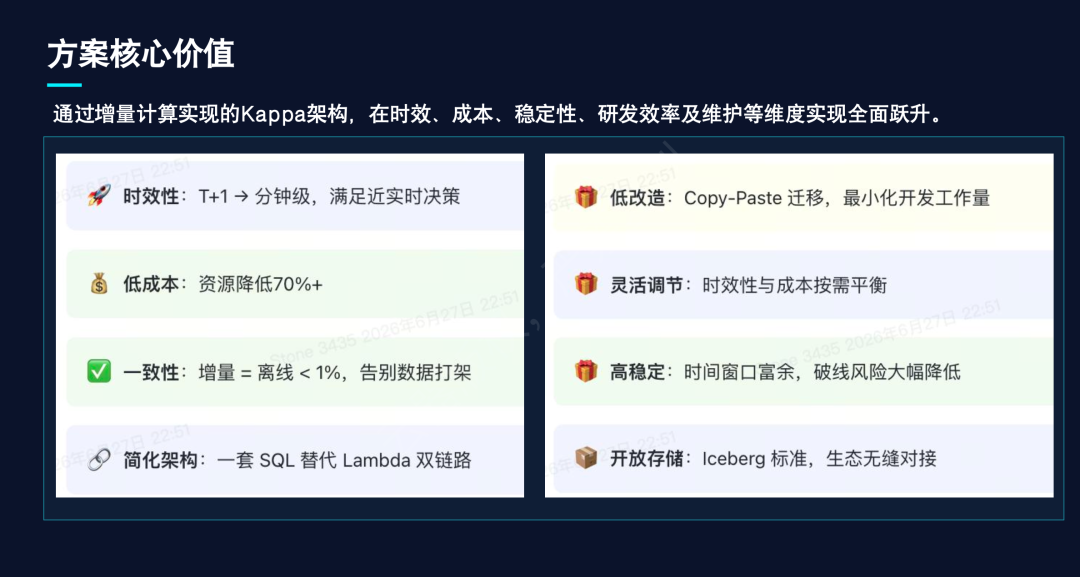
图25|方案核心价值——时效性、低成本、一致性、简化架构等八个维度
它实现了时效性的跨越( T+1 → 分钟级),满足了近实时决策需求;资源成本大幅降低(降低 70%+);数据一致性得到了切实保障(增量 = 离线,差异 < 1%)。 更重要的是,它用一套 SQL 替代了 Lambda 双链路,将开发工作量降到极低,同时允许业务方像调节音量一样,通过调度参数灵活平衡时效性与成本。
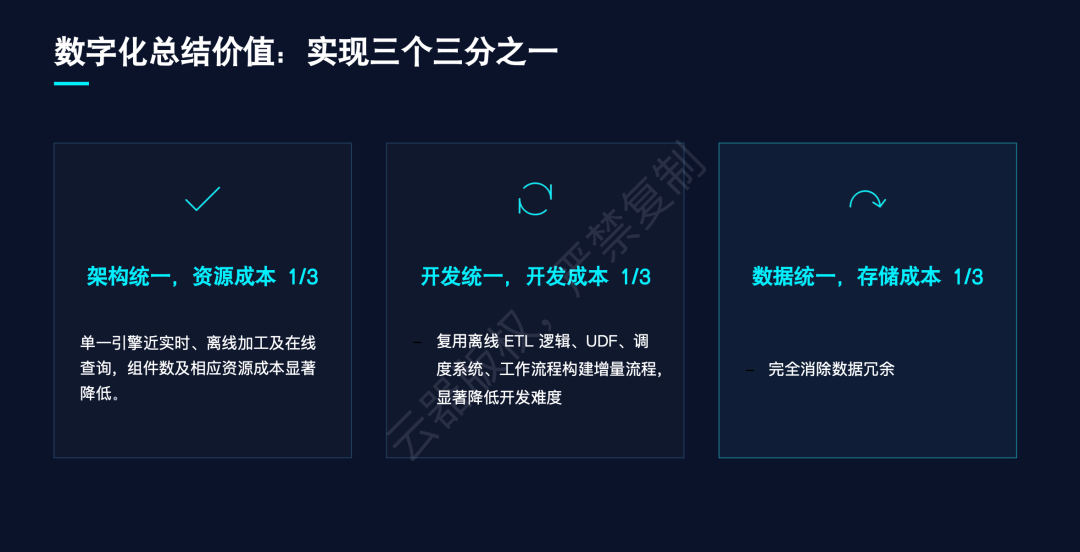
图26|数字化总结价值——实现三个「三分之一」
如果要抽象地浓缩这场变革——资源成本降低为原来的三分之一,开发运维成本降低为原来的三分之一,存储成本(因去重与高效压缩)同样降低为原来的三分之一。 在数据量持续暴涨的时代,三个“三分之一”的降本增效,或许正是增量计算获得快手与小红书共同选择的核心原因。
 发表于 2 小时前
|
查看: 2|
回复: 0


