凌晨两点十七分,手机连震三下。
钉钉群里开始刷 @全体成员,监控告警红成一片:订单服务全部超时,网关 502。
你爬起来开电脑,发现所有订单实例的支付超时时间,从 3000 毫秒被改成了 3 毫秒。不是 3 秒,是 3 毫秒。
运营同学半夜想改文案里的一个小参数,手一抖少打了两个零。这条配置 0.8 秒就推到了全集群 47 个实例,没有审批,没有灰度。等你想回滚,发现历史版本只存了最近 3 条——而运营今晚已经改了 5 次。
这种事故不是个例。Cloudflare 曾因一条全局配置变更,造成过全球级服务中断,28% 的 HTTP 流量受影响,The Pragmatic Engineer 专门复盘过。国内也有团队踩过类似的坑:线程池参数改错,直接触发级联雪崩。
问题的核心不在于“运营不该改配置”。配置当然要能动态改,不然每次改个参数都发版,半夜上线谁也受不了。
问题在于:配置从改完到全集群生效,这中间到底发生了什么?
配置变了,服务怎么知道
先说一个很多人答不上来的问题。
你在 Nacos(或者 Apollo、Consul、Spring Cloud Config)后台改了一条配置,点了“发布”。然后呢?服务怎么知道配置变了?
很多人的第一反应是“推送”——服务端把新配置推给所有客户端。听起来很合理。但仔细想,服务实例有 47 个,Nacos 服务端怎么知道这 47 个实例的地址?它又不是你的注册中心——
等等,Nacos 确实也做注册中心。但配置中心和注册中心是两码事。配置中心的职责是“存配置 + 通知变更”,通知的前提是知道有哪些客户端在监听。
那客户端是怎么告诉服务端“我在听”的?
答案是 长轮询。
长轮询:假装是推送的轮询
想象你去餐厅点完餐,有三种等法。
第一种,每 30 秒跑到前台问一次“我的餐好了没”。前台每次都得回应你——好了或者没好。这叫短轮询。简单,但费腿、费带宽;47 个实例同时每 30 秒问一次,服务端压力不小。
第二种,你留个手机号给前台,让他们做好了打给你。这叫推送。体验好,但需要维护手机号列表,也就是长连接,前后端都得支持 WebSocket 或类似的持久连接。
第三种:你站在前台不走,跟服务员说“我就在这儿等,30 分钟内好了直接给我,30 分钟没好我再回去拿”。你占着服务员一个位置,但不用反复跑。如果 10 分钟内菜好了,服务员直接递给你;如果 30 分钟没好,你回去一趟再来站着。
这就是长轮询。
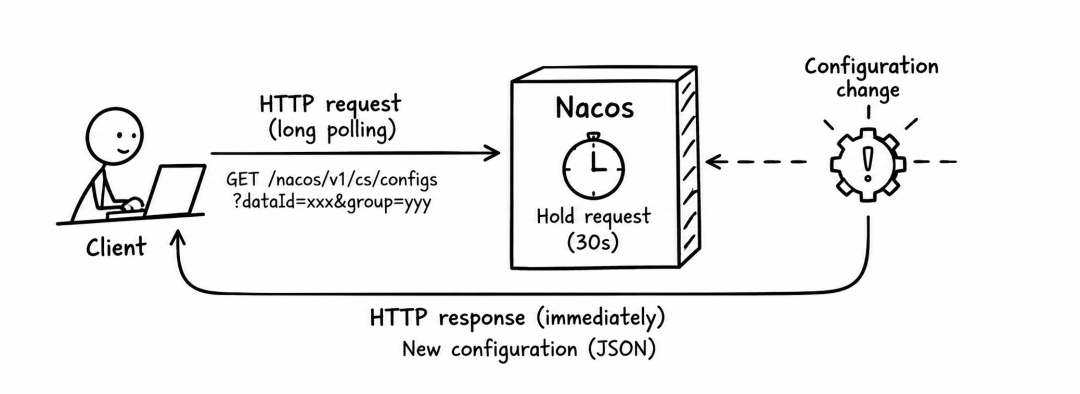
Nacos 客户端发一个 HTTP 请求到服务端,说“我监听 order-service.yaml 这个配置文件,当前 MD5 是 abc123。如果这个文件的 MD5 变了,立刻告诉我;如果没变,你先 hold 住这个请求,最多 30 秒”。
服务端收到请求后,检查配置的 MD5。如果跟客户端报的一样,就不立刻返回,而是把这个请求挂起(hold)在一个队列里。30 秒内如果有人改了配置,服务端立刻把新配置塞进这个请求的 response 里返回;如果 30 秒都没人改,服务端返回一个空结果(“没变”),客户端收到后立刻再发下一个请求。
所以你看到的链路是:
运营点“发布” → Nacos 服务端检测到 MD5 变化 → 遍历 hold 住的请求队列 → 找到监听这个配置的客户端请求 → 塞入新配置返回 → 客户端收到后触发回调函数 → 0.8 秒内全集群生效。
这个设计最妙的地方在于:它走的是 HTTP 协议,不需要 WebSocket、不需要维护长连接,穿透防火墙毫无压力。客户端只是一个普通的 HTTP 请求,只不过服务端 hold 住了 response,不立刻返回而已。
面试常问“配置中心怎么实现实时通知”,很多人张口就说“WebSocket 推送”。不对,至少 Nacos 不是。Nacos 用的是长轮询 + MD5 比对。Apollo 也类似,只是实现细节不同:Apollo 的长轮询是客户端连到 Config Service,通过 /notifications/v2 接口做长轮询。
MD5 校验:为什么不是直接推配置
你可能会问:既然服务端已经知道配置变了,为什么不直接把新配置推下去,还要做 MD5 比对?
因为网络不可靠。
假设客户端因为 GC 停顿了 200 毫秒,这期间服务端把变更推过去了——推到哪?客户端的 HTTP 请求已经超时断开,变更通知丢了。
MD5 比对是一个兜底机制。客户端每次发起长轮询请求时,都带上自己手里的配置 MD5。服务端比对:你的 MD5 跟我的一样吗?一样,说明你是最新的,我 hold 住你的请求等变更;不一样,说明你的配置过期了,可能重启过,也可能错过了上一次推送,我立刻把新配置返回给你。
这就保证了:就算你错过了推送,下一次轮询时也会自动修正。
这个思路跟消息队列里的“至少一次”语义(At-Least-Once)一样:不怕丢,怕的是丢了还不知道。MD5 就是那个“知不知道”的锚点。
那晚的真正问题
回到开头那个事故。
长轮询没问题,MD5 校验没问题,0.8 秒全集群生效也没问题——这恰恰是 Nacos 的卖点。问题出在更上面一层:没有任何防线挡在“运营改配置”和“配置生效”之间。
一条配置从修改到生效,理想情况下至少应该经过这些环节:
- 权限控制:谁能改什么配置。运营只能改文案类配置;超时时间、线程池大小这类技术参数,只有研发能改。
- 审批流:高危配置变更需要第二双眼睛(second pair of eyes),哪怕只是一个确认按钮。
- 灰度发布:先推到 1 个实例,观察 30 秒没问题,再推到剩余 46 个。
- 版本回滚:一键回滚到上一个版本,而不是翻历史记录手动 copy。
- 变更审计:谁在几点改了什么,留下记录。
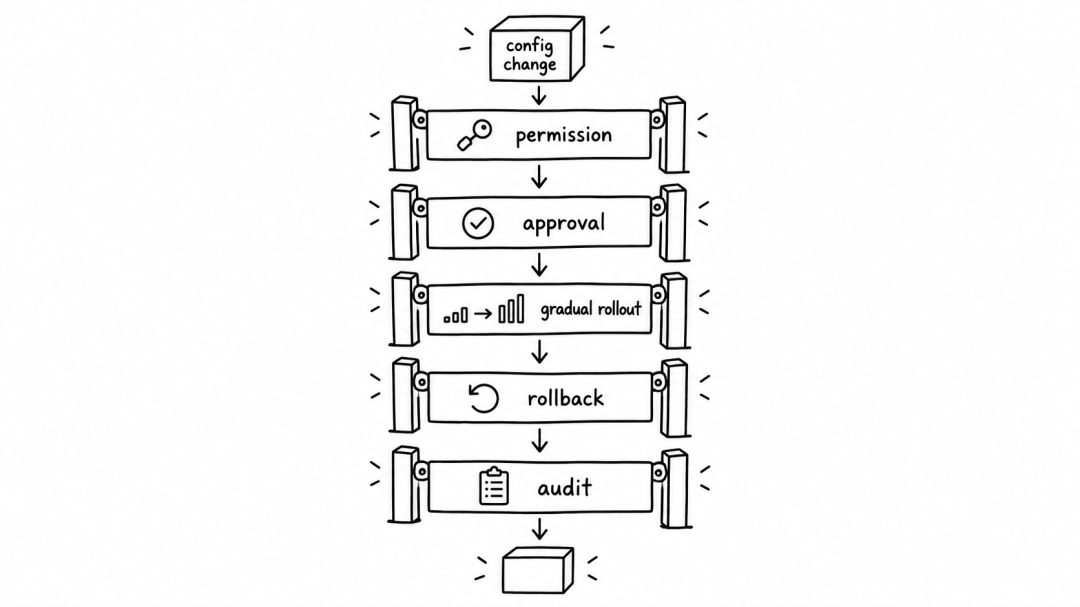
那天晚上,这五层一个都没有。运营同学有完整的配置编辑权限,包括技术参数;改完直接发布到全集群;历史版本只存 3 条;没有任何灰度策略。
说白了,配置中心的实时推送能力太强了,强到一旦配错就没有任何缓冲。这就像给车装了一台 0 到 100 只要 2 秒的引擎,却没装刹车——跑得快,不代表安全。
掘金上有个开源项目 nacos-web-config,作者出发点就是“运营半夜改条配置不想发版”。思路没错,但这类工具最该做的不是让改配置更方便,而是让改配置更 安全。
面试速记卡
把这篇文章浓缩成几条,面试时能直接说:
配置中心如何实现实时通知?
- Nacos / Apollo 用的是 长轮询,不是 WebSocket 推送
- 客户端发 HTTP 请求,服务端 hold 住最多 30 秒,有变更立刻返回
- 客户端比对配置 MD5,不同才拉取全量配置
长轮询 vs 短轮询 vs 推送?
- 短轮询:客户端定时请求,费带宽,延迟取决于轮询间隔
- 长轮询:请求 hold 住,准实时,走 HTTP 协议,不需要 WebSocket
- 推送(WebSocket/SSE):最实时,但需要维护长连接,穿透防火墙有风险
配置变更的防护机制?
- 权限分级:技术参数 vs 业务参数,不同角色不同权限
- 灰度发布:先 1 个实例验证,再全量推送
- 版本回滚:一键回滚 + 足够的历史版本保留
- 变更审计:谁在什么时间改了什么,可追溯
面试追问:Nacos 集群间配置怎么同步?
那天晚上我们花了 12 分钟手动回滚。12 分钟,47 个实例,每个实例都要 SSH 进去重启,因为当时的配置中心没有一键回滚。
后来我们做了一件事:在配置中心前面加了一层网关,所有高危配置变更必须走灰度发布流程,先推 1 个实例观察 30 秒。
再后来,运营再也没在半夜改过配置。
倒不是因为系统拦住了她,而是我们给她单独开了一个“文案配置”的权限组,技术参数她根本看不见了。
有时候最好的技术方案,就是让人碰不到不该碰的东西。
 发表于 15 小时前
|
查看: 1|
回复: 0


