10 月 7 日的 scheduler-mc 上,John Stultz 和 Suleiman 介绍了 proxy exec 向用户态延伸的工作——支持 FUTEX【1】。
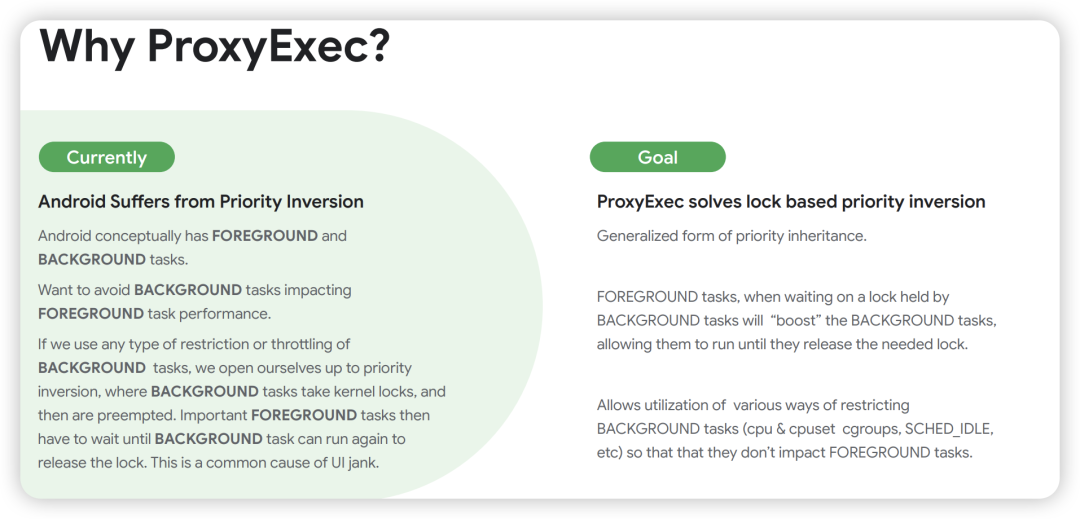
在典型的 Android 场景中,我们并不希望后台任务阻塞前台任务。因此,当后台任务可能挡住前台任务时,可以让后台任务借用前台任务的 CPU 时间来执行,从而避免 UI jank。
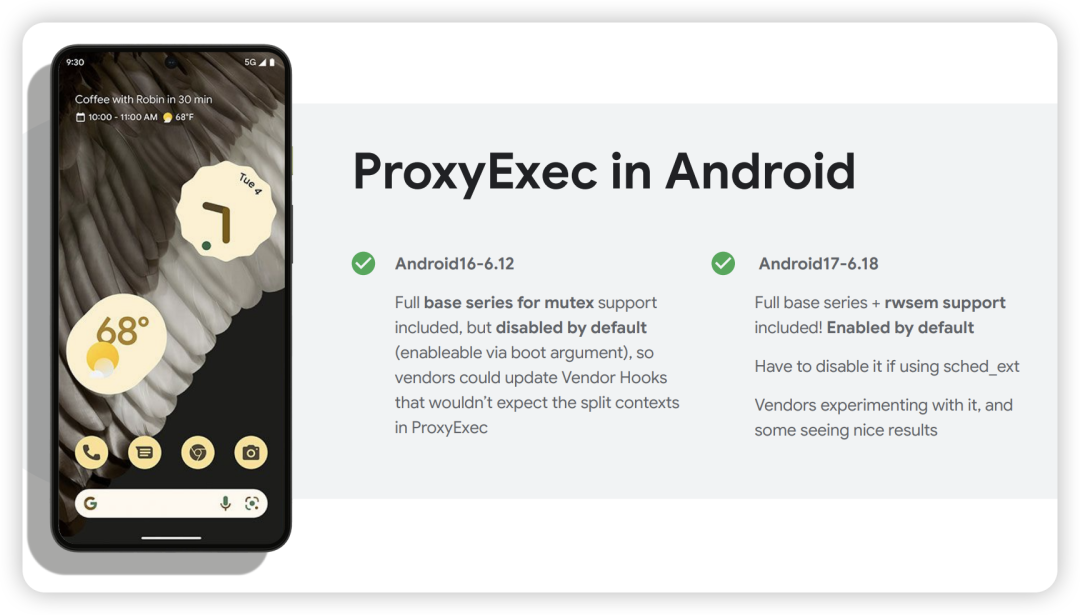
目前 proxy exec 在 Android 上的支持情况是:Android 16 基于 6.12,已经支持 mutex;Android 17 基于 6.18,支持 mutex 和 rwsem,但和 sched_ext 不兼容。
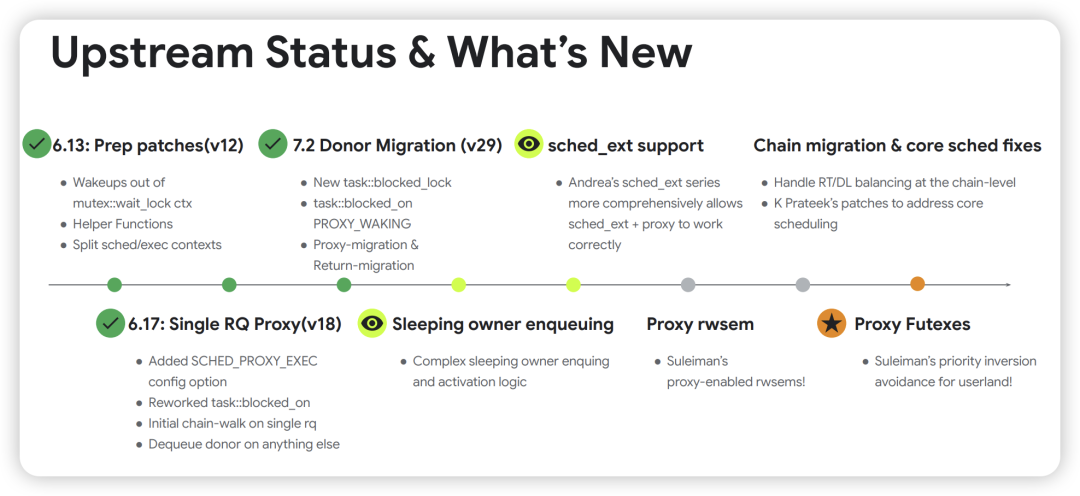
当然,上游开发仍在火热推进中,主要参与者包括 Andrea、Suleiman 和 John:
10 月 7 日的分享则主要聚焦于 FUTEX,试图解决 proxy exec 目前还不能直接服务用户态的问题:
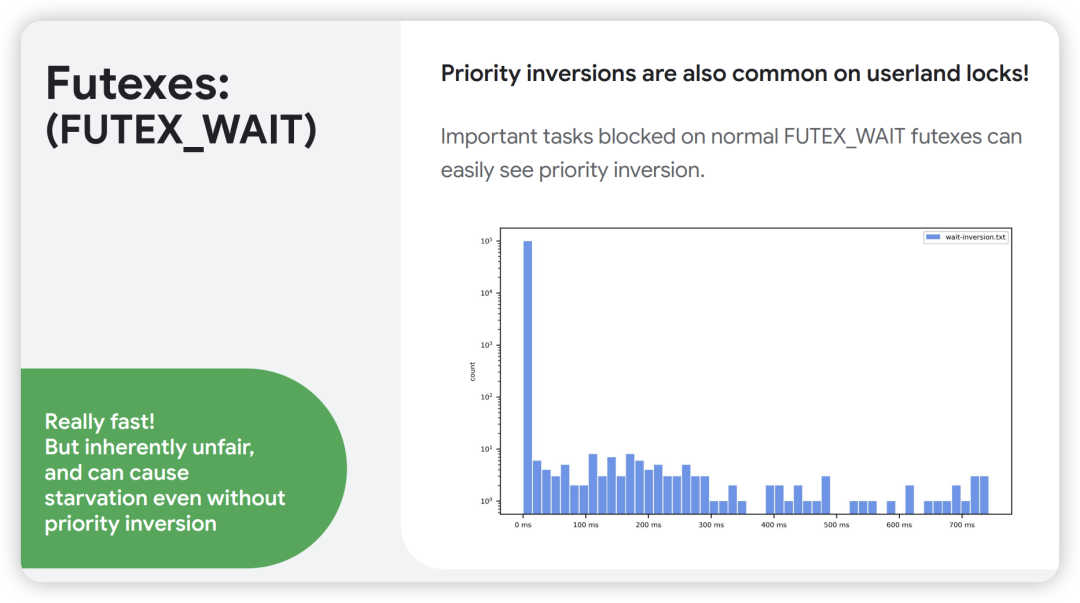
用户态任务的优先级翻转同样很普遍。典型情况是,任务阻塞在 FUTEX_WAIT 上面:
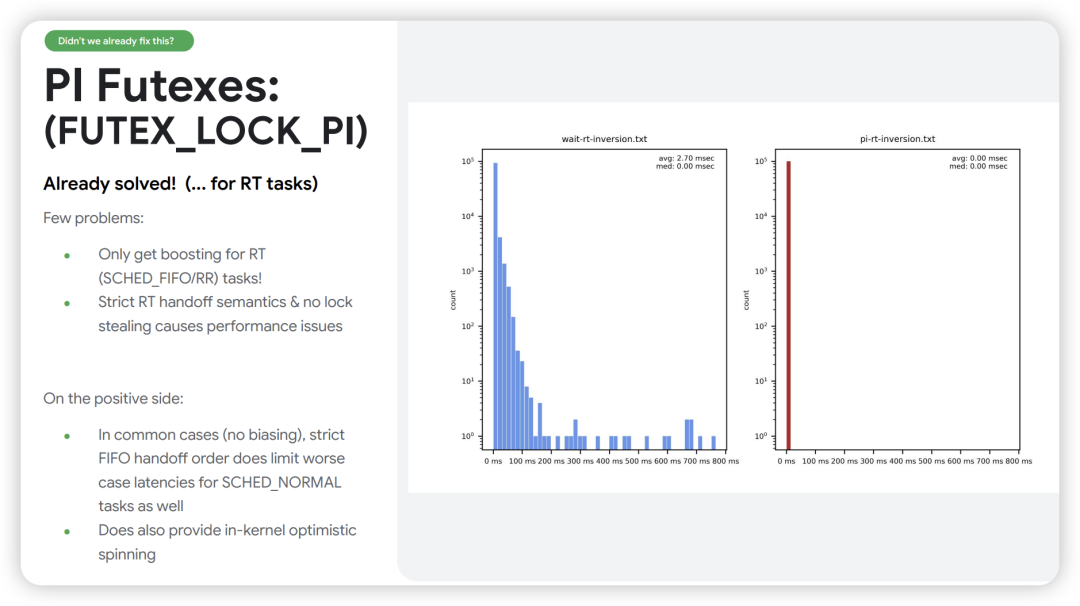
而当前 Linux 内核针对 RT 任务(SCHED_FIFO/RR 调度策略),已经支持 FUTEX_LOCK_PI:
不过,FUTEX_LOCK_PI 这种面向 RT 任务的 FIFO 机制,如果放到公平调度的 SCHED_NORMAL 任务上,反而会产生反作用。问题主要体现在两方面:FIFO 顺序对 SCHED_NORMAL 并不友好,以及 PI 不支持偷锁。
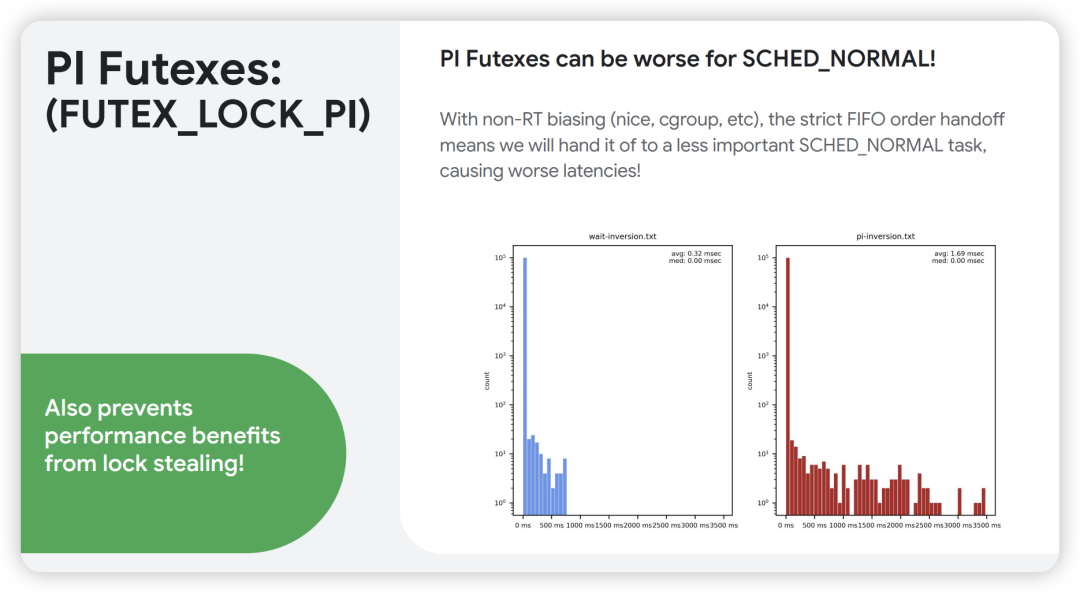
假设锁队列里按顺序排着:任务 A(后台,低权重)-> 任务 B(前台,高权重)。当当前持锁者释放锁时,LOCK_PI 强制把锁交接给排在最前面的任务 A。然而在 SCHED_NORMAL 调度下,任务 A 的 CPU 配额极低。它拿到锁之后,由于没有像 Proxy Exec 那样直接借用时间片的机制,只能靠自己的微弱 CPU 配额慢慢跑。排在后面的高优先级前台任务 B 就被卡住了,只能等任务 A 慢慢执行完毕。
同时,LOCK_PI 为了维持严格的 RT FIFO 顺序,不允许用户态偷锁。哪怕任务 B 此时正占着 CPU,完全可以瞬间完成临界区,它也必须陷入内核、被强行挂起,等待内核把锁按顺序“递”给前面的任务 A 等。这会直接带来频繁的内核上下文切换和更长的排队延迟。
为此,proxy exec 的 FUTEX 支持提出了 FUTEX_LOCK_PING 的概念。它的核心思想是:在用户态保留高效率的偷锁机制,同时在内核态引入基于 Proxy Execution 的优先级提升机制。
这里要先说明一下,PING 是 PI-NG(Priority Inheritance - Next Generation,下一代优先级继承)的缩写,并不是网络里的那个 ping 命令。
基于 PING 的用户态 futex_lock() 和 futex_unlock() 核心代码如下:
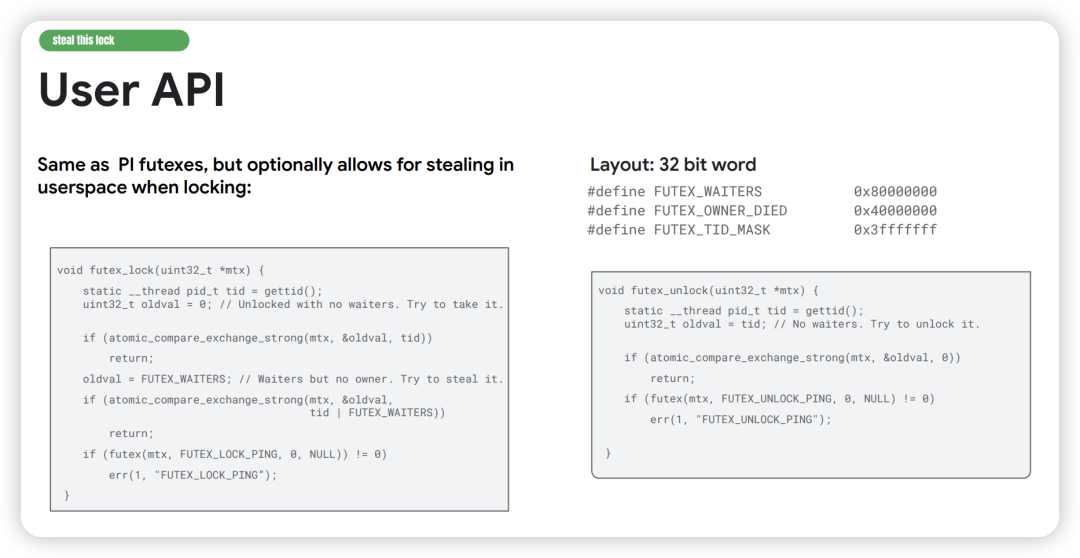
1. 用户态内存布局与标记位
锁变量在用户态仍然是一个 32 位的整型(uint32_t):
#define FUTEX_WAITERS    0x80000000 // 是否有等待者
#define FUTEX_OWNER_DIED 0x40000000 // 所有者退出
#define FUTEX_TID_MASK   0x3fffffff // 锁持有者的 TID
布局如下:
31              30              29                        0
+----------------+----------------+----------------------+
| FUTEX_WAITERS | FUTEX_OWNER_DIED |    FUTEX_TID_MASK    |
|   (1 bit)     |   (1 bit)        |     (30 bits)        |
+----------------+----------------+----------------------+
其中:
FUTEX_TID_MASK (0x3fffffff):低 30 位用来存放锁持有者的 TID。FUTEX_WAITERS (0x80000000):最高位标志位,表示当前有等待线程在内核中阻塞,或正在自旋。FUTEX_OWNER_DIED (0x40000000):标记所有者已经退出。
在 futex_lock 的具体操作中,用户态会写入 owner 的 TID。对于 FUTEX_LOCK_PING 以及内核中类似的 PI/PING Futex 设计来说,“在用户态把当前线程的 TID 写入 futex 锁变量”是整个机制非常关键的一步。
2. 用户态 API 与抢锁、释放逻辑
FUTEX_LOCK_PING 允许在用户态“偷锁”。下面先看加锁实现:
void futex_lock(uint32_t *mtx)
{
    static __thread pid_t tid = gettid(); /* 每个线程缓存自己的 TID */
    uint32_t oldval = 0;

    /*
     * 阶段 1:无竞争抢锁(Fast Path)
     * 期望锁变量为 0(无 Owner、无 Waiters)。
     * 成功:将锁变量原子更新为当前 tid。
     */
    if (atomic_compare_exchange_strong(mtx, &oldval, tid))
        return; /* 加锁成功,完全在用户态完成,无需系统调用 */

    /*
     * 阶段 2:用户态偷锁(Lock Stealing / Slow Fast-Path)
     * 期望锁变量为 FUTEX_WAITERS,即上一个 Owner 释放锁时
     * 清掉了 TID,但保留了 FUTEX_WAITERS 标志位。
     * 成功:将锁变量更新为 (tid | FUTEX_WAITERS)。
     */
    oldval = FUTEX_WAITERS;
    if (atomic_compare_exchange_strong(mtx, &oldval, tid | FUTEX_WAITERS))
        return; /* 偷锁成功,仍然不需要进内核 */

    /*
     * 阶段 3:争抢失败,进入内核(Slow Path)
     * 锁正被其他线程持有,锁变量中包含别人的 TID,必须陷入内核。
     */
    if (futex(mtx, FUTEX_LOCK_PING, 0, NULL) != 0)
        err(1, "FUTEX_LOCK_PING");
}
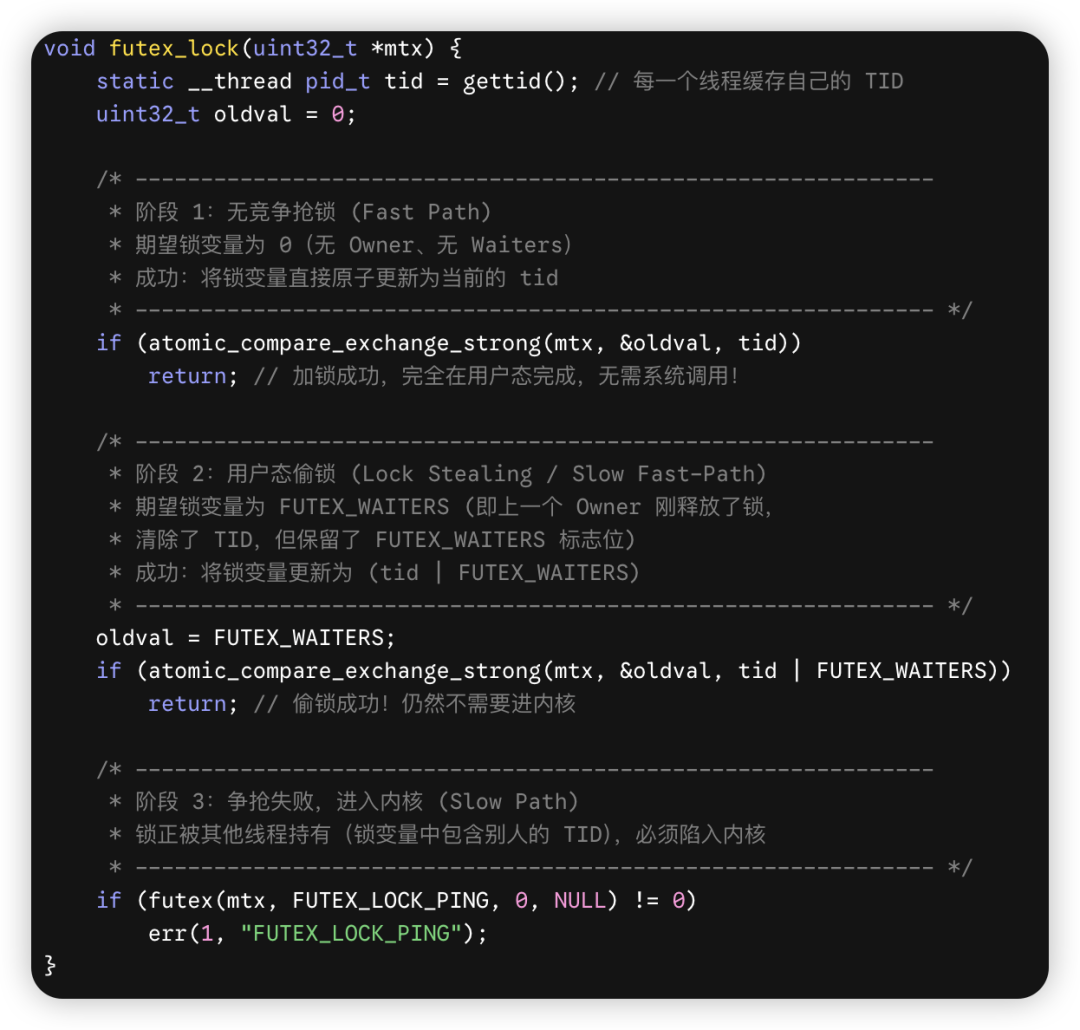
加锁过程可以拆成三个阶段:
阶段 1:Fast Path,纯写 TID
锁值为 0。当前线程 A(TID=1001)调用 CAS:0 -> 1001。锁变量变成 1001,线程 A 成功拿到锁,直接返回。
阶段 2:偷锁,写 TID | WAITERS
假设之前已经存在 Waiter,上一个 Owner 释放锁后,锁值被更新为 FUTEX_WAITERS(0x80000000)。此时新来的线程 B(TID=1002)恰好执行加锁,发起 CAS:0x80000000 -> (1002 | 0x80000000)。
结果是线程 B 抢锁成功,把自己的 TID 写入锁变量,同时保留 FUTEX_WAITERS 标志位,通知内核后续处理,全程不需要进内核打断执行。
阶段 3:进入内核
如果锁变量里已经保存了线程 A 的 TID,例如 1001,那么 CAS 失败,线程 B 就带着这个锁变量陷入内核系统调用。
当高优先级线程 B(TID=1002)在用户态抢锁失败,发起 futex(mtx, FUTEX_LOCK_PING, ...) 陷入内核时,内核会利用用户态写入的 TID 执行以下流程:
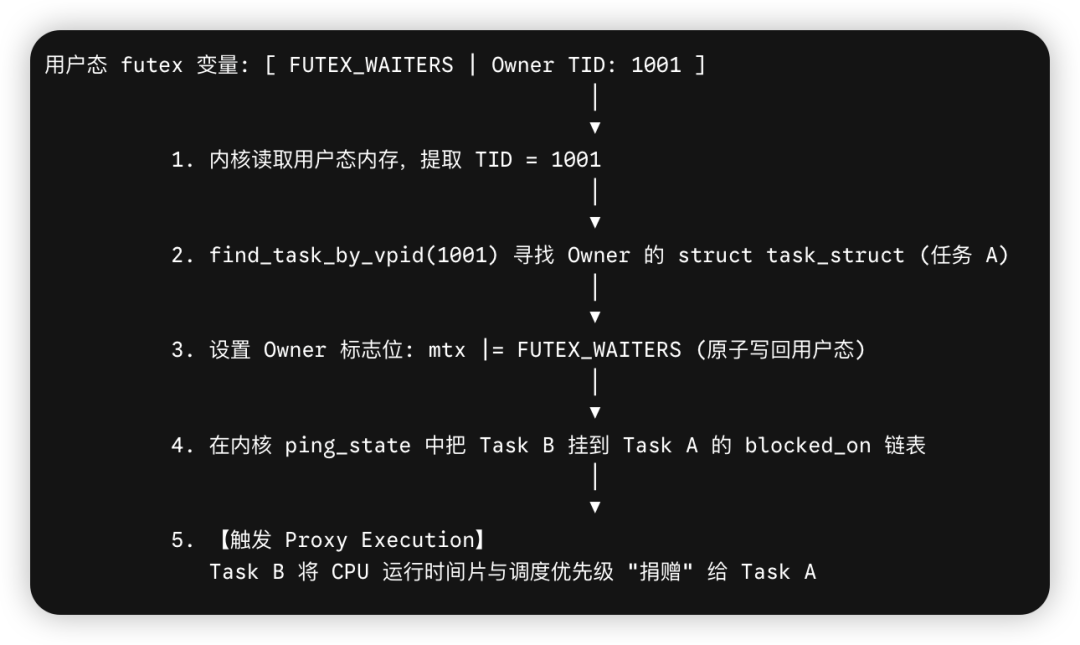
Proxy Exec 在 FUTEX_LOCK_PING 中的具体步骤
确定 Target,寻找 Owner
内核读取锁变量内容,通过低 30 位得到 owner_tid = 1001。接着通过 find_task_by_vpid(owner_tid) 在内核中精确找到持锁线程 A 的 task_struct。
标记 FUTEX_WAITERS
内核会确保用户态锁变量的最高位 FUTEX_WAITERS 被置位。如果用户态还没有置位,就由内核补上。这样线程 A 在执行 futex_unlock 时,就能知道用户态有 Waiter,或内核中存在挂起的等待者,从而强制进入内核调用 FUTEX_UNLOCK_PING,而不是直接在用户态把 TID 清掉。
建立 Proxy Exec 捐赠关系
高优先级等待线程 B 作为 Donor,把自己的 blocked_on 指针指向线程 A(Target)。
调度器随后会进行改写:当调度器在 pick_next_task 中原本抽中了高优先级线程 B 时,发现 B 处于 blocked_on 状态并且已经捐赠了时间片,就会顺着 B 的 blocked_on 找到线程 A,直接把 CPU 调度给线程 A 去运行。
这样就能解决优先级反转:即便线程 A 是一个低优先级后台任务,例如 SCHED_IDLE,或受限于某些 cgroup 配额,它也能借到线程 B 的高优先级配额,快速跑完临界区并释放锁。
解锁时的 TID 清理
解锁过程与 TID 写入互为逆过程:
void futex_unlock(uint32_t *mtx)
{
    static __thread pid_t tid = gettid();
    uint32_t oldval = tid;

    /* 1. 无 Waiter 的快速解锁:如果锁变量就是自己的 tid,尝试清为 0。 */
    if (atomic_compare_exchange_strong(mtx, &oldval, 0))
        return;

    /* 2. 存在 FUTEX_WAITERS,陷入内核解锁并唤醒或交接。 */
    if (futex(mtx, FUTEX_UNLOCK_PING, 0, NULL) != 0)
        err(1, "FUTEX_UNLOCK_PING");
}
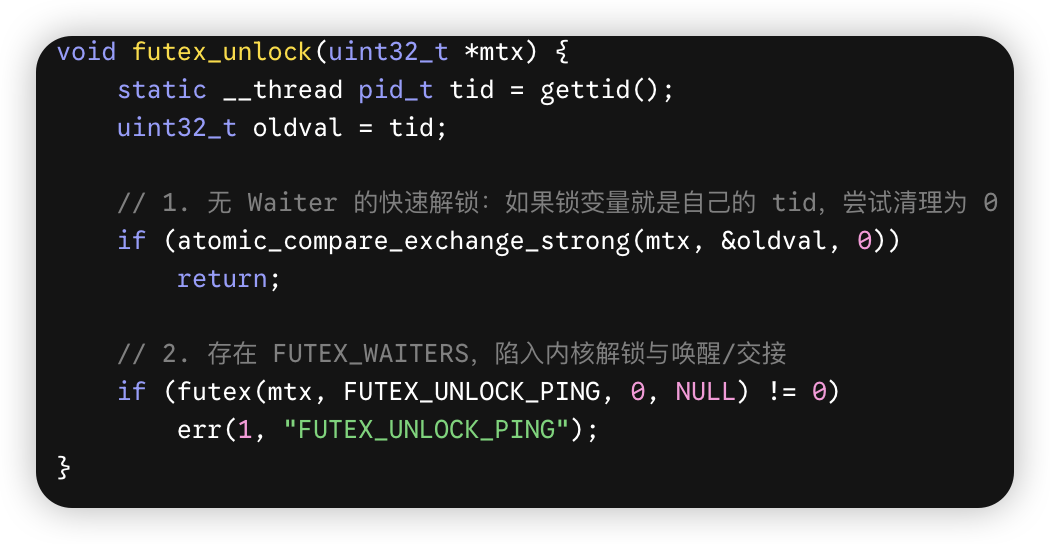
无 Waiter 时,执行 CAS tid -> 0。如果锁变量刚好是自己的 TID,就把它清零,表示没有竞争,解锁在用户态瞬间完成。
有 Waiter 时,由于最高位已经被标记为 FUTEX_WAITERS,CAS tid -> 0 会失败。线程陷入内核调用 FUTEX_UNLOCK_PING,由内核把线程 A 从 Proxy Exec 链条中解绑,恢复原本的调度关系,并唤醒等待在链表上的下一个线程,或允许它抢锁。
这个过程会和前面 futex_lock() 的偷锁机制配合:
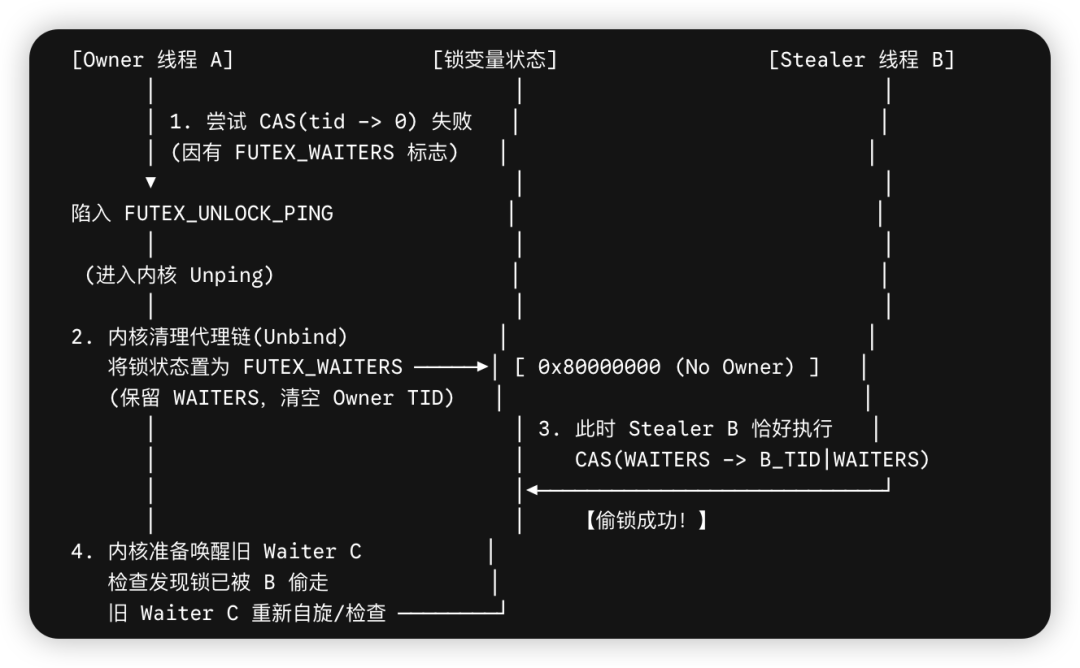
当 Owner 线程 A 尝试 CAS 解锁失败后,会陷入 FUTEX_UNLOCK_PING。内核清理代理链,把锁状态置为 FUTEX_WAITERS,即保留 WAITERS、清空 Owner TID。此时 Stealer 线程 B 如果正好执行 CAS(WAITERS -> B_TID | WAITERS),就有机会直接偷锁成功。内核准备唤醒旧 Waiter C 时,也会发现锁已经被 B 偷走,旧 Waiter C 便重新自旋或检查。
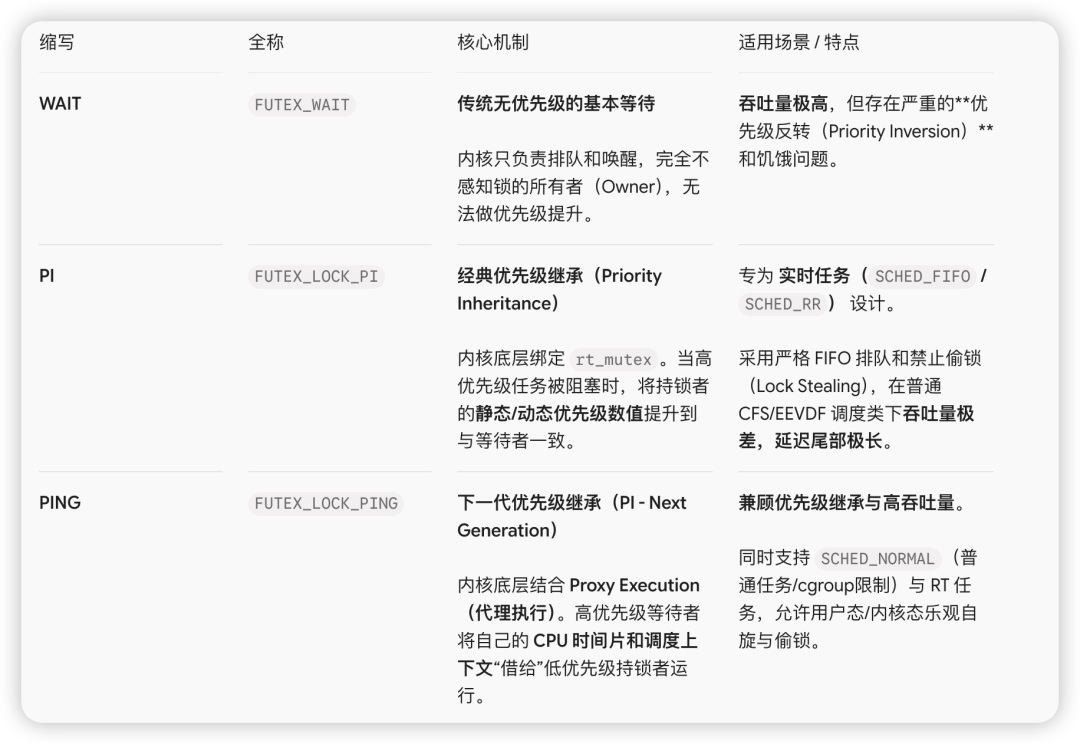
WAIT、PI、PING 对比
下面简单对比三种 futex 机制:
| 缩写 |
全称 |
核心机制 |
适用场景与特点 |
| WAIT |
FUTEX_WAIT |
传统、无优先级的基本等待 |
吞吐量极高,但存在严重的优先级反转和饥饿问题。内核只负责排队和唤醒,完全不感知锁的 Owner,无法做优先级提升。 |
| PI |
FUTEX_LOCK_PI |
经典优先级继承 |
专为 RT 任务(SCHED_FIFO / SCHED_RR)设计,内核底层绑定 rt_mutex。高优先级任务被阻塞时,将持锁者的优先级提升到与等待者一致。采用严格 FIFO 排队并禁止偷锁,在普通 CFS/EEVDF 调度类下吞吐量较差,延迟尾部可能很长。 |
| PING |
FUTEX_LOCK_PING |
下一代优先级继承 |
兼顾优先级继承与高吞吐量。内核底层结合 Proxy Execution,高优先级等待者把自己的 CPU 时间片和调度上下文“借给”低优先级持锁者运行。同时支持 SCHED_NORMAL 与 RT 任务,允许用户态或内核态乐观自旋与偷锁。 |
John Stultz 的 proxy exec 工作始于四年前,如今仍然有不少后续工作要继续推进。内核开发从来不是一蹴而就的事情,它需要长期坚持、耐心,以及“十年磨一剑”的毅力和勇气。
参考文献:
[1] https://lpc.events/event/20/contributions/2569/attachments/2021/4555/LPC2026%20-%20Proxy%20Enabled%20Futexes.pdf
 发表于 半小时前
|
查看: 5|
回复: 0


