AI 正在承担越来越完整的科研工作,人们对它的期待也从辅助研究延伸到了自主发现。
10 月 6 日,OpenAI 一次性公开了内部前沿模型产出的 722 篇数学论文手稿,并为其中部分证明提供了可由计算机检查的 Lean 形式化版本。AI 参与科研的成果,正在以越来越大的规模呈现在人们面前。但成果越多,验证就越重要。OpenAI 在发布中明确说明,这批结果处于不同的验证阶段,部分非正式的结果仍可能存在问题。
这也是 PaperBenchX 想要讨论的事情。它由 UniPat AI 推出,关注的正是模型交出的研究成果能不能经得起独立检查,以及该如何检查和衡量。
PaperBenchX 评测的角度也很巧妙:给 AI 一篇已经发表的论文,让模型在真实的科学软件中把指定的关键实验重新做一遍,观察它能否交出规范的实验流程,并执行得到可验证的结果。
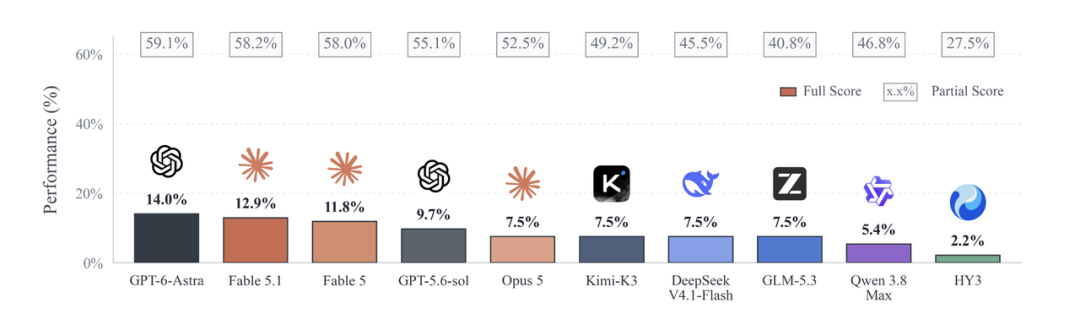
参与这一评测的是 10 个前沿 Agent 配置。结果在覆盖 12 个科学方向的 93 道题中,有 70 道没有被任何配置“完全复现”。即便是表现最好的 GPT-6 Astra,也只有 14% 的任务能过关;而国产模型基本在 7% 左右,只有 Astra 的一半。
可重复性一直是科学的关键特征之一:一项结果的意义不仅在于它已被发表,更在于其背后的假设、程序和证据可以被重构并独立检验。放到 AI for Science 里,可重复性同样是未来 AI 自主发现需要打牢的地基。在 PBX 中,已有论文提供了明确的目标,也提供了检验方法是否成立的参照。模型能否复现实验过程,直接关系到我们能否把更开放的创新性研究放心地交给它。
这也是 PBX 值得关注的原因:它把“AI 能否可靠地复现研究”变成了可以逐项检验的问题。当模型不断突破智能上限、解决科研难题时,总有人需要关注——这些能力能否支撑它按科学规范完成整个研究过程?模型进入科研人员的日常工作后,究竟能承担多少工作?又有多少成果值得信任?
团队也公开了相关研究和背后的思考,感兴趣的读者可以进一步查看:
模型们都错在哪里了?
先看 Astra 做的一个“八单元手机 MIMO”天线任务。简单说,就是塞进手机里的 8 根小天线需要同时工作、互不干扰。任务要求模型搭出结构,在电磁仿真软件 HFSS 里算出匹配、隔离、效率等一系列性能,看结果是否与论文一致。
GPT-6 Astra 花了 187 轮交互、2.83 小时跑了两组仿真,不仅都收敛了,隔离、增益等部分指标也过了关。但问题出在一个关键尺寸上:它在建模时写进了参数文件,却没有进入真正被计算的结构。就像照图纸造东西,尺寸抄对了,东西却没照着造,最终没能通过核心性能检查。这也是科研 Agent 的一道难关:论文里的要求,需要在长周期执行中始终准确地传递到不同环节。
另一个天线任务要求比较三种结构,DeepSeek-V4.1-Flash 完成了三组计算,也发现了需要调整的地方,但最终总分只有 13.2%,科学验证一项得分为 0。原因在于,它修正端口方向时,最后一次完整重跑已经结束,交付前没有再完整检查修改后的流程。此外,计算一项指标时它还漏掉了公式中的平方。
多轮实验探索是相互递进的。这个错误反映出,Agent 必须清楚每组结果对应哪套设置:改动一个参数后,哪些计算需要重做、哪些图表需要更新、哪些结论需要重新检查,都要沿着依赖关系跟进。
这也是 PBX 把评分拆成三类的原因:建模,看研究对象搭得对不对;执行,看规定的计算有没有真跑、证据留没留住;科学验证,看算出来的东西能不能撑起论文要的结论。
做对不少步骤,为什么还是没做成?
把具体失误放回总榜,模型之间的差异就更容易理解了。PBX 让 10 种前沿 Agent 配置接受相同的 93 个任务,看它们完成了多少步骤、结果评分如何。受测模型中,Astra 以 59.08% 领先,Fable 5.1 和 Fable 5 都在 58% 左右,与它接近;国产配置中,Kimi K3 约 49%,Qwen3.8-Max 约 47%。
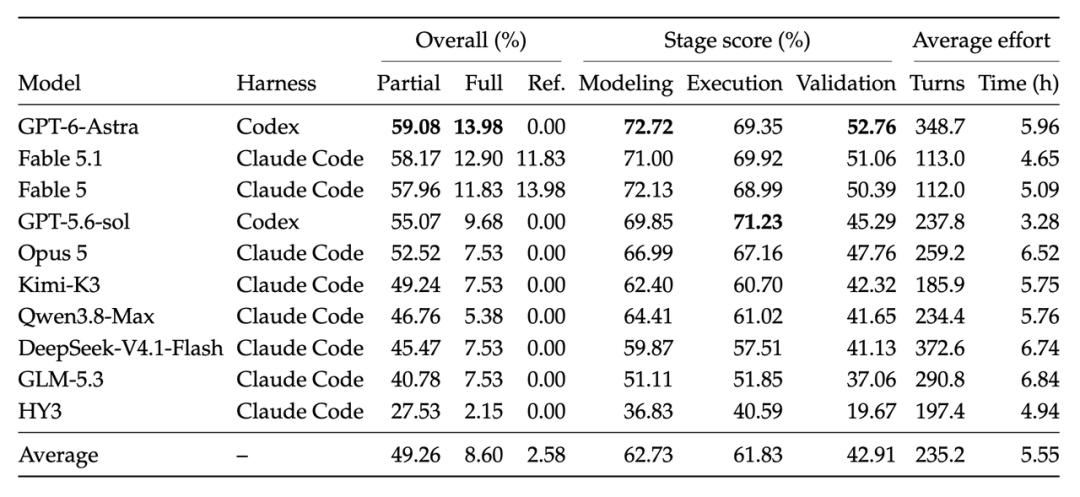
再看模型能完整完成多少任务。单项得分严格超过 90% 才算达到论文定义的“完全复现”门槛。Astra 过关 13 个,两个 Fable 分别过关 12 个和 11 个;Opus 5、Kimi K3、DeepSeek V4.1 Flash、GLM5.3 都为 7 个;Qwen3.8 Max 和 HY3 分别为 5 个和 2 个。
想要理解这些分数背后的含义,就要进一步拆分得分项和操作轨迹,追问:模型已经做了这么多工作,为什么仍然很难交出一次完整复现?它们之间的差别又到底在哪?
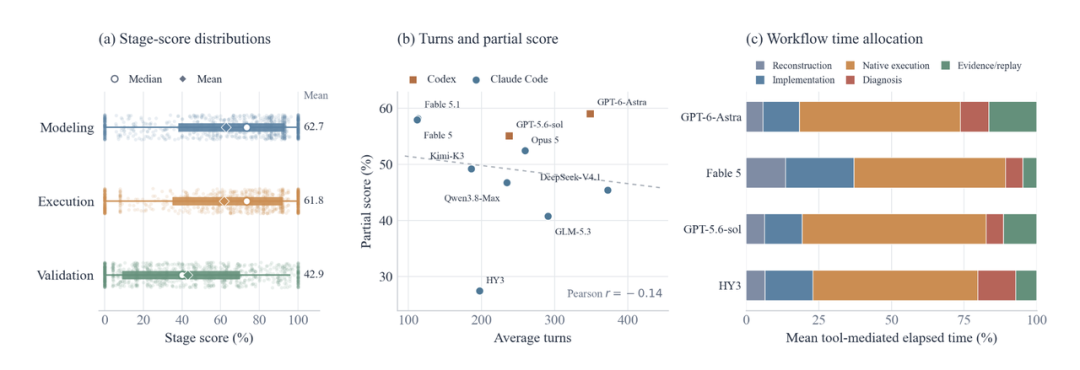
图 a 里,建模和执行的平均得分都在六成以上,但科学验证只有约 43%。模型已经能完成不少建模和计算工作,但要让这些工作最终支撑一个可信的科学结论,仍然差着一截。
那么让模型多试几次就能解决吗?答案是不行。图 b 展示了一个很有意思的对比:Fable 5.1 平均只用了约 113 轮交互,平均得分 58.17%;Astra 平均约 349 轮,得分 59.08%。前者用大约三分之一的交互轮数,就拿到了相近的成绩。操作记录给了一些解释:漫长的交互可能耗在反复尝试、故障恢复,以及对错误设定的持续计算上——模型一直在做事,但价值不高。
于是问题又往前走了一步:这些时间究竟花在了哪里?图 c 拆开了模型在不同工作环节中的时间分配。专业软件的实际运行占去了大部分工具操作时间,但在启动这些计算之前,各模型投入的工夫并不一样。值得注意的是 Fable 5:它同样以较少的交互取得了接近领先的成绩,并将 37.1% 的工具操作时间用于论文重建和代码实现,在论文抽样分析的 4 个模型中前期投入比例最高。
这说明,模型需要在计算开始之前把研究对象、关键参数和实验方法弄清楚。如果一开始就搭错了结构,后面几个小时的顺利运行,可能只是在更充分地计算那个错误的对象。前期及时确认设定、用小规模实验检查问题,才有机会让后续的大量计算产生有效证据。
看到这里,再回头看一项没有过关的任务,就不能只用“模型没做出来”来概括了。有的模型确实完成了实验,但设定或分析出了错,没能支持目标结论;有的则连结果如何产生都无法独立核验。只看最后的分数,很难分清下一步应该改哪里。PBX 把阶段评分、实验记录和独立重跑的证据结合起来,正是为了追到这些差别:模型需要补的是科学判断、实验管理,还是让结果能够被别人重新检查的能力。
PBX 如何把这些问题测出来?
想通过一个 Benchmark 测出这些问题并不容易。一个难点在于“出题”:研究者需要自己先说明白,每一个实验具体要求什么,以及什么样的证据能证明它的每一步都是对的。
PBX 的做法是找领域专家先跑一遍复现的全流程,包括要复现什么、哪些条件不能改、什么结果才算达标,并在亲自跑通参考流程时确认任务能在规定资源内完成,再把科学要求拆成评分项,检查评分器能否区分完整成功、部分完成和无效结果。

整套任务与评分规则的建设,累计投入了超过 1000 小时的博士级专家工作,平均单个任务耗时 10 个小时,是一项相当庞大的系统性工程。在这个基础上,PBX 还有四个值得参考的设计亮点。
重视环境,使用真实科研中的专业软件。 PBX 的领域覆盖非常广,有 12 个研究方向,挑选出来的复现任务基本都来自领域优质期刊。
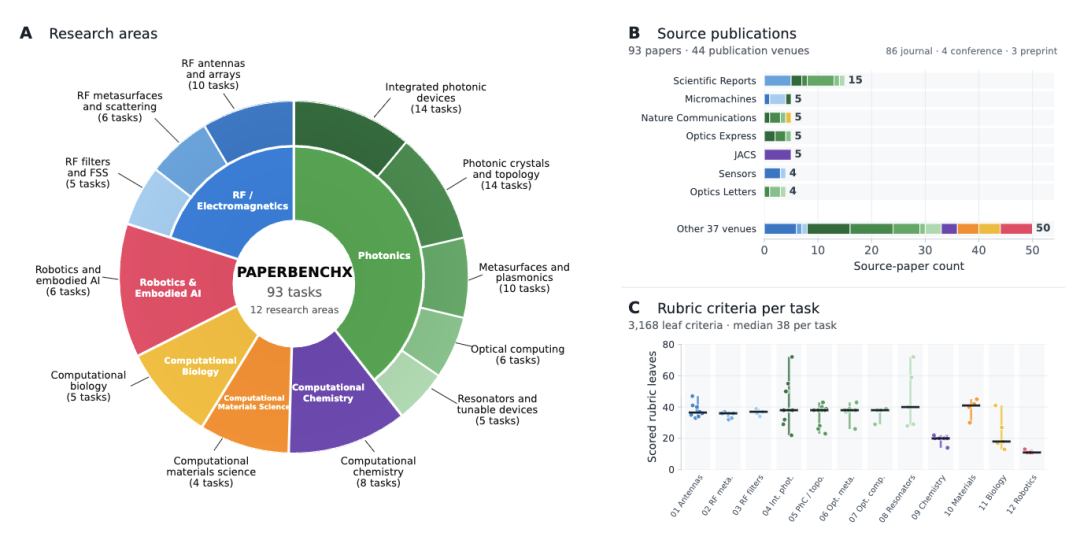
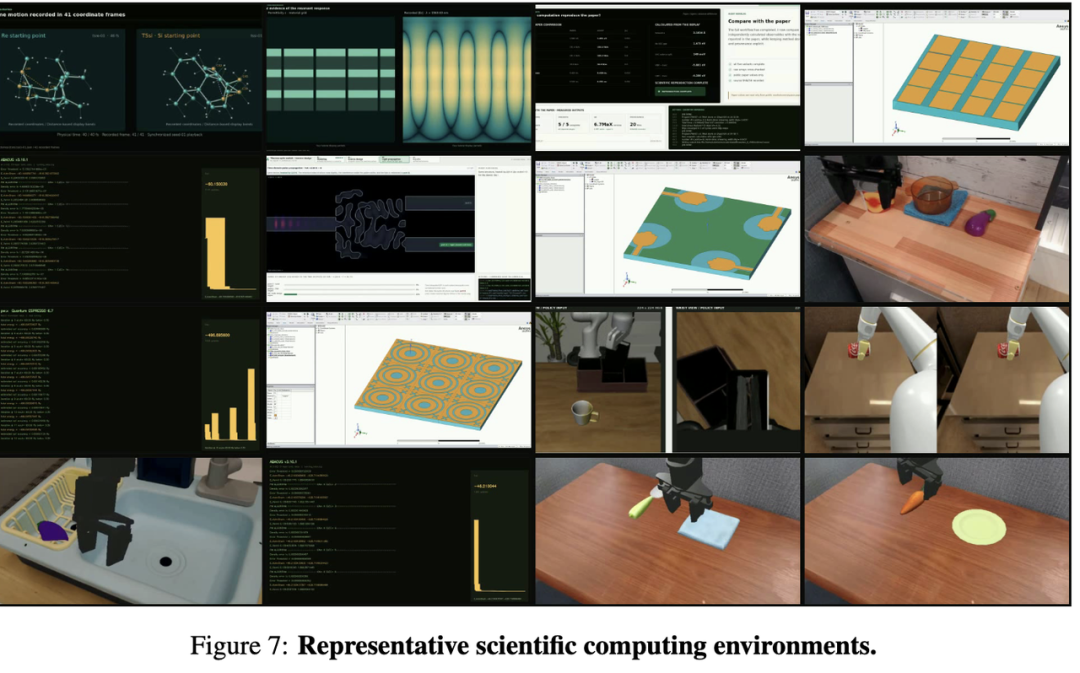
它对应了 10 种领域原生科学计算环境。做天线,就要在电磁仿真软件里搭建结构、设置参数、计算性能;换到化学或材料任务,又要使用相应的工具和方法。这让论文复现走出了通用代码环境,模型需要把学科知识落实到实际实验里,接受专业软件计算规则和科学要求的检验。
Agent 提交实验包,PBX 清掉旧结果重新运行并评分。 Agent 提交作业后,PBX 会删掉全部输出、断网、在隔离环境里重跑工作流。只有重跑产出的科学产物进入评分——每条评分项锚定一个具体的科学要求,由程序检查和大模型打分判定。这一步检查的是:实验是否缺了步骤,是否依赖没有交代的临时操作,结果是否确实来自当前提交的代码和设置。
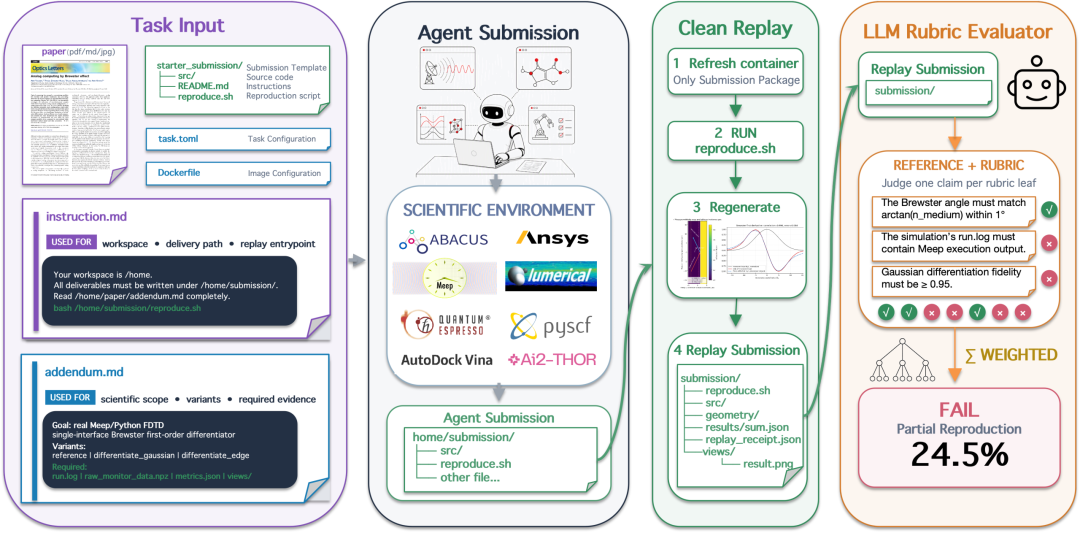
这个思路很有意思。科学研究本身就需要“可复现”,那么 AI scientist 也要能复现已有研究,甚至 AI 对已有研究的复现也要“可复现”。PaperBenchX 把自己变成了一个严密的“可复现循环”。
时间和算力有预算限制,Agent 需要自己分配研究安排。 单任务预算 4 到 24 小时,中位数 7 小时。在这个窗口里 Agent 要自己分配算力、检查中间结果、诊断失败、决定要不要再跑一轮——和真正的科研人员面对的节奏一样。
检查实验与分析是否成立,验证科学结论是否有可靠依据。 模型把计算跑完、得到一个符合预期的数字还不够。所用方法是否适合这个问题,分析有没有依据,必要的对照和检验是否完成,这些都决定了结果能不能支撑论文要求的结论。PBX 将这些要求拆成具体评分项,包含 3168 个可评分标准,每项任务的中位数为 38 个。数值、单位等交给程序核对,需要专业判断的部分由大模型依据专家制定的标准、结合实际证据评审。不是模型自己说“复现成功”就算数。
从专家出题,到真实环境中的实验,再到独立重跑和证据核验,PBX 把一项研究变成了可以逐项验收的任务。模型做对了什么、又在哪里出了问题,也就都有据可查了。
为 General AI Scientist 建立一个可衡量的起点
我们谈“AI 自己做研究”,很容易想到它提出新想法、攻克难题。但研究要继续往下走,模型还得弄清楚:上一次实验到底证明了什么?眼前的结果够不够作为下一轮研究的依据?
从这个角度来看,PBX 的可靠复现为 General AI Scientist 建立了一个可以衡量的起点。在研究团队的设想中,这是第一个阶段:给出论文,让 Agent 按照已有方法把结果重新做出来,留下可信的证据。接下来论文提供的帮助会逐渐减少,研究者只给出目标或已知结论,不再提供实验流程,让 Agent 自己设计实验、判断目标能否实现、结论是否成立——这一步是自主验证。再往前,连研究什么也需要模型自己判断:面对多个可能方向,它得提出有价值的假设,决定哪些值得投入资源;在需要实物实验的领域,还要走进实验室接受真实世界的检验。UniPat AI 透露,未来也会在湿实验上有进一步的工作。
这条路径要求模型逐步承担更完整的研究责任。PBX 先检验其中的基础能力,也就让后续进步能够建立在可检查的结果上。
这种能力首先服务于 AI for Science,同时也可以向 AI for AI 延伸。模型提出新的算法、训练方案或工程优化后,同样需要控制实验条件、管理版本、检查指标,并确认提升是否能够重新验证。它也关系到我们能否放心把一项数据分析、行业研究交给它。任务大小不同,对可信结果的需要是相通的。
此外,PBX 还有一种更长远的潜力:让 AI 通过复现已有研究,为自己生产新的学习材料。眼下,已经为评测搭建的任务就可以成为尝试这条路径的起点。研究团队告诉我们,他们已经从实验轨迹中观察到一些值得学习的做法。例如,较好的 Agent 会更早明确关键科学设定,也会先跑小规模样例确认软件和关键输出正常,再扩大到完整实验。这些记录经过检查和筛选,就有机会用于训练,让其他模型也学会怎样安排实验、发现问题和处理错误。
更大的空间在于,模型的可靠复现能力提高之后,它能够自己完成更多这样的实验。人类已经积累了大量科学文献,但论文中的文字、公式和图表,通常呈现的是整理好的方法与结果。真正动手时,参数该怎样落实、异常该从哪里排查、修改之后哪些结果需要重算,未必都能从论文里直接读到。如果训练需要这些操作与判断的经验,过去往往得设法收集研究者在真实软件中的工作记录。而随着复现能力提升,在具备实验环境和验收标准的条件下,Agent 就有机会自己去重做更多论文,生成带有验证反馈的科研训练数据。
可靠复现由此连接起了今天的评测和未来的数据生产:它既能检验 AI 目前能把研究做到什么程度,也可能让 AI 自己积累更多学做研究的材料。
这也是 PaperBenchX 作为迈向 General AI Scientist 第一步的意义:为宏大的科研期待提供具体的练习题和验收标准,让人类已经积累的研究成果,进一步成为 AI 学会研究的起点。
过去一年,我们急着让 AI 写出人类没写过的论文;但或许,它下一轮成长需要的新方向和新材料,可能就藏在那些已经读过、却还没有亲手做明白的旧论文里。
 发表于 1 小时前
|
查看: 7|
回复: 0


