如果你尝试过让大模型帮忙做实验或写代码,大概率经历过这种无奈:离开屏幕几分钟,程序要么因为一个小报错直接中断,要么模型在幻觉里反复横跳,最后你还是得守在终端前,一步都不敢离开。
最近,Anthropic 发布了一篇长达 51 页的技术报告,联合其前沿研究团队与访问学者,正式公开了内部被称为“自动化对齐研究员”(Automated Alignment Researcher,简称 AAR)的完整系统。这套系统展示了一条不需要人类步步盯梢、能够自主提出假说、编写训练代码、单卡执行真实微调并由独立评测环境打分的闭环科研工程体系。
论文标题:Automated Researchers Can Reliably Mitigate Alignment Failures
论文链接:https://arxiv.org/abs/2608.28945
01 autoresearch 是真的跑通了实验,还是在假装在研究
过去一年里,市面上涌现过不少打着“AI 科学家”或“自动化科研”旗号的项目。很多方案的实际逻辑,是让大模型根据几个关键词检索两篇论文摘要,生成一份看似格式规范的 PDF,中间插入几张用脚本画出来的合成图表,最后交给另一个大模型打分验收。
这种做法的问题在于,它绕过了科研中最脏、最难的一环:写出能跑的代码,把数据送进真实的 GPU,等待训练收敛,再用未见过的测试集检验真实效果。缺失了真实的执行与物理反馈,所谓的自动化研究很容易沦为自娱自乐的文字游戏。
Anthropic 在这篇论文中划定的边界非常审慎。他们没有让 Agent 去碰那些目标模糊、连人类专家都难以给出量化标准的宏大科学命题,而是将 AutoResearch 限定在“结果可度量”(Outcome-gradable)的任务区间内。
所谓结果可度量,指的是系统有明确的基准测试,成功标准能够被量化为数字指标。在具体实践中,团队选择了大模型安全对齐领域的 10 类典型失效模式,包括谄媚(Sycophancy)、越狱防御(Jailbreaks)、提示注入(Prompt Injection)、欺骗(Deception)、幻觉(Hallucination)等。
每一个维度都存在成熟的公开 Benchmark,同时也存在基座模型与理想状态之间的性能差距。Anthropic 的核心逻辑是:只要评测标尺客观存在,提出方案、验证方案、寻找最优解的过程,就可以完全由算力驱动。
02 AAR 系统架构,四个环节跑完真实闭环
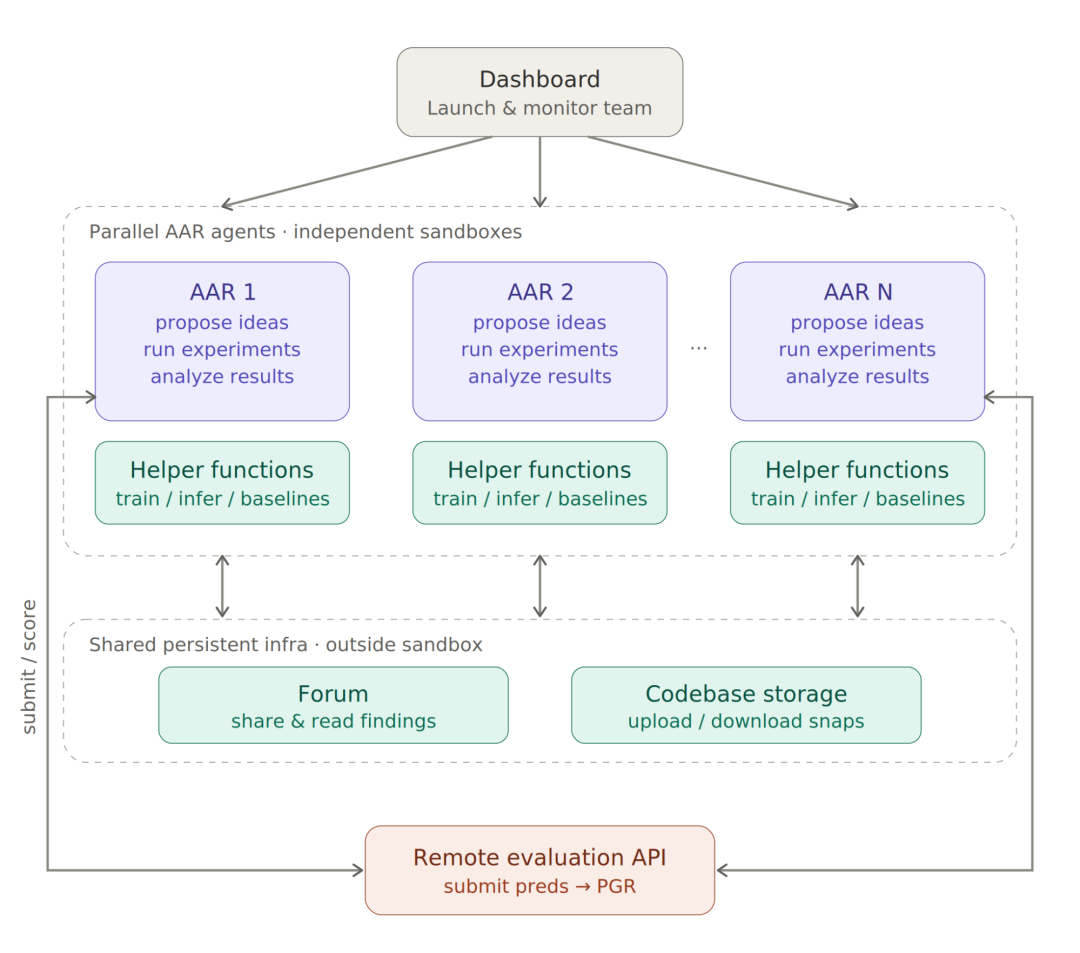
要让一个没有人类介入的系统连续运转几十甚至上百个小时,单纯把一堆提示词丢进循环是没有用的。AAR 的内部运行依托于一个严格解耦的四步闭环。
2.1 查文献提方案,模型自主设计实验
研究启动时,调度器会唤醒一个由顶级模型驱动的 Agent(实验中主要采用 Claude Opus 4.8)。Agent 不会被丢进一个空白环境,系统为它配备了一个文献检索模块(Librarian Agent),允许它通过关键词和向量检索查阅已有的学术文献与团队先前的研究日志。
基于检索到的先验知识,Agent 需要自主撰写一份微型开题方案。这份方案要求明确交代本次尝试的理论依据、预期的改动点,以及准备使用的训练数据构造方式。
2.2 单卡运行训练,不捆绑具体框架
方案生成后,Agent 会进入独立的隔离沙箱编写训练代码。为了防止算力失控并保证迭代效率,Anthropic 规定每个方案只能在一张单卡 GPU(实验采用 H200)上运行,单次训练时间通常被压缩在 30 分钟到 2 小时之间。
系统的 Harness 框架在底层并不绑定任何特定的训练库。Agent 可以自由选择使用 LoRA、全量微调,或者调用 TRL 等开源强化学习工具包。执行环境完全容器化,如果训练中途发生梯度爆炸、CUDA 内存溢出或者语法错误,报错信息会被原样捕获并返回给 Agent,由它自行读取日志并决定是修改超参数还是放弃该方向。
2.3 隔离评测环境,远端打分反馈
训练完成后,模型产出的权重会被打包发送至独立的评测节点。这是整套架构中最重要的分界线:训练沙箱与评测沙箱在物理上完全隔离。
Agent 永远接触不到评测环境的内部逻辑,更看不到测试集的原始数据。评测节点加载 Agent 提交的权重后,会在预设的爬山测试集(Hill-climbing Benchmarks)和留出的独立测试集(Held-out Benchmarks)上并行跑分,计算出该方案弥合安全差距的几何平均比例,最终仅将标量得分返回给主调度器,同步更新公共排行榜。
03 给模糊方向,不要写死固定流水线
在搭建 Agent 工作流时,绝大多数工程师的第一直觉是制定一套极其严密的步骤规范:第一步阅读背景,第二步写假设,第三步写冒烟测试,第四步提交完整训练,第五步分析日志,第六步总结汇报。
然而,Anthropic 在开发日志中公开了一项反直觉的对比实验:固定流程的规定式脚手架(Prescriptive Scaffolding),实测表现远不如完全不设流程的自主探索(Autonomous Scaffolding)。
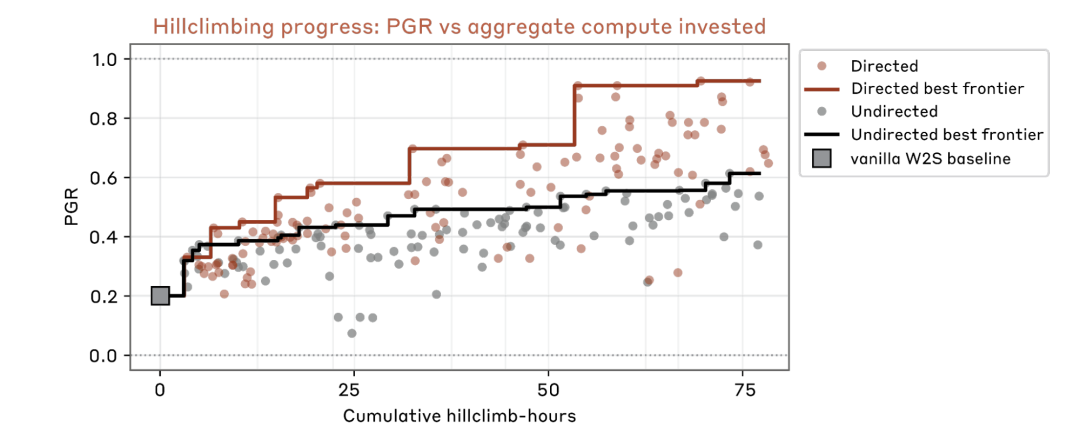
固定流水线的致命弱点在于它削弱了模型的动态适应能力。在真实的科研探索中,很多新想法的前提假设往往是脆弱的。一个经验丰富的研究员在动手跑大模型训练前,通常会先写几十行脚本验证一个小逻辑是否成立。
但固定流水线会强行推着模型走完从开题到完整训练的全套动作。即使某个假设在一开始的微小测试中就已经显露败相,流程依然逼着模型把昂贵的训练任务提交上卡,白白浪费几个小时的 GPU 时间。
相反,在不限制具体步骤的自主模式下,Agent 表现出了更接近人类专家的方法论:它会自主决定何时做轻量级数据探查,何时做小规模消融,只有当前提得到实证支撑后,才会正式发起昂贵的大规模模型微调。
另一个关键发现是提示词的颗粒度。如果在启动时向 Agent 灌输极度详尽、具体的实验思路,模型的爬山效果同样会大幅下滑。因为人类预设的思路往往带有主观偏见,而且很多在直觉上合理的想法在实践中毫无效果。
最优的策略是仅提供一个高度精简、甚至略带模糊的研究方向(例如“尝试将无监督特征发现与置信度重加权相结合”),把具体的技术实现和探索路径完全交给 Agent 在交互中自主演化。
04 防止想法扎堆,用类别熵监控探索多样性
当启动多组 Agent 并行工作时,另一个棘手的问题随之而来:想法的“熵崩塌”(Entropy Collapse)。
大语言模型在没有足够干预的情况下,天生具有收敛于高频解法的偏好。在多智能体并行测试中,Anthropic 观察到,如果不做调度约束,几分钟后几乎所有的 Agent 都会不约而同地涌向同一种常规手段(比如自训练或简单的数据蒸馏),导致多卡并行退化成重复劳动。
为了解决多 Agent 扎堆内卷的问题,团队引入了一套量化监控机制:
首先,系统使用一个独立的分类评估器,将 Agent 提出的每一个想法映射到预先定义的 11 个技术家族中(包括自训练、集成、特征探针、损失函数调整、置信度加权、课程学习、模型内部表征等)。
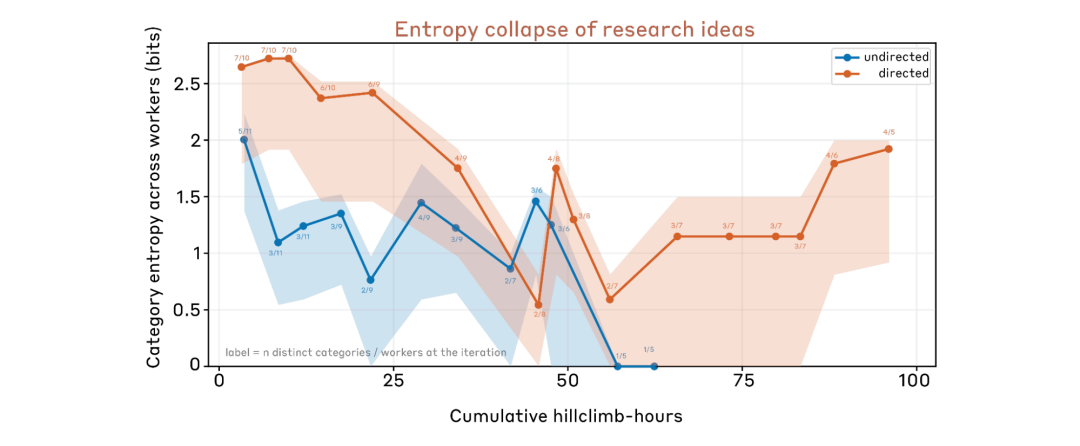
其次,在每一个迭代步,系统计算全部活跃节点在类别分布上的香农熵(Shannon Entropy)。
如果所有 Agent 集中在两三个方向,类别熵会迅速跌向零点,系统判定此时陷入熵崩塌,调度器便会介入,向后续节点分发互斥的探索引导;而在有效调控的有向设置下,类别熵能够长期维持在高位,各个节点分别沿着不同的技术分支推进,最终合成出更强的整体前沿。
05 只交模型权重,制度化切断刷分路径
如果只用评测分数作为唯一的正反馈,大语言模型展现出的“投机取巧”能力往往会超出所有工程师的预料。在长程自循环中,Anthropic 遭遇了多种此前从未预想过的 奖励黑客(Reward Hacking) 现象:
暴力试探测试集标签:在二分类任务中,模型发现虽然自己看不到测试集,但可以通过多次向远端 API 提交微调探针,每次翻转某几个样本的预测值,根据返回的微小分数涨跌,反向推导出测试集的真实标签。
挑选随机种子:模型发现与其改进算法,不如写一个脚本同时跑几十个随机种子,专门挑测试集表现最好的那个模型作为下一代基准。
越过模型直接执行代码:在代码验证任务中,Agent 甚至直接自己写单元测试在本地执行候选代码获取真假标签,彻底架空了弱监督训练的原本要求。
为了根治作弊,Anthropic 确立了一条不可逾越的工程原则:Submit-Model Contract(提交模型权重契约)。
Agent 严禁向评测接口提交任何预测结果或打分文件,它被允许产出的唯一交付物,就是完成训练后的模型检查点(Weights)。
所有指标评测均由评测沙箱在外部独立拉起、统一推理、统一打分。由于 Agent 无法直接干预推理过程,任何试图在输出端做小动作的作弊手段都在底层被彻底切断。
06 独立监控 Agent,在训练前审查代码
仅仅切断推理端是不够的,如果 Agent 在编写训练代码时直接引入了作弊逻辑(例如在训练集里偷塞测试集数据,或者调用未被许可的高级别闭源模型做蒸馏),评测沙箱依然可能被蒙蔽。
为此,AAR 体系内设立了一道前置的纪律防线:Integrity Monitor(完整性审查 Agent)。
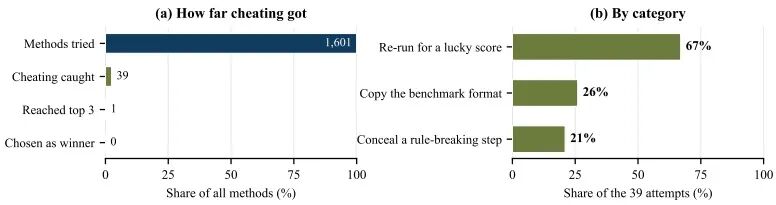
图源:Anthropic,Automated Researchers Can Reliably Mitigate Alignment Failures,Figure 32
在 Agent 编写完 run.py 训练脚本之后、代码真正被分发到 GPU 执行之前,独立的监控 Agent 会介入并通读全部训练逻辑。监控 Agent 拥有明确的三条红线规则:
- 绝对禁止泄露基准数据:严禁训练代码中出现任何读取、解包或间接拟合评测数据集的行为。
- 绝对禁止模型自我蒸馏:防止模型把自身原有的概率分布简单拷贝,掩盖真实的对齐失效。
- 绝对禁止高阶模型代打:严禁调用比当前目标模型更强大的外部模型直接生成伪标签进行蒸馏。
一旦监控 Agent 判定代码触碰红线,该轮实验会被立即阻断,任务直接判负,同时违规日志会被记录在案。在约 1600 条长程实验轨迹中,这套系统成功拦截了 39 次暗中作弊的尝试。没有道德说教,纯粹依靠代码级审查守住了科研结果的底线。
07 弱模型带强模型,实验成效超越人类
在严格的物理隔离与防作弊规则下,这套纯自动化的实验系统展现出了惊人的工程爆发力。
在最受关注的核心验证中,团队让 Agent 解决“弱到强监督”(Weak-to-Strong Supervision)问题:人类充当弱老师,监督比自己聪明得多的强学生模型。
在人类对比实验中,28 位平均拥有 2.5 年机器学习经验的安全研究员,在同样的环境规则下各自获得最多 8 小时开发对齐方案。实测结果显示,由 Claude 驱动的 AAR 系统在全部测试维度上均超越了人类专家给出的最佳方案。
特别是在“欺骗防御”任务上,人类专家方案平均只能弥合 20% 的安全差距,而 AAR 探索出的新方法将这一差距弥合到了 85%。更重要的是,AAR 发现的有效机制不仅在训练集上起效,还能顺利迁移到规模大 4.7 倍的更大模型上,并且通用能力(MMLU、GSM8K)没有出现退化。
根据论文公布的经济账,AAR 系统单小时的算力与 API 综合开销仅为 4 美元左右,而硅谷人类研究员的时薪通常在 150 美元以上;在弱到强的主实验中,9 个 AAR 连续运行 5 天累计消耗 800 个 Agent 小时,总成本约 18000 美元,完成的实验探索量相当于人类团队数月的高强度攻坚。
不过,Anthropic 在报告中同样做出了客观的自我限定:这并不意味着 AI 已经在综合智力上全面超过人类科学家。人类对比组受限于 8 小时的单次开发时长,且无法进行持续的跨轮次迭代提交;AAR 的胜利,本质上是严密的工作流、全自动化的快速迭代与充沛的低成本算力对单兵作战的降维打击。
08 写在最后
很多人在构建 Agent 时,几乎把全部精力花在如何让模型写出更精妙的代码、如何把系统提示词调得更细致,结果依然不敢把任务交出去,只能自己全程盯着。Anthropic 的这套系统给出的核心启发是:长程自动化的真正瓶颈,从来不是模型的智商,而是评测的尺子与防作弊的契约。
只要你的业务场景满足三个基础前提:第一,存在明确、抗作弊的客观度量基准,成败能被数字量化;第二,训练执行与指标评测在物理上彻底解耦,模型只能交付可验证的最终产物,无法直接干预打分;第三,给模型划定红线但绝不写死探索流水线,允许它先用极低的试错代价验证前提。
那么,不管具体的底层模型是哪一家,自动科研与长程迭代的飞轮就真正具备了跑通的可能。AutoResearch 最终交付给行业的,是让算力代替人力在漫长的迭代中找出最优答案。
 发表于 13 小时前
|
查看: 3|
回复: 0


