咱都经历过笔记软件“用着用着就凉了”。这回说一个把数据牢牢攥在自己手里的国产开源项目。
先讲个挺扎心的经历。前两年我用过一款当时挺火的云笔记,笔记、剪藏、待办全在里面,陆陆续续用了小两年,攒了几千条。结果某天它说关服就关服,导出功能做得稀烂,我费劲导出来的内容一多半是乱码。那次之后我想明白一件事:把身家性命押在“别人的服务器”上,本身就是风险。你可能说,那我用大厂的总行了吧,稳。可“稳”的代价是,你永远只能租用,不能真正拥有。笔记这种东西是跟你脑子绑在一起的,我现在越来越倾向一个原则:数据得在我自己硬盘上,哪怕公司明天倒闭,我照样能打开。顺着这个念头,我找到了 思源笔记。
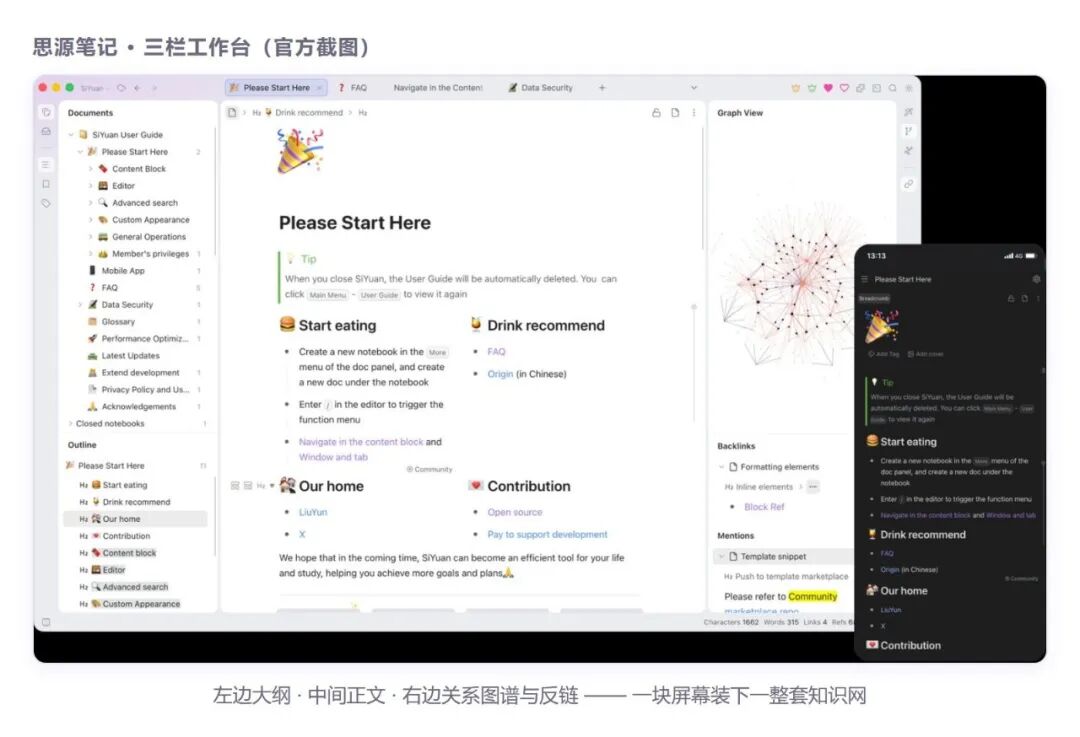
它到底是个啥
思源笔记,英文名 SiYuan,GitHub 上的仓库在 siyuan-note/siyuan 这个位置,4.6 万颗星。它本质上是一个本地优先的“块级”知识库。翻译成人话就是:你写的每一个字,都存在自己电脑上的一个文件里;而且它不是按“整篇文章”来组织内容,而是按“块”来组织。
作者是国内开发者 88250(江湖人称“阎王”),一个人从 2020 年做到现在,仓库最近一次提交就在今天。这种长跑型项目,比那种突然冒出来、又突然消失的要靠谱得多。下面我掰开揉碎讲三个点:块级引用到底好在哪、数据具体存在哪、什么人不适合用。
第一个杀手锏:块级引用
一般笔记软件的链接,是“这篇文章指向那篇文章”。思源的链接,精确到一个段落,甚至一句话。
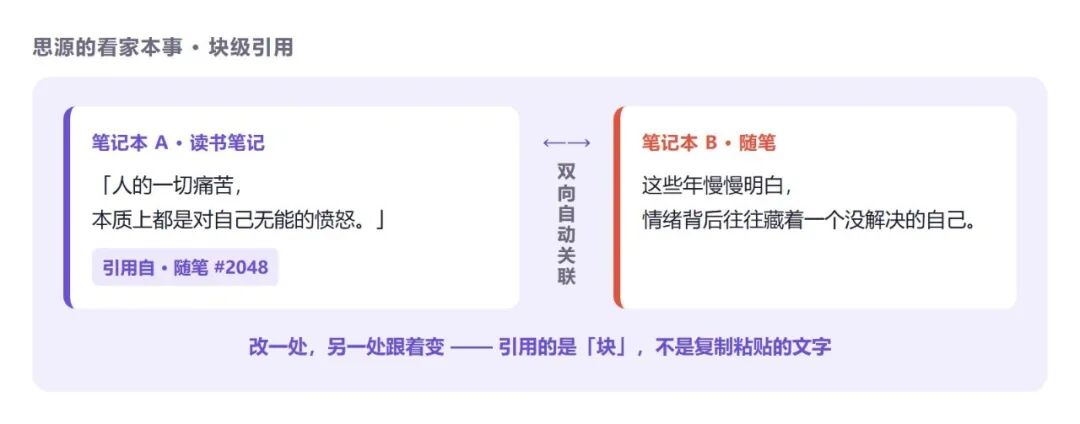
打个比方,你在“读书笔记”里摘了一句话,想在“随笔”里针对这句话写点感想。普通软件你得复制粘贴一遍,可原句要是改了呢?两处就对不上了,成了两份互不相干的文字。思源的做法不一样:你在随笔里引用的不是那段“文字”,而是那个“块”本身。原块一改,所有引用它的地方跟着变;反过来点一下反链,又能看到“这句话都被哪些文章引用过、各自写了什么”。
反链面板算是它的精髓。用得久了你会发现,很多你以为是八竿子打不着的念头,其实早被自己悄悄串起来了,只是以前忘了而已。思源帮你把这条暗线显影出来。功能上也确实齐全:Markdown 所见即所得、百万字大文档不卡、数学公式、流程图、甘特图、思维导图、闪卡间隔重复、PDF 标注、网页剪藏……该有的基本都有,大部分免费,商用也免费。
如果你对这类开源项目的最佳实践和源码分析感兴趣,可以到开源实战翻一翻,里面有不少关于 GitHub 热门项目维护和贡献指南的讨论。
第二个杀手锏:数据是你自己的
这块是我最看重的,也是它跟云笔记最本质的区别。
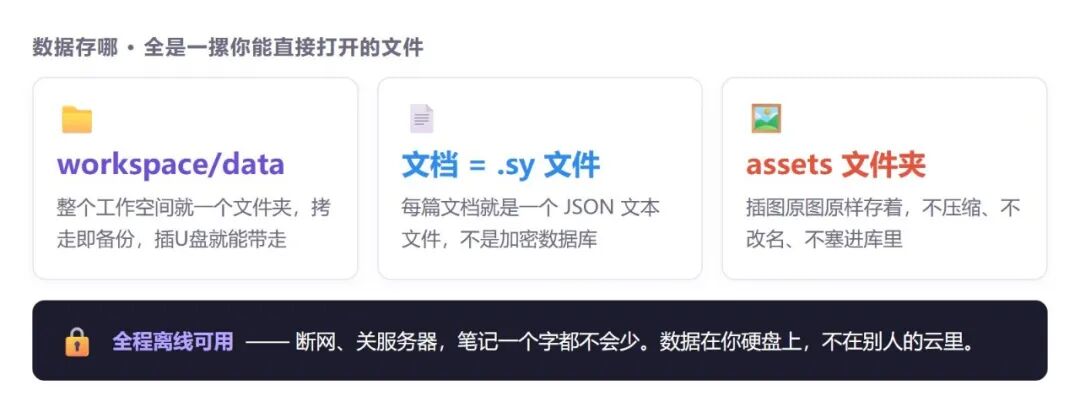
思源的整个工作空间,就是一个叫 workspace 的文件夹,里面包含:
- data 文件夹:所有笔记都在这里,拷走即备份
- .sy 文件:每篇文档就是一个 JSON 文本,不是加密数据库,用文本编辑器就能打开
- assets 文件夹:插图原图原样存着,不压缩、不改名、不塞进库里
这意味着啥?意味着你插个 U 盘就能把全部身家拷走,随便找台电脑装个思源,原地复活。也意味着哪天你不想用它了,数据不会被它锁死——毕竟是标准文件。它还有个数据仓库机制(官方叫 dejavu),像 Git 一样给笔记做版本快照。手滑删错东西、误改了一段,能翻回去找。本地存一份,也能同步到你自己选的云盘、WebDAV 或者 S3。这个“云”是你自己选的,不是被绑死的。
云同步是会员功能,但数据永远在本地。不想花钱?纯本地 + 自己的网盘同步,一样能多设备用。
关于知识库的架构设计和数据管理思路,技术文档板块里也有不少避坑指南和架构设计文章,值得对照着看。
什么人适合,什么人不适合
先说句实在话,它不是给所有人准备的。它更适合这几类人:
- 笔记量大、且内容之间互有关联的人(写作、研究、做知识管理)
- 介意数据放在别人服务器上、想自己说了算的人
- 愿意花点时间折腾配置的人(插件、主题、同步都得自己配一配)
那什么人不适合?想要“打开就能用、一点不用想”的轻量用户。思源的上手曲线比云笔记陡,功能多到菜单里翻半天。你要只是随手记两笔,用系统自带备忘录可能更省心。还有几个点得提前知道:
- 它不支持用第三方同步盘(比如把文件夹直接丢进某度网盘),官方明确说过这么操作有损坏数据的风险
- 换设备要迁移数据,得用它自己的导出/导入功能,不能直接拖文件夹
收个尾
我推荐思源,不只因为它功能强。我更看重的是它背后那股劲:一个人,六年,把一款国产开源软件做到了 4.6 万星,数据格式还公开、不锁用户。这在“云服务说关就关”的今天,本身就是一种态度。好工具不一定是最火的那个,是那个让你敢把重要的东西交出去、又不担心被辜负的。 |  发表于 10 小时前
|
查看: 6|
回复: 0


