本文拆解卡内基梅隆大学 AI Agents 课程(11-768)第一课,由 Daniel Fried 和 Graham Neubig 授课。第一课题目是《What Are Agents? And How Do They Work?》,核心围绕一个循环展开:模型怎样调用工具?面对复杂任务时还需要哪些能力?模型之外,又该搭建哪些系统来支撑它?下面我会结合课堂视频与课程讲义,把整节课的思路拆开讲清楚。
你让大模型解释一段代码,它可以直接给出答案。但如果换一种说法:“打开项目里的文件,找出问题,修改代码,再运行测试”,事情就复杂多了。它需要知道文件在哪里,选择读取工具,根据返回内容判断,再决定编辑哪个文件、运行什么命令。每做一步,系统都要根据实际执行结果,决定下一步该怎么走。
从接收任务到采取行动,再根据结果继续判断,这个循环构成了 AI Agent 的基本工作方式。 沿着这几个问题,我们就能把“一个会行动的智能体”拆开来看。
1. Agent 的关键,是与环境持续交互
在 Russell 与 Norvig 的《Artificial Intelligence: A Modern Approach》中,Agent 的经典定义包含两件事:感知环境,以及对环境采取行动。放到今天的语言模型系统里,“环境”可以是代码仓库、网站、应用程序,也可以是一套业务流程。模型读到的文件内容、网页、截图、工具结果,都是观察;编辑文件、运行命令、调用 API、点击按钮,则是动作。
动作可能改变环境,也可能只是读取信息。执行结果成为新的观察,模型再据此决定下一步。与此同时,系统还需要评价任务做得怎样:测试有没有通过、输出是否满足要求、用户是否认可结果,都可以成为评价信号。
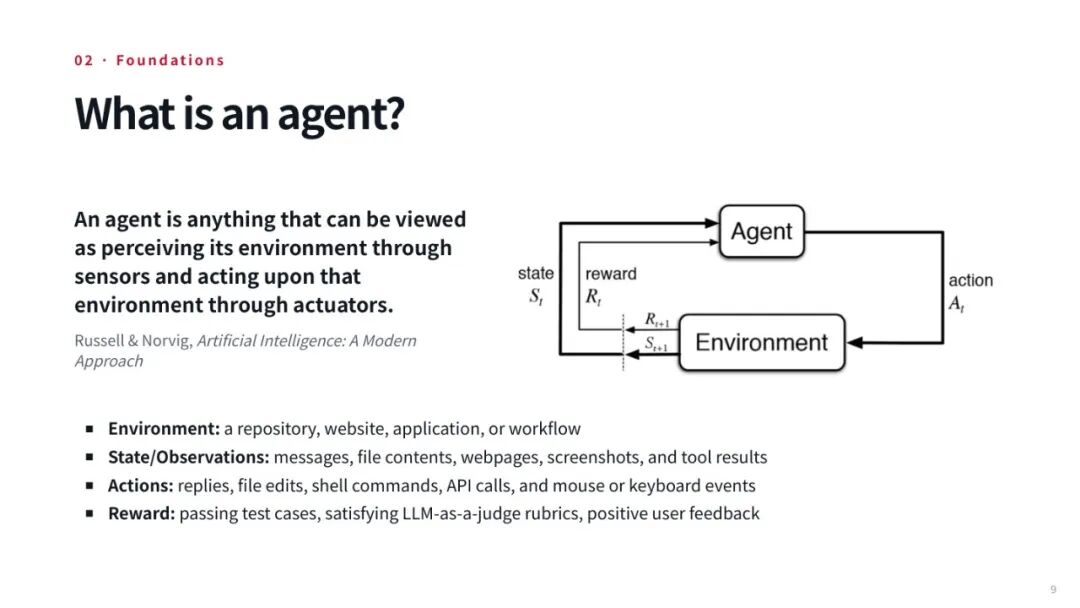
环境提供观察,Agent 采取动作,评价信号帮助判断任务完成得怎样。
这样的交互让系统有机会完成跨度更长的任务。课程开场介绍了 Nicholas Carlini 在 Anthropic 报告的一次实验:16 个并行 Agent 在两周内构建了约 10 万行、用 Rust 写的 C 编译器,能够编译 Linux 内核。这是一次具体实验的成果,展示了多个 Agent 协同工作的可能性。
行动能力也让错误直接影响现实。课程引用了 Summer Yue 分享的邮件处理经历:她要求行动前先审批,系统却继续删除邮件,最后只能终止进程才停下来。Daniel 推测,这可能与上下文压缩后丢失“不要删除邮件”的指令有关。
两个案例把问题连在了一起:Agent 能做多少事,取决于它的能力;允许它独立做哪些事,则涉及权限、信任和后果。读取文件、发送邮件、迁移支付接口,需要的执行边界显然不同。
2. 模型怎样真正调用工具?
语言模型的基本生成方式,是根据已有上下文预测下一个 token,再把生成内容接回上下文,继续预测。工具调用也沿用这一机制,只是生成的内容有特定结构:它要说明调用哪个工具,以及传入什么参数。
以读取文件为例。系统先把 read_file 的说明交给模型:它读取 UTF-8 文件,参数 path 表示文件路径,必须是字符串。当任务是“看看 test.py 里有什么”时,模型可以生成一次工具调用,选择 read_file,并把 path 设为 "test.py"。接下来,系统执行读取,把文件内容作为工具结果送回。调用 ID 用来关联这次调用与对应结果。
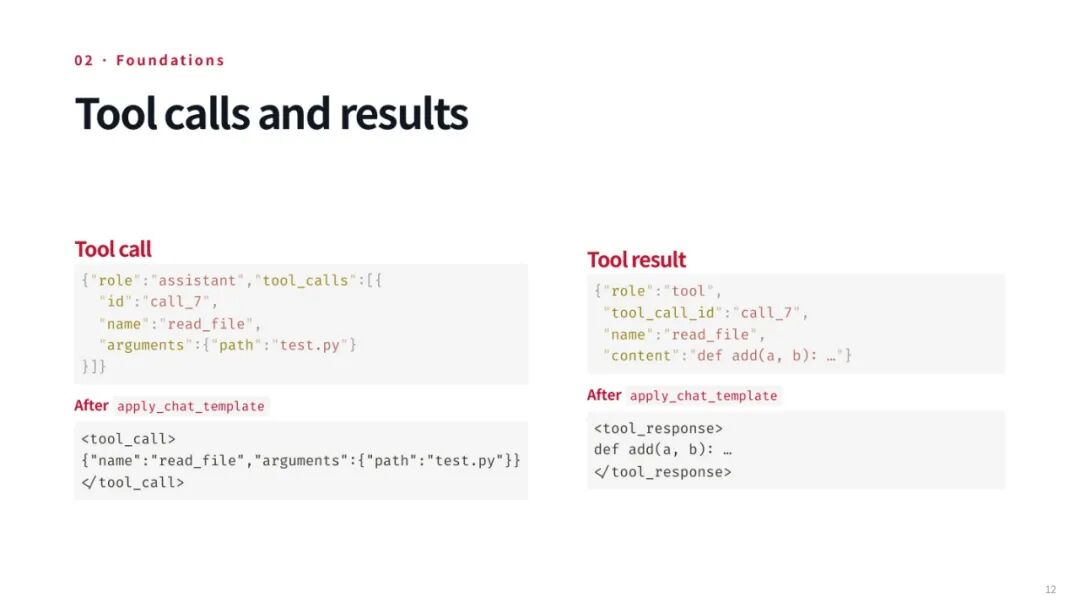
工具调用表达模型想做的动作;工具返回结果提供实际执行后的观察。
这里需要看清一个分工:模型生成动作的表示,运行控制层负责让动作发生。
课程使用的术语是 harness,这里译作“运行控制层”。它围绕模型组织工具与执行过程,解析调用、校验参数、执行动作,再把结果放回上下文。模型生成了一段看起来正确的调用,只有经过这层处理,才能真的读到文件。
这也解释了为什么“回答说已经读过文件”和“系统实际执行了读取”需要区别对待。要判断 Agent 做了什么,必须能查看它的工具调用和执行结果。
3. 把工具接回模型,就形成了行动循环
读文件的例子可以继续往下走。系统拿到 test.py 的内容后,将结果追加到历史里,再交给模型。模型据此判断,文件中定义了 add(a, b),随后通过 send_message 把结果告诉用户。
这个过程可以拆成四步:
- 将任务、可用工具和历史信息交给模型。
- 模型选择下一步动作。
- 运行控制层执行动作,获得结果。
- 将结果加入上下文,继续判断,直到任务结束。
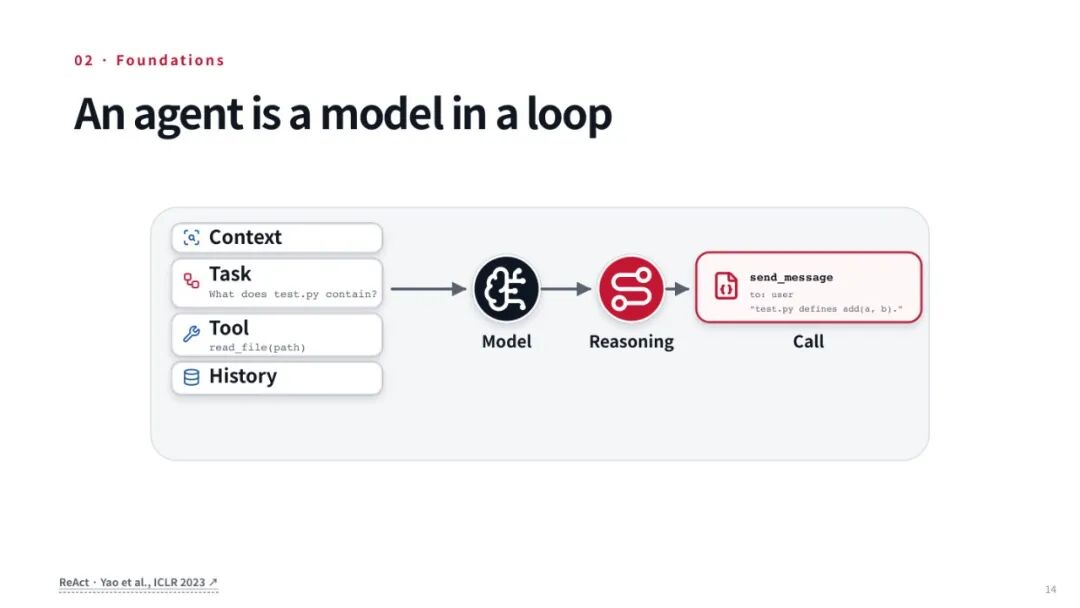
任务、工具和历史共同构成上下文;读取结果进入历史后,模型据此生成回复。
每次行动得到的结果,都成为下一次判断的依据。 ReAct 所强调的推理与行动相互连接,就可以从这个循环开始理解。
课程用 mini-swe-agent 的精简代码展示了这种结构:先初始化消息,再反复查询模型、执行动作,把模型输出和环境观察追加到消息历史中。如果照着这个循环自己实现 Agent,还要考虑终止条件、错误处理和资源限制。
循环如何推进,可以在执行轨迹里直接看到。课堂展示的一条 SWE-bench 示例轨迹中,模型发出 Bash 命令,环境返回退出码,然后进入下一轮。退出码 0 说明这条命令执行成功;整个编程任务有没有解决,还要看最终结果和测试。
另一段 OpenHands 演示展示了 Flask 待办应用的开发过程:Agent 检查日志,发现端口占用,继续尝试启动;打开浏览器后,又测试添加和删除待办事项。代码、日志与界面都进入了同一条行动链。遇到问题之后能否读取反馈、调整下一步动作,是理解这个过程的重点。
4. 要完成长任务,Agent 还需要六项能力
一个简单循环能跑起来,距离完成复杂任务还有很长一段路。工具可能选错,任务历史可能丢失,多个子任务可能互相冲突,执行权限也可能失控。课程把这些挑战归纳为六项能力,并给出了两条建设路径。
一条是模型训练:通过预训练、监督微调(SFT)或强化学习(RL),改变模型自身的行为。另一条是运行控制层(Harness)工程:调整模型周围的提示词、工具、记忆与控制流程,为它提供上下文、校验、重试和执行边界。
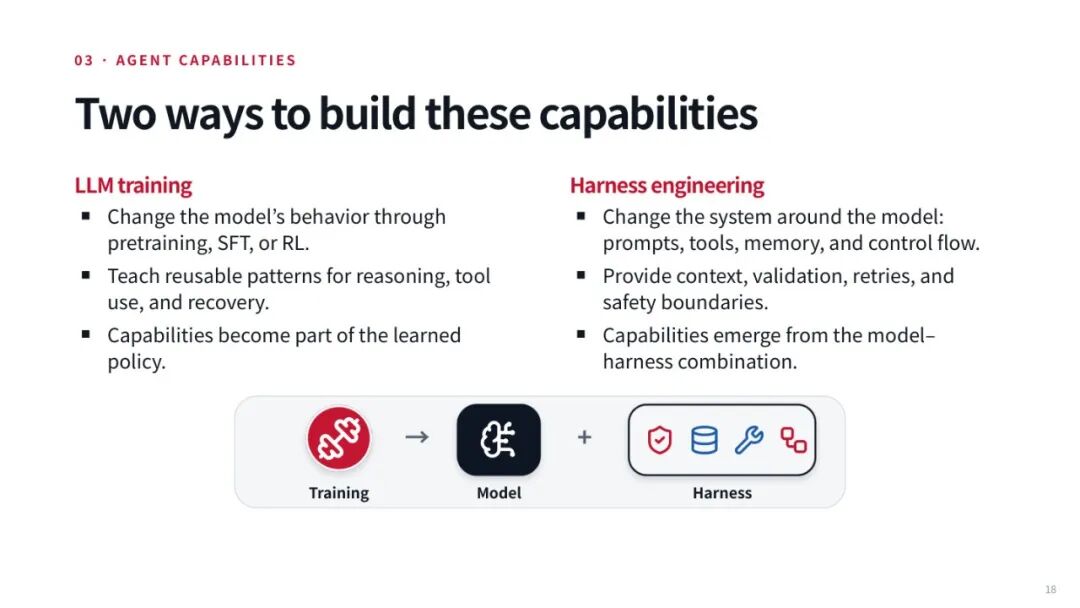
模型训练改进模型行为,运行控制层工程组织任务与执行过程。
Graham 在课堂中给出了他的个人判断:很多问题会先通过系统工程处理;当问题重要到值得专门训练模型时,再让训练跟进。他更倾向于在有条件时通过训练解决问题,但训练需要时间,长上下文的计算效率、用户定制等问题,也仍然需要系统工程。他同时提醒,若干能力目前还没有解决。具体选择取决于问题,两条路径没有一种始终更好。
工具调用:选对工具,也给对参数
让输出符合 JSON 等格式,只解决了调用的一部分。模型还要知道什么时候用什么工具、参数是否符合任务要求。运行控制层可以通过受语法约束的解码和参数校验减少格式错误;模型则可以通过工具调用轨迹的监督训练,学习选择工具与组织参数。
长上下文连贯性:任务做久了,仍记得关键约束
任务越长,消息历史越多。系统需要保留相关信息,避免后续行动失去先前的约束。工程方法包括压缩上下文、动态检索记忆、将部分工作委派给子 Agent;训练方法包括长上下文 SFT。更长的上下文窗口提供了空间,但系统如何使用这段空间,同样影响表现。邮件案例中的“先审批”就是一种需要持续保留的约束。
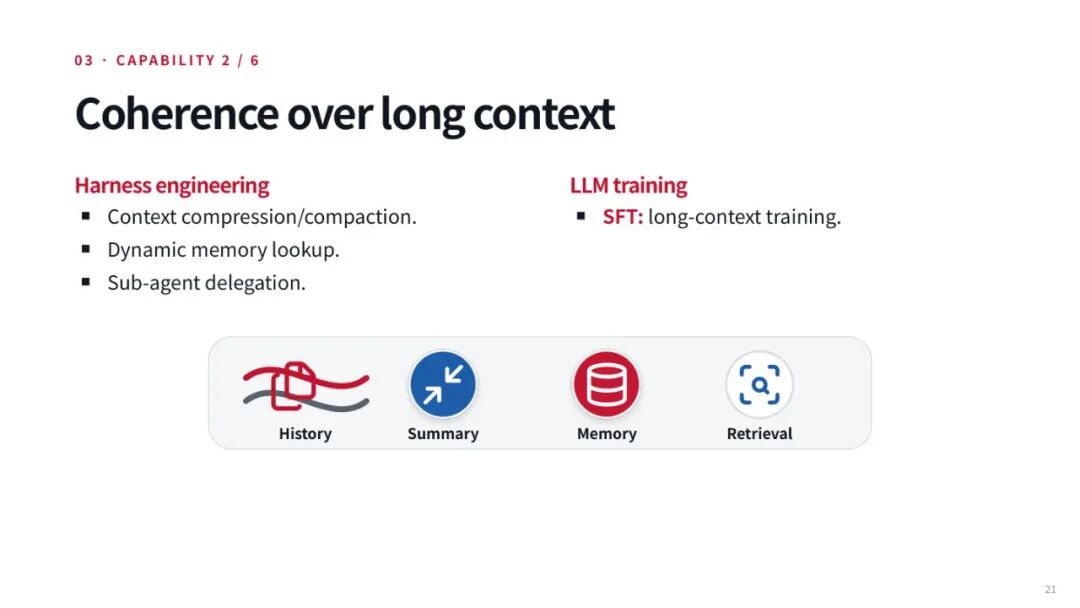
摘要、记忆和检索帮助管理不断增长的任务历史。
可定制性:适应不同用户和任务
Agent 需要知道特定用户的偏好、领域规则和可用工具。运行控制层可以通过记忆、skills 和自定义工具提供这些信息;模型也可以通过强化学习,从用户反馈中学习。定制信息放在哪里,要看它的性质。有些适合进入模型行为,有些更适合在具体情境下,以脚本或独立指令提供。
复杂任务管理:拆分之后,还要验证
规划、任务分解和子 Agent 委派,可以帮助系统推进复杂工作。模型也可以在复杂、长时间跨度的任务中接受训练。其中容易被忽略的一步是验证:子任务完成后,还要检查结果能否支撑整体目标。多个 Agent 各自输出了答案,仍然需要有人或某个控制过程负责整合与检查。
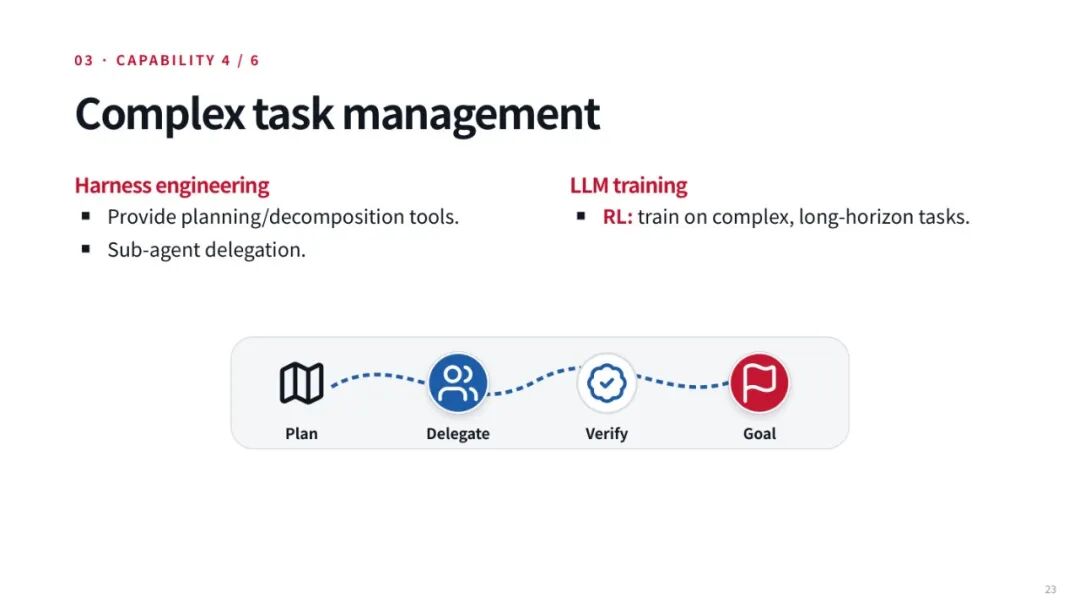
规划与委派推动任务展开,验证检查结果是否支撑目标。
环境理解:读懂实际收到的信息
代码仓库、网页和截图提供的信息形式不同。Agent 必须理解自己面对的环境,才能做出合适动作。工程侧可以提供包含领域知识的技能;训练侧可以使用符合实际观察形式的数据做 SFT,也可以在特定环境中做 RL。观察是什么样的,直接影响系统需要学会理解什么。
安全:把权限落实到执行过程
课程提到的工程方法包括工具执行沙箱、凭证访问限制和任务轨迹监控;训练侧则包括考虑安全的强化学习。这些机制需要进入实际执行链。允许访问哪些文件、调用哪些接口、在什么情况下需要审批,都应在动作发生时得到约束。开场的邮件案例说明,一项重要限制如果只依赖模型记住,可能在长任务中变得脆弱。
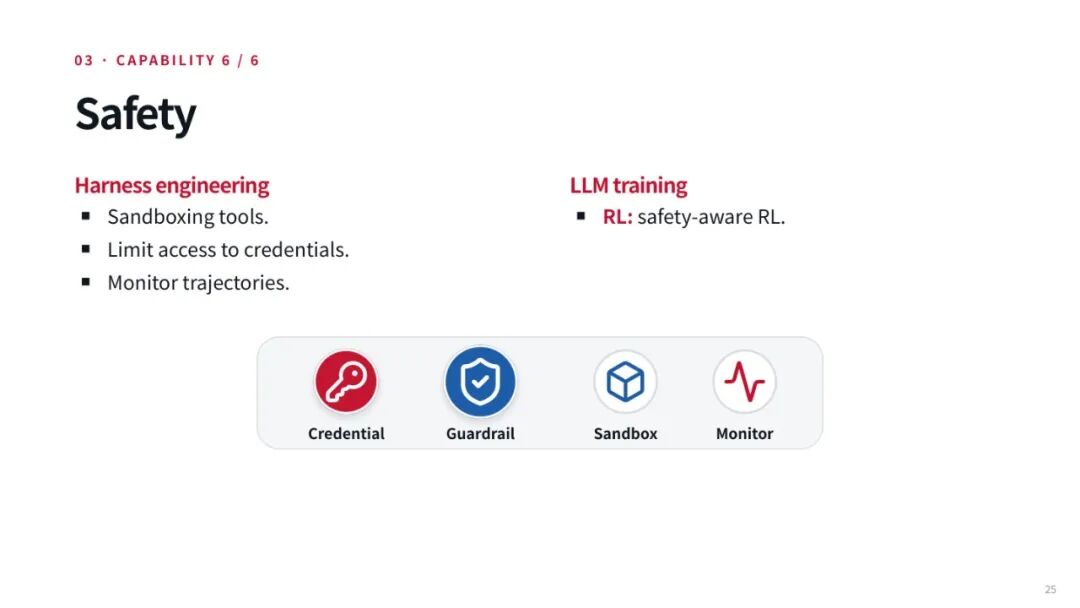
沙箱、凭证限制与监控,共同约束 Agent 的执行范围。
5. 一个完整的 Agent 系统,由哪些部分组成?
把前面的概念拼起来,就能看到模型周围需要怎样的基础设施。
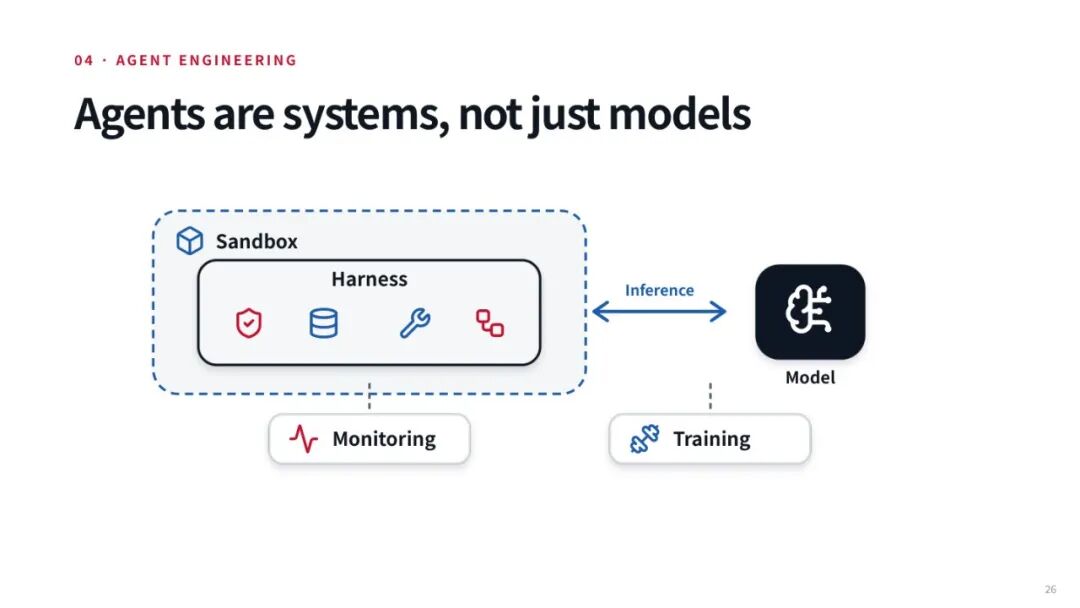
模型负责生成判断与动作,其他组件支撑执行、改进和观察。
运行控制层管理状态、工具、记忆和控制流程,处理参数校验、执行错误与权限。沙箱隔离代码和工具执行,限制计算、网络与文件系统访问,并帮助提供可复现的环境。
推理服务负责模型请求的实际运行,包括批处理、缓存复用、流式输出、并行和吞吐管理。它影响系统能否以合适的速度和成本持续推进任务。
训练系统负责准备数据、收集任务轨迹、组织训练、保存模型检查点并进行评估。可观测性与监控则记录轨迹和指标,让我们能追踪质量、费用与失败,比较不同执行过程的结果。
当一个 Agent 没有完成任务时,这张图也提供了一条排查思路:是模型选错了动作,历史信息没有组织好,工具执行出了错,还是最终结果缺少验证?把问题落到具体组件上,改进才有明确的着力点。
6. 想自己动手,可以从一个小循环开始
课程的实践路线是先搭建 Agent,再评估表现,最后通过训练或系统调整改进能力。沿着这条路线,第一次实践可以很小。
先让一次调用完整发生。 只接入 read_file 这类单一工具,走完“任务—调用—执行—观察—回复”。保留每一步消息,检查回答是否确实依据工具返回内容。
再让表现可以测量。 选择一组明确的任务,定义成功条件,记录通过与失败。查看失败发生在哪一步:工具、参数、上下文、执行过程,还是最终判断。
最后根据失败改进。 可以先改变工具说明、记忆组织或控制流程;有训练条件时,再考虑让模型学习相应行为。比较改动前后的任务结果、成本与稳定性。
这是一组依据课程思路整理的入门练习。它会让“工具、记忆、规划、安全”从术语变成实现中需要回答的问题:模型凭什么选择这个动作?执行结果如何回来?什么时候继续,什么时候停止?最终完成了什么?带着这些问题再去搭建 Agent,每一步都会有更清楚的目的,也有可以检查的结果。
延伸阅读
 发表于 7 小时前
|
查看: 1|
回复: 0


