在当前的 AI 辅助编程环境中,很多开发者都面临一个尴尬的割裂:你为 Claude 付了费,在终端里装着 Claude Code,但在日常写代码的主战场——Cursor、VS Code 或 OpenCode 里,却无法直接使用这份订阅额度。
为了在一个界面里调用所有模型,社区过去最常见的做法是搭建一个转译网关,截获编辑器发出的请求,篡改请求头并附带凭证转发给官方接口。但在实际运行中,这种思路越来越难以为继:服务商的安全校验与上下文检测日益严密,轻则无法命中官方的 Prompt 缓存导致延迟激增,重则触发接口异常与账户权限限制。
开源项目 Magpie(来自知名开源作者 yetone,也是 avante.nvim 的作者)给出了一个截然不同的工程思路:它放弃了协议层模拟与网络头伪造,通过独立配置目录隔离环境,直接在后台驱动官方命令行工具完成交互。
这种把官方 CLI 当作本地运行时的做法,运行特征与人工在终端操作完全一致。这篇文章深入它的源码,拆解这套设计的底层实现与工程权衡。
为什么传统的 API 转译思路走不通了?
要理解 Magpie 的解法,得先看传统转译网关为什么频频失效。
以往的转译网关,核心工作是充当协议层翻译器。客户端发来 OpenAI 格式的请求,网关将其转换成 Anthropic 格式,再附带用户的凭证转发到服务端。但这套逻辑在面对新一代官方命令行(如 Claude Code)时遇到了明显阻碍。服务商在防御与识别层面主要设置了三重机制:
- System Prompt 语义分类:服务端会对请求内容进行实时分类。如果请求里的系统提示词带有其他编辑器的特征(例如 Cursor 的 harness 指令),即便附带的凭证完全合法,请求也容易被识别为第三方调用,进而转入独立计费通道或受到访问限制。
- 动态指纹与会话元数据:官方客户端在每次交互时都会生成动态的上下文哈希与计费头部,任何静态模拟的请求在经历多次轮换后都容易暴露出协议层的不一致。
- 缓存击穿带来的延迟与成本:第三方代理每次拼装上下文时,通常无法精确重构官方客户端的 Prompt 分块结构。这会导致原本官方提供的长上下文缓存直接失效,响应延迟成倍增加,费用随之飙升。
只要停留在 HTTP 协议层去模拟官方客户端,就必须持续跟进厂商的校验规则变动,在工程上处于被动应对的状态。
Magpie 的核心架构:配置隔离与后台 CLI 托管
既然在网络协议层模拟官方客户端的维护成本过高,另一种思路应运而生:直接将官方客户端作为本地受控进程运行。
在 Magpie 的架构中,本地网关(默认监听 127.0.0.1:3425)对外依然提供标准的 OpenAI、Anthropic 与 Gemini 接口,但当它需要调用 Claude 订阅时,它直接在后台调起本地安装的 claude 官方二进制程序。
整个方案建立在三个底层的工程实现之上。
1. 独立配置目录实现账号隔离
多账号切换是终端工具的一大痛点。在官方设计中,登录凭证通常保存在固定的用户目录(如 ~/.claude/.credentials.json)或系统钥匙串中。如果在同一个环境中频繁切换账号,凭证很快会被互相覆盖。
Magpie 的解决办法非常轻量:利用官方 CLI 原生支持的环境变量 CLAUDE_CONFIG_DIR。
在源码的 internal/provider/claude_dirs.go 中,Magpie 为每个配置的账号分配一个独立的哈希目录:
claude-accounts/<account-hash>/
  ├── .credentials.json
  └── settings.json
在 macOS 上,钥匙串的存储标识也会附带该目录的特征哈希(Claude Code-credentials-<hash>)。
每一个账号在磁盘上都是一个完全独立的配置沙盒,Token 刷新与凭证持久化全部由官方 CLI 内部逻辑自动完成。 Magpie 本身无需解析或接管 OAuth 刷新流程,只负责在启动进程时将环境变量指向对应目录。对官方服务端而言,收到的完全是来自独立工作目录的标准终端会话。
2. 长连接进程池与上下文增量写入
频繁新建进程带来的冷启动开销显然无法满足交互式编程的需求。Magpie 在 internal/gateway/claude_subscription.go 中构建了一个长连接会话池:
const (
    claudeCacheTTL = time.Hour
    idleLongest    = claudeCacheTTL
    idleMost       = 6
)
启动参数中,Magpie 让官方 CLI 以流式 JSON 形式交互:
claude -p --output-format stream-json --input-format stream-json \
  --include-partial-messages --verbose --model <model> \
  --tools <tools> --strict-mcp-config --mcp-config <mcpConfig> \
  --setting-sources "" --dangerously-skip-permissions ...
当一轮对话结束时,后台的 claude 进程并不退出,其标准输入(stdin)持续保持打开,并在内存中维持最多 1 小时的会话窗口。当用户在编辑器里发起下一轮对话时,Magpie 仅将新增的消息增量追加写入 stdin。
这一机制带来了显著的性能收益:由于进程和会话连接保持存活,Anthropic 服务端提供的 1 小时 Prompt 缓存能够高概率命中,省去了绝大部分首字等待时间。
当用户在前端主动中断请求时,Magpie 并不强行杀死进程,改为向 CLI 发送内部回退指令,把对话状态撤销到前一个回合,将已经缓存好的上下文完整保留下来。
3. 阻塞式 MCP 双向挂起桥接
其中最具巧思的设计,在于跨生态工具调用的处理。
如果后台运行的是官方 claude 进程,而前端发起请求的是 Cursor 或 OpenCode,前端定义的那些本地工具(例如读取当前项目文件、执行特定命令)如何跨进程执行?
Magpie 利用了 Claude 原生支持的 MCP(Model Context Protocol)扩展协议:
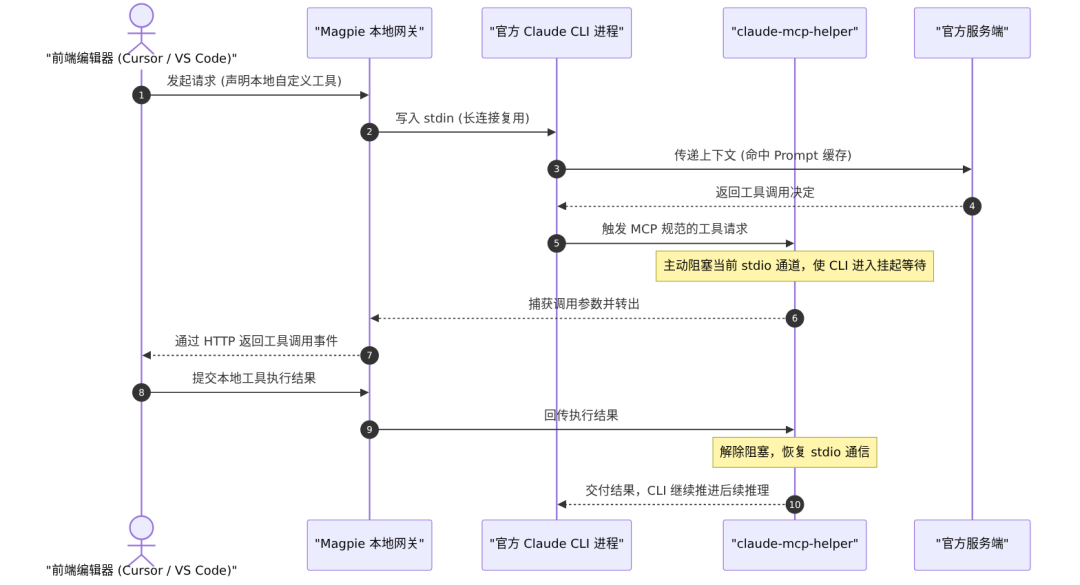
整个交互过程形成自洽闭环:上层编辑器面向标准 API 规范发起请求,下层大模型则基于官方支持的 MCP 协议调度本地工具。 双方在各自熟悉的通信机制下完成协作,省去了中间层对工具定义的二次转换。
架构演进:大模型接入的三层范式
从系统设计的角度审视,Magpie 的实践展现了大模型工具接入在架构演进上的清晰脉络:
| 集成层级 |
核心交互机制 |
协议保真度 |
维护成本与对抗性 |
典型方案 |
| L1: 协议模拟层 |
逆向 HTTP 接口,抓包模拟客户端 Headers 与指纹 |
脆弱,易被语义分类器与动态哈希标记 |
较高,需随官方防御策略频繁更新 |
第三方转译网关 |
| L2: 原语托管层 |
本地拉起官方二进制,利用独立配置沙盒隔离会话 |
极高,完全复用官方客户端的原生行为与凭证流 |
较低,底层认证逻辑由官方自行维护 |
Magpie 的 CLI 进程池 |
| L3: 协议穿透层 |
利用标准扩展协议(如 MCP)实现跨进程双向通信 |
标准化,依托官方原生支持的通信规范 |
中等,需处理 stdio 阻塞与并发调度 |
Magpie 的 MCP 工具桥 |
很多时候,工程直觉倾向于通过网络抓包和 HTTP 转发来寻找最简路径。然而在大模型交互中,厂商的客户端指纹与语义审查已经深入到请求载荷与上下文序列之中。
当协议模拟的维护代价超过了本地进程的调度开销时,直接托管真实运行时就变成了更稳固的工程选择。
工程权衡与未来观察
在肯定这套架构精巧性的同时,也需要客观评估其适用的工程边界。
首先是并发承载与资源开销的权衡。CLI 托管模式在本地单机或小规模开发者环境中表现出色,但每个活跃会话都需要维持独立的系统进程与内存占用。若尝试将其放置在数百人并发的集中式团队服务中,进程调度开销与内存水位会显著高于无状态的轻量网关。它更适合作为个人开发机或私有工作站的高保真接入层,而非公网高并发的分发枢纽。
其次是大模型客户端的形态演变。从工程趋势来看,大模型的交互载体正从单一的无状态 HTTP 接口,逐步过渡到融合了本地上下文管理、工具调度与环境校验的复合运行时。
随着客户端安全校验与 Prompt 缓存深度的持续提升,下游生态对模型的集成方式,正在逐步从网络层的逆向模拟,迁移至操作系统级的运行时托管与标准化协议桥接。这一转变所反映的,正是大模型工具链走向成熟过程中必然经历的工程分工重塑。对于正在探索多模型统一接入方案的开发者来说,Magpie 的思路无疑提供了一个值得深入研究的样本,类似的讨论在云栈社区也时有出现。
 发表于 2 小时前
|
查看: 7|
回复: 0


