米尔电子最近拿出一套车载双视觉方案,一套系统同时做两件事:360环视负责监控车外,DMS驾驶员监测负责盯着车里的司机。
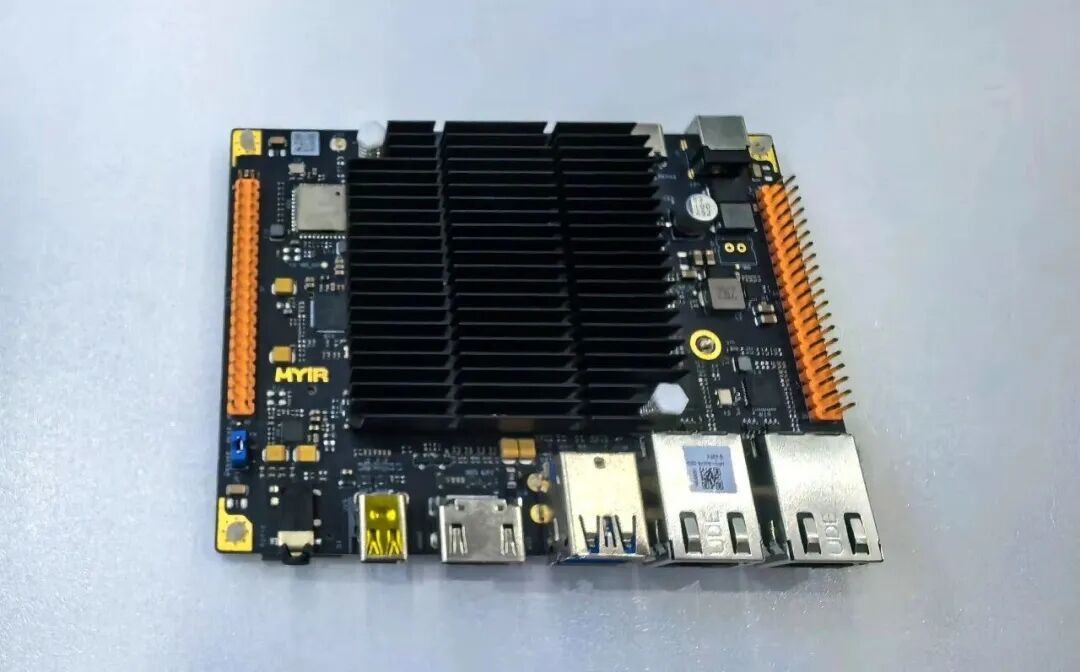
这套系统使用的硬件平台是RK3576,四核A72加四核A53,GPU是Mali G52,还内置一颗6TOPS的NPU。
系统跑的是Linux 6.1.75,摄像头配置为四路720P鱼眼加一路1080P MIPI RGB,这颗RGB专门用来监控驾驶员。
这套方案很直观,也是行业里常见的做法:整条链路全交给OpenCV,采集、去畸变、透视投影、鸟瞰拼接、显示一条龙。功能一次就调通了,四路鱼眼拉直、拼成俯视图,逻辑全对,相当完美。
但是一测端到端延迟,居然有300毫秒,远超25fps对应的40ms帧延迟预算。也就是说车开起来,屏幕上是0.3秒之前的世界,这玩意装上车没法用。
问题出在哪?我第一反应是四路视频同时算,A72扛不住了。但仔细剖析了一遍,才发现实时性的瓶颈并不在算法复杂度。真正让延迟飙到300ms的根本原因居然在搬数据——全链路在密集搬运不必要的数据。
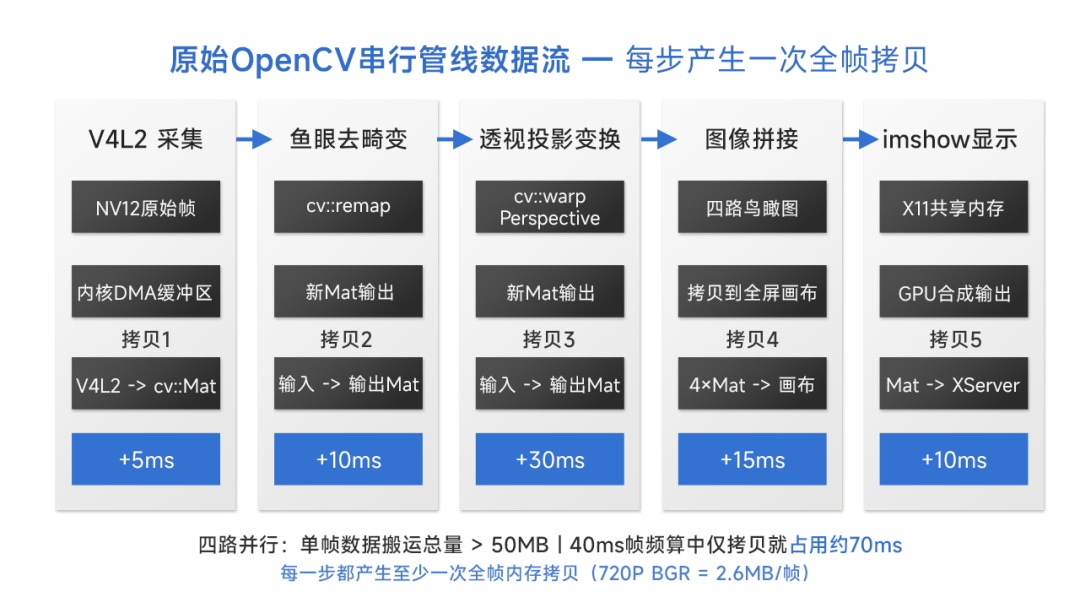
上面这张图就是原方案的五个步骤,串着跑,每一步都要把整帧图像在内存里倒腾一遍。720P的BGR帧,一帧就是2.6MB,四路相机并行,一个处理周期光搬运就超过50MB。这还没算OpenCV函数内部那些看不见的临时缓冲。
打个比方,等于请了四个大厨炒菜,每道工序之间还要派卡车把锅端去另一个厨房,端锅的时间比炒菜还长。
为了突破CPU的性能瓶颈,把去畸变和投影变换搬到了GPU,用OpenCL跑。效果还是有的,去畸变从10ms干到1ms,投影从30ms压到8ms。但是cv::Mat和cv::UMat是两套内存,数据进出GPU要显式上传下载,一来一回25ms。结果省下来的31ms加速,被这25ms搬运吃掉一大半。
到这一步,方向就很清楚了:别再琢磨更快的算法,应该把拷贝本身干掉。
米尔给出的解法是DMA-BUF。说白了就是:让V4L2、RGA、CPU和DRM四家共用同一块物理内存。互相传个文件描述符就行,谁都不许复制数据。
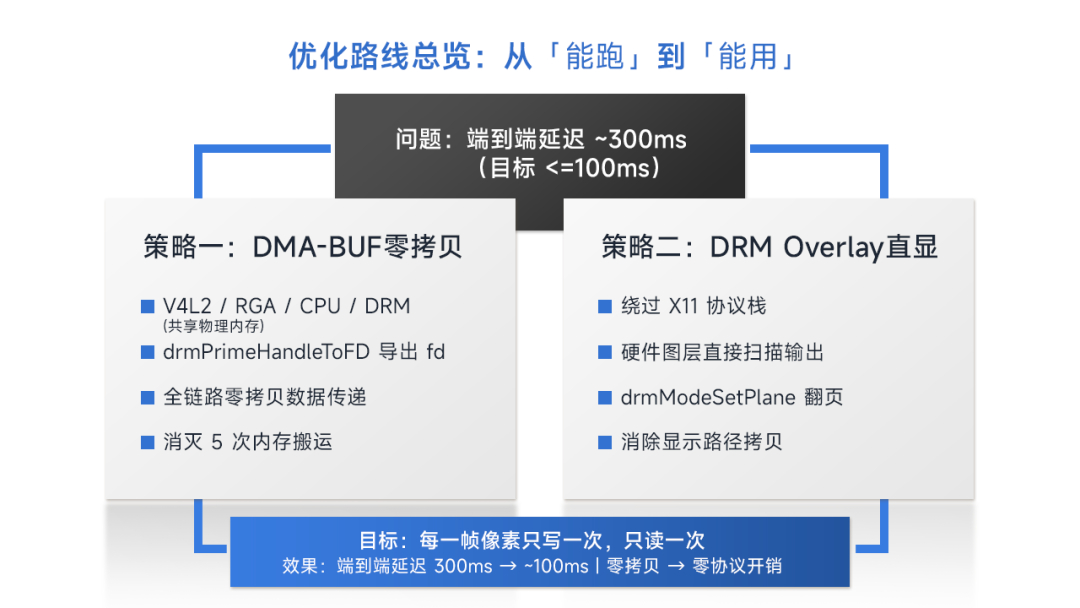
显示端也同步配合,把cv::imshow换掉。直接调drmModeSetPlane,把内存挂到Overlay Plane上,硬件按VSYNC扫描出画面。提交动作0.1ms,还是非阻塞的,顺带把X11这个中间商开除了。
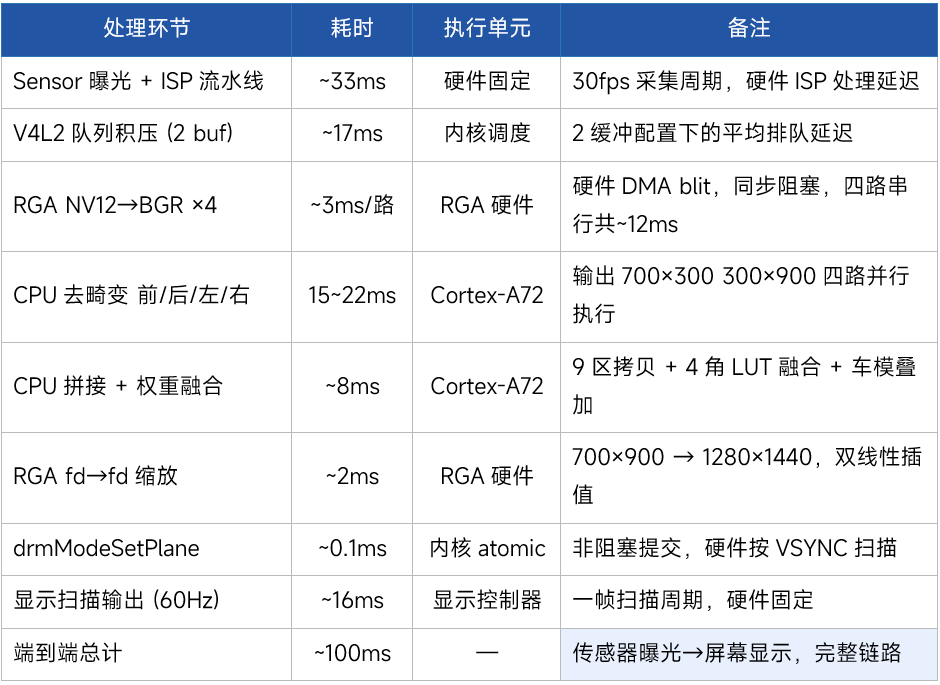
优化后的整条管线,捋一遍大家感受下。
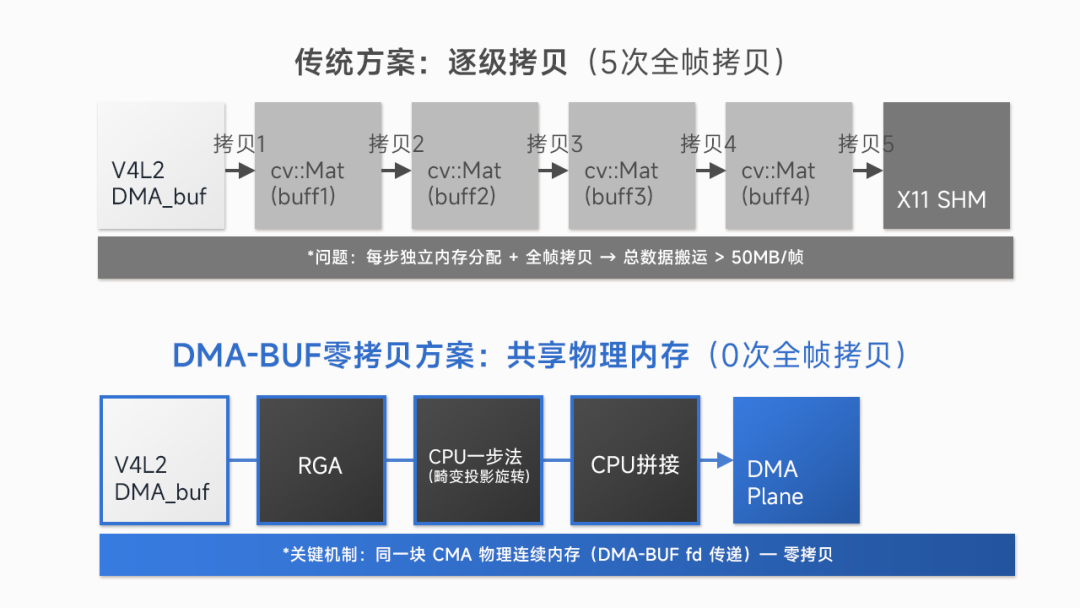
摄像头通过V4L2直接DMA写进物理内存,全程CPU都没什么事做,几乎处于空闲状态。RGA做NV12转BGR,硬件搬运,一路约3ms。CPU做去畸变,cv::Mat直接架在DMA-BUF映射出来的指针上,一次额外内存分配都没有。鸟瞰拼接也在CPU上,九宫格布局,权重图融合,再贴个车模,8ms。接着交给RGA做一次fd到fd的缩放,还是硬件DMA,2ms。最后drmModeSetPlane绑定显示层,直接推送到屏幕。
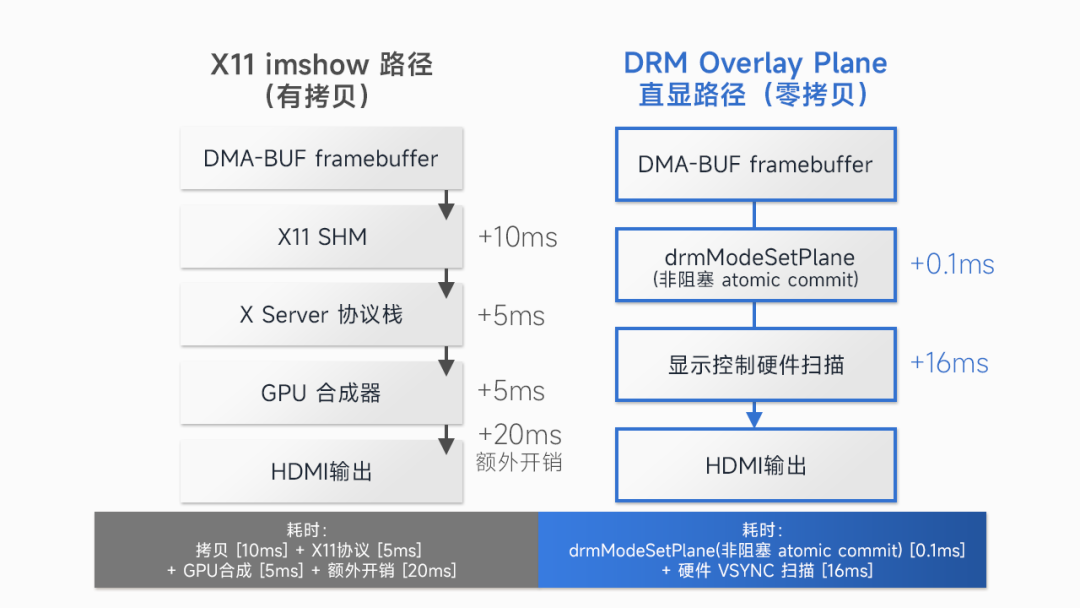
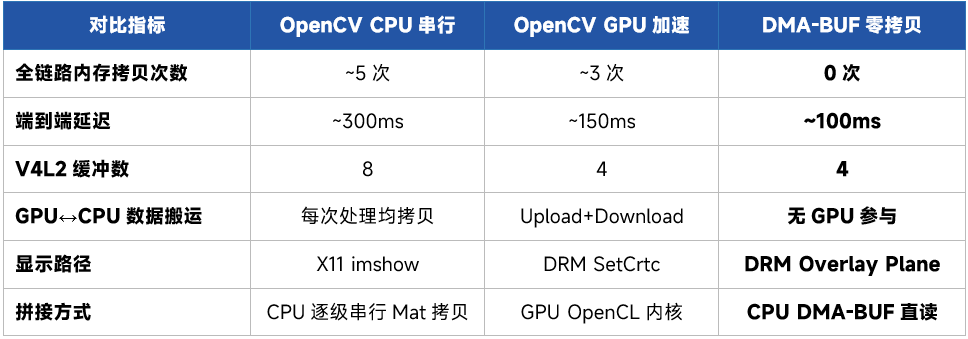
从采集到显示,每帧像素只写一次、只读一次,原来那五次全帧拷贝一个不剩。端到端延迟从300ms降到100ms左右,没有GPU方案那种时快时慢的毛病,行为稳定可复现。
当然,100ms离40ms预算还有距离,但最大的那块石头已经搬走了,接下来的优化就有迹可循了。
将DMA-BUF优化方案与原始方案并列对比,优化的价值还是挺直观的。
再看另一只摄像头,DMS。一路1920×1080的RGB摄像头装在驾驶位前方,怼着驾驶员的脸。画面喂给RK3576那颗6TOPS的NPU做实时推理。
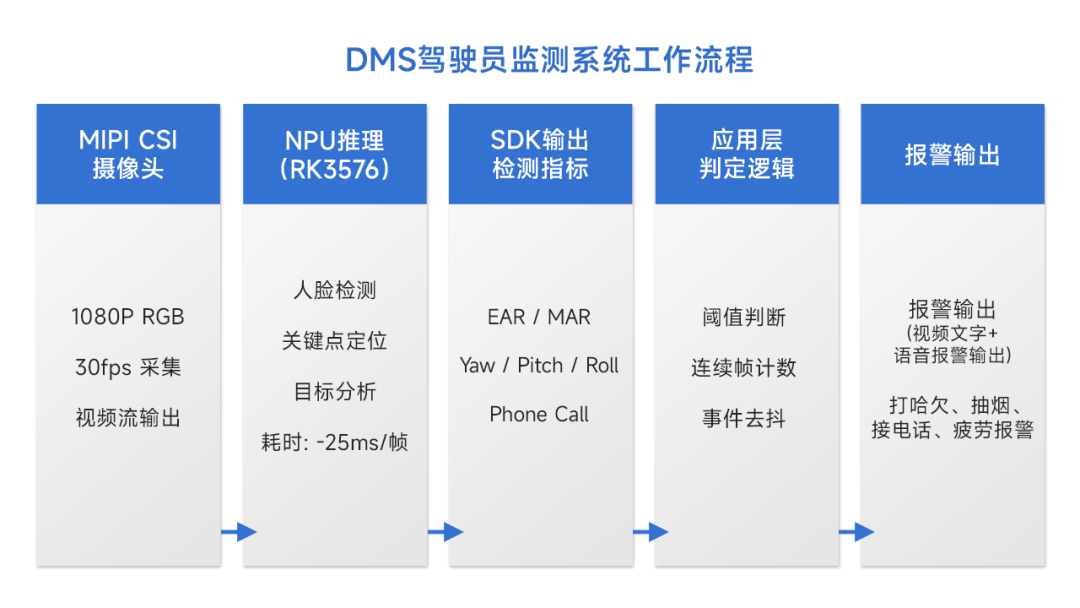
模型是瑞芯微官方的打包模型,rkdms_3576.data,才4.9MB。这个模型装着人脸检测、关键点定位、属性分析一堆子模型。
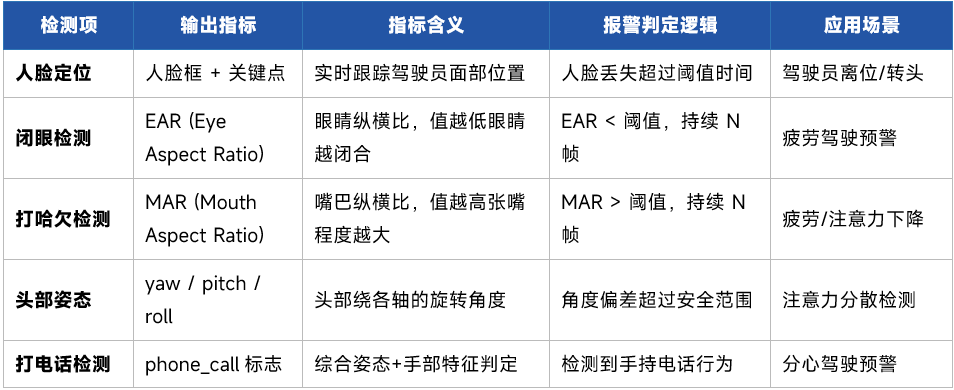
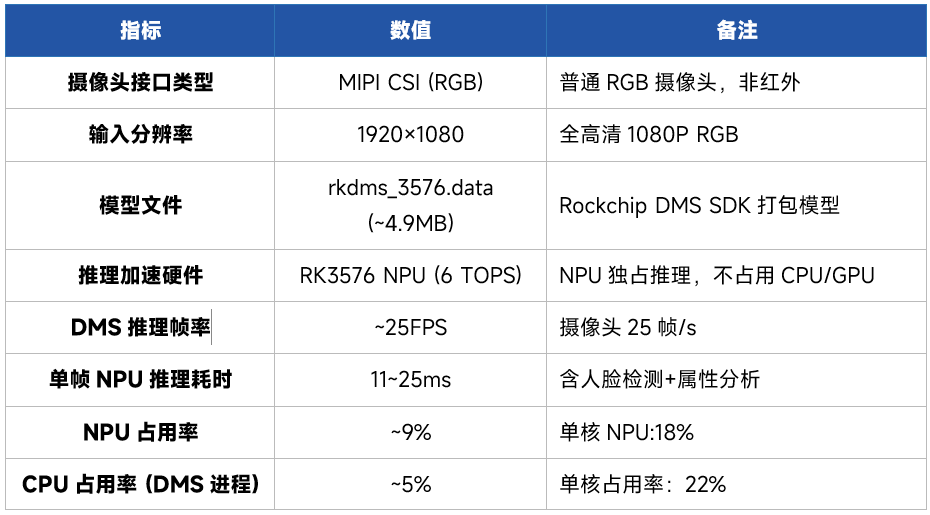
它负责识别四件事:闭眼疲劳、打哈欠、开车打电话、抽烟。
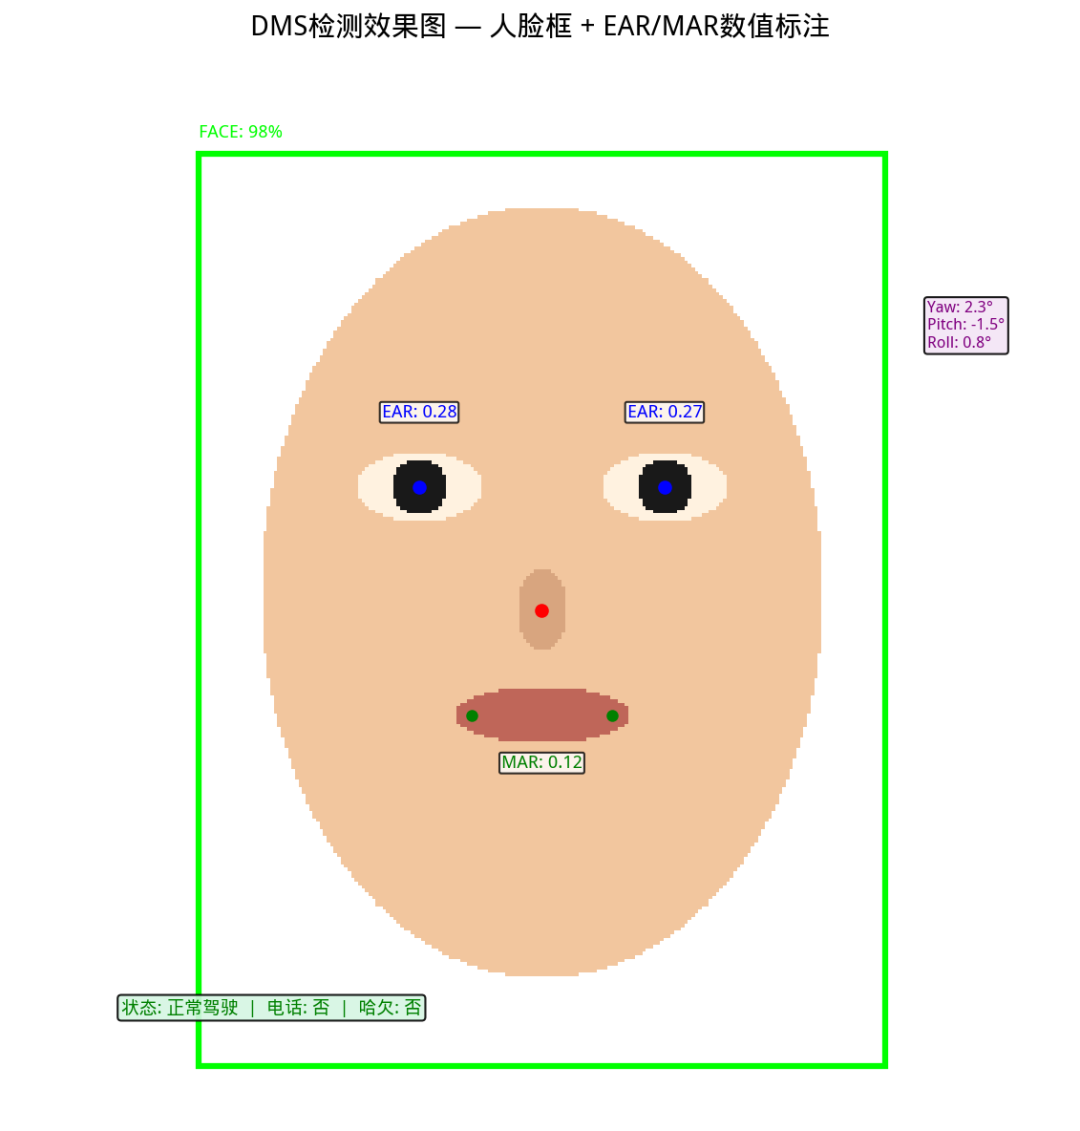
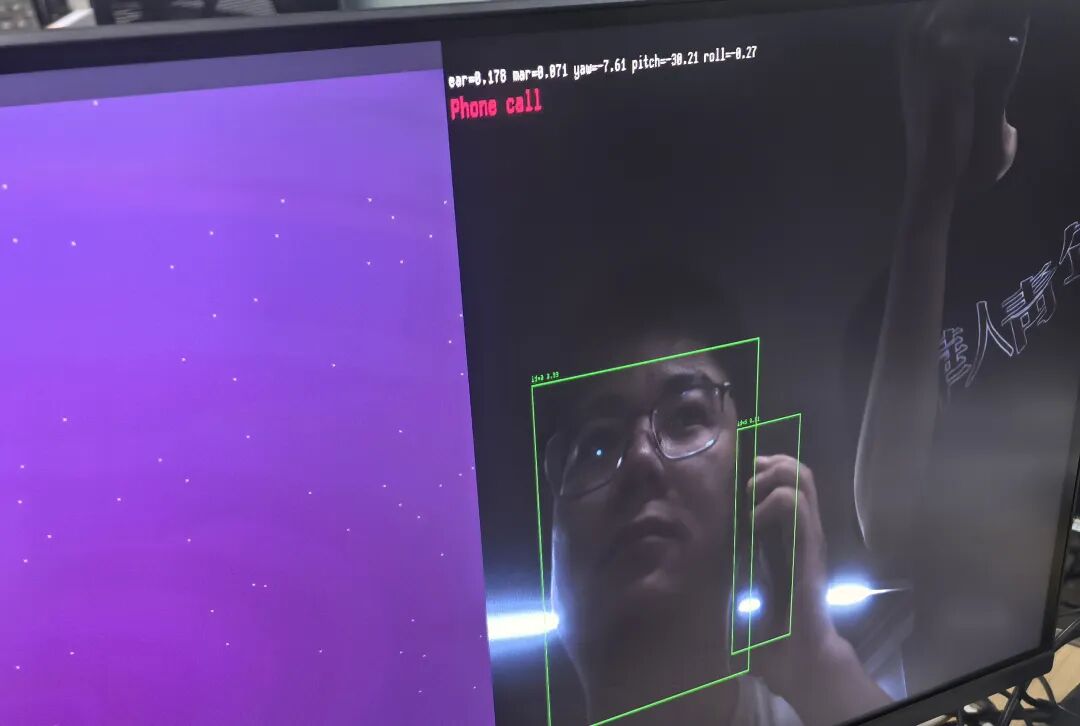
任何一项被触发,就放本地语音报警,fatigue.wav、yawning.wav、phone.wav、smoking.wav,各放各的。有个前提要交代:这套模型要向瑞芯微申请license才能用,不是拿来就能跑。
那么这两套系统怎么同时给司机看?
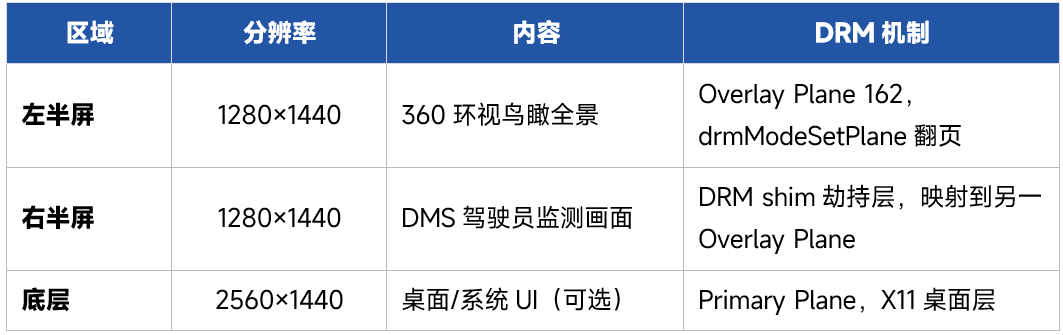
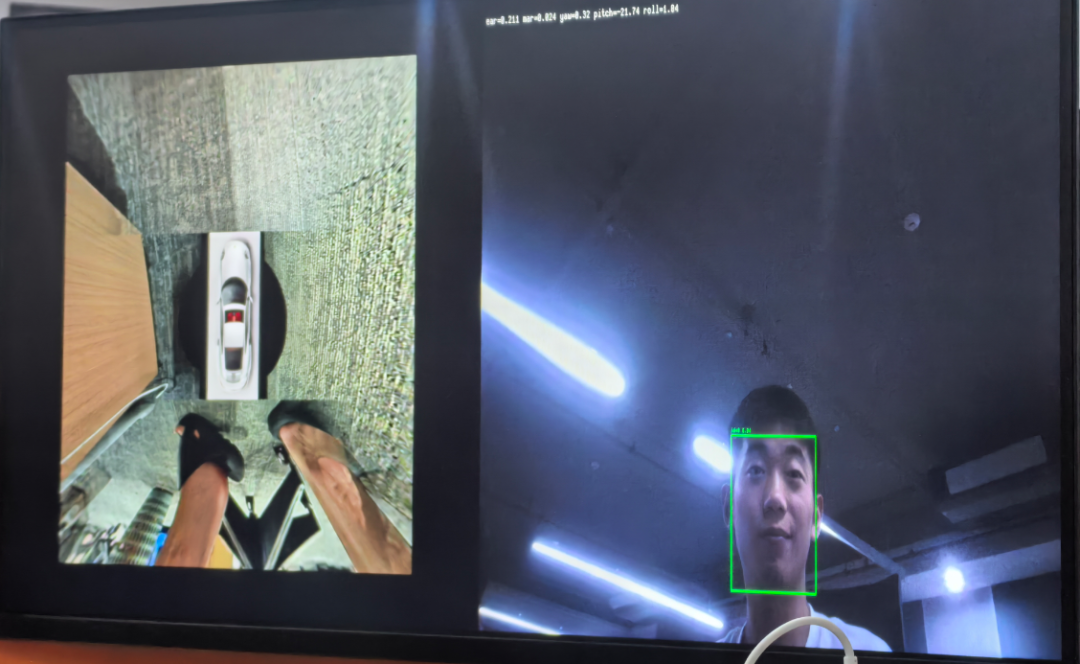
一块2560×1440的屏,左边环视右边DMS,靠的还是DRM的Overlay Plane分屏。这是两个独立进程,各跑各的,谁崩了都不连累对方。
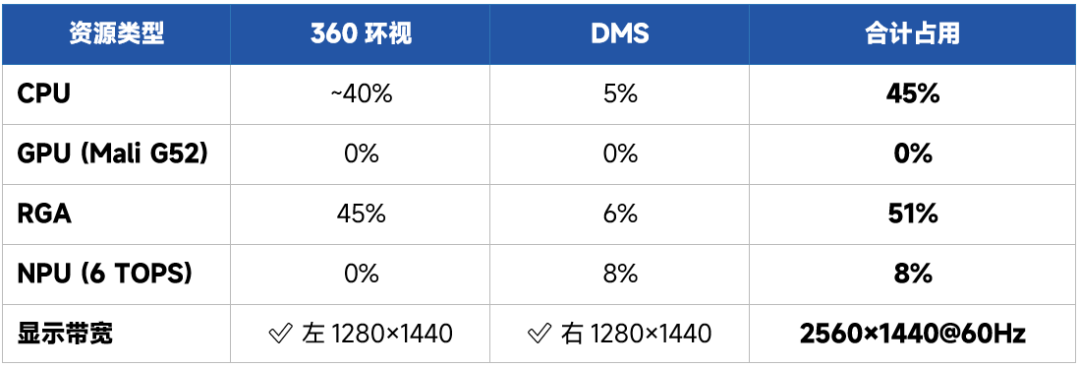
这个系统里的资源占用各有特点:环视吃CPU和RGA,DMS吃NPU,GPU全程闲着。三种算力各干各的,谁也不抢谁的道,这才是异构SoC的正确打开方式。
这次优化的核心成果如下:
1、把端到端延迟从300ms降至约100ms:通过全链路DMA-BUF零拷贝,消除了从采集到显示的5次内存搬运,也彻底消除了GPU方案的波动问题,系统行为稳定可复现。
2、双视觉系统同屏集成:360环视与DMS驾驶员监测在单块2560×1440屏幕上左右分屏同时运行,独立进程架构保证了系统的模块化和鲁棒性。
3、异构计算资源协同:360环视跑CPU+RGA,DMS跑NPU,GPU几乎空闲。三种计算资源各司其职、并行不悖,充分发挥了RK3576异构架构的潜力。
总结:嵌入式平台上做实时视觉类项目,第一瓶颈往往不是算力,而是数据搬运。GPU能加速计算,但消灭不了搬运,搬运转头就转嫁到GPU和CPU之间的总线上,搞不好更慢。DMA-BUF和DRM都是Linux内核白送的基础设施,不要钱,就看你会不会用。像这类内核优化实践,在云栈社区也有不少开发者一起交流探讨。
 发表于 2 小时前
|
查看: 7|
回复: 0
 /1


