多年不用 PageHelper 了,最近新入职的公司,项目框架里正好集成了这个工具,而且是一个独立紧急项目的基础。开发过程本身倒还算顺手,但没想到最后测试阶段,它狠狠地给我上了一课。
我的项目发生了哪些奇葩现象?
一切都要从接手这个项目说起。开发过程中碰到了各种离谱的问题,我挑几个典型的说说。
账号重复注册?
你肯定在想这是什么意思?就是字面意思:已经注册过的账号,居然能再次注册成功!
else if (UserConstants.NOT_UNIQUE.equals(userService.checkUserNameUnique(username))
        || "匿名用户".equals(username)){
    // 注册用户已存在
    msg = "注册用户'" + username + "'失败";
}
如上所示,checkUserNameUnique(username) 用来验证数据库里是否已经存在该用户名:
select count(1) from sys_user where user_name = #{userName} limit 1
正常来说这段逻辑没啥问题,具体原因我们后面再讲,继续看下一个问题。
查询全部分类的下拉列表只能查出 5 条数据?
如上所示,明明有十几个结果,怎么只返回了 5 条?我好像也没有添加分页参数啊?
相信用过 PageHelper 的同学已经猜到问题出在哪里了。
修改用户密码报错?
当管理员在后台重置用户密码时,居然直接报错了。
报错信息很清楚地告诉我:SQL 语句异常,update 语句不认识 Limit 5。
到这里,问题已经比较明确了:我的 SQL 被拼接了该死的 limit 分页参数。
小结
上面提到的还只是冰山一角。在使用过程中,凡是涉及 SQL 的地方,都可能因为这个分页参数出问题。我大致把它们分为两类:
- 直接导致报错的:能明确看到报错原因
比如 insert、update 等语句,本身不支持 limit,就会直接报错。
- 导致业务逻辑错误,但代码没有明显报错提示
比如前面提到的用户可以重复注册,代码里其实有报错,但当前方法对异常进行了 throw,最终被全局异常捕获了。
不分页的 SQL 被拼接了 limit,导致没有报错,但返回的数据量是错误的。
需要注意的是:异常不是每次都出现,是有一定几率的,但触发概率较高,原因后面会慢慢展开。
PageHelper 是怎么做到这些问题的?
PageHelper 使用
这里只讲项目所用框架里的使用方式。
代码如下:
@GetMapping("/cms/cmsEssayList")
public TableDataInfo cmsEssayList(CmsBlog cmsBlog){
    // 状态为发布
    cmsBlog.setStatus("1");
    startPage();
    List<CmsBlog> list = cmsBlogService.selectCmsBlogList(cmsBlog);
    return getDataTable(list);
}
使用起来很简单:通过 startPage() 指定分页参数,再用 getDataTable(list) 把结果封装成分页格式。
有些同学会问:这里也没传分页参数啊,实体类里也没有。这正是有意思的地方,下一小节我们看源码。
startPage() 干啥了?
protected void startPage(){
    // 通过 request 去获取前端传递的分页参数,不需要控制器显示接收
    PageDomain pageDomain = TableSupport.buildPageRequest();
    Integer pageNum = pageDomain.getPageNum();
    Integer pageSize = pageDomain.getPageSize();
    if (StringUtils.isNotNull(pageNum) && StringUtils.isNotNull(pageSize))
    {
        String orderBy = SqlUtil.escapeOrderBySql(pageDomain.getOrderBy());
        Boolean reasonable = pageDomain.getReasonable();
        // 真正使用 PageHelper 进行分页的位置
        PageHelper.startPage(pageNum, pageSize, orderBy).setReasonable(reasonable);
    }
}
PageHelper.startPage(pageNum, pageSize, orderBy).setReasonable(reasonable) 的参数分别是:
- pageNum:页数
- pageSize:每页数据量
- orderBy:排序
- reasonable:分页合理化,对于不合理的分页参数自动处理,比如 pageNum 小于 0 时,会默认设置为 1
继续跟踪,一路点到 startPage 构造方法,会来到如下位置:
/**
 * 开始分页
 *
 * @param pageNum      页码
 * @param pageSize     每页显示数量
 * @param count        是否进行 count 查询
 * @param reasonable   分页合理化,null 时用默认配置
 * @param pageSizeZero true 且 pageSize=0 时返回全部结果,false 时分页,null 时用默认配置
 */
public static <E> Page<E> startPage(int pageNum, int pageSize, boolean count, Boolean reasonable, Boolean pageSizeZero){
    Page<E> page = new Page<E>(pageNum, pageSize, count);
    page.setReasonable(reasonable);
    page.setPageSizeZero(pageSizeZero);
    // 1、获取本地分页
    Page<E> oldPage = getLocalPage();
    if (oldPage != null && oldPage.isOrderByOnly()) {
        page.setOrderBy(oldPage.getOrderBy());
    }
    // 2、设置本地分页
    setLocalPage(page);
    return page;
}
这里已经到关键位置了,分别是 getLocalPage() 和 setLocalPage(page),我们分别看一下。
getLocalPage()
进入方法:
/**
 * 获取 Page 参数
 *
 * @return
 */
public static <T> Page<T> getLocalPage(){
    return LOCAL_PAGE.get();
}
再看看常量 LOCAL_PAGE 是什么路数:
protected static final ThreadLocal<Page> LOCAL_PAGE = new ThreadLocal<Page>();
好家伙,是 ThreadLocal。学过 Java 基础的同学都知道,它是独属于每个线程的本地缓存对象。
当一个请求进来时,会获取持有当前请求的线程的 ThreadLocal,调用 LOCAL_PAGE.get(),查看当前线程是否有未执行的分页配置。
setLocalPage(page)
这个方法显而易见,就是设置线程的分页配置:
protected static void setLocalPage(Page page){
    LOCAL_PAGE.set(page);
}
小结
经过前面的分析,我们发现,问题似乎就是这个 ThreadLocal 导致的。
是不是使用完之后没有清理?导致下一次这个线程再次处理请求时,仍然沿用之前的配置?
带着这个疑问,我们继续看看 MyBatis 是如何使用 PageHelper 的。
mybatis 使用 pageHelper 分析
我们需要关注的是 MyBatis 在什么时候使用了这个 ThreadLocal,也就是何时获取到分页参数。
前面提到过,通过 PageHelper 的 startPage() 方法完成 page 缓存的设置。当程序执行 mapper 接口的 SQL 时,就会被拦截器 PageInterceptor 拦截到。
PageHelper 本质上是 MyBatis 的分页插件,通过 mybatis使用pageHelper分析 这类场景可以看到,它借助 PageInterceptor 实现分页效果。这里我们重点看 intercept 方法:
@Override
public Object intercept(Invocation invocation) throws Throwable {
    try {
        Object[] args = invocation.getArgs();
        MappedStatement ms = (MappedStatement) args[0];
        Object parameter = args[1];
        RowBounds rowBounds = (RowBounds) args[2];
        ResultHandler resultHandler = (ResultHandler) args[3];
        Executor executor = (Executor) invocation.getTarget();
        CacheKey cacheKey;
        BoundSql boundSql;
        // 由于逻辑关系,只会进入一次
        if (args.length == 4) {
            // 4 个参数时
            boundSql = ms.getBoundSql(parameter);
            cacheKey = executor.createCacheKey(ms, parameter, rowBounds, boundSql);
        } else {
            // 6 个参数时
            cacheKey = (CacheKey) args[4];
            boundSql = (BoundSql) args[5];
        }
        checkDialectExists();
        // 对 boundSql 的拦截处理
        if (dialect instanceof BoundSqlInterceptor.Chain) {
            boundSql = ((BoundSqlInterceptor.Chain) dialect).doBoundSql(BoundSqlInterceptor.Type.ORIGINAL, boundSql, cacheKey);
        }
        List resultList;
        // 调用方法判断是否需要进行分页,如果不需要,直接返回结果
        if (!dialect.skip(ms, parameter, rowBounds)) {
            // 判断是否需要进行 count 查询
            if (dialect.beforeCount(ms, parameter, rowBounds)) {
                // 查询总数
                Long count = count(executor, ms, parameter, rowBounds, null, boundSql);
                // 处理查询总数,返回 true 时继续分页查询,false 时直接返回
                if (!dialect.afterCount(count, parameter, rowBounds)) {
                    // 当查询总数为 0 时,直接返回空的结果
                    return dialect.afterPage(new ArrayList(), parameter, rowBounds);
                }
            }
            resultList = ExecutorUtil.pageQuery(dialect, executor,
                    ms, parameter, rowBounds, resultHandler, boundSql, cacheKey);
        } else {
            // rowBounds 用参数值,不使用分页插件处理时,仍然支持默认的内存分页
            resultList = executor.query(ms, parameter, rowBounds, resultHandler, cacheKey, boundSql);
        }
        return dialect.afterPage(resultList, parameter, rowBounds);
    } finally {
        if(dialect != null){
            dialect.afterAll();
        }
    }
}
上面是 intercept 的全部代码,我们只关注几个重点位置。
设置分页:dialect.skip(ms, parameter, rowBounds)
这里的 skip 方法会设置分页参数,内部调用:
Page page = pageParams.getPage(parameterObject, rowBounds);
继续跟踪 getPage(),会发现这个方法的第一行就获取了 ThreadLocal 的值:
Page page = PageHelper.getLocalPage();
统计数量:dialect.beforeCount(ms, parameter, rowBounds)
我们都知道,分页需要先获取记录总数,所以这个拦截器会在分页前先执行 count 操作。
如果 count 为 0,则直接返回,不再进行分页:
// 处理查询总数,返回 true 时继续分页查询,false 时直接返回
if (!dialect.afterCount(count, parameter, rowBounds)) {
    // 当查询总数为 0 时,直接返回空的结果
    return dialect.afterPage(new ArrayList(), parameter, rowBounds);
}
afterPage 其实是对分页结果的封装方法,即使不分页也会执行,只不过返回空列表。
分页:ExecutorUtil.pageQuery
处理完 count 之后,才进入真正的分页查询:
resultList = ExecutorUtil.pageQuery(dialect, executor,
        ms, parameter, rowBounds, resultHandler, boundSql, cacheKey);
这个方法在执行分页前,会判断是否需要分页,依据就是前面通过 ThreadLocal 获取到的 page。
当然,不分页的查询,以及新增和更新操作,不会走到这个方法里。
非分页:executor.query
它们会走到下面这个分支:
resultList = executor.query(ms, parameter, rowBounds, resultHandler, cacheKey, boundSql);
我们可以思考一下:如果 ThreadLocal 在使用后没有被清除,当执行非分页方法时,是不是就会把 Limit 拼到 SQL 后面?
为什么非分页查询也会拼接?回头看前面提到的 dialect.skip(ms, parameter, rowBounds):
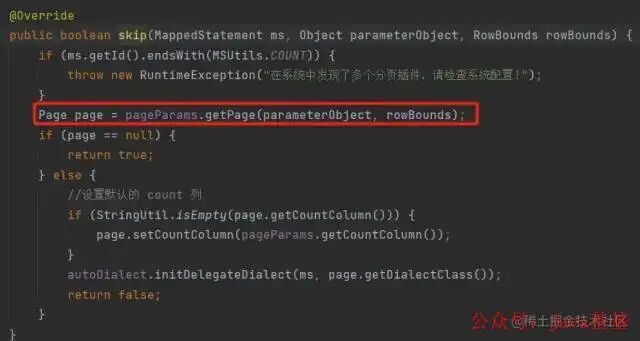
如上所示,只要 page 被获取到了,这条 SQL 就会走前面提到的 ExecutorUtil.pageQuery 分页逻辑,最终导致不可预料的情况。
实际上,PageHelper 对分页后的 ThreadLocal 是有清除处理的。
清除 ThreadLocal
在 intercept 方法的最后,会在 SQL 方法执行完成后清理 page 缓存:
finally {
    if(dialect != null){
        dialect.afterAll();
    }
}
看看这个 afterAll() 方法:
@Override
public void afterAll(){
    // 这个方法即使不分页也会被执行,所以要判断 null
    AbstractHelperDialect delegate = autoDialect.getDelegate();
    if (delegate != null) {
        delegate.afterAll();
        autoDialect.clearDelegate();
    }
    clearPage();
}
只关注 clearPage():
/**
 * 移除本地变量
 */
public static void clearPage(){
    LOCAL_PAGE.remove();
}
小结
到这里,关于 PageHelper 的使用方式就讲解完了。
整体看下来似乎不会有什么问题,但我们可以考虑几种极端情况:
- 如果调用了
startPage(),却没有执行对应的 SQL,那就说明当前线程的 ThreadLocal 被设置了分页参数,但没被消费。当下一个请求复用这个线程时,问题就来了。
- 如果程序在执行 SQL 前发生异常,就没办法执行 finally 里的
clearPage(),同样会造成线程的 ThreadLocal 被污染。
所以,官方给的建议是:使用 PageHelper 进行分页时,执行 SQL 的代码要紧跟 startPage() 方法。
除此之外,我们还可以手动调用 clearPage() 方法,放在可能存在问题的方法之前。
需要注意的是:不要在需要分页的方法前手动调用 clearPage(),否则你的分页会失效。
还有人问为什么不是每次请求都出错?
这其实取决于我们启动服务所用的容器。比如 Tomcat,其内部通过线程池处理请求;甚至现在很多容器基于 Netty,同样通过线程池复用线程来提升并发能力。
假设线程 1 持有没有被清除的 page 参数,然后不断调用同一个方法。接下来两个请求分别由线程 2 和线程 3 处理,没有问题;但再下一个请求又轮到线程 1 了,此时问题就出现了。
总结
关于 PageHelper 的介绍就这么多。它确实折磨了我好几天,要不是项目紧急,来不及替换,我大概率不会继续用这个组件。
莫名其妙的就会有个方法出问题,排查一圈,发现都是 PageHelper 导致的。虽然我已经全局搜索了使用位置,保证 startPage() 后紧跟 SQL 命令,但难免还有漏网之鱼,只能在出问题的方法里用 clearPage() 打补丁。
虽然 PageHelper 给我带来了一些困扰,也耗费了不少时间,但在定位问题的过程中,也重新梳理了 MyBatis 和 PageHelper 的实现方式。对于喜欢阅读源码的同学来说,这种排查经历还是有一定提升的。如果你也常在 云栈社区 翻阅这类实战复盘,可能对类似的坑会更有体感。
 发表于 4 小时前
|
查看: 6|
回复: 0
 /1


